
本地部署大模型需要什么配置?一张表看显存门槛
想在自家电脑上跑大模型,先别急着下载,显存够不够是第一道门槛。一句话结论:模型文件必须完整装进显存(或退一步装进内存)才能流畅运行,所以选配置的顺序是先按想跑的模型估显存,再看显卡和内存,最后才看 CPU 和硬盘。
显存怎么估算:参数量乘每参数字节数
模型的体积主要由参数量决定。参数是模型内部的小数,默认用 16 位浮点数存储,每个数占 2 字节;量化能把它压到更少字节,这正是模型量化存在的意义。想理解模型为什么是一堆数字,可以看这篇大语言模型是怎么工作的。
常用的粗算口径(估算值,实际还与上下文长度和推理引擎有关):
- FP16 原版:每 1B 参数约 2GB,7B 模型约 14GB。
- Q8 量化:每 1B 参数约 1GB,7B 模型约 7GB。
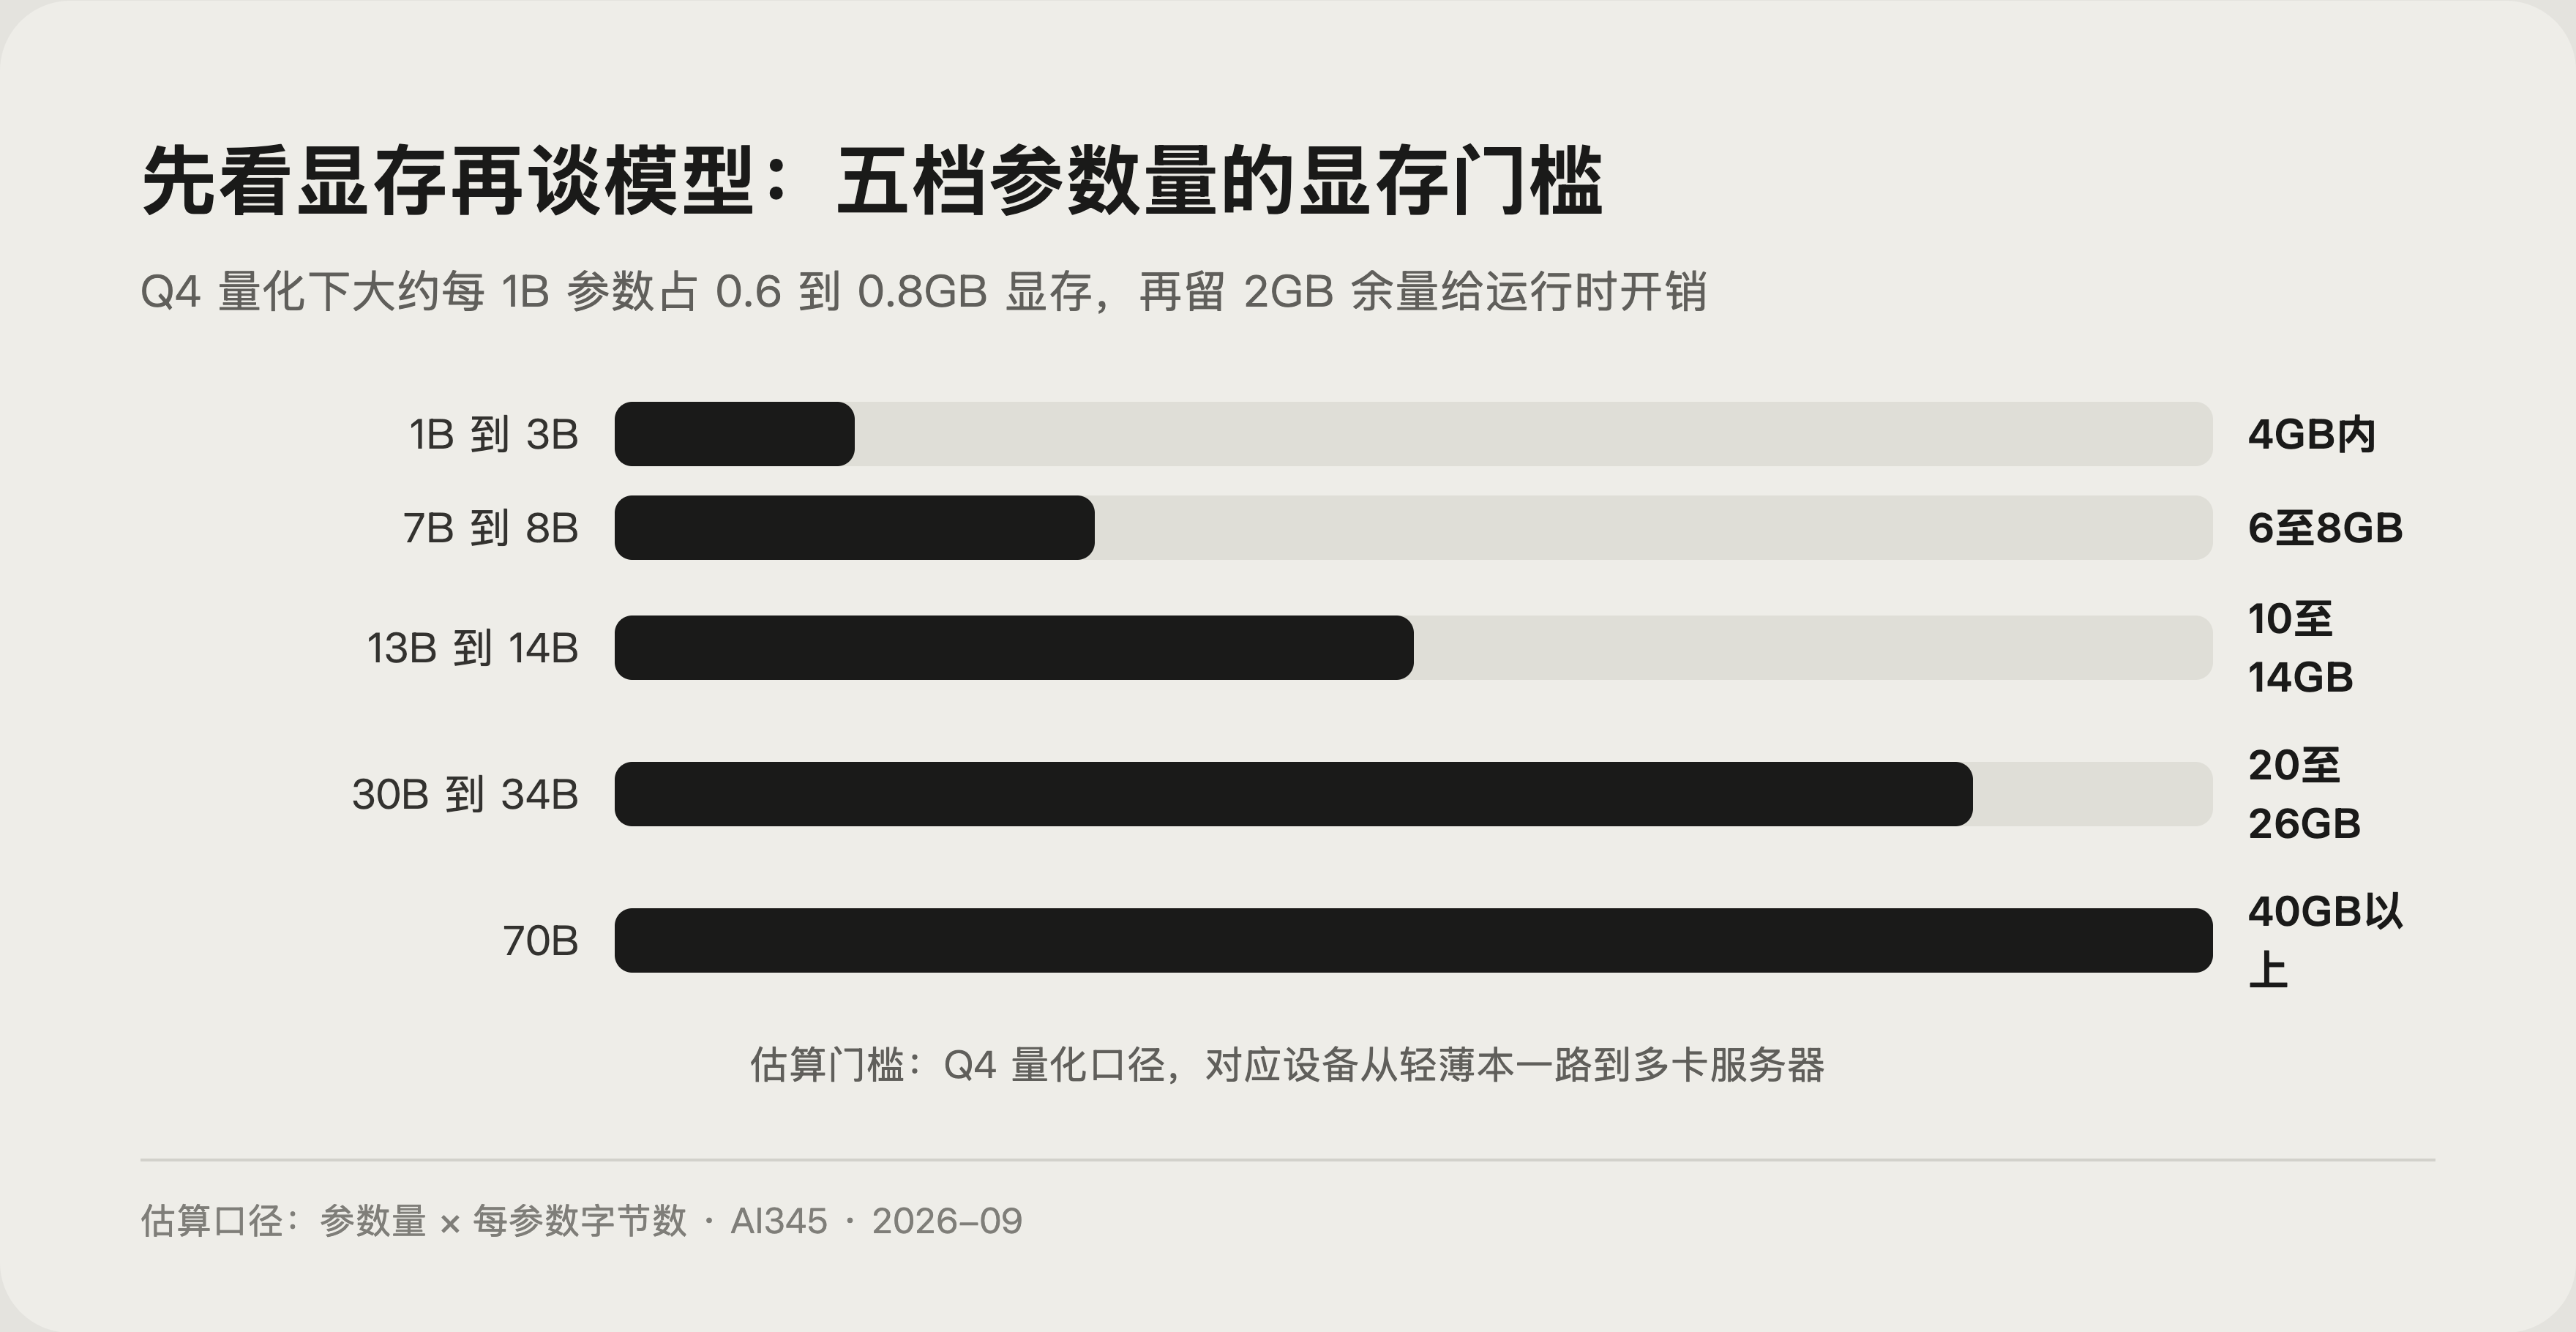
- Q4 量化:每 1B 参数约 0.6 至 0.8GB,7B 模型约 4 至 6GB。
在估算结果上再留 2GB 左右余量给运行时开销(上下文缓存、系统占用),就是你要准备的显存数。量化为什么能做到这个压缩比,GPTQ 论文给了权威背书:175B 模型量化到 3 至 4 bit 后精度损失可忽略,还能在单张 GPU 上推理(见 GPTQ 论文)。
一张表看几 B 模型需要什么机器
下表均为 Q4 量化下的估算门槛(标注:估算),按「流畅运行」标准给出:
| 模型规模 | 显存需求(估算) | 最低能跑的设备 | 体验预期 |
|---|---|---|---|
| 1B 到 3B | 4GB 以内 | 轻薄本、核显、高端手机 | 流畅,适合轻任务 |
| 7B 到 8B | 6 至 8GB | 入门独显或 16GB 内存笔记本 | 基本流畅 |
| 13B 到 14B | 10 至 14GB | 中端独显 | 均衡之选 |
| 30B 到 34B | 20 至 26GB | 24GB 显存级显卡 | 需要认真配机 |
| 70B | 40GB 以上 | 多卡、服务器,或大内存慢速运行 | 消费级很难流畅 |
两个容易被忽略的配角:内存是显存的备胎,显存装不下时可以放内存里跑,只是速度明显变慢;硬盘只影响下载和加载时间,现在主流模型文件在几 GB 到几十 GB 量级,普通固态硬盘都够。另外别忘了散热这个隐性因素:笔记本长时间满载推理会降频,速度忽快忽慢往往不是配置不够,而是过热降频。
没有好显卡还能怎么办
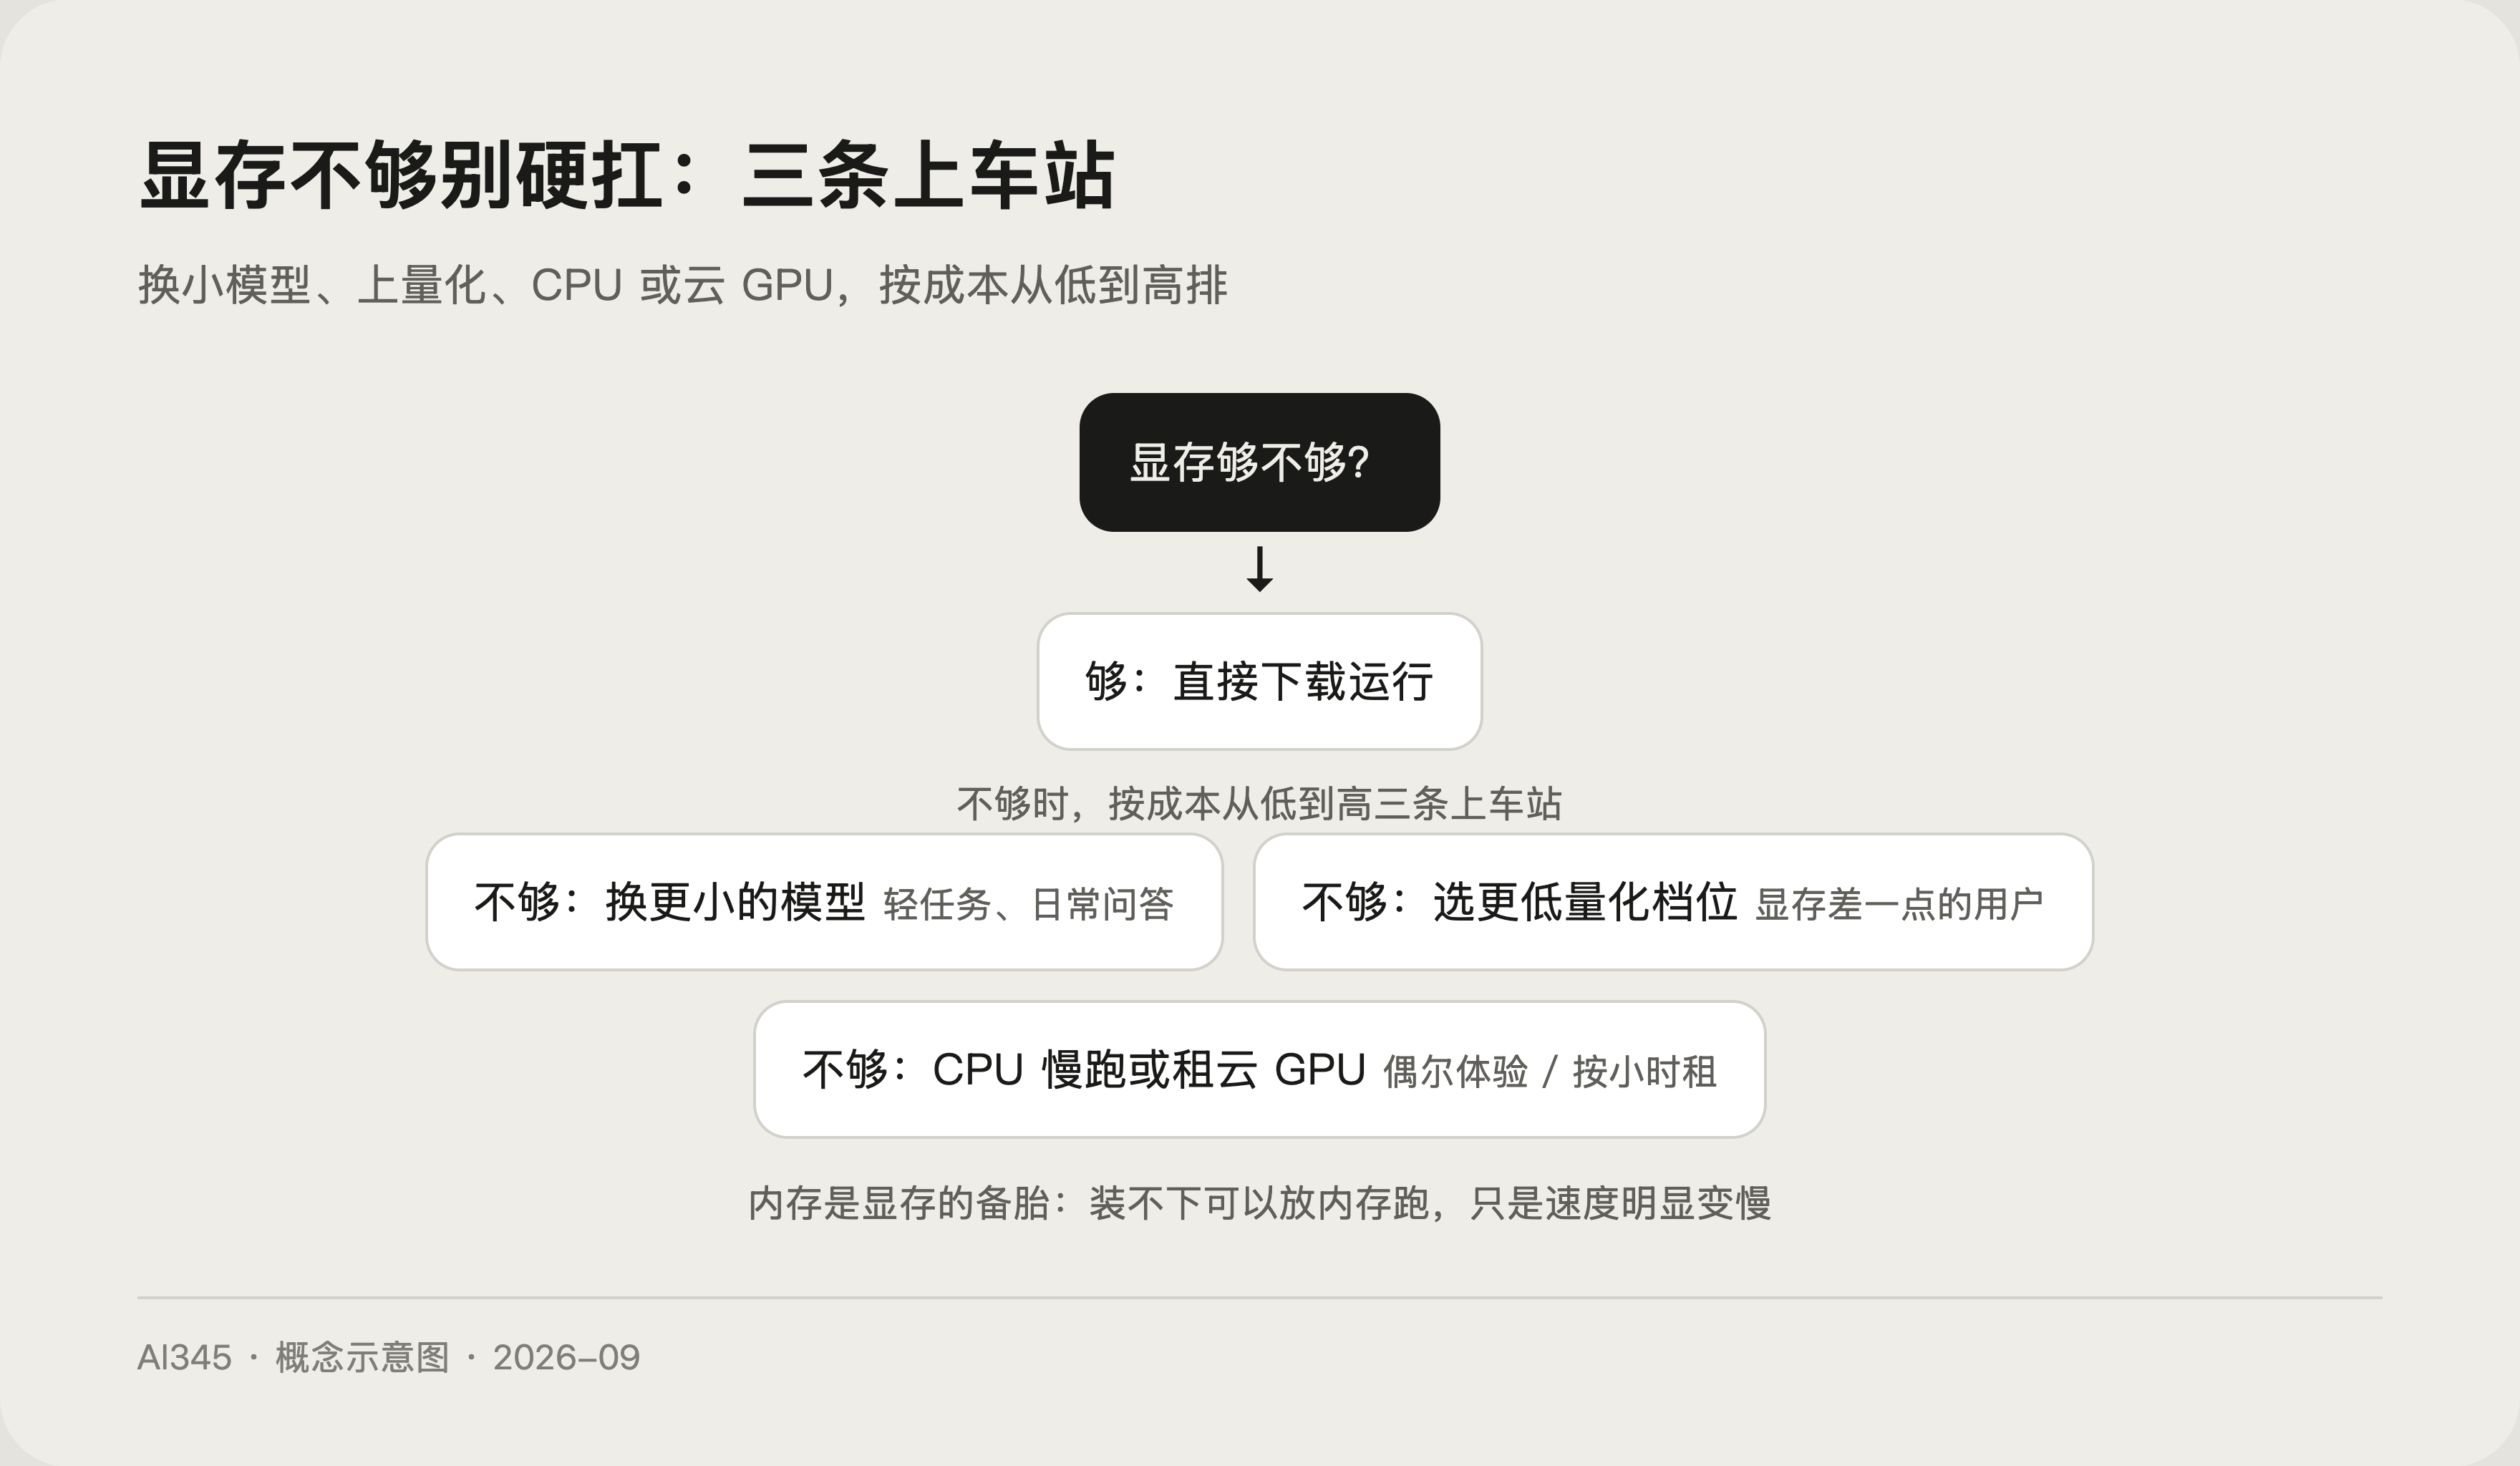
预算不是门槛,方案有三条,按成本从低到高排:
- 换小模型:与其用 8GB 显存硬跑 34B,不如选 7B 以下的小模型,速度快、质量在轻任务上够用,端侧模型就是这条路线,参考这篇面壁 MiniCPM 2B 上手解析。
- 上量化:同一模型选 Q4 档位,显存需求直接砍半以上,QLoRA 研究证明 4 位量化能把 65B 模型塞进单张 48GB GPU(见 QLoRA 论文),消费级同理受益。
- CPU 跑或租云显卡:CPU 跑大模型是慢速兜底,适合体验不适合干活;确有高强度需求,按小时租云上 GPU 往往比自购显卡划算。
上手路径:用 Ollama 三步跑起来
工具选择上,开源项目 Ollama 和 llama.cpp 是目前本地部署的主流入口,前者把后者的能力包装成了一条命令的体验。
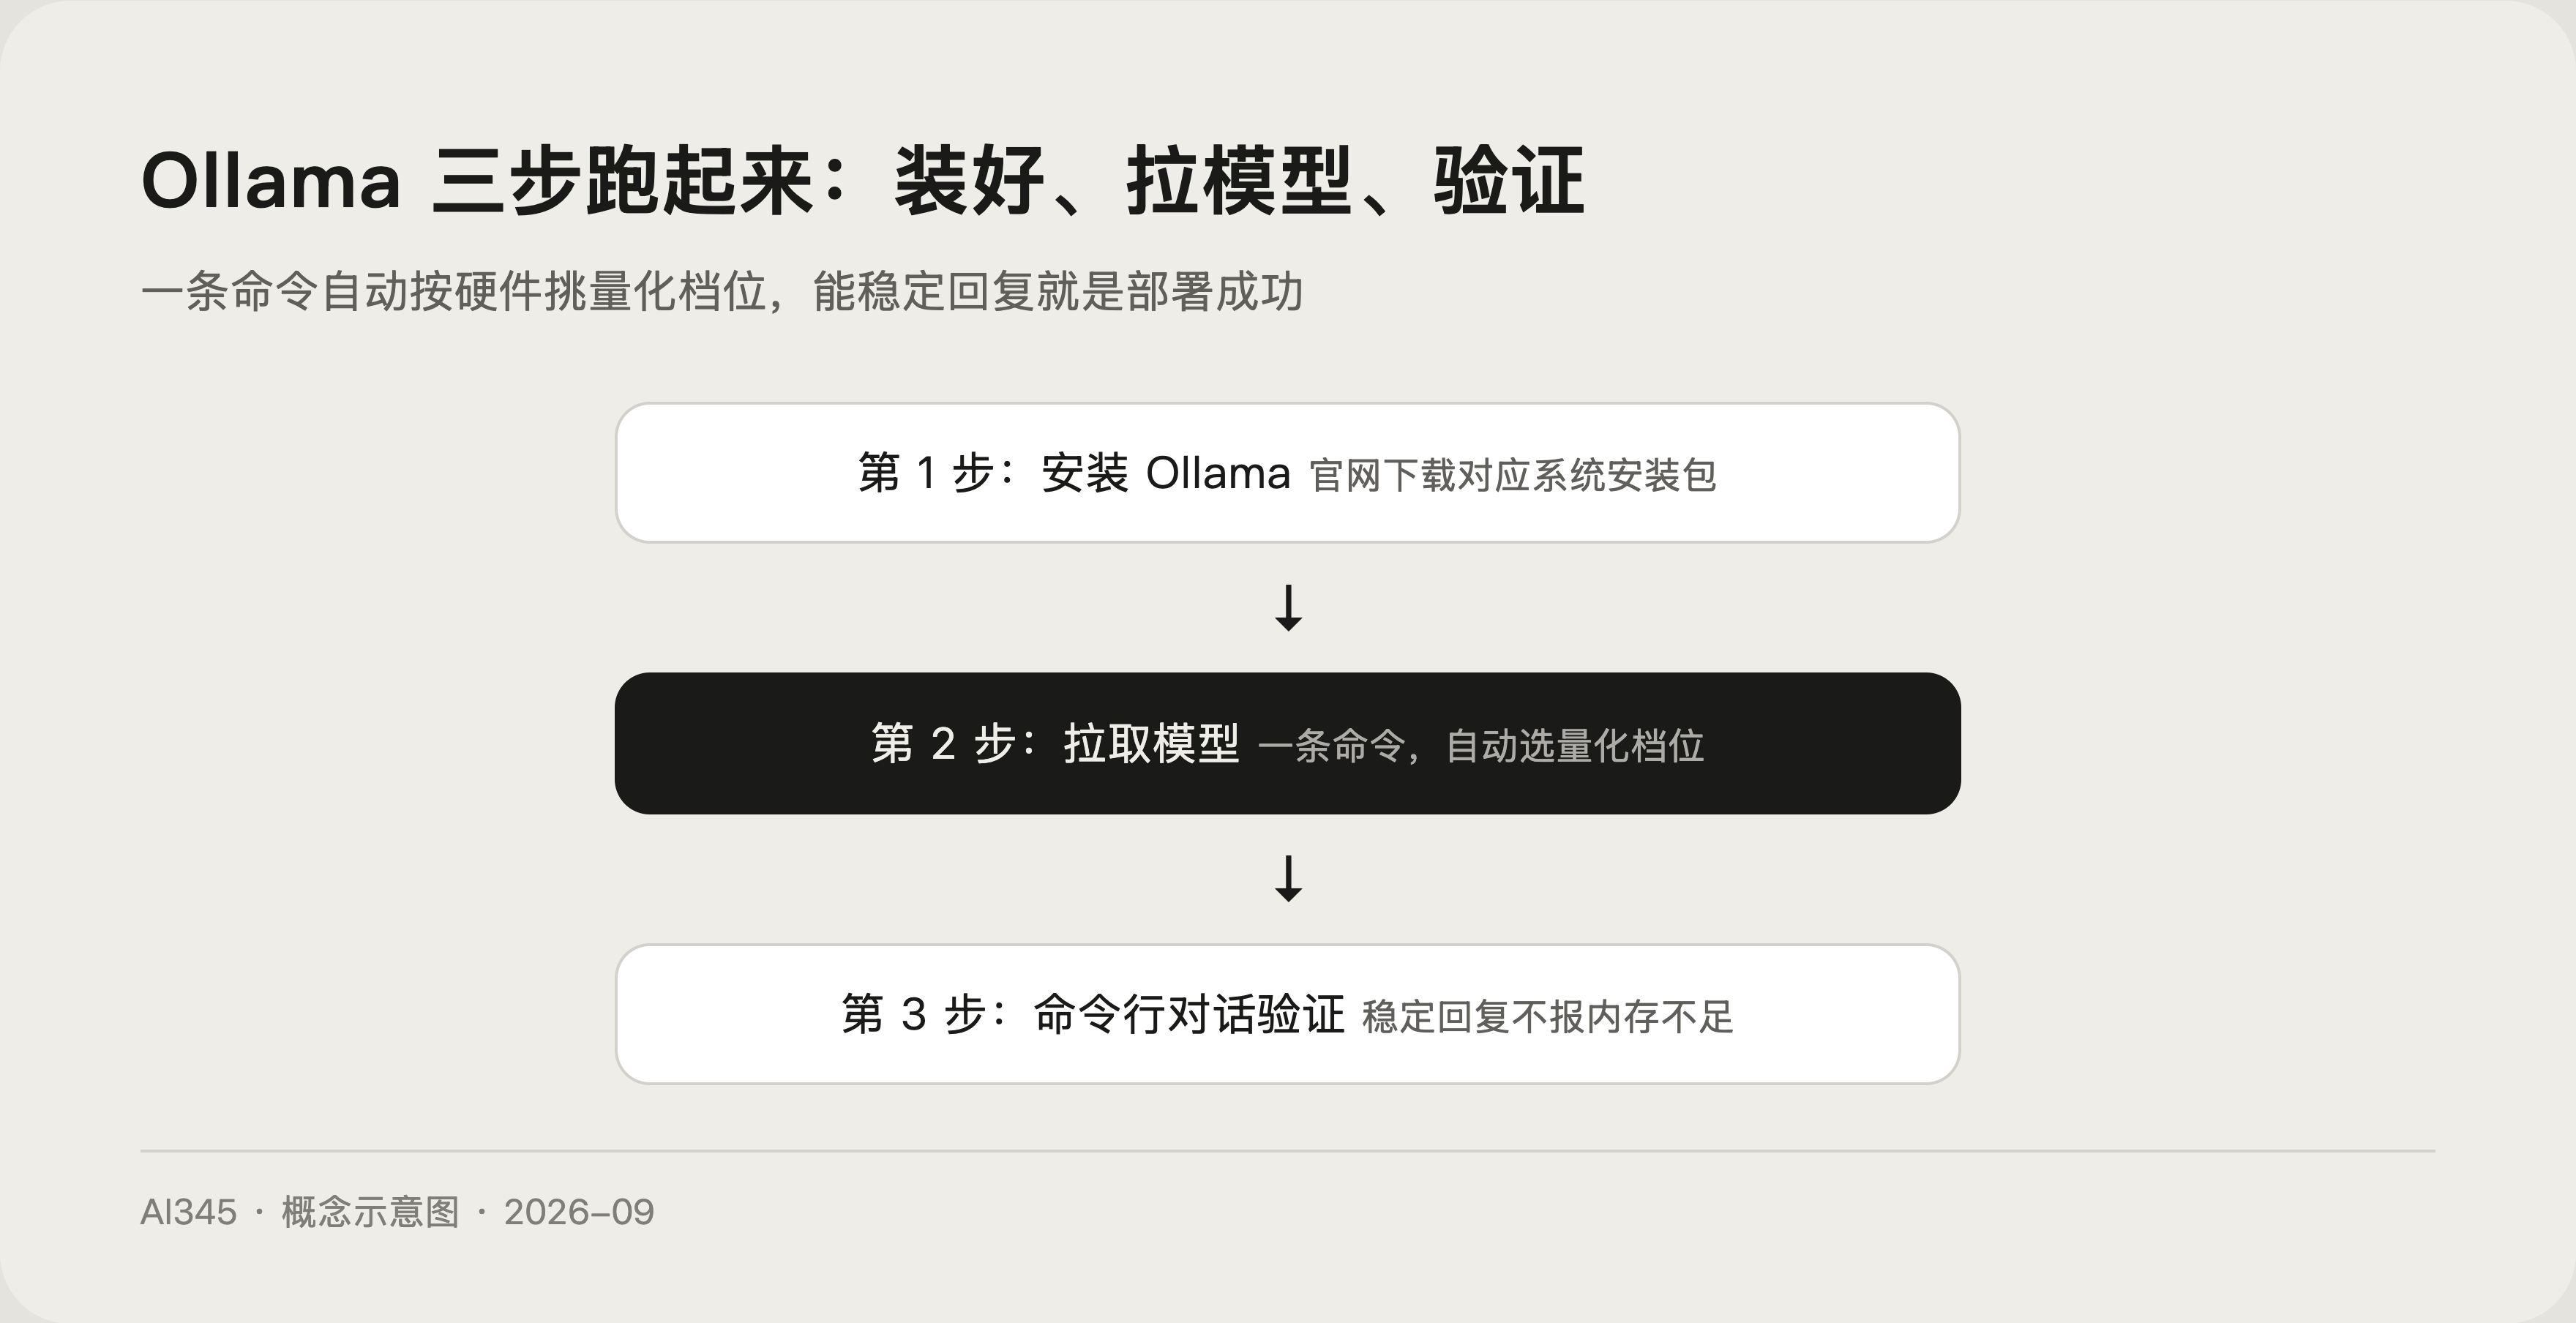
- 安装:去官网或 GitHub 下载对应系统的安装包,Windows 和 macOS 都有现成版本。
- 拉模型:一条命令指定模型名,工具会自动按你的硬件挑合适的量化档位下载。
- 对话验证:启动后进入命令行对话,能稳定回复不报「内存不足」,就说明部署成功。
具体到某个模型的完整部署细节,可以看站内这篇 openPangu 2.0 本地部署教程,流程是通用的。
一段话讲清本地部署配置
可以照这个口径复述:本地部署的第一约束是显存,模型参数量乘以每参数字节数就是大致体积,FP16 约每 1B 参数 2GB,Q4 量化约 0.6 到 0.8GB,再留 2GB 运行余量。显存不够的三条出路是换更小的模型、上更低量化档位,或用内存和 CPU 慢速运行,极致场景租云 GPU。内存是显存的溢出区,硬盘只影响加载速度。选型逻辑是先用估算表定档位,再用工具实测验证。
常见问题
只有 8GB 内存的老笔记本还能跑吗?
答:可以跑 1B 到 3B 的小模型,速度可用;7B 模型会很勉强,建议先从最小的档位试起。
显存和内存有什么区别?
答:显存是显卡上的高速存储,模型计算主要用它,速度快;内存是电脑的通用存储,显存不够时模型可以退到内存里跑,但速度明显下降。
苹果电脑没有 NVIDIA 显卡能跑吗?
答:能。苹果芯片采用统一内存架构,显存和内存共享,统一内存大的 Mac 可以跑相当规模的量化模型,是消费级里性价比不错的路线。
上下文长度会影响显存占用吗?
答:会。上下文越长,运行时的缓存占用越大,长文档任务要在估算余量之外再预留空间,否则可能中途溢出。
本地部署和调 API 怎么选?
答:看重数据隐私、离线可用或高频调用,选本地;看重模型能力和省心,选 API。两者不冲突,很多团队是混合用。
 京ICP备2024094994号-29