
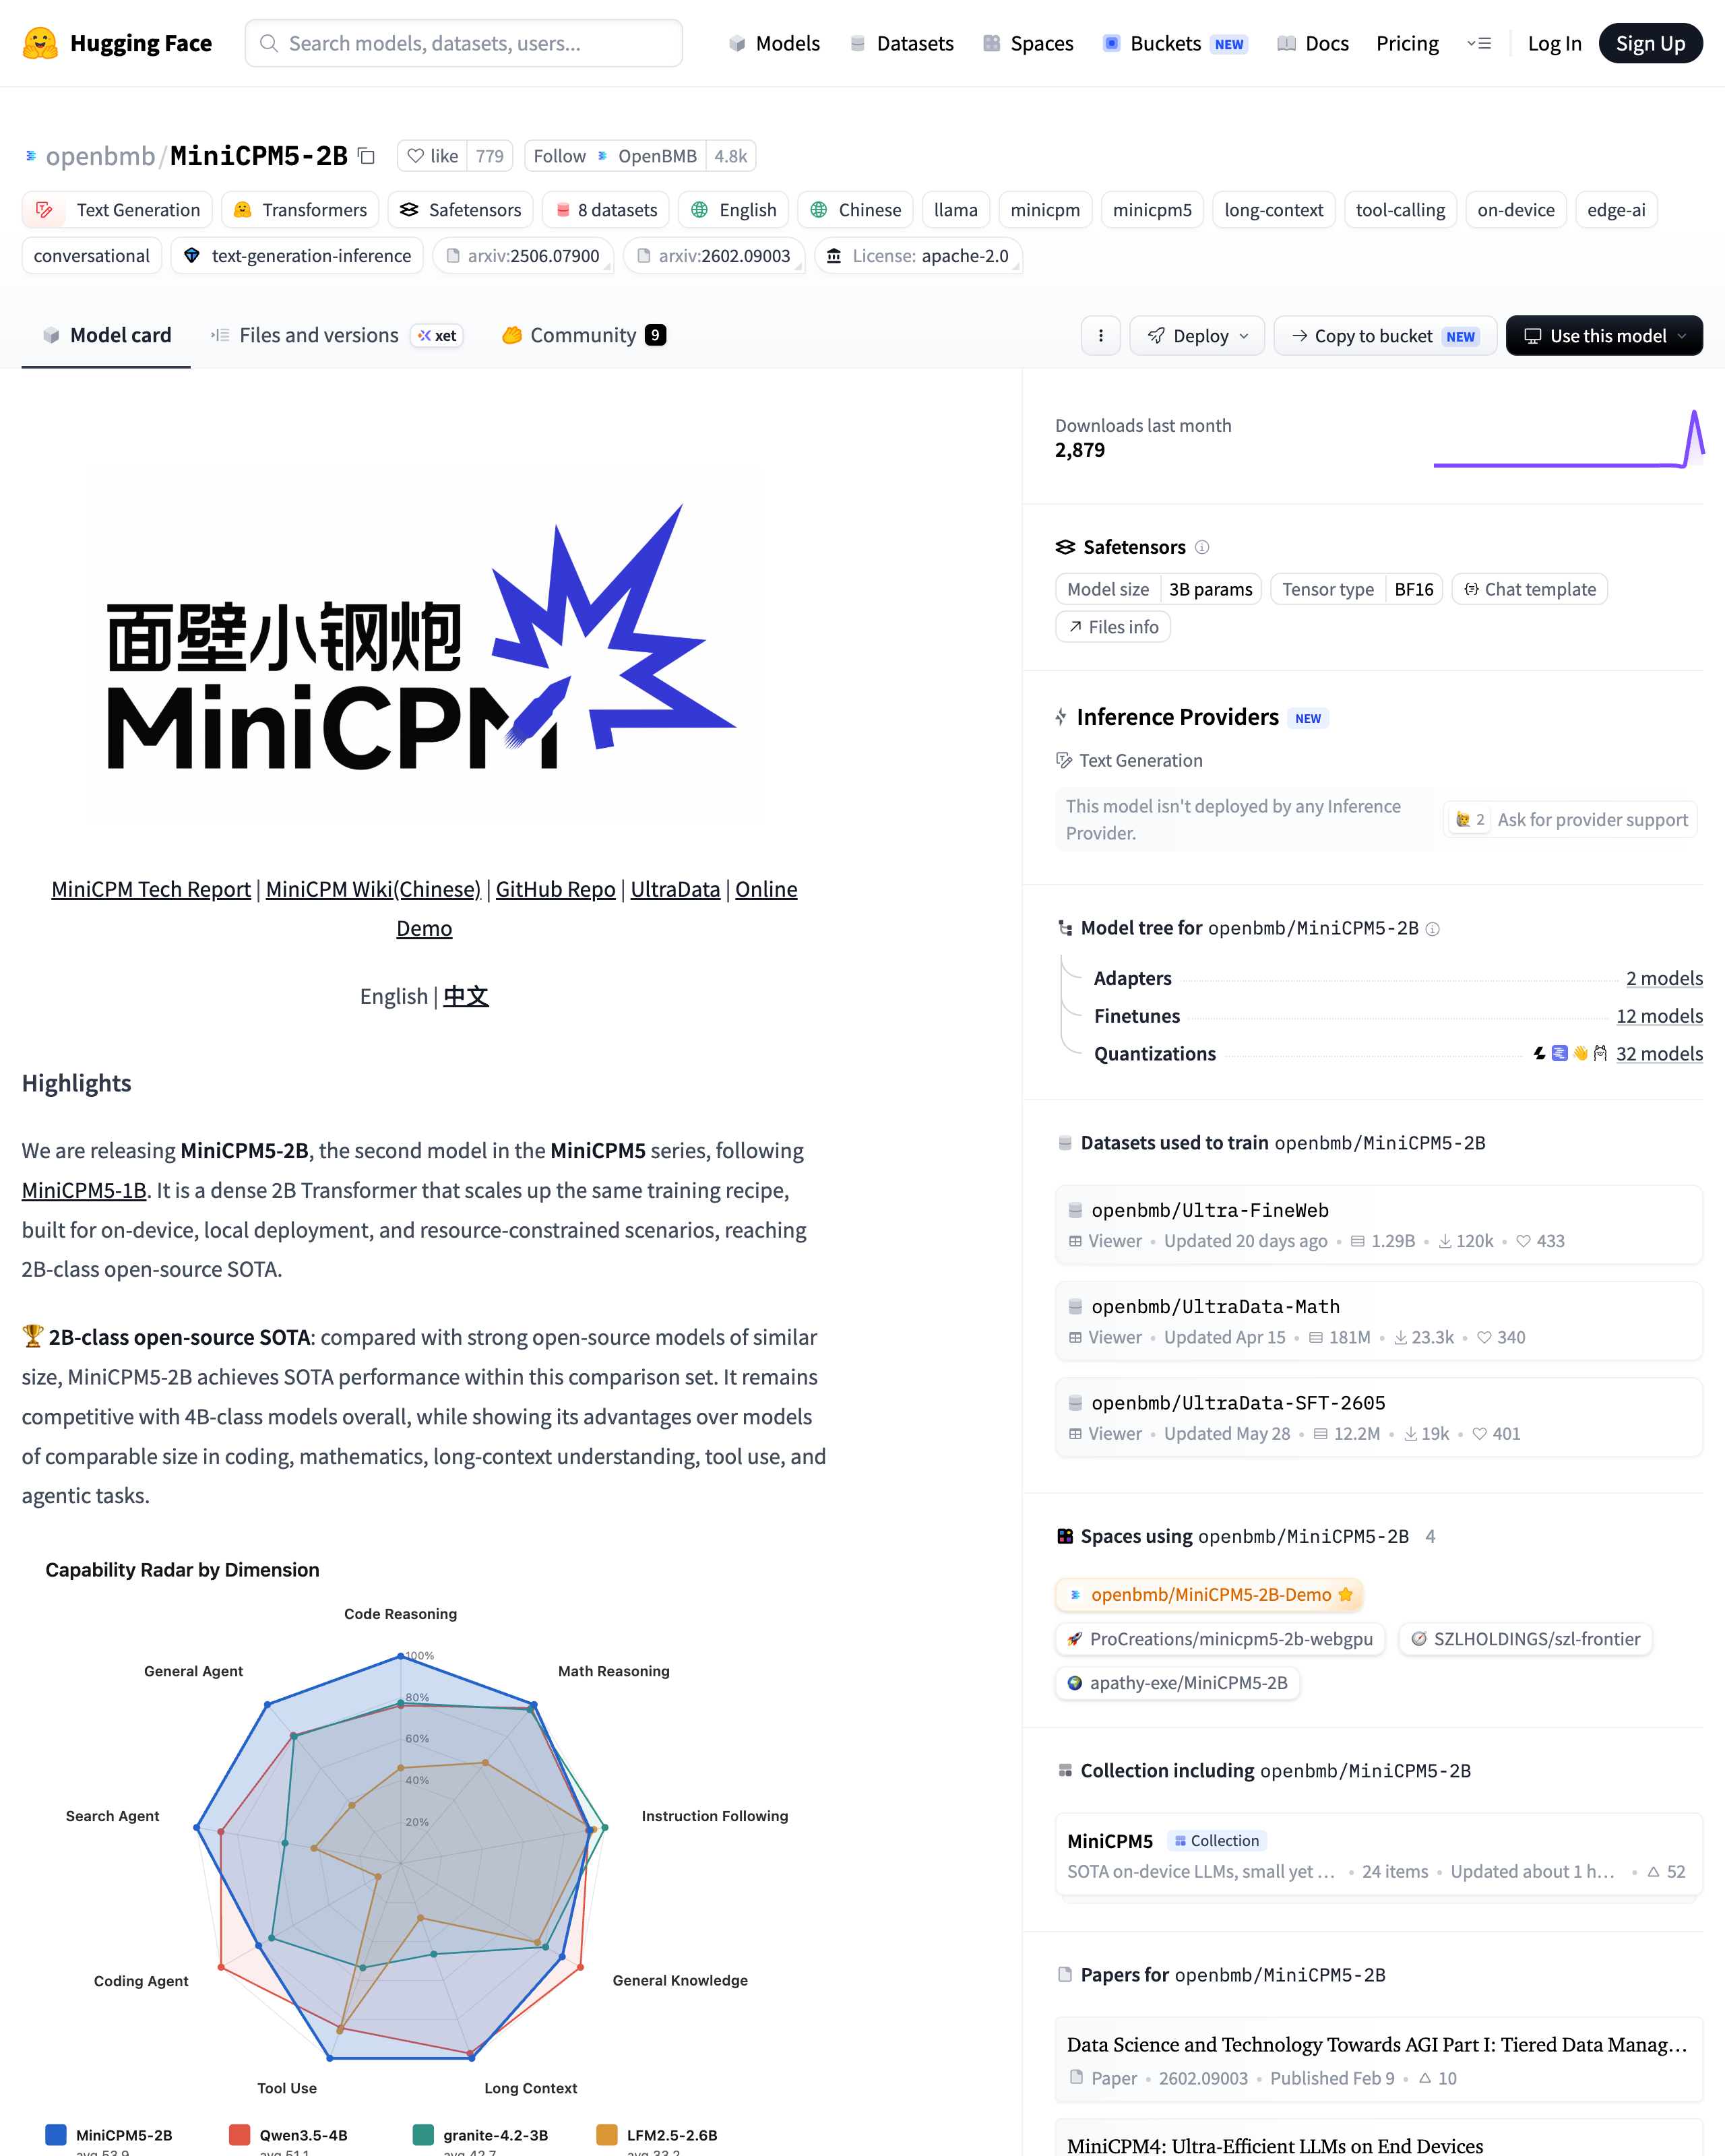
MiniCPM5-2B 是什么?面壁 2B 端侧模型手机部署全解
MiniCPM5-2B 是 OpenBMB(面壁智能与清华系团队)2026 年 9 月 7 日发布的开源 2B 级语言模型,也是 MiniCPM5 系列的第二款稠密模型。它要解决的问题很明确:不调云端 API、不靠大显卡,在自己设备上也能跑一个会写代码、会调工具、能读长文档的中文小模型。
MiniCPM5-2B 是什么:定位与关键参数
按官方仓库的说明,它是把 MiniCPM5-1B 的训练配方放大到 2B 参数的版本,面向本地助手、编码 Agent、工具调用工作流和资源受限场景。关键参数核对自 OpenBMB 官方仓库与模型卡(2026 年 9 月):
| 项目 | 官方数值 |
|---|---|
| 架构 | 标准 LlamaForCausalLM |
| 参数量 | 2,516,756,480(非嵌入参数 1,981,982,720) |
| 层数 | 42 |
| 注意力 | GQA,16 个 Query 头 / 2 个 KV 头 |
| 上下文长度 | 131,072 tokens |
| 开源协议 | Apache 2.0 |
| 变体 | Base、SFT、Midtrain、GGUF、MLX、GPTQ、DSpark、LiteRT-LM 手机版 |
GQA 把 KV 头压到 2 个,是推理显存压力小的直接原因;131,072 tokens 的原生上下文意味着十几万字的中文文档可以直接放进提示,不必外挂检索。
跑分表现:2B 级开源 SOTA 意味着什么
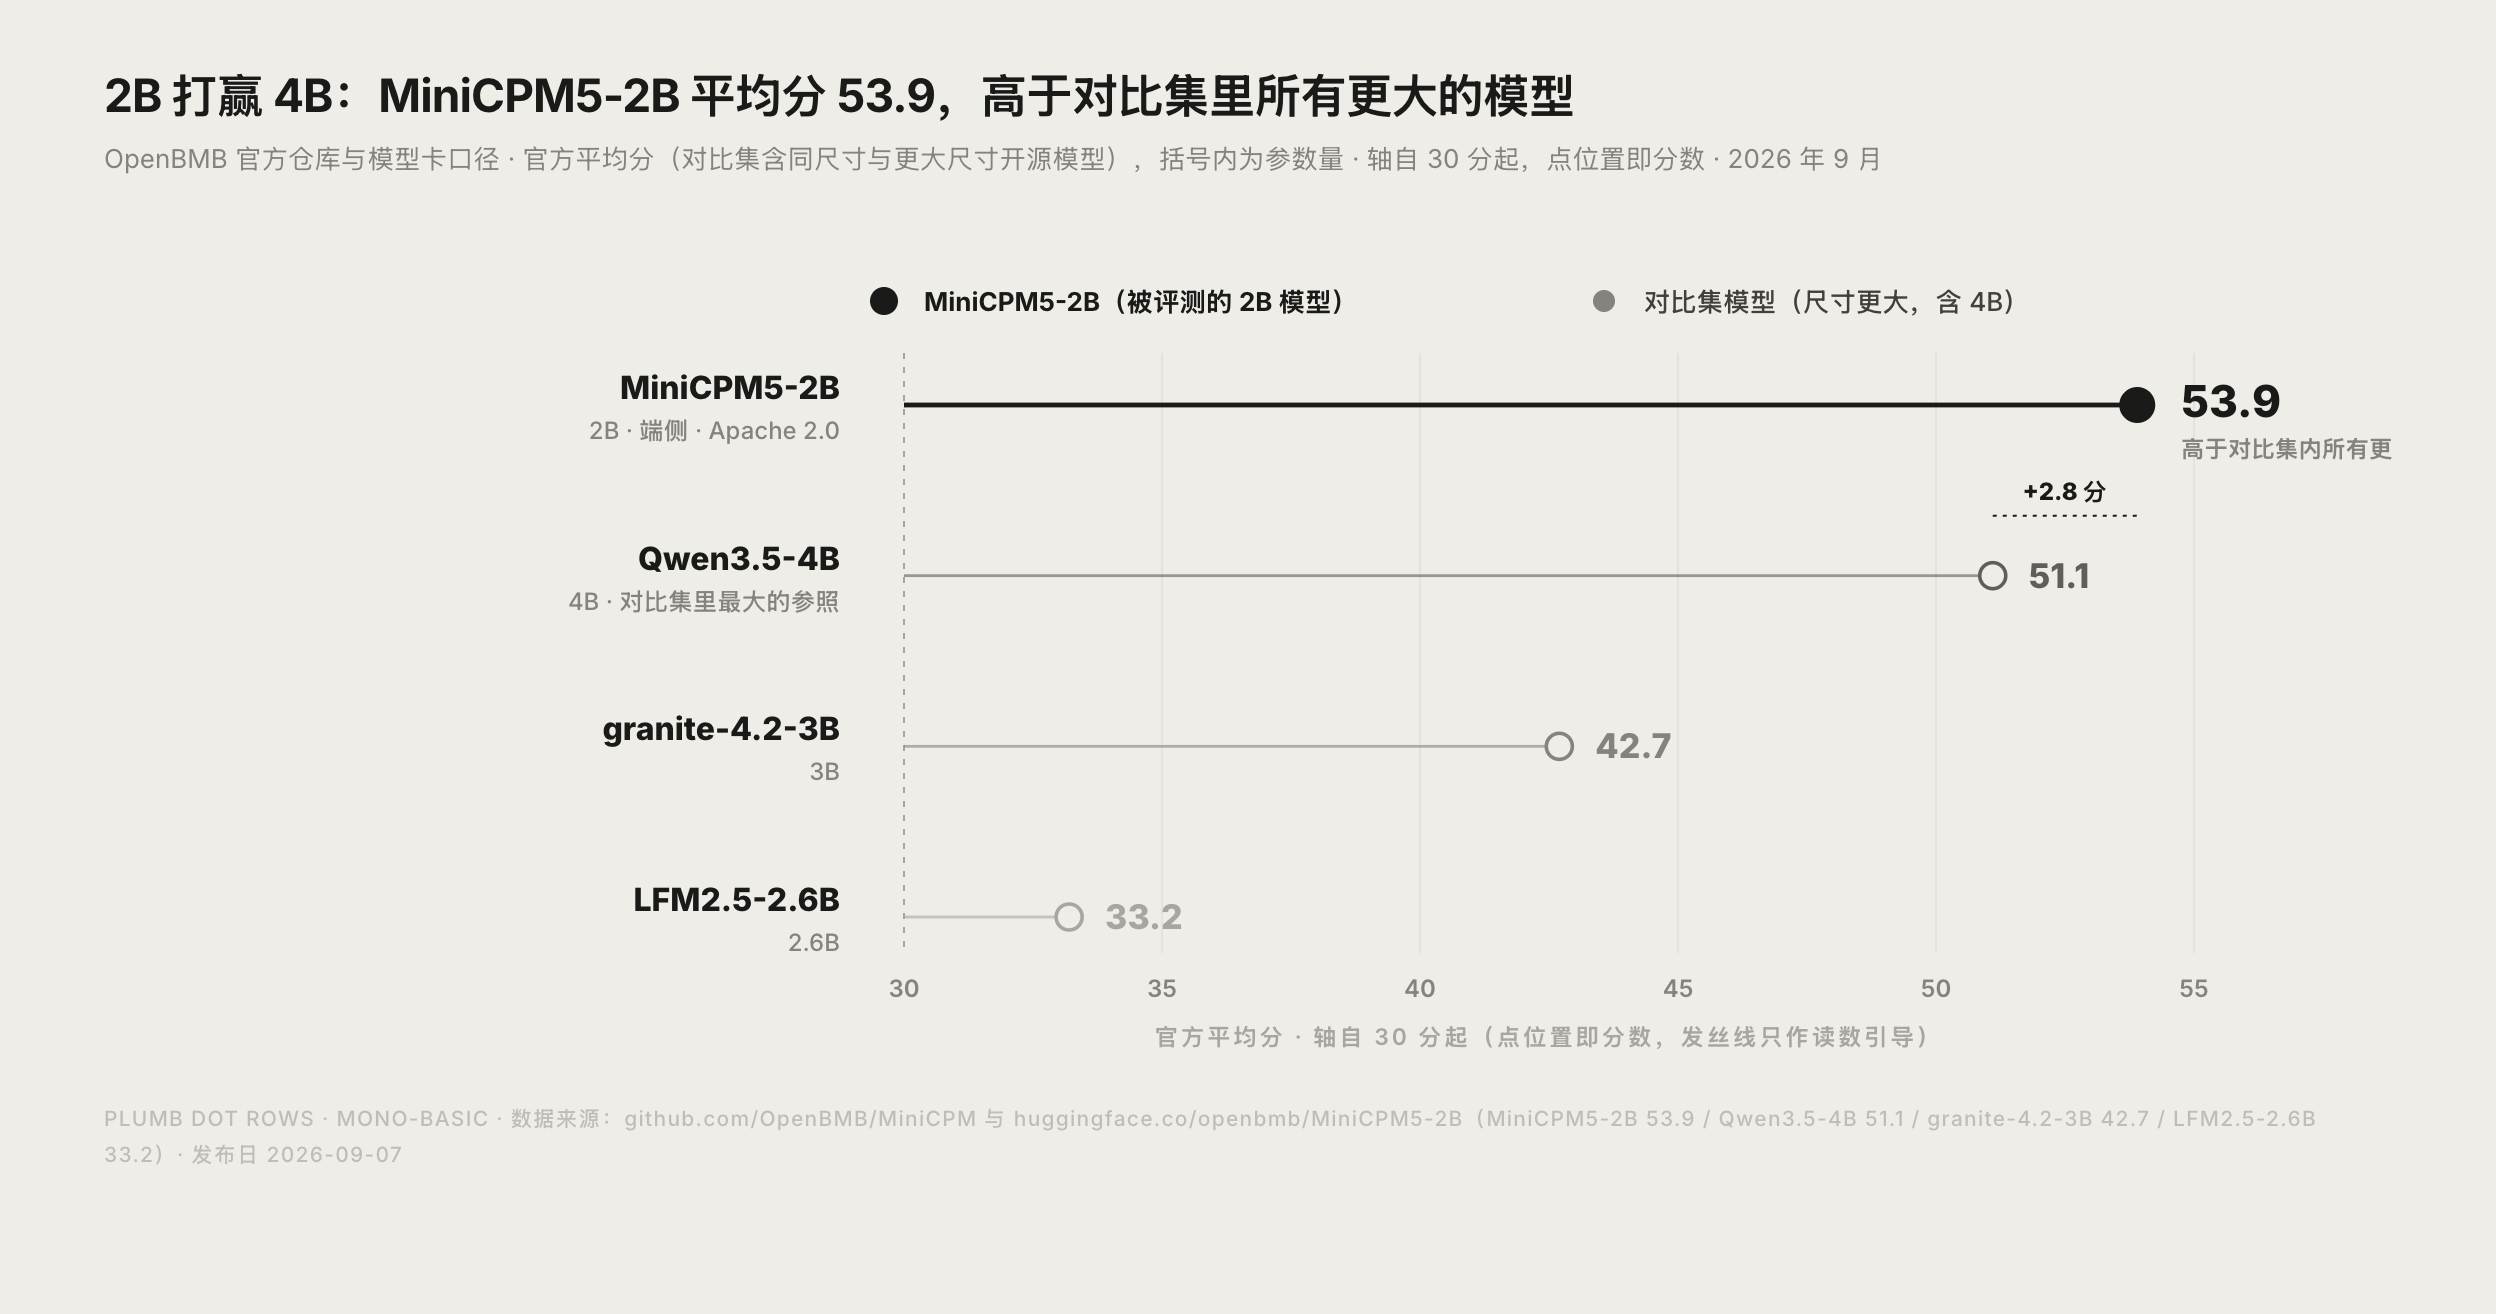
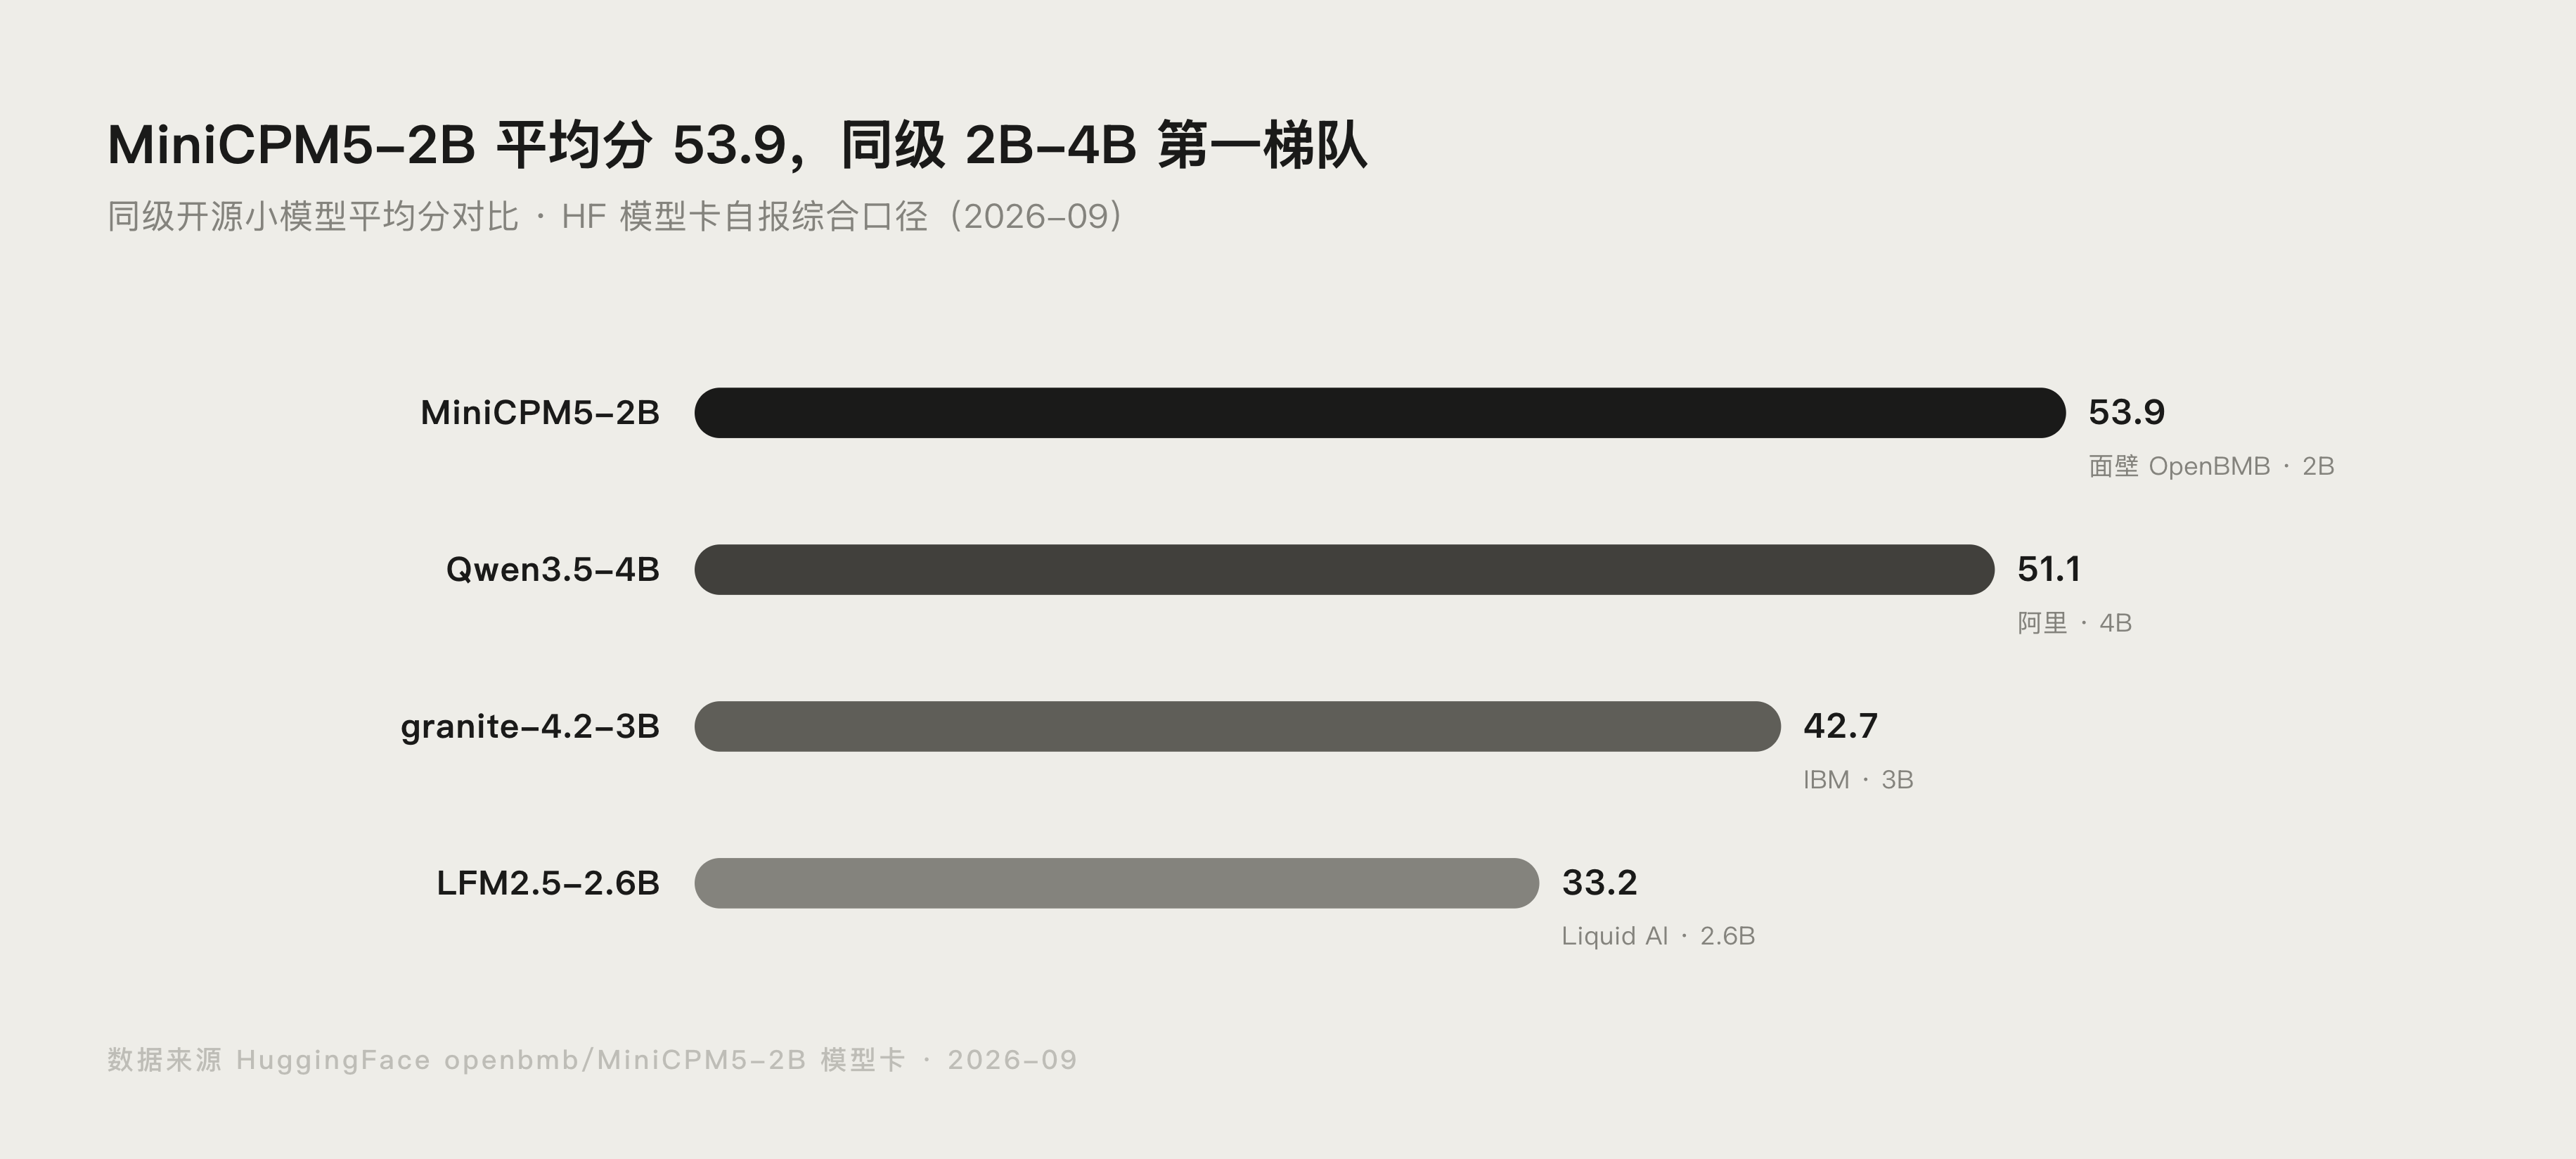
官方给出的平均分是 53.9,高于对比集中所有更大的模型(其中最高的是 Qwen3.5-4B 的 51.1),官方称之为 2B 级开源 SOTA。对比集里既有同尺寸对手(LFM2.5-2.6B、Qwen3.5-2B、Gemma-4-E2B-it),也有更大的参考模型(Qwen3.5-4B、granite-4.2-3B、Nemotron-3-Nano-4B、Gemma-4-E4B-it、LFM2.5-8B-A1B)。
细分维度上,数学和代码是它的强项:AIME 2025 得分 86.5,MATH-500 为 94.6,LiveCodeBench v6 为 69.1。工具调用方面 BFCL v4 拿到 66.6 分,在 2B 级别里属于偏高水位。官方仓库同时给出了一张分域能力雷达图,代码推理、数学推理、长上下文理解、工具使用与多个 Agent 任务上,它的优势最明显。
为什么 2B 能追平 4B:数据和训练配方
效率不是凭空来的,官方把这套配方的细节一起开源了:
- 数据分层。训练语料按 UltraData 分层数据管理做全栈实践,Ultra-FineWeb、Ultra-FineWeb-L3、UltraX、UltraData-Code、UltraData-Math 都已公开。
- 三阶段训练。基础训练(稳定训练 + 衰减训练)、中期训练(强化目标能力、适配目标数据分布)、后训练三段走。
- 后训练三步。先用 400B tokens 的深度思考 SFT 建立推理与通用对话能力,再做数学、代码、Agent、写作等专项 RL 教师训练,最后用 OPD 收敛。
- Agent 数据单独开源。UltraData-SFT-Agent-2609 含 50 万条 Agent 训练样本,UltraData-RL-2609 含 8 万条以上覆盖数学、代码、通用知识与长上下文推理的 RL 样本。
对使用者的意义是:你不只是拿到了权重,还拿到了配方和增量数据。想在自己垂类上继续训练或蒸馏,起点比只有一个模型文件高得多。
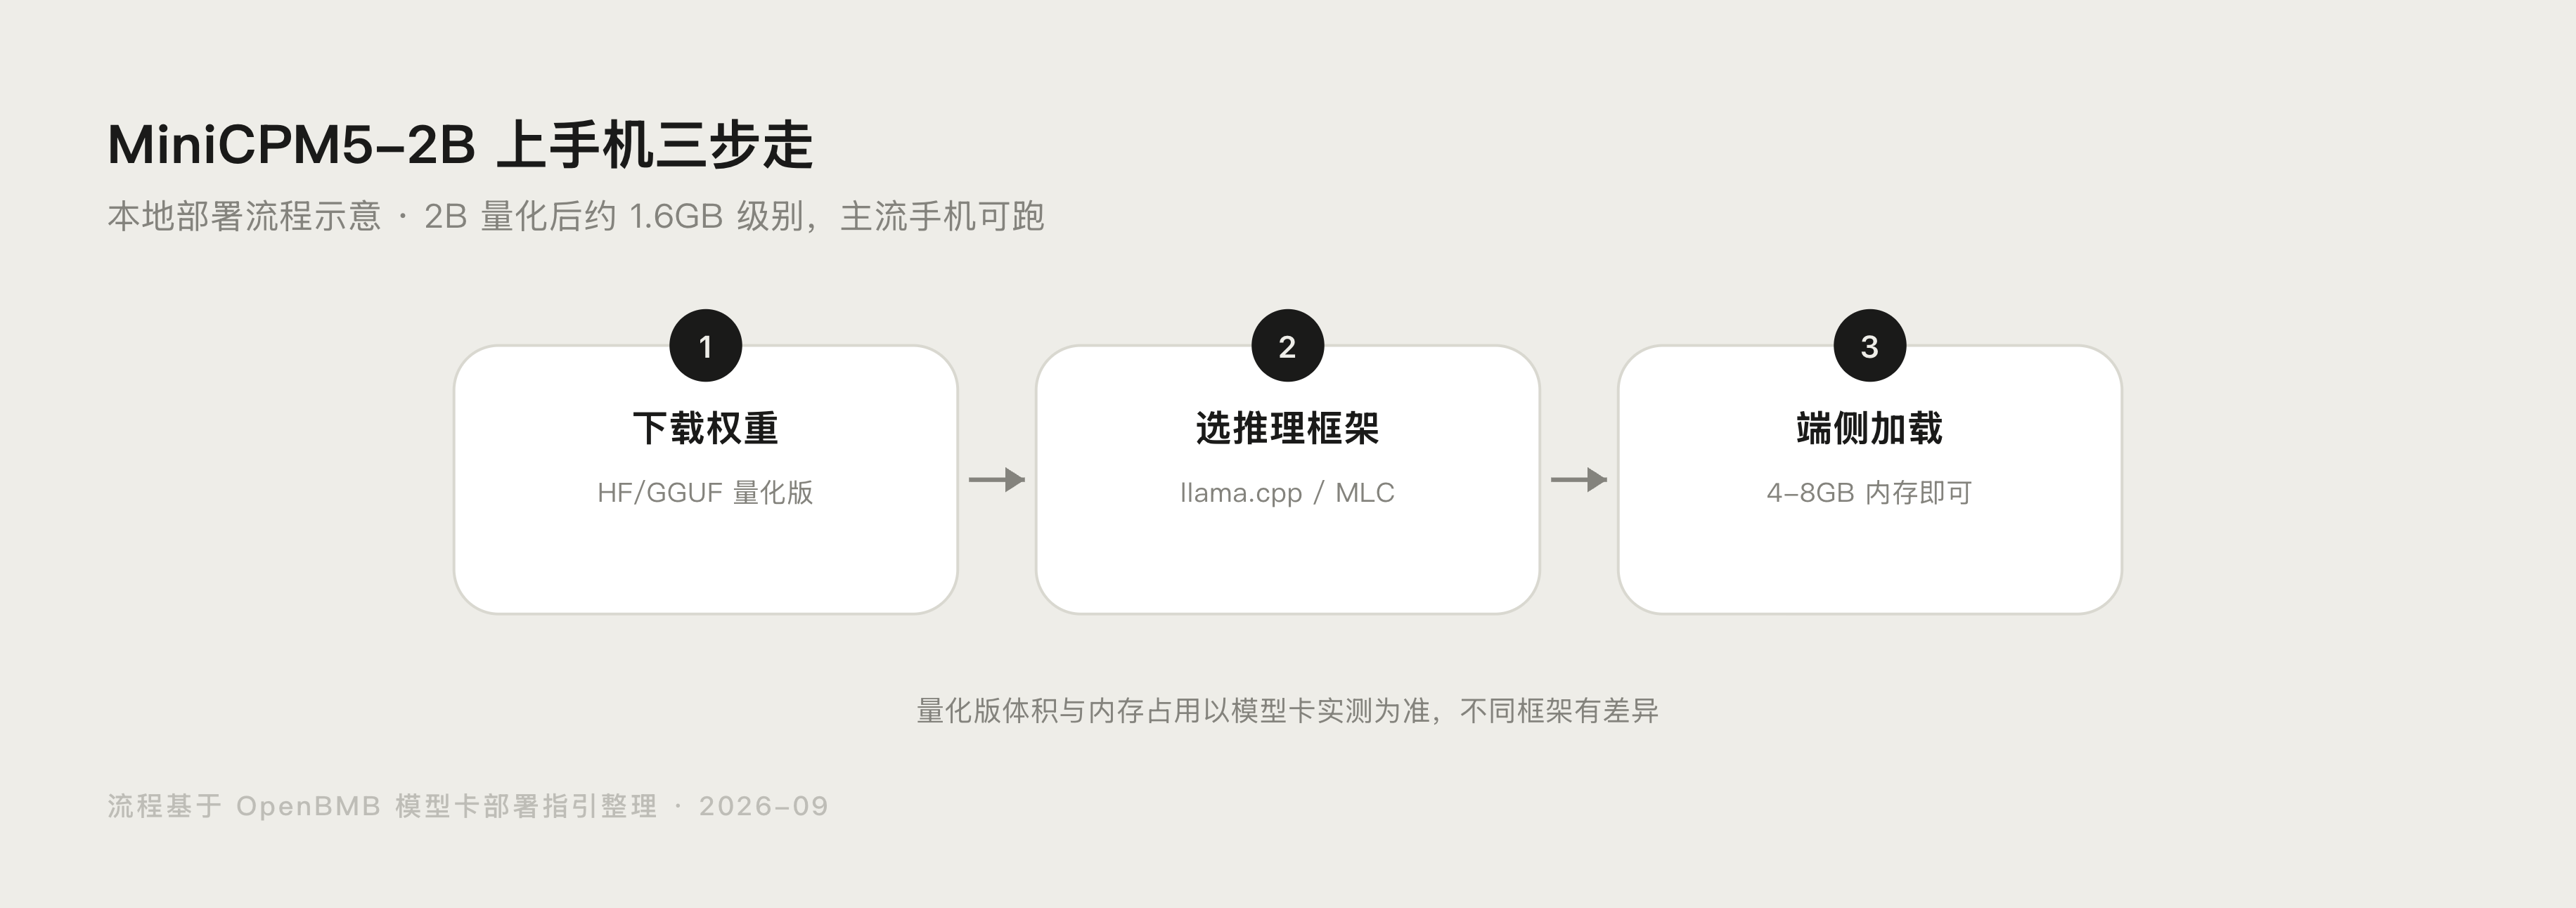
怎么在本地和手机上跑起来
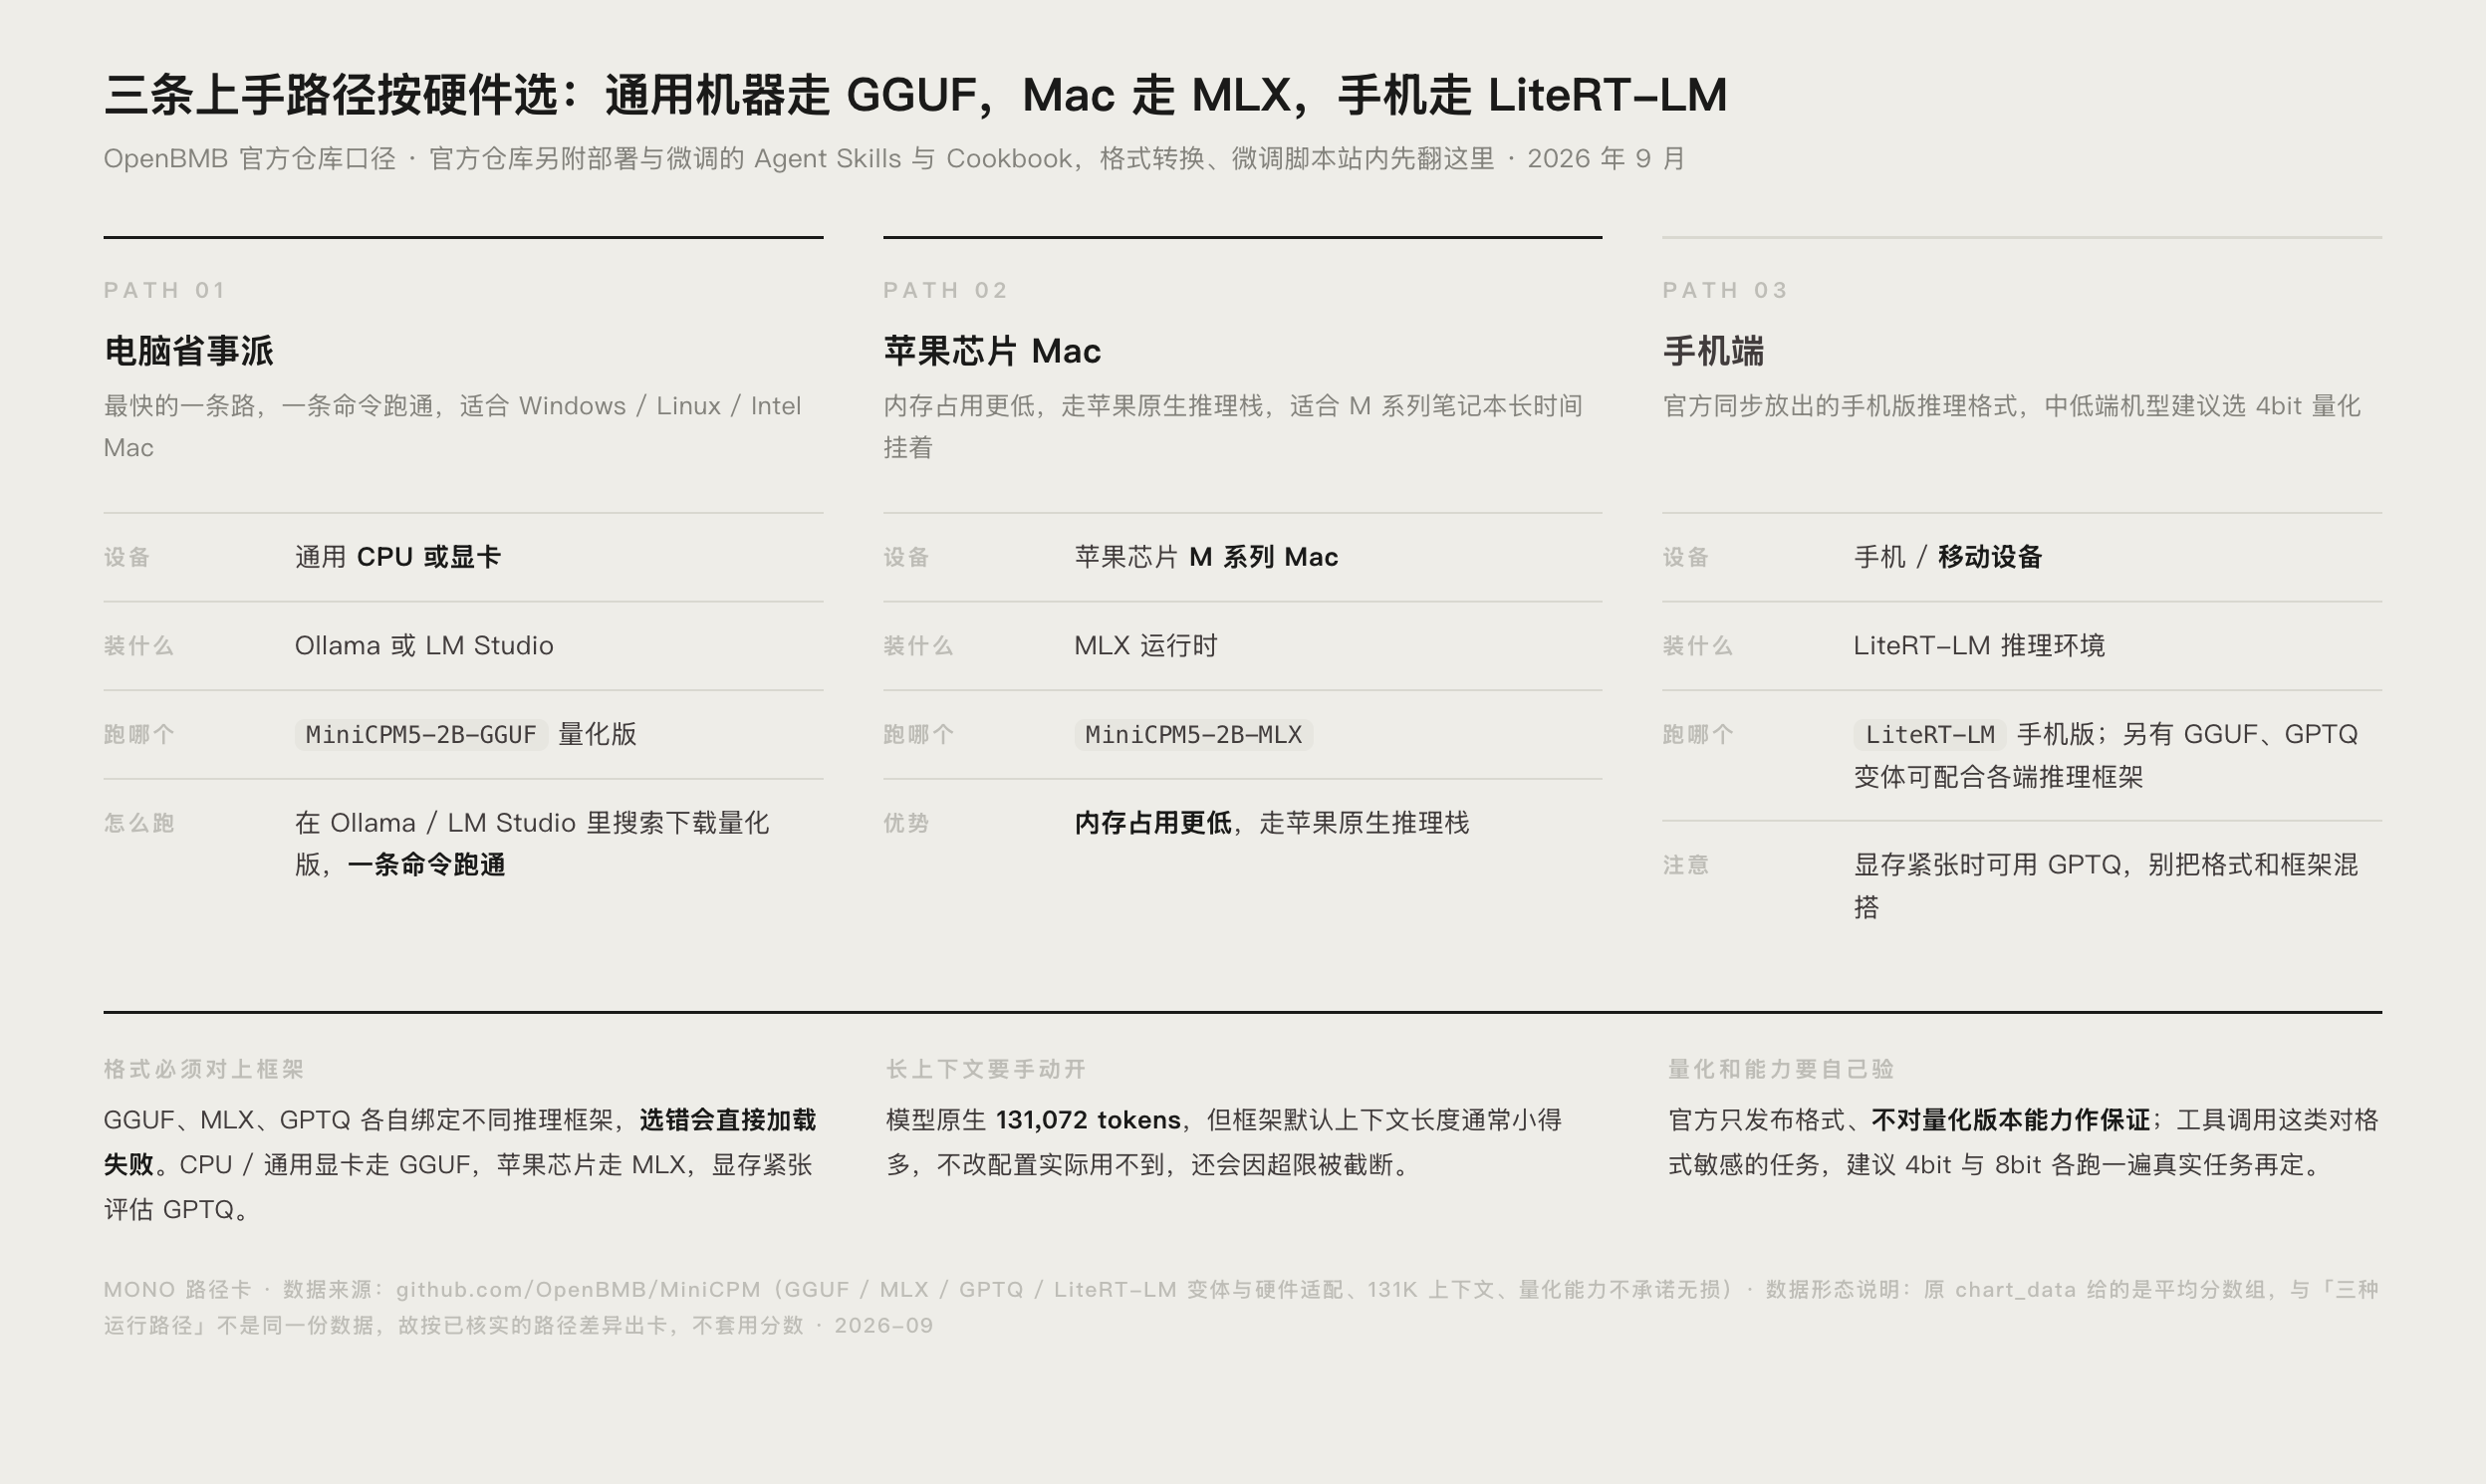
最快路径三条,按设备选:
- 电脑省事派:装 Ollama 或 LM Studio,搜索下载 MiniCPM5-2B-GGUF 量化版,一条命令跑通。
- 苹果芯片 Mac:选 MLX 版本,内存占用更低,走苹果原生推理栈。
- 手机端:官方同步放出 LiteRT-LM 手机版,另有 GGUF、GPTQ 变体可配合各端推理框架。
对本地部署流程不熟的读者,可以参考站内的星火 X2.5 本地部署教程,Ollama 的操作步骤是通用的,换个模型名即可。官方仓库里还提供了部署与微调的 Agent Skills 与 Cookbook,遇到格式转换、微调脚本一类问题,先翻这里比搜第三方教程可靠。
容易踩的坑与注意事项
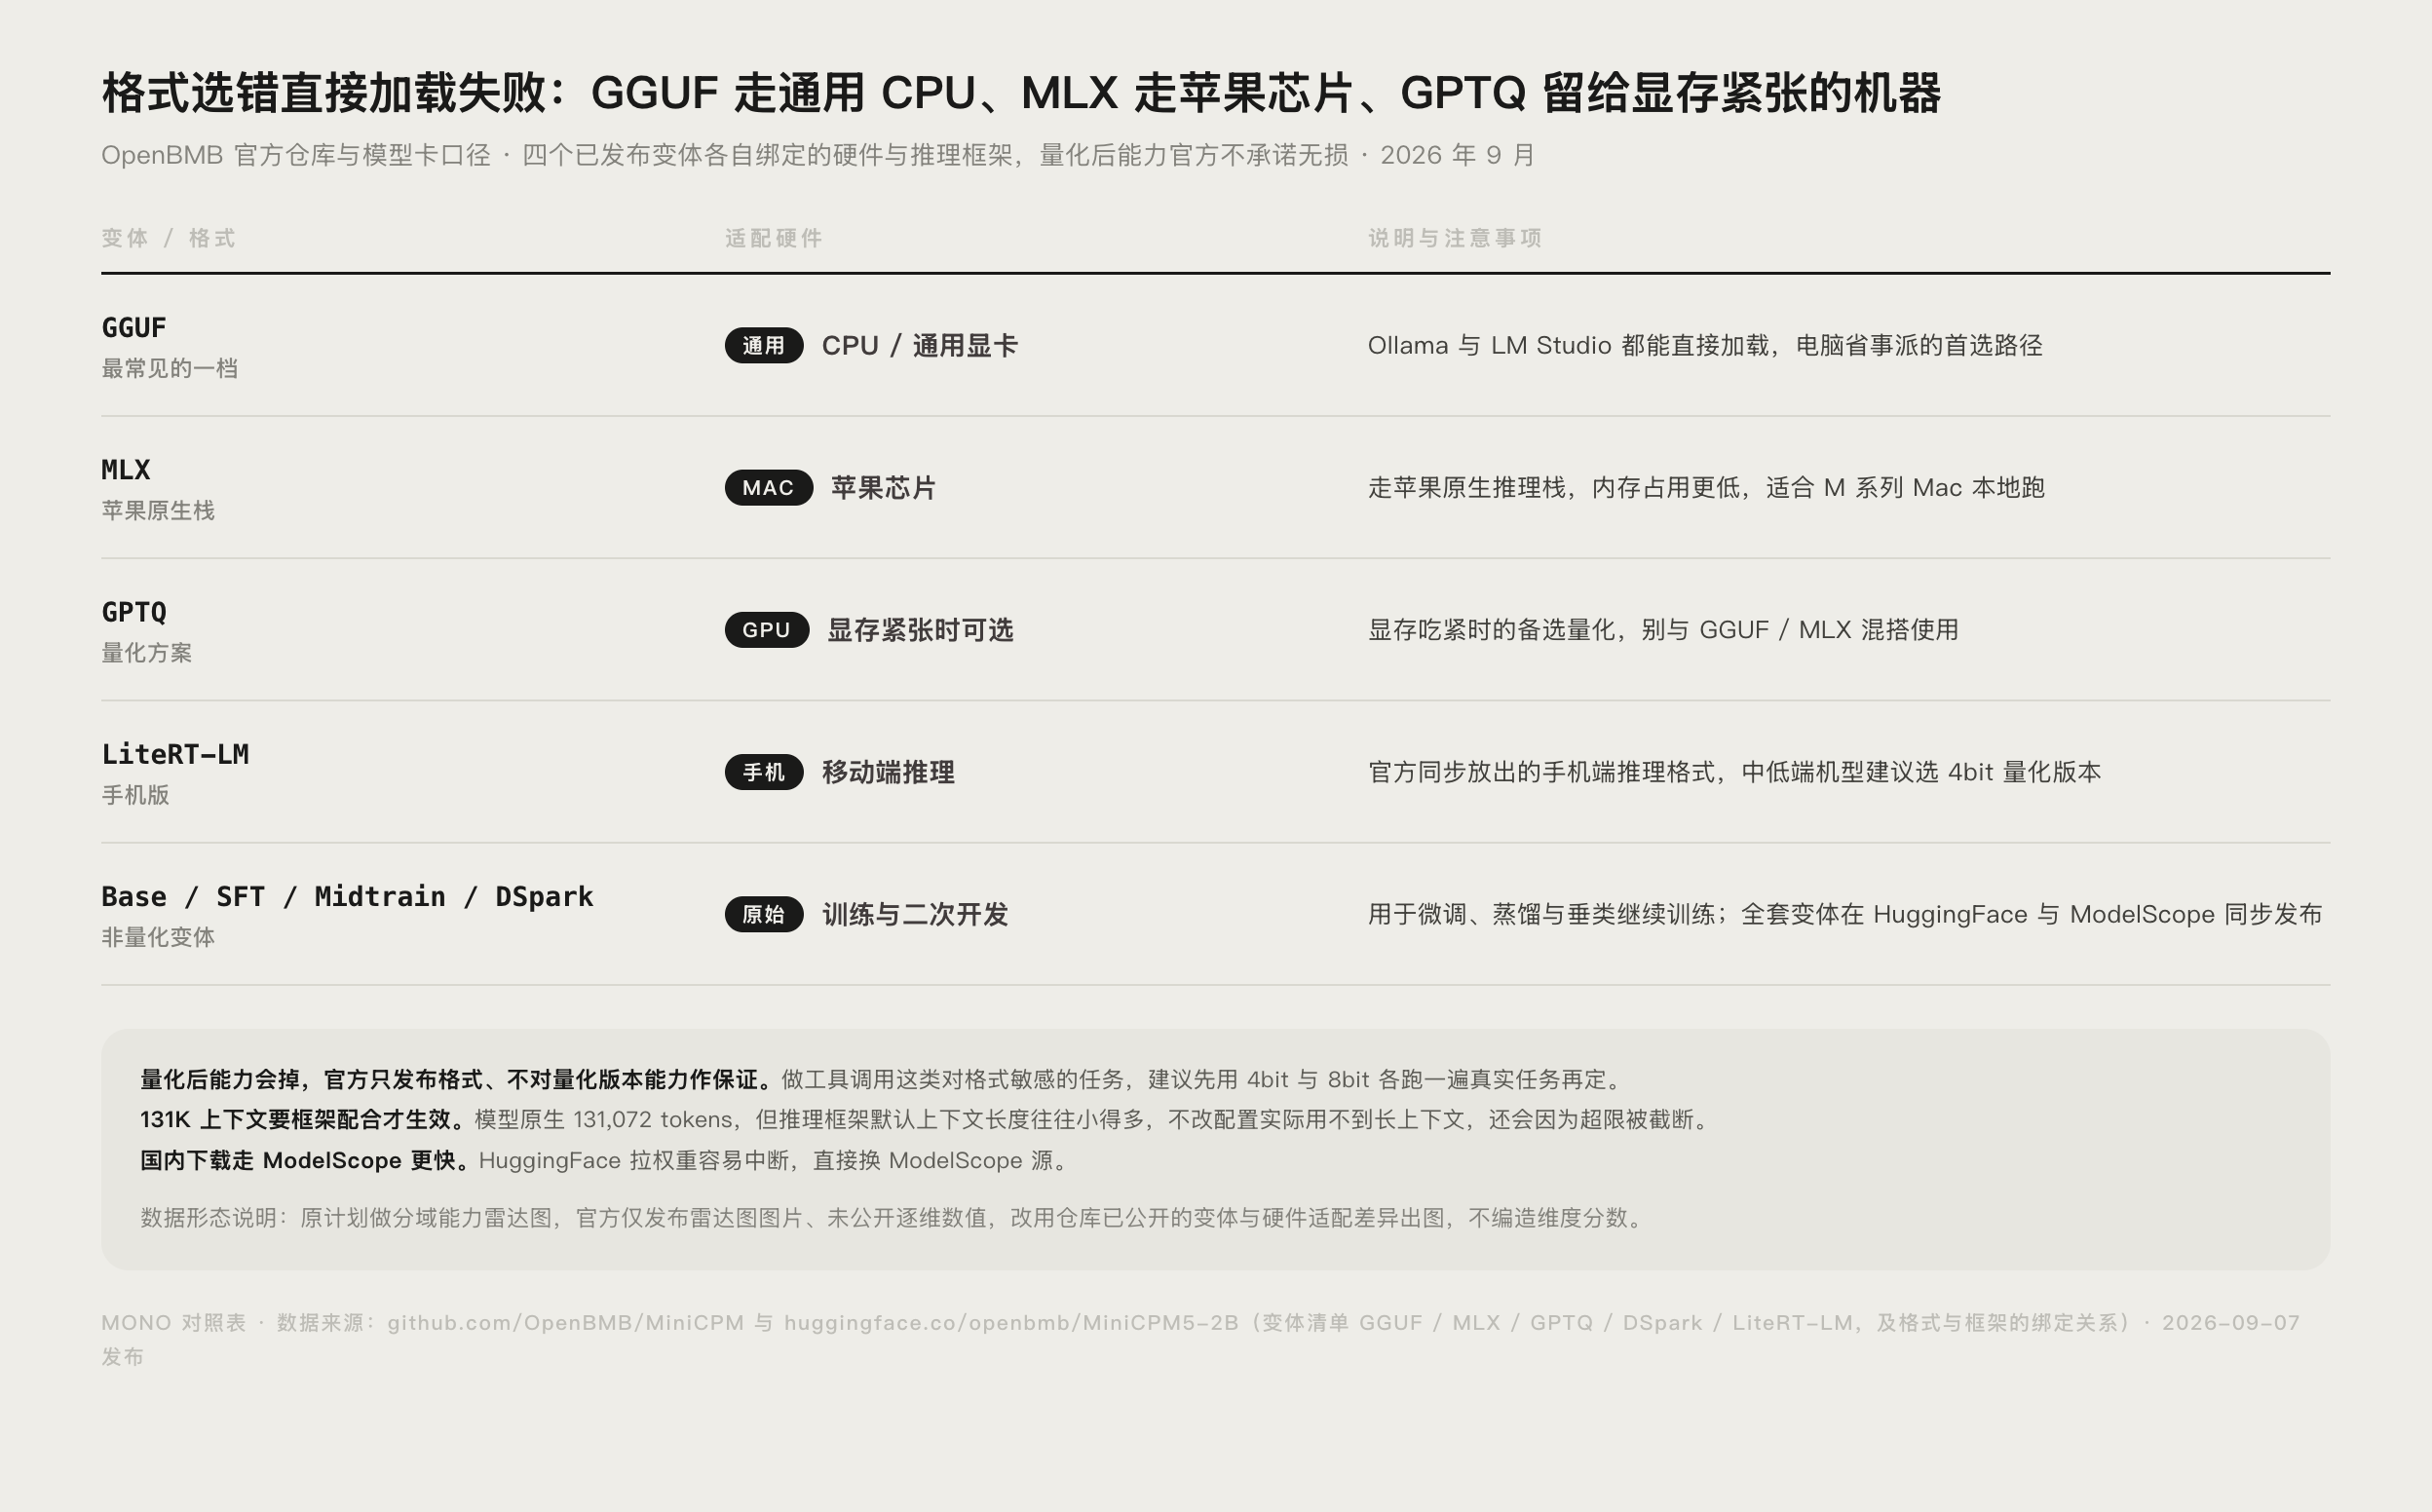
- 量化格式选错会直接加载失败。GGUF、MLX、GPTQ 各自绑定不同推理框架,CPU/通用显卡走 GGUF,苹果芯片走 MLX,GPU 显存紧张可评估 GPTQ,别把格式和框架混搭。
- 量化后能力会掉,官方未承诺无损。官方只发布格式,不对量化版本的能力作保证。做工具调用这类对格式敏感的任务时,建议先用 4bit 与 8bit 各跑一遍你的真实任务再定。
- 131K 上下文要框架配合才生效。模型原生支持 131,072 tokens,但推理框架默认的上下文长度往往小得多,不改配置实际用不到长上下文,还会因为超限被截断。
- 国内下载走 ModelScope 更快。官方在 HuggingFace 与 ModelScope 同步发布全部变体,国内网络下 HuggingFace 拉权重容易中断,直接换 ModelScope 源省事。
- 别把它当通用大模型用。2B 的能力天花板摆在那里,多步骤复杂推理、超长文档深度分析这类任务,它的表现和 30B 级模型不是一个量级。
和 Qwen3.5-4B 这类小模型怎么比
一句话:MiniCPM5-2B 的卖点不是单项第一,而是每 B 参数的效率。它用更小的参数量在平均分上超过对比集中更大的模型,并在编码、数学、长上下文理解、工具使用等维度对同级模型保持优势。设备跑 4B 吃力,它是更务实的选择;显存充裕且追求能力上限,4B 及以上模型仍有空间。想了解另一条小模型路线,可以看站内的 MiniMax H3 解读。
适合谁用,不适合谁
适合:想在手机、笔记本或开发板上跑私有模型的开发者;对数据隐私敏感、不能走云端 API 的场景;做端侧 Agent 和工具调用原型验证的人;想基于开源配方做垂类微调的团队。
不适合:追求顶级推理质量的重任务用户,2B 模型的能力上限摆在那里;没有本地部署条件、只想网页对话的普通用户,直接用官方在线 Demo 更省事。
选型时还可以对照站内的2026 AI 工具分场景推荐,把模型选择放进完整的工具链里看。
常见问题
MiniCPM5-2B 免费吗?可以商用吗?
答:免费。模型以 Apache 2.0 协议在 HuggingFace 与 ModelScope 开源,个人使用和商用都不需要付费,仅需遵守协议条款。
手机真的能跑 MiniCPM5-2B 吗?
答:可以。官方提供了 LiteRT-LM 手机版和 GGUF、MLX、GPTQ 等量化变体,手机和苹果芯片设备都有对应格式,中低端机型建议选 4bit 量化版本。
MiniCPM5-2B 和 MiniCPM5-1B 怎么选?
答:两者同系列同配方,1B 版 2026 年 5 月 19 日发布,2B 版 2026 年 9 月 7 日发布。2B 版能力更强,1B 版速度更快、显存要求更低。设备资源紧张选 1B,追求能力上限选 2B。
上下文窗口有多大,能直接吃长文档吗?
答:原生 131,072 tokens,约十几万字中文文档可以直接放入,不用额外拼接或外挂检索;但需要在推理框架里手动把上下文长度配置开到位。
在哪里下载?国内访问方便吗?
答:HuggingFace 和国内的 ModelScope 都有官方版本,搜索 openbmb/MiniCPM5-2B 即可,国内用户走 ModelScope 更快。
发布了哪些变体和训练数据?
答:模型侧有 Base、SFT、Midtrain、GGUF、MLX、GPTQ、DSpark 等;数据侧公开了 UltraX、UltraData-Code、UltraData-SFT-Agent-2609(50 万条 Agent 样本)、UltraData-RL-2609(8 万条以上 RL 样本)等。
 京ICP备2024094994号-29