
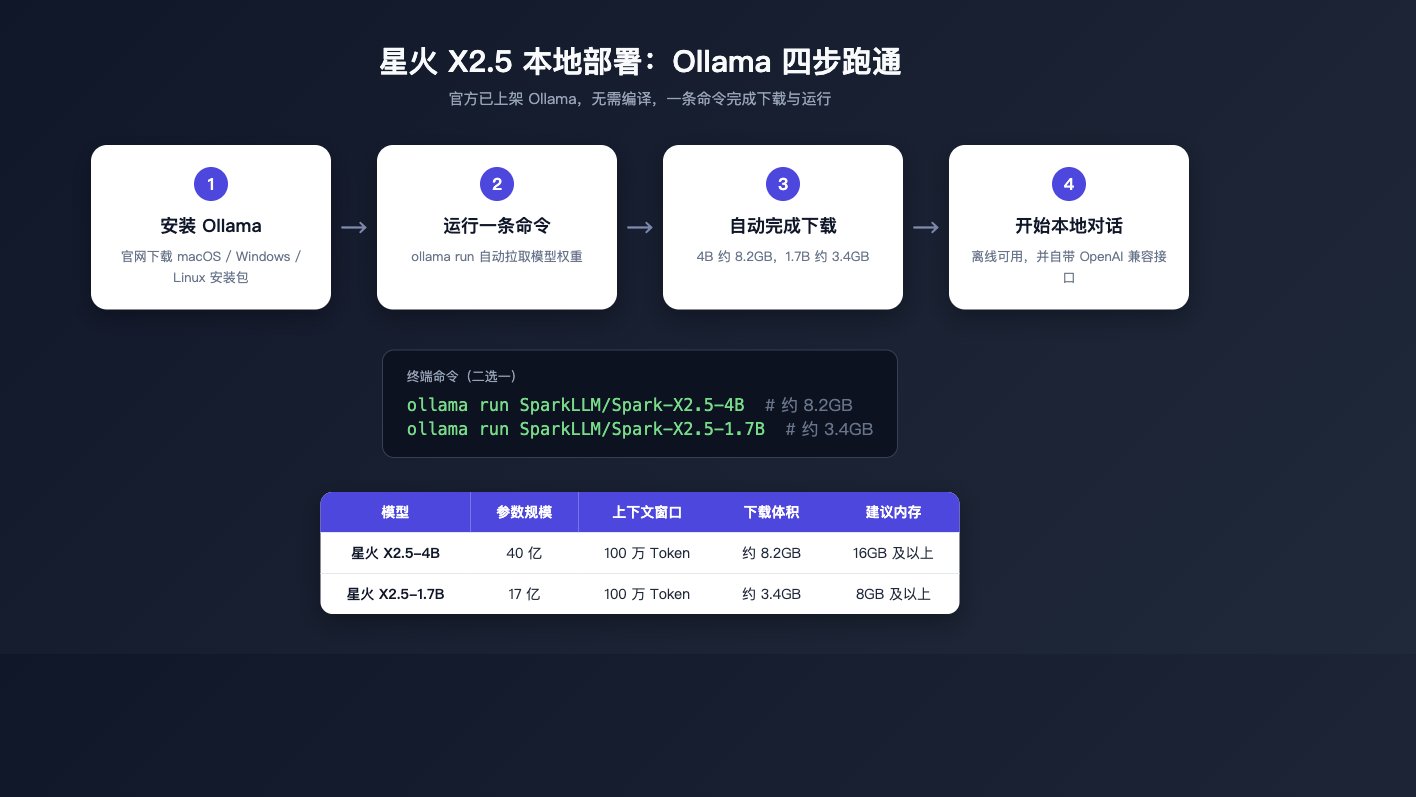
星火X2.5本地部署教程:Ollama一条命令跑通,附下载与手机运行条件
星火X2.5本地部署教程:Ollama一条命令跑通,附下载与手机运行条件
星火X2.5 是科大讯飞子公司「词元星火」2026 年 9 月 1 日开源的端侧大模型系列(4B 和 1.7B 两款),业界首个原生支持 100 万 Token 上下文的端侧模型,Apache 2.0 协议、可免费商用。本地部署最简单的方式是用 Ollama 跑一条命令:
ollama run SparkLLM/Spark-X2.5-4B,下载约 8.2GB 后即可离线对话。本文整理全部官方下载渠道、两种部署方法、硬件要求和手机运行的真实条件,信息核对自官方 GitHub 仓库与 Ollama 模型页。
本文目录
- 星火X2.5 是什么:30 秒看懂
- 两款模型规格与官方成绩速览
- 星火X2.5 下载渠道全表(国内推荐 ModelScope)
- 星火X2.5 本地部署方法一:Ollama 一条命令
- 方法二:LM Studio / llama.cpp + GGUF(含一个必踩的坑)
- 服务器部署:vLLM / SGLang 与完整 100 万上下文
- 手机上能跑吗?一笔内存账
- 和 Qwen3.5-4B 比怎么样?
- 常见问题 FAQ
最后更新于 2026 年 9 月 3 日 · 作者:AI345 指南编辑部
星火X2.5 是什么:30 秒看懂
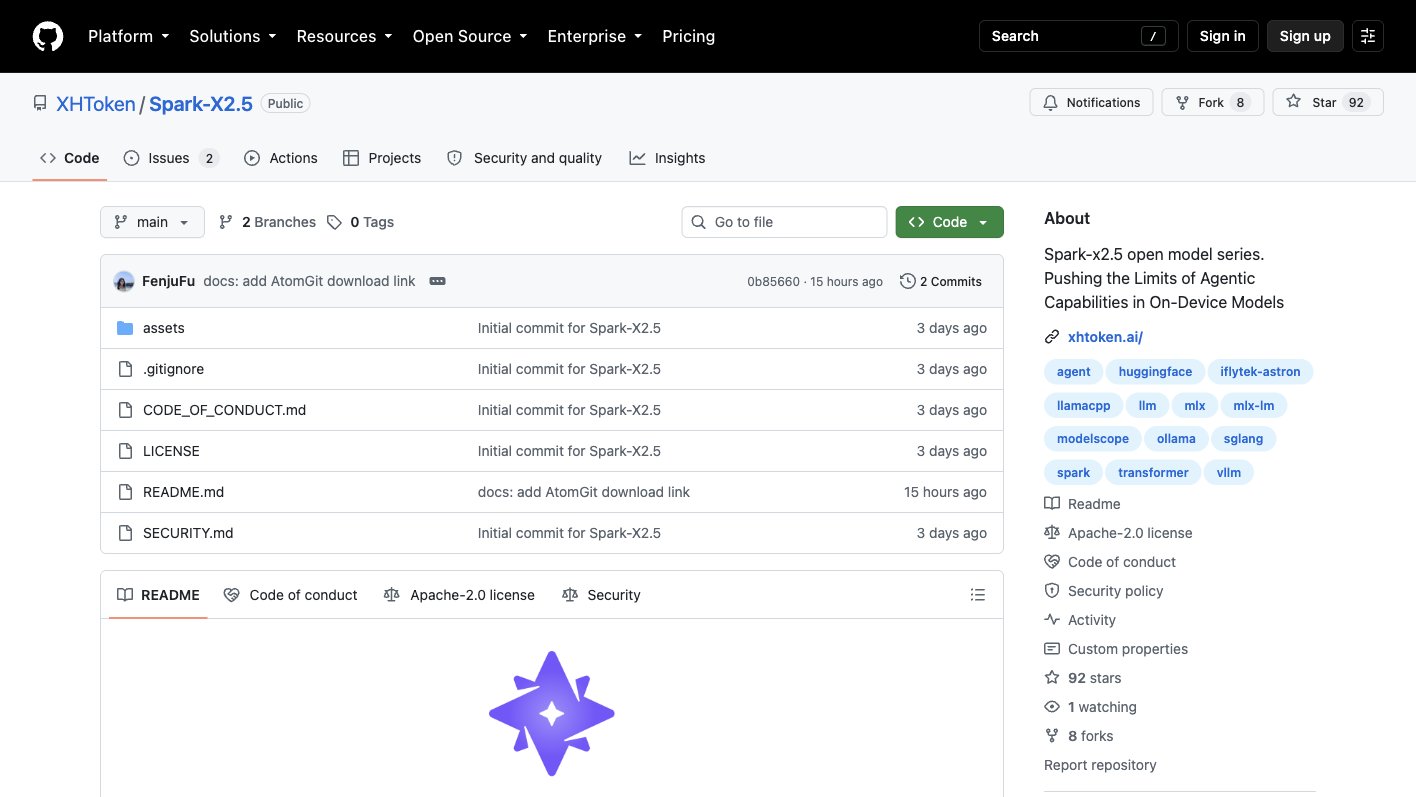
星火X2.5(Spark-X2.5)是科大讯飞全资子公司词元星火在 2026 年 9 月 1 日正式开源的端侧通用大模型,包含 4B 和 1.7B 两个规格。按照官方与中新网的报道,它是业界首个原生支持最长 100 万 Token 上下文窗口的端侧模型——意思是这几 B 参数的小模型,可以一次性"读完"几十万字的整本手册再回答问题,而过去这类能力只存在于云端大模型上。
它解决的问题很实际:手机、汽车座舱、智能家居、机器人这些设备不总是有网,也不适合把隐私数据传到云端。星火X2.5 让设备在本地离线状态下就能完成对话、读长文档、执行多步智能体任务。模型采用 1 层全注意力 + 3 层滑动窗口注意力的混合架构,用约 20 万亿 Token 数据在华为昇腾集群上完成全国产算力训练。
另外提醒:官方预告 9 月 7 日将发布旗舰级通用大模型「星火X2.5」(云端大版本),和本文讲的端侧开源小模型不是一回事,别混淆。
两款模型规格与官方成绩速览
| 项目 | 星火X2.5-4B | 星火X2.5-1.7B |
|---|---|---|
| 上下文窗口 | 1,048,576 Token(原生) | 1,048,576 Token(原生) |
| 语言支持 | 200+ 种 | 200+ 种 |
| 许可证 | Apache 2.0(个人与商用免费) | Apache 2.0(个人与商用免费) |
| Ollama 下载体积 | 约 8.2GB | 约 3.4GB |
| 训练算力 | 华为昇腾集群,全国产化全流程 | 同左 |
官方基准里几组有代表性的成绩(对同量级开源模型):
- SWE-Bench Pro 44.4:高于参数大 2 倍多的 Qwen3.5-9B(33.8),同量级第一;
- AIME 2026 数学 90.7:显著高于 Qwen3.5-4B 的 83.0 和 Gemma4-12B 的 82.1;
- τ³-bench 30.4、MCP-Atlas 54.6:智能体与工具调用能力在同量级里领先(这些基准是什么,可以看我们之前的 AI Agent 评测指标与基准全解);
- 智能家居实测:1.7B 控制指令端到端执行准确率 90.3%,平均响应 0.85 秒。
星火X2.5 下载渠道全表
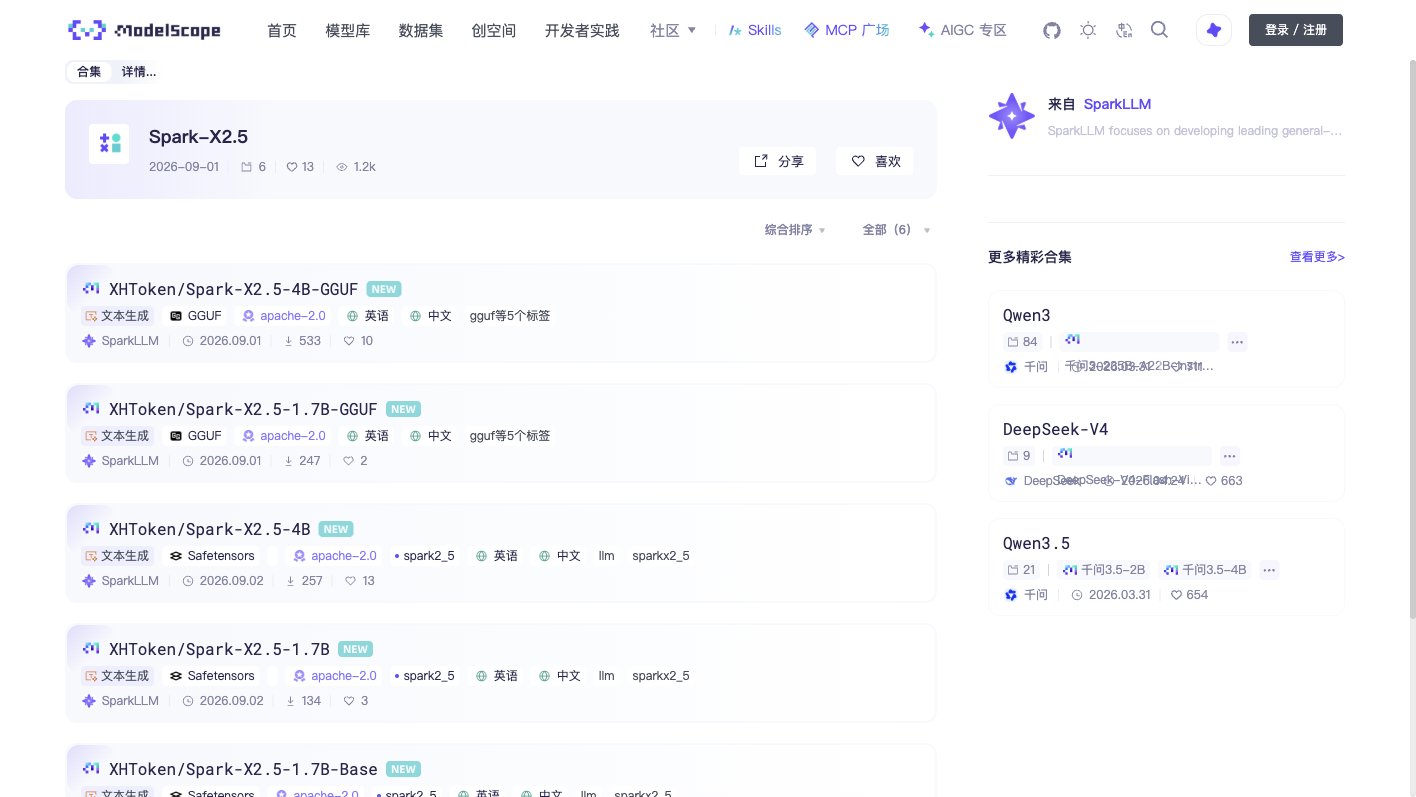
官方权重已同步上架 6 个平台,按你的网络和硬件选:
| 平台 | 入口 | 适合谁 |
|---|---|---|
| ModelScope 魔搭 | modelscope.cn 搜「XHToken/Spark-X2.5」 | 国内用户首选,速度快 |
| Hugging Face | huggingface.co/XHToken 合集 | 海外网络环境 |
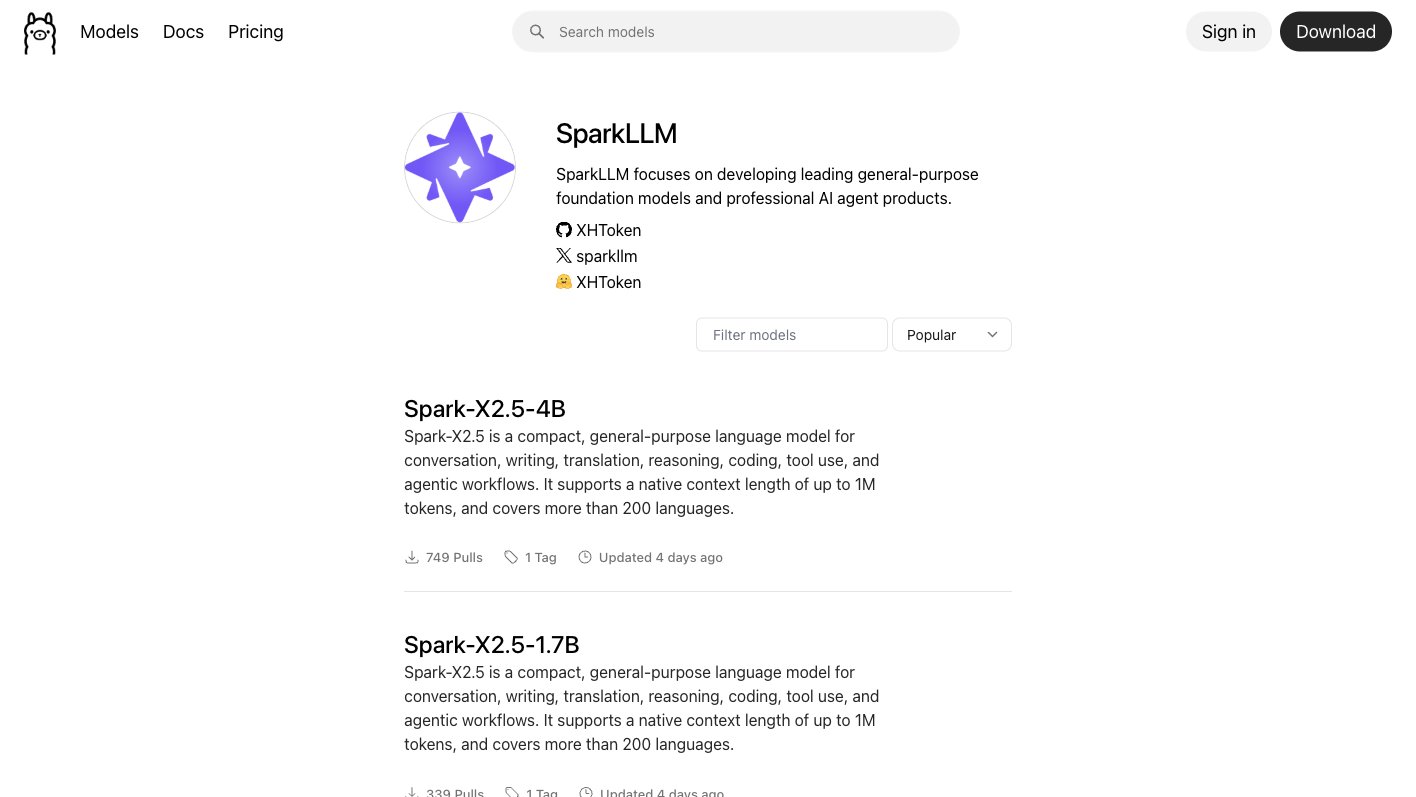
| Ollama | ollama.com/SparkLLM | 想一条命令跑起来的个人用户 |
| Modelers(魔乐) | modelers.cn 搜 XHToken | 昇腾芯片用户 |
| SCNet | scnet.cn | 海光 DCU 用户 |
| AtomGit | ai.atomgit.com | 国内备选 |
注意区分官方账号:GitHub、Hugging Face、ModelScope 上的组织名都是 XHToken("词元"的缩写),Ollama 上是 SparkLLM。下载时认准这两个名字,避免下到第三方改过的权重。官方还提供了 BF16 的 GGUF 单文件版(4B 约 8GB),方便 llama.cpp 系工具直接加载。
星火X2.5 本地部署方法一:Ollama 一条命令跑通
这是目前对个人用户最省事的方式——官方已经直接上架 Ollama 模型库,不需要自己转格式、不需要编译。
步骤:
- 到 ollama.com 下载并安装 Ollama(支持 macOS / Windows / Linux);
- 打开终端,运行:
ollama run SparkLLM/Spark-X2.5-4B
# 内存紧张可换小杯:
ollama run SparkLLM/Spark-X2.5-1.7B
- 首次运行会自动下载模型(4B 约 8.2GB、1.7B 约 3.4GB,实测渠道为 Ollama 官方模型页标注体积);
- 下载完成后直接进入对话,断网也能用。Ollama 会在本地 11434 端口提供 OpenAI 兼容接口,写代码调用的方式和调用其他大模型 API 一致。
两点实测提醒(官方文档没细说的地方):
- 目前 Ollama 上架的是 BF16 精度版本,4B 要占 8GB 以上内存,16GB 内存的电脑跑 4B 比较稳;只有 8GB 内存就老实用 1.7B;
- 两个模型默认开启"思考模式",回答前会先输出一段推理过程;推荐采样参数按官方给的温度 1.0、top_p 0.95 设置即可。
方法二:LM Studio / llama.cpp + GGUF(含一个必踩的坑)
喜欢图形界面的用户可以选 LM Studio,追求极致控制的用户选 llama.cpp。但这里有一个官方文档写了、但很容易被忽略的坑:
星火X2.5 的混合注意力架构用了一些新算子,原版 llama.cpp 和原版 Ollama 并不支持,直接拿官方 GGUF 塞进老版本会加载失败或输出乱码。必须使用词元星火官方 fork 的 llama.cpp(github.com/XHToken/llama.cpp)重新编译,再用它替换 LM Studio 的推理后端,或者按官方仓库 README 里的方法自行编译 Ollama fork。
具体流程(以 LM Studio 为例):
git clone https://github.com/XHToken/llama.cpp.git并编译;- 备份并替换 LM Studio 的
extensions/backends/下对应运行时目录; - 把下载好的 GGUF 放进
models/目录,加载模型即可对话。
如果你的设备是苹果芯片 Mac,还有第三条路:官方的 Spark-MLX-LLM 项目可以直接跑 Hugging Face 原始权重,不需要转 GGUF,对 Apple Silicon 优化更好。想了解 Mac 跑本地模型的完整思路,可以参考我们此前的 Qwen3.8-27B 本地部署指南,量化选型和内存预算的算法是通用的。
服务器部署:vLLM / SGLang 与完整 100 万上下文
要在 GPU 服务器上部署(比如给团队搭内部服务),官方支持两条路线:
- SGLang:官方提供了带 Spark-X2.5 运行时的 Docker 镜像,启动时指定
--context-length 1048576,单卡即可拉满 100 万 Token 上下文; - vLLM:需要先安装官方的 Spark-plugin 适配插件,再正常启动 vLLM 服务。
追求长上下文的场景要注意:100 万 Token 窗口对应的 KV Cache 显存开销不小,建议按官方示例设置 --mem-fraction-static 0.8 并预留余量。微调方面官方推荐 LLaMA-Factory 的 fork 版本做增量训练。
手机上能跑吗?一笔内存账
这是搜索里问得最多的问题,直接给结论:1.7B 有机会、4B 很勉强,且目前都不是"开箱即用"。
按 GGUF 常见量化精度的体积估算(此为理论估算,非实测数据):
| 模型 | BF16 原版 | 4-bit 量化估算 | 手机可行路径 |
|---|---|---|---|
| 星火X2.5-1.7B | 约 3.4GB | 约 1GB 上下 | 8GB 内存手机跑量化版理论可行 |
| 星火X2.5-4B | 约 8.2GB | 约 2.5GB 上下 | 需旗舰机型 + 量化版,体验难保证 |
现实约束有三条:一是目前 Ollama 官方上架的是 BF16 版,手机端要等社区 4-bit 量化版进一步成熟(Hugging Face 上已有第三方 Q8/MLX 量化,Q4 版本还需观察);二是前面说的 llama.cpp fork 问题在手机端同样存在,安卓上走 Termux 编译的门槛不低;三是 100 万 Token 上下文在手机内存里根本放不下,实际可用上下文会小得多。稳妥的判断是:短期内星火X2.5 的主战场是 PC、车机和智能硬件,手机端侧落地要等芯片厂商和手机厂商的适配。小米玄戒 O3 这类主打端侧 AI 算力的芯片(见我们的玄戒 O3 解读)是值得关注的落点。
和 Qwen3.5-4B 比怎么样?
同量级对比(官方基准数据):星火X2.5-4B 在智能体任务(τ³-bench、MCP-Atlas、BrowseComp)和数学(AIME 2026)上领先 Qwen3.5-4B,SWE-Bench Verified 略低(41.6 对 38.8 则是反超)。最大的差异化是原生 100 万 Token 上下文——同量级开源端侧模型里目前没有对手。如果你的场景是"喂一整本手册/一整个代码库再提问",星火X2.5 值得优先试;如果只是日常对话和补全,两者的差距不大,选生态更熟的那个就行。想看另一个开源旗舰的水平,可以读我们的 GLM-5.3 深度评测。
不想折腾本地部署的话,星火X2.5 的 API 已上线讯飞星辰 MaaS 平台并限时免费,可以直接调用对比。
总结
星火X2.5 把"100 万 Token 上下文 + 智能体能力"第一次带进了 4B 级别的开源端侧模型,Apache 2.0 协议对商用友好,官方还同步上架了 Ollama,让个人用户一条命令就能在本地跑起来。对开发者,建议先用 Ollama 试用 1.7B/4B,再按需上 vLLM/SGLang 部署满血上下文;对普通用户,直接用限时免费的官方 API 更省心。9 月 7 日旗舰版发布后,我们会持续更新这篇文章。
主要信息来源:词元星火官方 GitHub 仓库(部署文档与基准数据)、Ollama 官方模型页(下载体积与运行命令)、Hugging Face 官方模型合集、中新网安徽 9 月 1 日报道。文中手机端体积为理论估算,已明确标注。
常见问题
星火X2.5 是免费的吗?可以商用吗?
答:是。模型以 Apache 2.0 协议开源,个人使用和商业使用都免费,只需保留版权声明。权重在 Hugging Face、ModelScope、GitHub 等平台均可直接下载。
星火X2.5 在哪里下载?
答:官方渠道包括 Hugging Face 合集(XHToken/spark-x25)、ModelScope 魔搭、Ollama(SparkLLM)、Modelers、SCNet 和 AtomGit。国内用户推荐 ModelScope,速度快且是官方同步上架。
本地部署最低要什么配置?
答:用 Ollama 跑 1.7B 版约需 8GB 内存电脑(模型文件约 3.4GB);跑 4B 版建议 16GB 内存(模型文件约 8.2GB)。都有显卡会更流畅,但纯 CPU 也能运行,只是生成速度慢。
100 万 Token 上下文本地跑得动吗?
答:分情况。GPU 服务器上用 SGLang 指定 context-length 1048576 可以跑满;个人电脑内存有限,实际能用的上下文远小于 100 万,建议按需截断文档。100 万窗口的意义在于"能力上限",不是让 8GB 内存设备真的一次性吃下百万 Token。
为什么我的 llama.cpp / LM Studio 加载星火X2.5 失败?
答:大概率是用了原版 llama.cpp。星火X2.5 的混合注意力架构包含新算子,需要用官方 fork(github.com/XHToken/llama.cpp)重新编译,或等 llama.cpp 上游合并支持后再用。
星火X2.5 和 9 月 7 日发布的星火X2.5 是什么关系?
答:9 月 1 日开源的是端侧小模型(4B/1.7B),9 月 7 日发布的是旗舰级云端通用大模型「星火X2.5」,主打代码和多步智能体协同。前者跑在你的设备上,后者主要通过 API 和官方应用使用。
 京ICP备2024094994号-29