
腾讯混元 Hy-MT2 是什么?附 Ollama 本地部署与 GGUF 下载教程
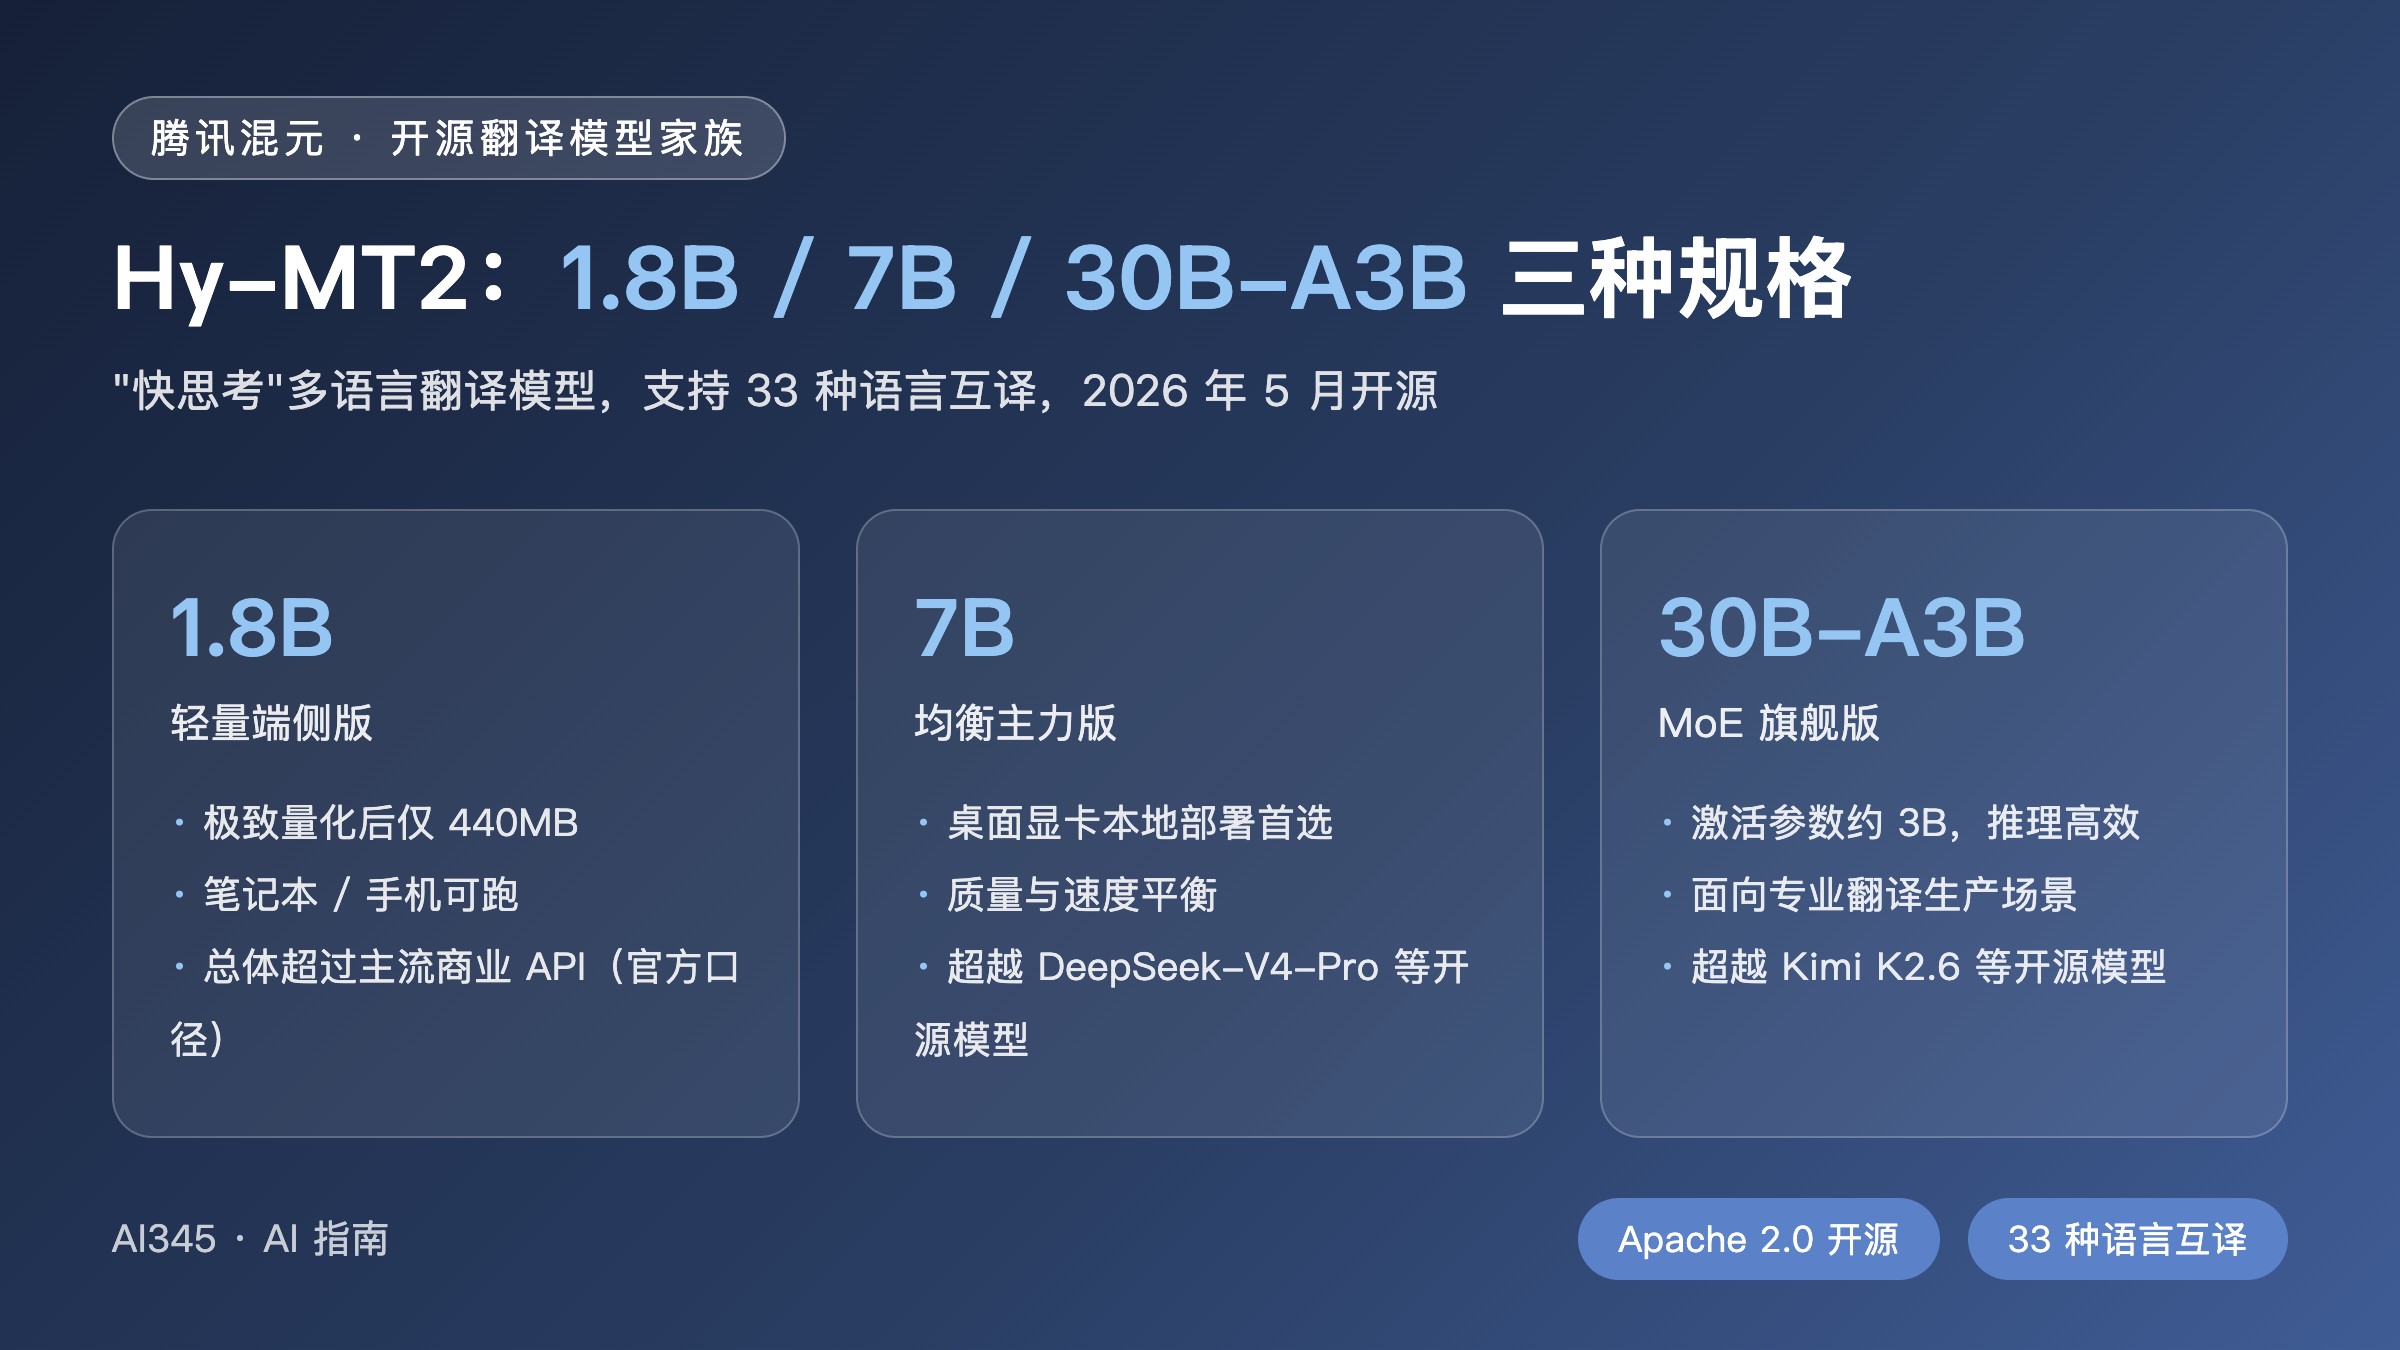
腾讯混元 Hy-MT2 是腾讯 2026 年 5 月 21 日开源的多语言翻译模型家族,包含 1.8B、7B、30B-A3B(MoE)三种规格,支持 33 种语言互译,采用 Apache 2.0 协议,个人和商用都可以免费使用。它不是通用聊天模型,而是专门为翻译任务训练的"快思考"模型——按官方口径,7B 和 30B-A3B 在翻译任务上超越了 DeepSeek-V4-Pro、Kimi K2.6 等开源模型,轻量的 1.8B 版本总体表现也超过微软、豆包等主流商业翻译 API。
这篇文章会讲清楚:Hy-MT2 各规格的区别与怎么选、官方评测成绩、Ollama 一条命令本地部署、官方 GGUF 下载与 llama.cpp 部署、1.8B 手机/端侧安装(440MB 极致量化)、云 API 调用,以及实测中需要注意的坑。
Hy-MT2 是什么:专为翻译而生的模型家族
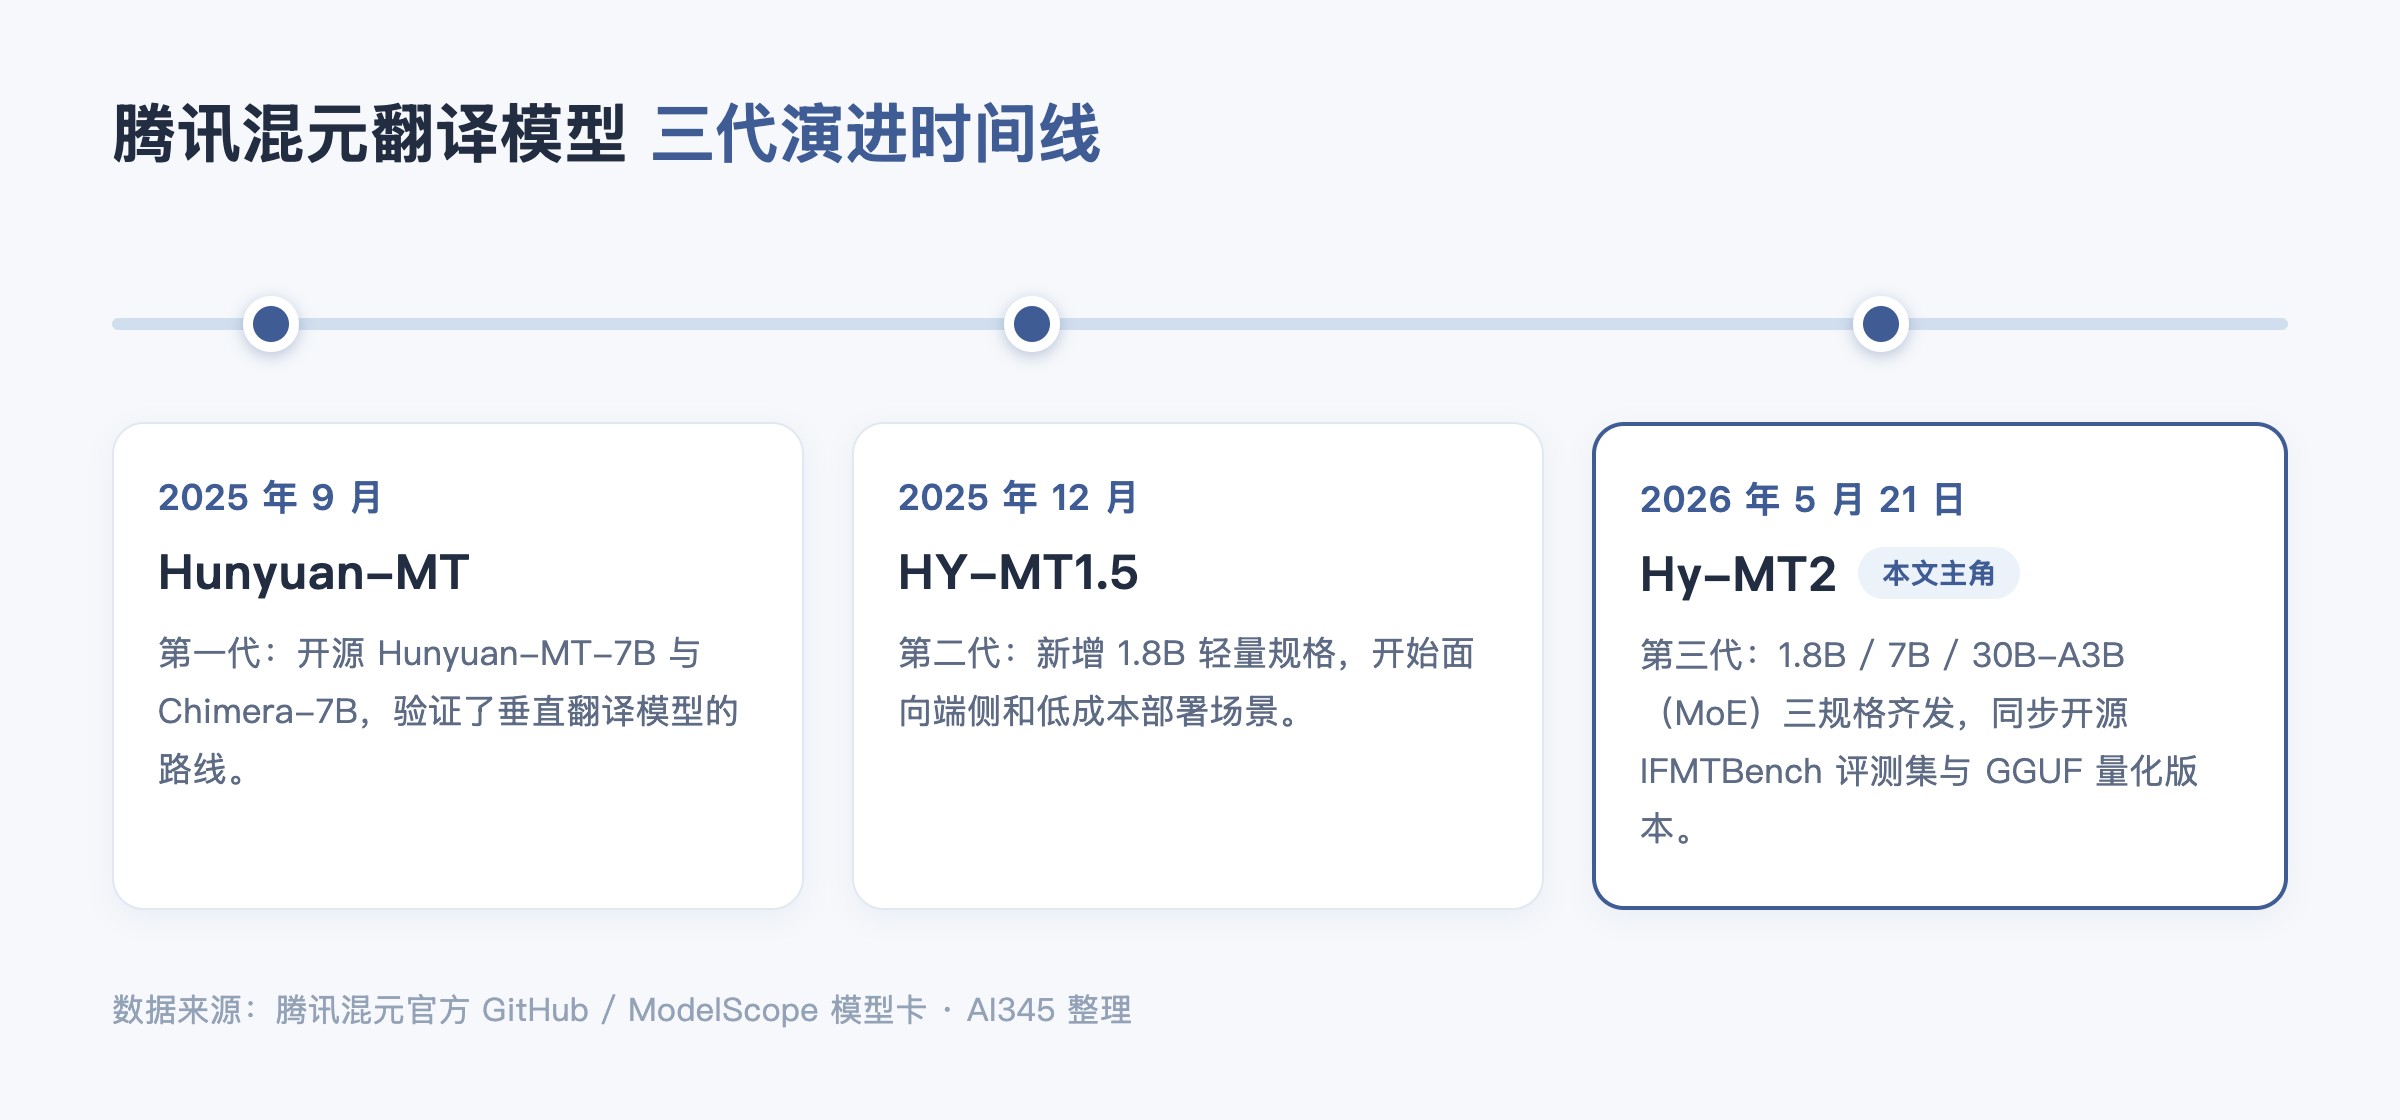
Hy-MT2 是腾讯混元翻译模型系列的第三代。前两代分别是 2025 年 9 月开源的 Hunyuan-MT-7B 和 2025 年 12 月开源的 HY-MT1.5 系列,Hy-MT2 在 2026 年 5 月 21 日一次性开源了三个规格,并同步放出了翻译指令遵循评测集 IFMTBench。
三种规格的定位很清晰:
| 规格 | 类型 | 适合场景 | 特点 |
|---|---|---|---|
| Hy-MT2-1.8B | 轻量稠密 | 笔记本、手机、端侧设备 | 极致量化后仅 440MB,推理速度提升 1.5 倍 |
| Hy-MT2-7B | 主力稠密 | 桌面显卡本地部署 | 质量与速度平衡,个人开发者首选 |
| Hy-MT2-30B-A3B | MoE 旗舰 | 专业翻译生产环境 | 总参数 30B、激活约 3B,质量最高且推理高效 |
它支持中、英、日、韩、德、法、西等 33 种语言互译,并且能听懂翻译指令——比如指定术语表、指定文风、要求保留分隔符等,这是它和通用大模型"顺手翻一下"最大的区别。官方还配套发布了 Hy-MT2-Translator Skill,可以直接把它接入 Agent 工作流做翻译任务;如果你在搭 Agent,可以先看看什么是 AI Agent 补齐概念。
Hy-MT2 的翻译表现如何
根据腾讯混元官方模型卡和技术报告(arXiv):
- 7B 和 30B-A3B:在快思考(fast-thinking)模式下,于通用、真实业务、领域垂直、指令遵循四类翻译任务上,超越 DeepSeek-V4-Pro、Kimi K2.6 等开源模型,达到开源模型最佳水平;
- 1.8B:作为轻量模型,总体表现超过微软、豆包等厂商的主流商业翻译 API;
- 官方与 WMT26 合作:Hy-MT 团队成为 WMT26 视频字幕翻译任务的官方合作方,使用 Hy-MT 系列参赛还有机会获得混元特别奖。
需要说明:以上是官方评测口径。社区实测(知乎部署文)提到 1.8B 版处理短文本问题不大,但输入超过约 1k tokens 后质量会明显下降——这也符合小模型的普遍规律,长文档建议用 7B 或 30B-A3B,或分段翻译。
Hy-MT2 免费吗?协议与下载渠道
免费。 Hy-MT2 全系列在 ModelScope 显示为 Apache 2.0 协议,个人使用、商用都无需付费。官方下载渠道有两个:
- ModelScope(国内推荐):Tencent-Hunyuan 模型页,国内访问速度快;
- Hugging Face:tencent/Hy-MT2 系列合集,含原始权重、FP8、GGUF 各种版本;
- GitHub:Tencent-Hunyuan/Hy-MT2 仓库,含部署脚本和说明。
Hy-MT2 Ollama 本地部署教程
Ollama 官方库目前没有收录 Hy-MT2(搜出来的是社区上传版),想用 Ollama 一条命令跑起来,推荐社区打包的 kaelri/hy-mt2——它直接使用腾讯官方 GGUF 权重,只是补了 Ollama 兼容的提示词模板,权重和推理行为都没有改动。
步骤如下:
- 安装 Ollama(ollama.com 下载对应系统版本);
- 终端执行一条命令拉取并运行:
ollama run kaelri/hy-mt2:1.8b
- 想要更高质量,换 7B 版(需约 6.2GB 显存/内存):
ollama run kaelri/hy-mt2:7b
几个实测要注意的点(来自该模型页的基准测试说明):
- 默认 tag 是 Q6_K 量化,1.8B 体积约 1.5GB;也有 Q4_K_M、Q8_0 可选;
- 模型上下文窗口 256K,但它本质是翻译模型,不要指望它执行翻译之外的指令(测试中指令覆盖行为不可靠);
- 偶尔会输出形如
<|hy-Assistant|>的控制符残留,这是解码副作用,可在参数里配 stop 词过滤; - 社区用 500 条 FLORES-200 中英样本 + COMET 评测,Q6_K 的 1.8B 得分 0.8954,质量不错。
Hy-MT2 GGUF 下载与 llama.cpp 部署
如果你不想经过 Ollama 这层包装,可以直接用官方 GGUF 文件 + llama.cpp:
| 模型 | 用途 | 下载 |
|---|---|---|
| Hy-MT2-1.8B-GGUF | 标准量化(约 4.5GB) | ModelScope |
| Hy-MT2-1.8B-2bit-GGUF | 2bit 极限压缩 | HuggingFace / ModelScope |
| Hy-MT2-1.8B-1.25bit-GGUF | 1.25bit 极致量化,仅 440MB | HuggingFace / ModelScope |
| Hy-MT2-7B-GGUF | 7B 标准量化 | HuggingFace / ModelScope |
以 llama.cpp 为例:
# 编译(首次)
cmake -B build && cmake --build build --config Release

# 启动一个兼容 OpenAI 接口的本地翻译服务
llama-server -m Hy-MT2-1.8B-GGUF-*.gguf --port 8080
官方模型卡里同样提供了 vLLM、SGLang 的部署脚本,生产环境按需选择。调用时记得用官方提示词模板,最基础的格式是:将以下文本翻译为 {目标语言},注意只需要输出翻译后的结果,不要额外解释:{原文},语言名要写全称(如"简体中文""English")。
Hy-MT2-1.8B 手机/端侧安装怎么弄
手机端没有官方 App,可行路径是端侧推理框架 + 极致量化 GGUF:
- 官方为端侧场景用 AngelSlim 做了 1.25bit 极致量化,把 1.8B 模型压到仅 440MB,推理速度还提升了 1.5 倍——这个体积放在手机上完全现实;
- Android 可通过 llama.cpp 的 Android 移植或 Termux 自行编译运行;iOS 侧同理可借助支持 GGUF 的端侧框架加载;
- 再提醒一次局限:1.8B 在超过 1k tokens 的长文本上质量会下降,手机端适合短句、对话式翻译,不适合整篇文章。
如果你的需求只是"手机上随时翻译",不想折腾,直接用混元 App / 元宝的翻译功能或云 API 更省事。
Hy-MT2 API 调用:不想自己部署的选择
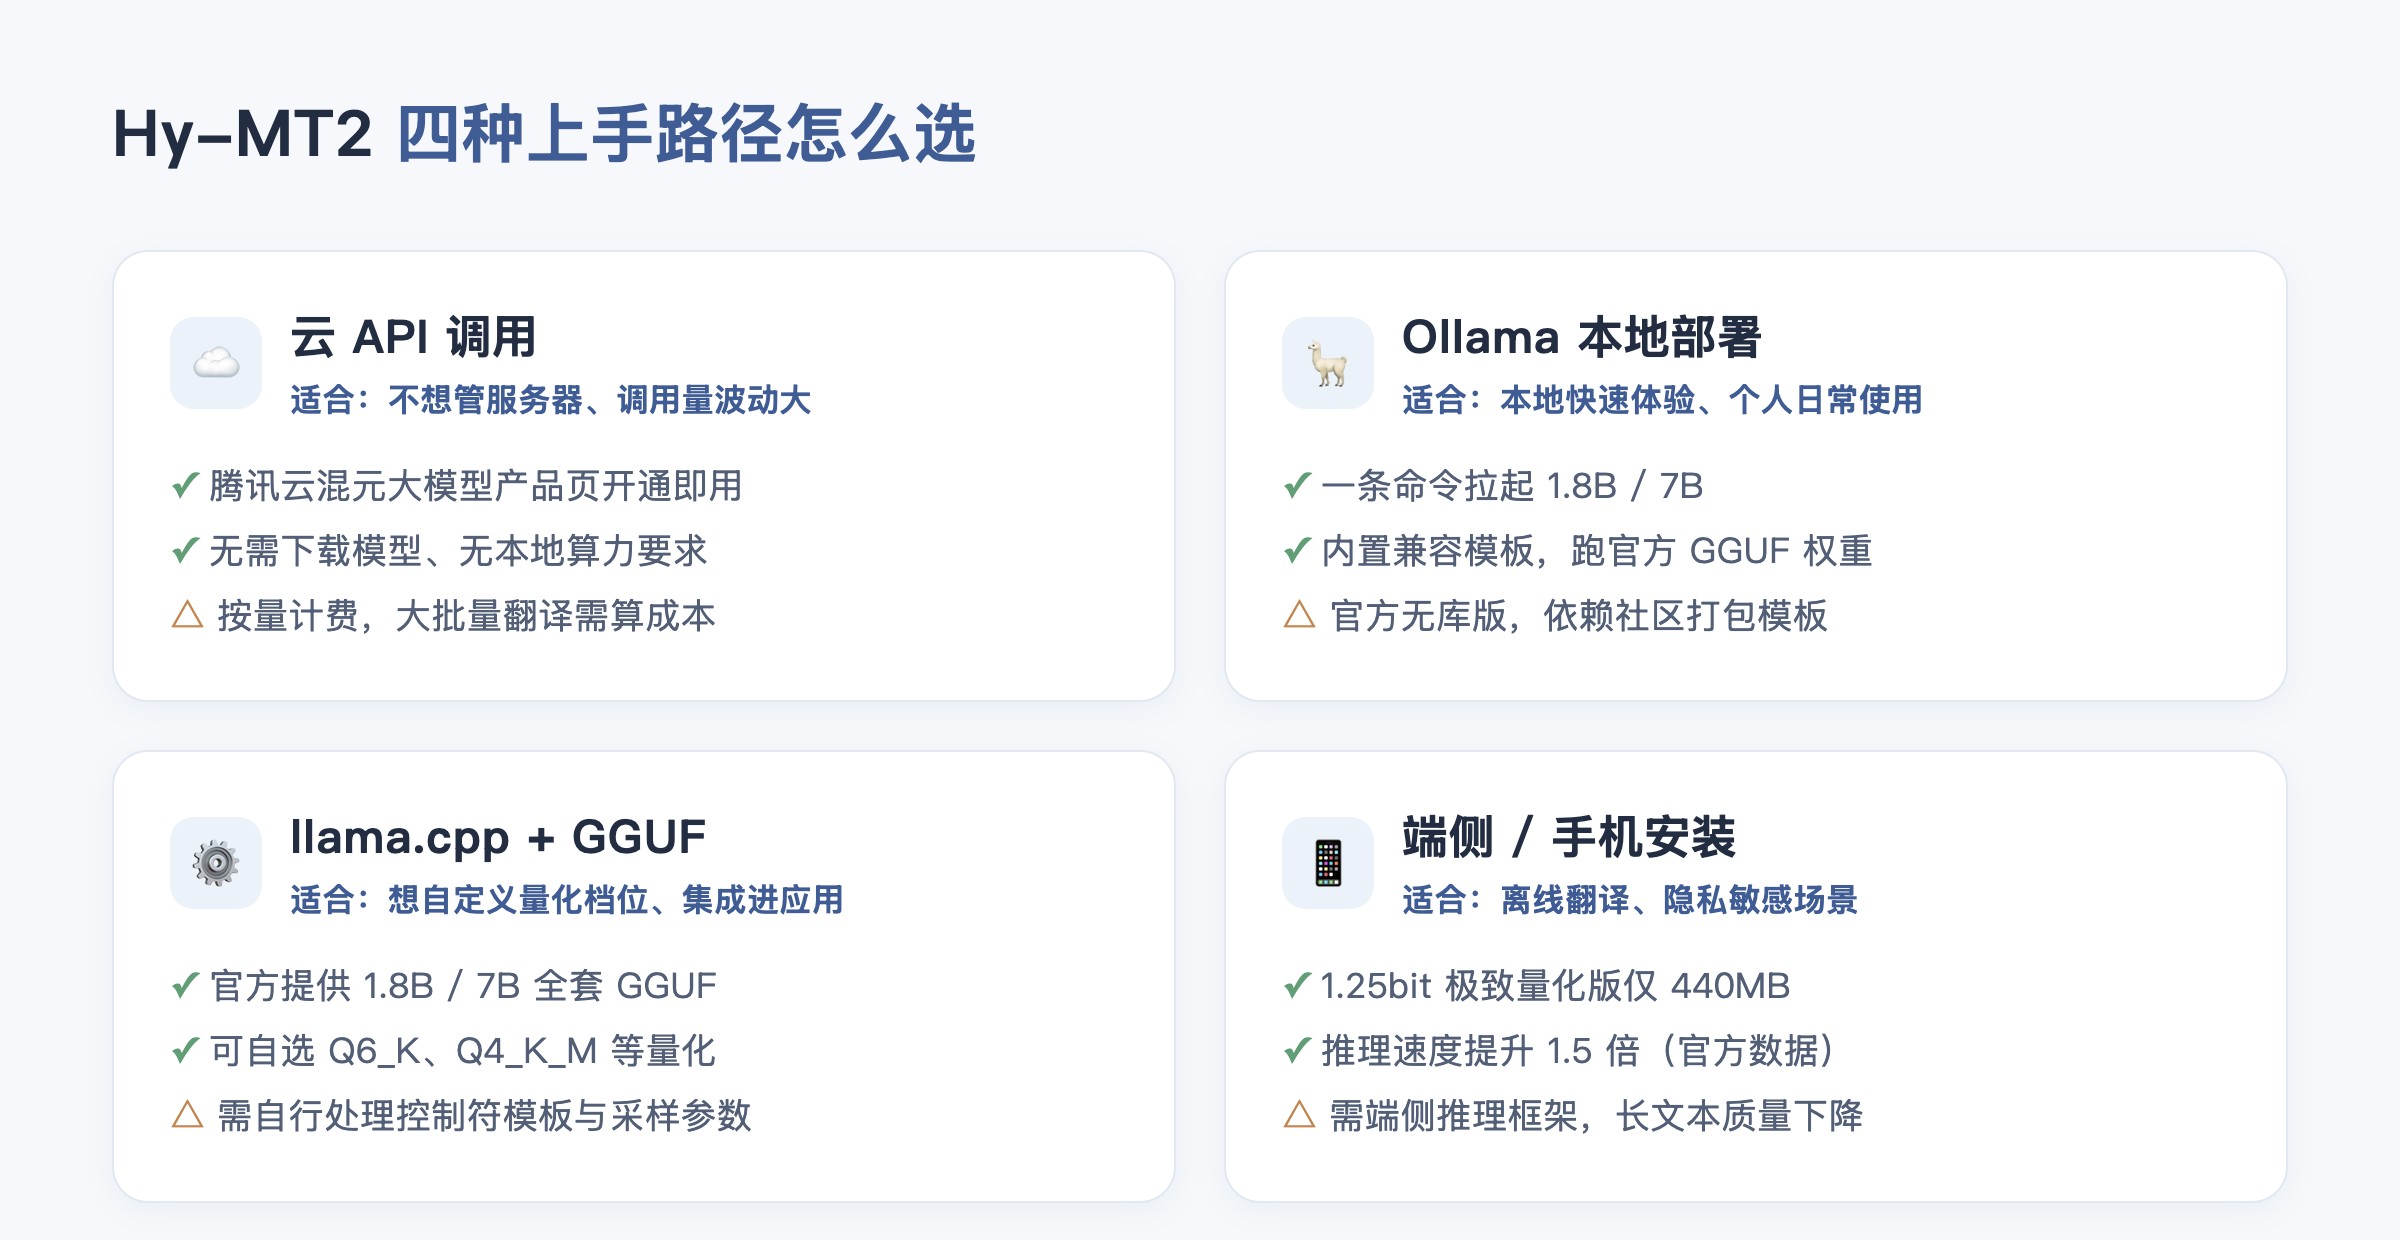
本地部署之外的第四条路是云 API:在腾讯云混元大模型产品页开通后即可通过接口调用混元系列模型,接口兼容 OpenAI 格式,适合调用量波动大、不想维护 GPU 的团队。具体支持的模型 ID 和价格以官网为准,这里不引用会过时的数字。
总结
Hy-MT2 的价值在于把"专业翻译模型"做成了免费开源的三档选择:手机/端侧选 1.8B(440MB 极致量化),桌面本地选 7B(Ollama 一条命令),生产环境选 30B-A3B(MoE 高质量)。上手成本最低的路径是 Ollama + kaelri/hy-mt2;要求完全可控就用官方 GGUF + llama.cpp;不想折腾就用云 API。如果你关注腾讯混元家族的其他模型,可以接着读腾讯混元 Hy4 Preview 发布:新能力与使用要点,做通用能力选型可以参考AI 编程工具怎么选。
最后更新于 2026 年 8 月。本文由 AI345 编辑部基于腾讯混元官方模型卡、GitHub 仓库、arXiv 技术报告及 Ollama 社区实测资料整理撰写,事实性内容均标注了来源链接。
参考资料
常见问题
Hy-MT2 是免费的吗?
是。全系列采用 Apache 2.0 协议开源,个人和商用均免费,权重可在 ModelScope、Hugging Face 免费下载。
hy-mt2 ollama 怎么跑?
Ollama 官方库暂无收录,用社区打包版:`ollama run kaelri/hy-mt2:1.8b`(或 `:7b`),它基于官方 GGUF 权重补了兼容模板。
Hy-MT2-1.8B 手机上能装吗?
可以。用 1.25bit 量化版(440MB)配合支持 GGUF 的端侧推理框架运行,适合短文本离线翻译;长文本建议换大模型或用云 API。
Hy-MT2 和用通用大模型翻译有什么区别?
Hy-MT2 是翻译专精模型,支持术语表、文风控制、分隔符保留等翻译指令,同体积下翻译质量更高,但它不会聊天、不会写代码,指令覆盖不可靠。
为什么我的 Hy-MT2 输出里有奇怪的符号?
那是模型的控制符残留(如 ` `),属于已知解码副作用,配置 stop 序列即可过滤。
1.8B 和 7B 差距大吗?
短文本差距不大,1.8B 官方口径甚至超过主流商业 API;但长文本(超过约 1k tokens)1.8B 质量下降明显,整篇文档翻译建议上 7B 或 30B-A3B。
 京ICP备2024094994号-29