Qwen3.8-Flash-Next 本地部署教程:75GB 内存起步,NVFP4 / GGUF / vLLM 四条路线怎么选
最后更新于 2026 年 8 月 31 日(模型 8 月 26 日开源,本文基于官方仓库、Unsloth 文档与 vLLM/SGLang 官方部署配方整理,day-0 镜像与量化仓库更新频繁,建议收藏后按更新记录对照)
Qwen3.8-Flash-Next 本地部署最低需要 75GB 总内存(1 位 GGUF 量化,RAM、显存或 Mac 统一内存均可),推荐 96GB 以上;RTX 50 系等 Blackwell 显卡可走 NVFP4 量化路线;FP8/BF16 原版权重则面向多卡服务器,FP8 权重就占约 173GB 显存。普通 24GB 显存的消费级显卡跑不动原版权重,这正是网上大量教程没说清楚的地方。下面按你的硬件对号入座。
快速事实速览
| 项目 | 内容 |
|---|---|
| 模型身份 | 通义千问 Qwen4 架构预览版,125B 多模态 MoE,2026 年 8 月 26 日开放权重 |
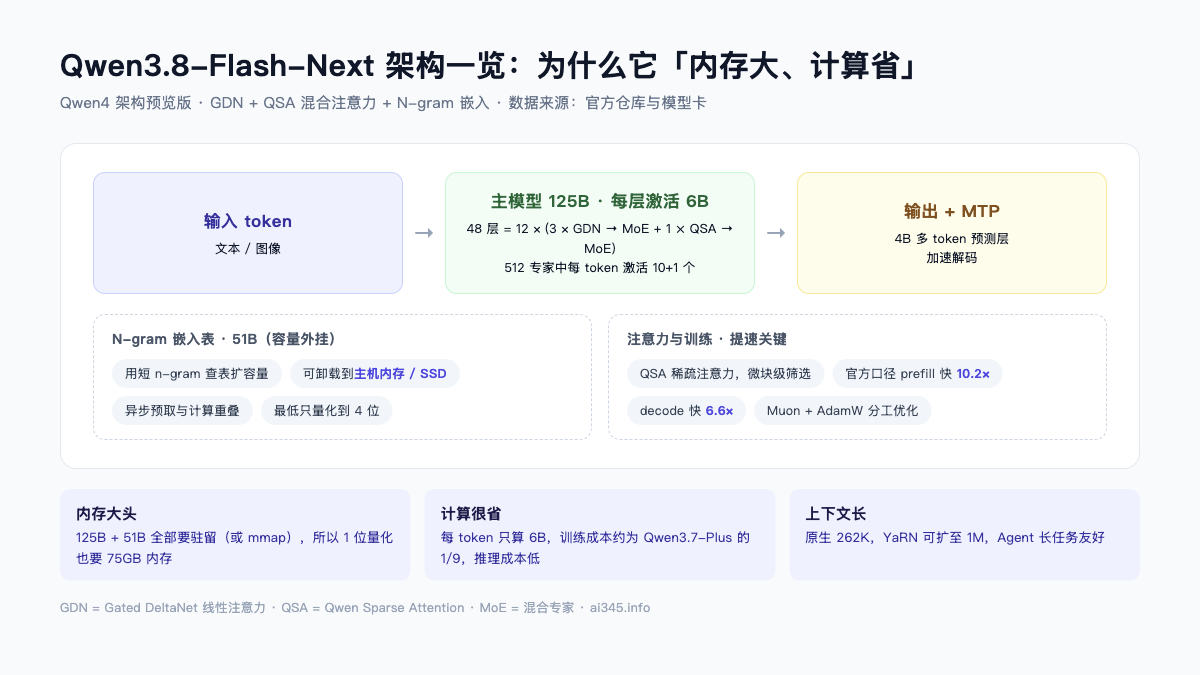
| 参数构成 | 主模型 125B(每 token 激活 6B)+ 51B N-gram 嵌入 + 4B MTP |
| 上下文 | 原生 262,144 token,YaRN 可扩展到 100 万 |
| 最低本地门槛 | 75GB 总内存(1 位 GGUF),推荐 96GB / 128GB |
| 服务器级要求 | FP8 权重约 173GB 显存(建议 ≥265GB),BF16 约 335GB(建议 ≥423GB) |
| 权重地址 | GitHub 仓库 · Hugging Face、ModelScope(国内推荐) |
| 许可 | qwen-community-1.0,商用前务必阅读许可原文 |
先纠正一个误区:激活 6B ≠ 只要 6B 内存
这是目前中文教程里最容易误导人的点。Qwen3.8-Flash-Next 每 token 只激活约 6B 参数,于是不少人以为「6B 模型,一张 16G 显卡就能跑」——错得离谱。
按官方模型卡:主模型 125B、N-gram 嵌入表 51B、MTP 层 4B,全部权重都要驻留在内存或显存里;6B 描述的是每个 token 的计算量,不是存储量。所以它的本地门槛由「总参数量」决定,而不是「激活量」——1 位量化也要 75GB。
理解了这一点,四条路线的选择逻辑就很清晰了:有多少内存/显存,就选哪条路。
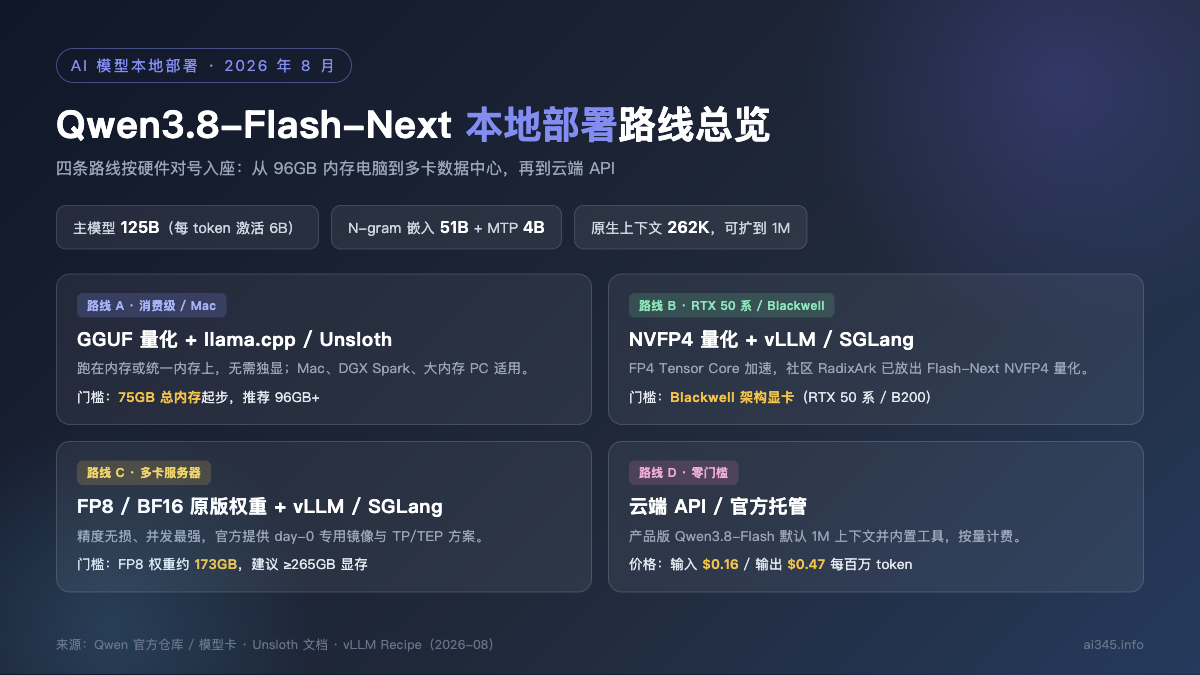
Qwen3.8-Flash-Next 本地部署四条路线怎么选
| 你的硬件 | 推荐路线 | 说明 |
|---|---|---|
| 96GB 内存 PC / Mac Studio 级统一内存 | GGUF 1-2 位 | llama.cpp 或 Unsloth Desktop,无独显也能跑 |
| 128GB 内存 | GGUF 3-4 位 | 准确率明显回升的「甜蜜区」 |
| RTX 50 系 / B200 等 Blackwell 显卡 | NVFP4 | FP4 Tensor Core 加速,vLLM / SGLang |
| 4 卡以上服务器(A800/H200/GB300) | FP8 + vLLM / SGLang | 生产部署,支持高并发与 262K 上下文 |
| 都不满足 | 云端 API | 产品版 Qwen3.8-Flash,按量计费,零门槛 |
它是 Qwen 团队给 Qwen4 打前站的架构预览版:GDN 线性注意力 + QSA 稀疏注意力的混合设计、N-gram 嵌入扩容量、Muon 优化器,官方口径下 QSA 内核带来约 10.2 倍 prefill、6.6 倍 decode 加速。成绩上也确实能打——SWE-bench Pro 62.5 分超过自家 397B 的 Qwen3.7-Plus,LiveCodeBench v6 拿到 91.9。与 Qwen3.8-Flash(托管产品版)、Qwen3.8-27B(小尺寸稠密版)的详细差异,我们在这篇 Qwen3.8 系列对比里单独讲过,不蚕食本文主题。
路线 A:GGUF 量化部署(96GB 内存 / Mac 统一内存)
这是普通用户唯一现实的本地路线。感谢 Unsloth 第一时间放出了 Dynamic GGUF 量化包(国内可从 ModelScope 搜同名仓库下载)。
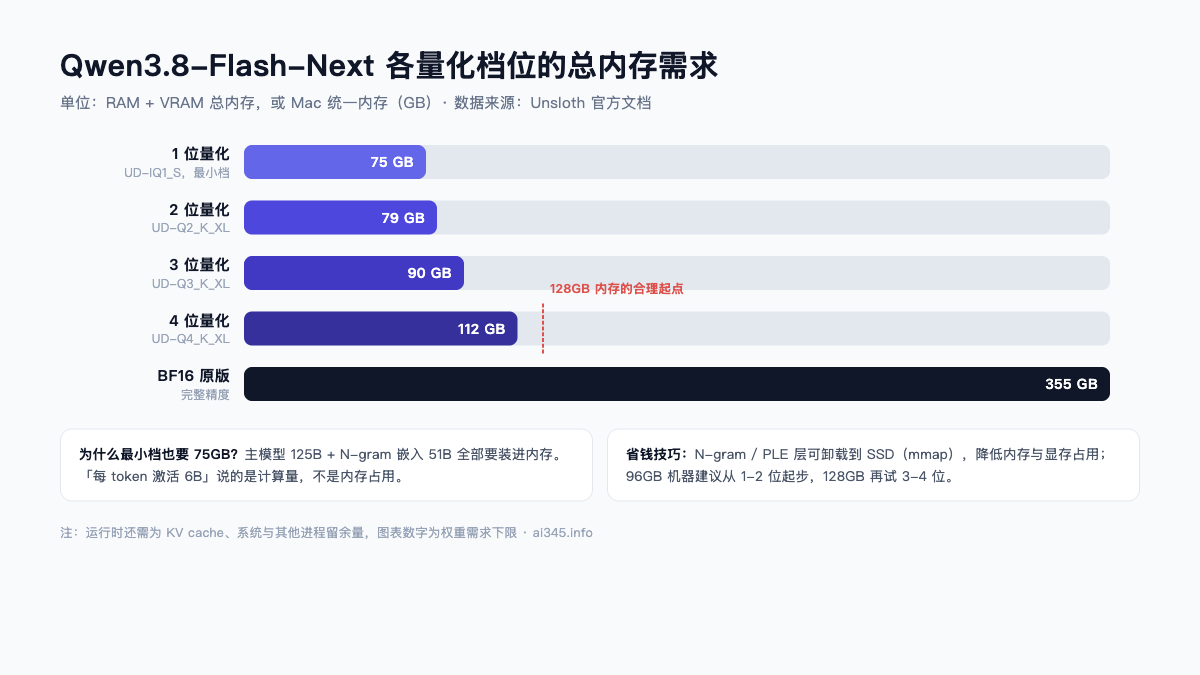
内存要求:75GB 只是下限
| 量化档位 | 总内存需求 | 适合谁 |
|---|---|---|
| 1 位 | 75GB | 96GB 内存机器的起步档 |
| 2 位 | 79GB | 同上,可微调选择 |
| 3 位 | 90GB | 128GB 机器 |
| 4 位 | 112GB | 128GB 机器的舒适上限 |
| BF16 | 355GB | 多卡服务器,别在 PC 上尝试 |
两个省钱细节,官方文档里写了但容易被忽略:
- N-gram / PLE 层可以卸载到 SSD(mmap 机制),能明显降低内存和显存占用,代价是随机访问变慢;
- 视觉多模态需要额外加载 projector 文件,磁盘别只按量化包大小规划。
启动命令:一行搞定
用 llama.cpp(先升级到支持该架构的最新版):
llama serve -hf unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XL
或者用 Unsloth Desktop(macOS / Windows / Linux 都支持,自动处理卸载和多 GPU):
unsloth run --model unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XL
注意两点:96GB 内存的机器不要照抄 UD-Q4_K_XL,换成 UD-IQ1_S 或 UD-Q2_K_XL;context 别从 262144 起步,先用 8K 或 16K 跑通,再逐级加大。
该选哪一档?看体积换准确率的账
Unsloth 用 KLD 评估给出了各档的准确率恢复数据,我们整理成一张图:
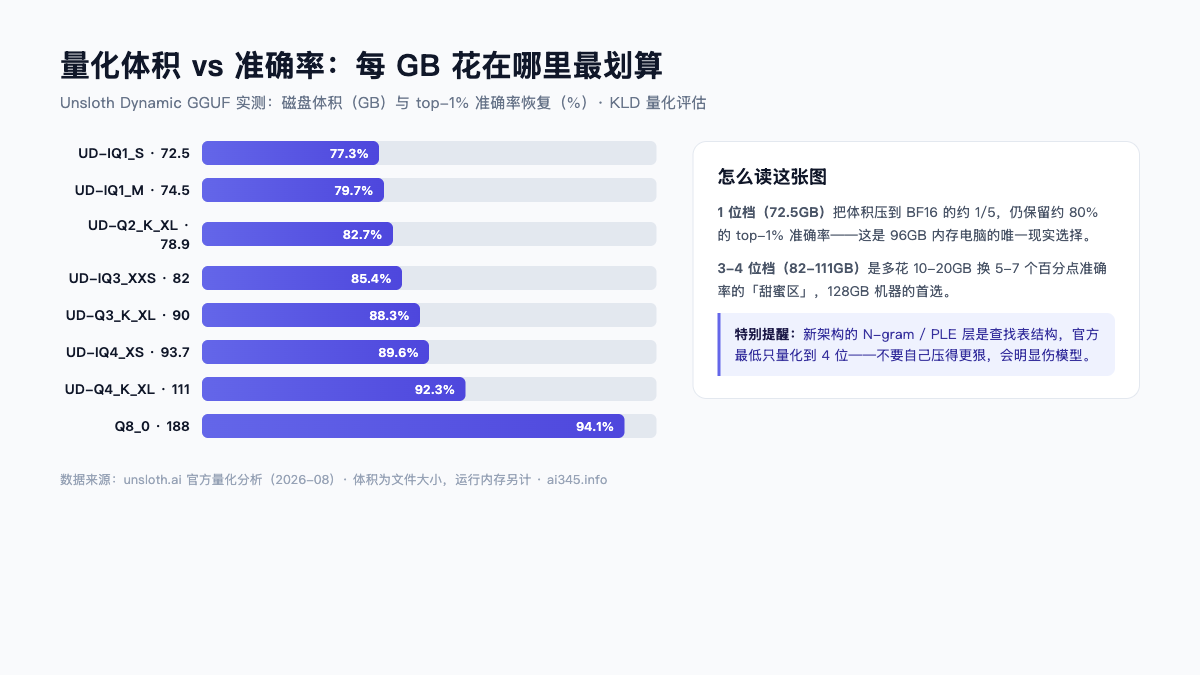
结论很直接:1 位档用 1/5 的体积保住了约 80% 的 top-1% 准确率,是 96GB 机器的唯一现实选择;128GB 机器直接上 3-4 位档,每多花 10-20GB 磁盘能换 5-7 个百分点。另外一个坑:新架构的 N-gram/PLE 层是查找表结构,官方最低只量化到 4 位,不要用第三方更激进的量化版本,会明显伤模型。
一个来自社区的真实参照:知乎上有作者用 4×V100 32G 实测 Flash-Next,同机对比 27B 模型,8K prefill 速度慢约 4-5 倍——MoE 大模型的「每 token 便宜」在老架构显卡上未必兑现成速度,动手前先想清楚自己的显卡代际。
路线 B:NVFP4 量化(RTX 50 系 / Blackwell 显卡)
搜「qwen 3.8 flash next nvfp4」进来的朋友看这一节。
NVFP4 是 NVIDIA 原生 4 位浮点格式,只在 Blackwell 架构上有效(RTX 50 系、B200/B300、DGX Spark),配合 FP4 Tensor Core 可以做到 W4A4 的真 4 位矩阵乘,速度远超 W4A16 的传统 4 位量化。
当前可选的 Flash-Next NVFP4 量化:
- RadixArk/Qwen3.8-Flash-Next-NVFP4:社区里下载量最高的一版(发布一周内 9 万+ 下载),基于 NVIDIA ModelOpt 制作,vLLM/SGLang 均有适配;
- Unsloth 官方 NVFP4 系列目前只到 Qwen3.8-27B,Flash-Next 的 NVFP4 还没出,追更可以留意 Unsloth 的 NVFP4 文档。
为什么值得等/值得用:NVFP4 相比 MXFP4 用更小的块(16 vs 32)和 FP8 缩放因子,异常值隔离更好、准确率更高;Unsloth 在 Qwen3.6/27B 上的基准显示其 Dynamic NVFP4 版本能比普通 NVFP4 再快约 1.5-2.5 倍,同时 MMLU-Pro、GPQA、AIME 成绩与 FP8 几乎持平。这套经验大概率会延续到 Flash-Next。
一句话判断:你的显卡是 RTX 50 系或更老的(30/40 系),NVFP4 跟你没关系——老卡走 GGUF 或 W4A16 社区量化即可。
路线 C:服务器级 FP8/BF16 部署(vLLM / SGLang)
面向有 A800/H20/H200/GB300 等多卡机器的团队。官方提供 day-0 支持,两个引擎都要用专用版本:
显存先算清
按 vLLM 官方配方(recipes.vllm.ai):
- FP8 权重约 172.78 GiB,建议至少 265GB GPU 显存(如 4×GB300、8×H20);
- BF16 权重约 335.28 GiB,建议至少 423GB;
- 以上是权重,KV cache、视觉 projector、并发缓冲都要另算余量。
vLLM 启动示例(4 卡 FP8)
vllm serve Qwen/Qwen3.8-Flash-Next-FP8 \
  --tensor-parallel-size 4 --gpu-memory-utilization 0.90 \
  --enable-prefix-caching \
  --enable-auto-tool-choice --tool-call-parser qwen3_coder \
  --reasoning-parser qwen3
注意:vLLM 需专用镜像 vllm/vllm-openai:qwen38-flash-next;8×H200 跑 FP8 应使用 TEP8(张量并行 + 专家并行组合),不能照搬普通 TP8;OOM 时优先加 TP 数、降 --max-model-len,或设 VLLM_PLE_CPU_OFFLOAD=1 把 N-gram 表挪进主机内存。
SGLang 启动示例
docker pull lmsysorg/sglang:qwen38flashnext
sglang serve --model-path Qwen/Qwen3.8-Flash-Next-FP8 \
  --port 8000 --tp-size 4 --context-length 262144 \
  --reasoning-parser qwen3 --tool-call-parser qwen3_coder
AMD 显卡用 lmsysorg/sglang-rocm:qwen38flashnext 镜像,别和 CUDA 版混用。部署细节见 SGLang 官方 cookbook。
想上 100 万上下文
原生 262K 之外,vLLM 需显式开 YaRN:
VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 vllm serve Qwen/Qwen3.8-Flash-Next-FP8 \
  --tensor-parallel-size 4 \
  --rope-scaling '{"rope_type":"yarn","factor":4.0,"original_max_position_embeddings":262144}' \
  --max-model-len 1000000
扩到 1M 前先做一轮质量回归,别直接上生产。
没有硬件怎么办:云端 API 一样能用
本地部署不是必须的。产品版 Qwen3.8-Flash(基于 Flash-Next,默认 1M 上下文、内置工具)已在 Qwen 官方 API 提供,官方博客口径的价格为输入 $0.16 / 输出 $0.47 每百万 token。按这个价格,偶发调用一年的 API 费可能还不够一张 96GB 内存的内存条,低频用户没必要硬上本地。
本地部署常见坑(社区实测汇总)
- 模型加载成功 ≠ 能用:进程不 OOM 只是第一关。启动后先打
/v1/models确认加载的不是 27B 或错误量化档,再记录首 token 延迟和稳定生成速度; - 系统持续 swap / 被 OOM killer 杀掉:内存不够还硬上,换更低量化档,或把 PLE/N-gram 卸载到 SSD;
- 上下文拉满后工具调用 JSON 损坏:先降 context 复测,Agent 场景别默认 262K;
- 跑 Agent 任务只看自然语言回答:务必测一次结构化工具调用,检查工具名、参数和下一轮工具结果是否被正确保留;
- 手抄分片路径出错:Unsloth 长文档的手动下载示例目前有笔误,优先用仓库别名(
-hf unsloth/...:量化档)下载,别手拼 shard 文件名。
内存只有 16-48GB 的 Mac 用户不用强上 Flash-Next,Qwen3.8-27B Mac 16GB 本地部署指南是更务实的选择;准备为本地大模型升级硬件的话,可以看看我们对 Mac Studio / Mac mini 新机型的分析,统一内存是大模型本地部署目前性价比最高的路线之一。
总结
Qwen3.8-Flash-Next 把 Qwen4 的架构提前交到了社区手里,也把「本地跑 125B MoE」的门槛压到了 75GB 内存——这是它作为 Qwen3-Next 精神续作最大的实用价值。行动建议按硬件三步走:96GB 内存选 GGUF 低比特档先跑通;RTX 50 系用户等/用 NVFP4 版本接 vLLM;没有硬件的用 Qwen3.8-Flash API。本文所有数字均来自官方仓库、模型卡、Unsloth 文档与 vLLM/SGLang 官方配方(引用见文中链接),day-0 生态变化很快,更新记录会持续维护在文首。
作者:AI345 编辑部(专注开源模型与 AI 工具的实测与本地部署内容) 相关阅读:Qwen3.8 系列对比 · Qwen3.8-27B Mac 本地部署 · 什么是 AI Agent
常见问题
Q:Qwen3.8-Flash-Next 本地部署最低要什么配置?
A:1 位 GGUF 量化最低 75GB 总内存(RAM、显存或 Mac 统一内存均可),推荐 96GB 起步、128GB 舒适。消费级 24GB 显存显卡跑不动任何一档,请选 27B 或云端 API。
Q:每 token 只激活 6B,为什么不能跑在 16GB 显卡上?
A:6B 是计算时的激活量,125B 主模型 + 51B N-gram 嵌入 + 4B MTP 全部权重都要驻留在内存/显存里,存储门槛由总参数量决定。
Q:NVFP4 量化用的是什么显卡?
A:只有 NVIDIA Blackwell 架构支持(RTX 50 系、B200/B300、DGX Spark)。RTX 30/40 系等老卡用不了 NVFP4,请走 GGUF 路线。
Q:GGUF 和 NVFP4 怎么选?
A:有 Blackwell 显卡且要接 vLLM/SGLang 服务,选 NVFP4(更快);96-128GB 内存电脑或 Mac,选 GGUF(门槛最低)。两者不是竞争关系,是硬件决定的。
Q:Qwen3.8-Flash-Next 和 Qwen3.8-Flash 是同一个模型吗?
A:不是。Flash-Next 是开放权重的架构预览版(本地部署的对象);Flash 是基于它、面向生产的托管版本,默认 1M 上下文并内置工具,走 API 调用。
Q:商用要付费吗?
A:权重采用 qwen-community-1.0 许可,不是传统开源协议,商用和再分发前请直接阅读许可原文,不要只看标签。
 京ICP备2024094994号-29