
模型量化是什么?一次讲透 GGUF 与 Q4 Q8 的含义
一个几十 GB 的大模型,能被塞进 8GB 显存的家用显卡里跑,靠的不是魔法,是量化。一句话定义:模型量化(quantization)是把模型权重从高精度数字(如 16 位浮点数)压缩成低精度数字(如 4 位整数)的技术,用一点点精度损失,换来数倍的存储和显存缩减。
先懂一个前提:模型本来就是一堆数字
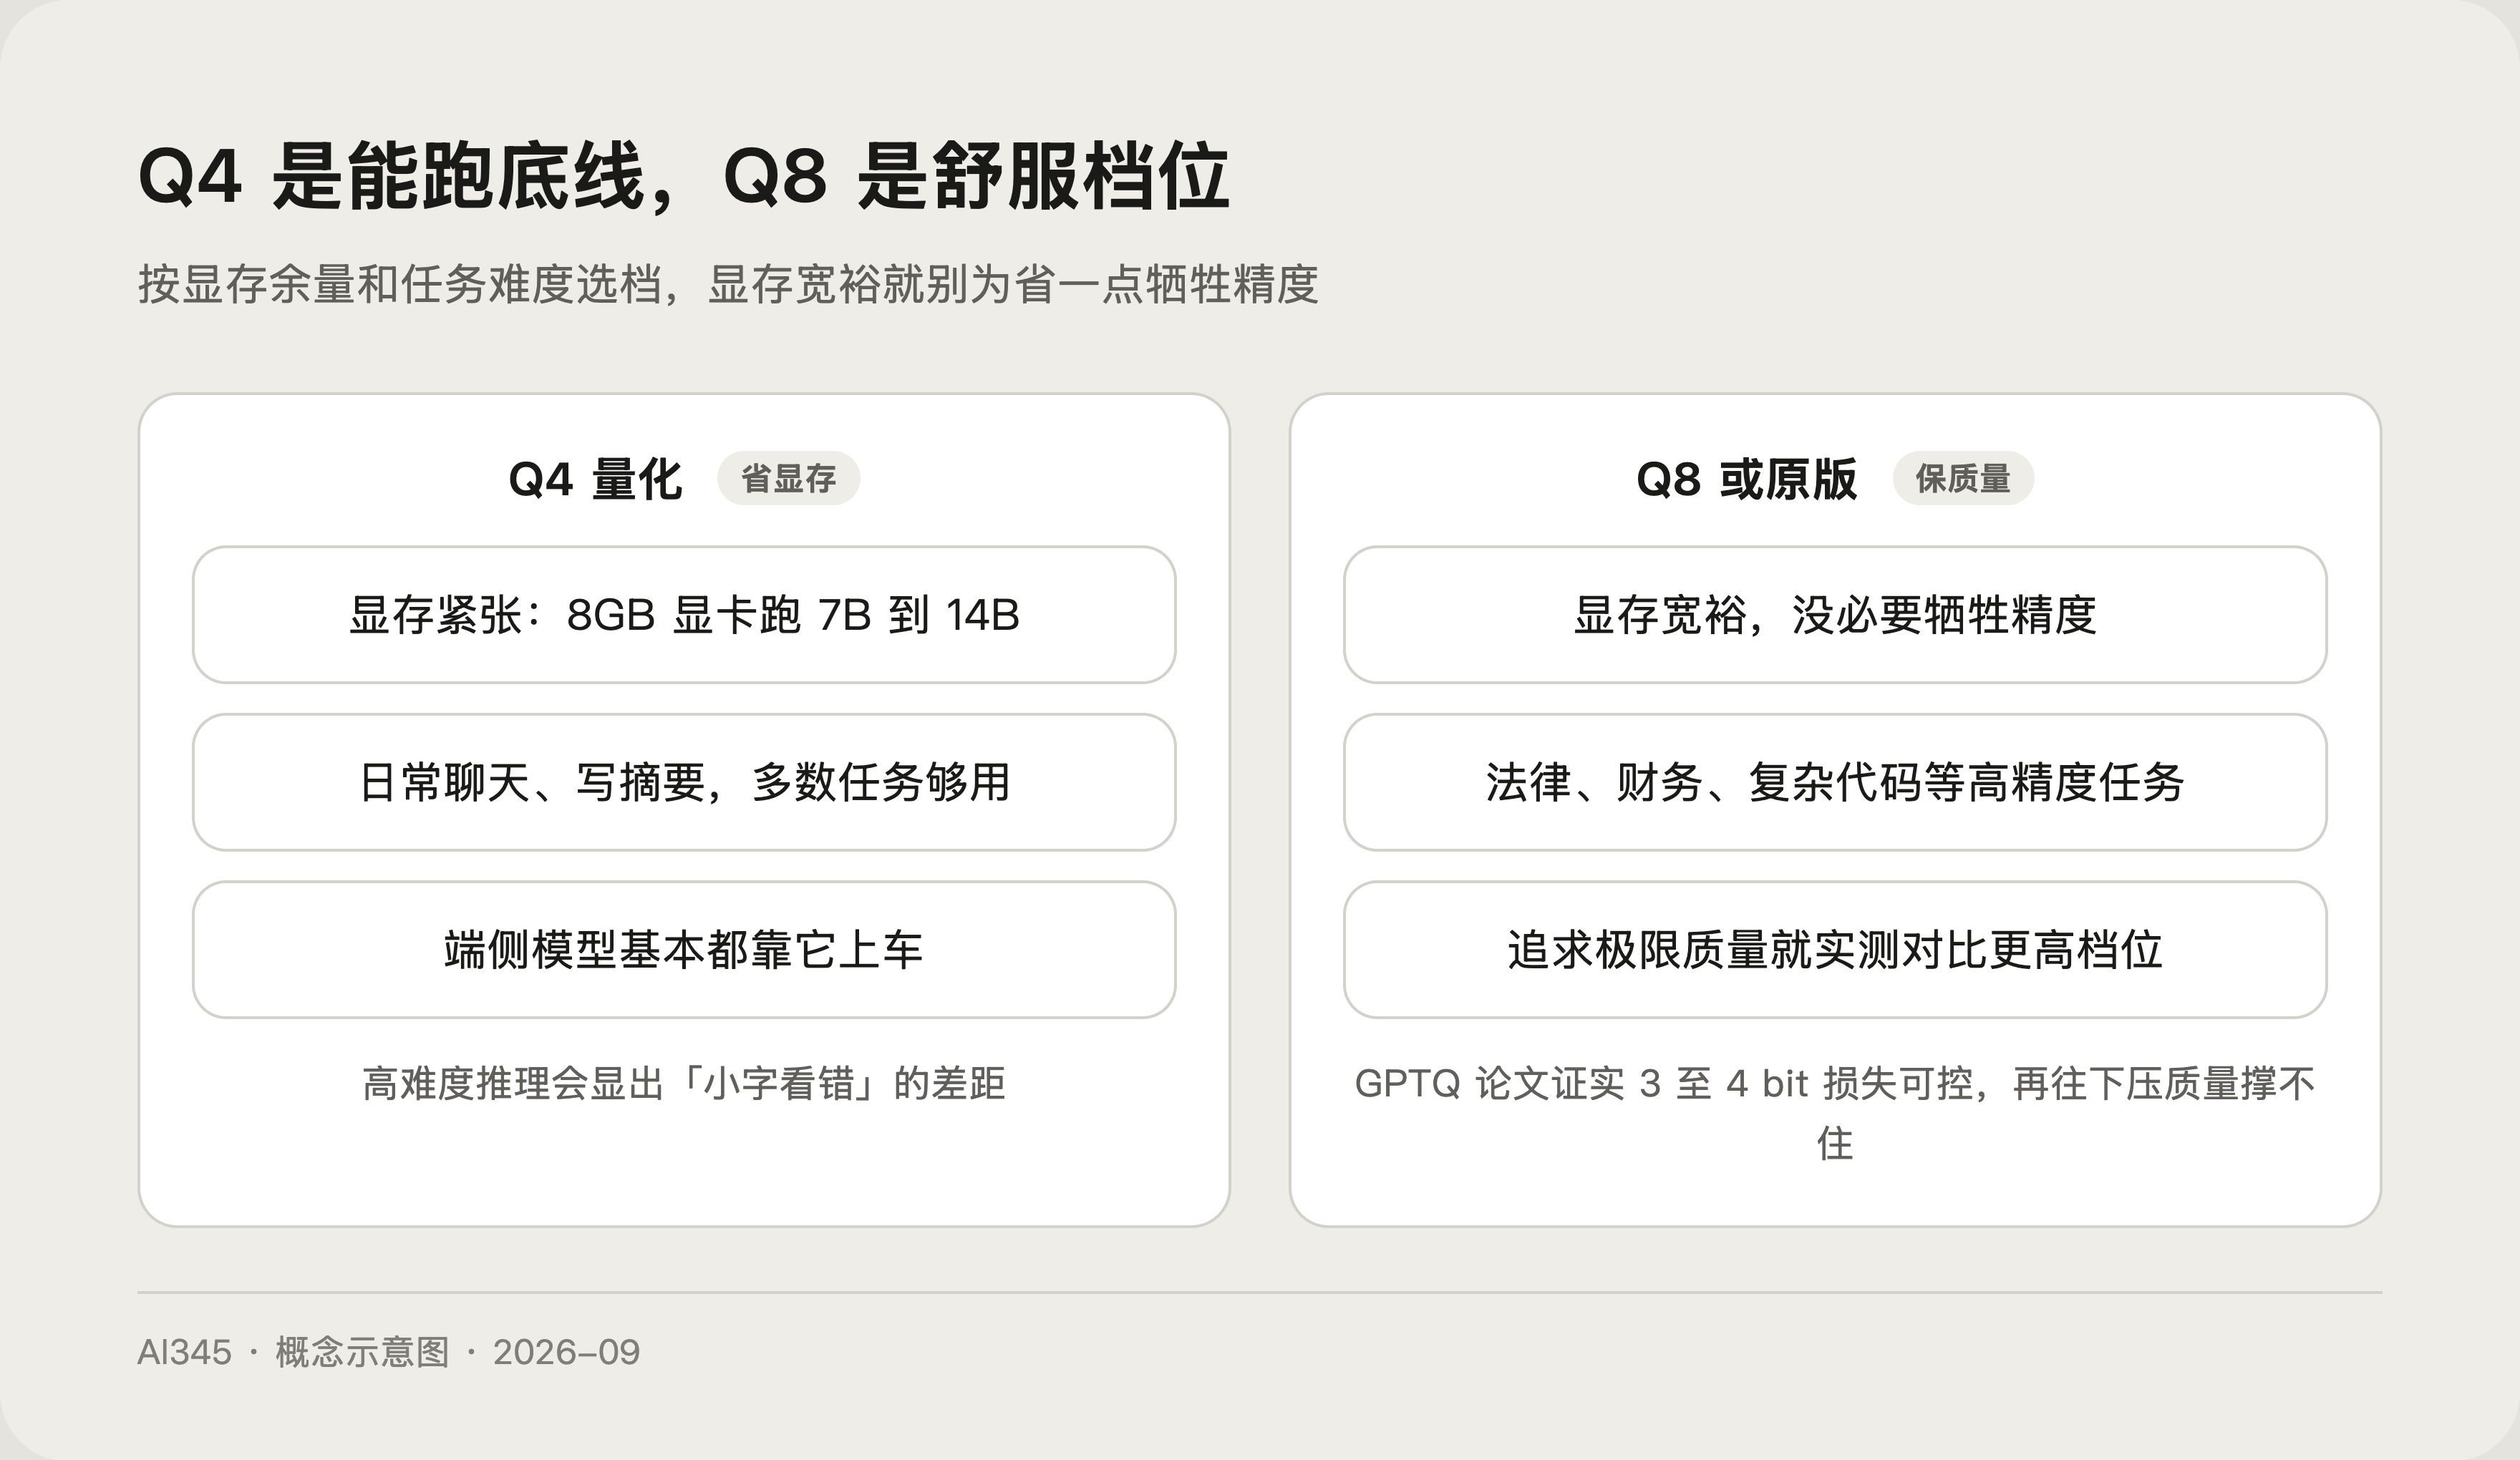
大模型内部没有任何「知识文本」,只有海量参数,也就是一个个小数。训练时这些数默认用 16 位浮点数(FP16)存储,每个数占 2 个字节。参数越多,这堆数就越大,想了解模型怎么工作的,可以先看站内这篇大语言模型是怎么工作的。
量化做的事很朴素:把这堆数换一种更占地方的记法存下来。原来每位数用 16 位表示,现在只保留 4 位或 8 位的信息。
课本缩印比喻:省纸,但小字有点糊
把模型想象成一本 16 号大字排版的课本:
- FP16 原版:字大清晰,但一页放不了多少内容,书厚得离谱。
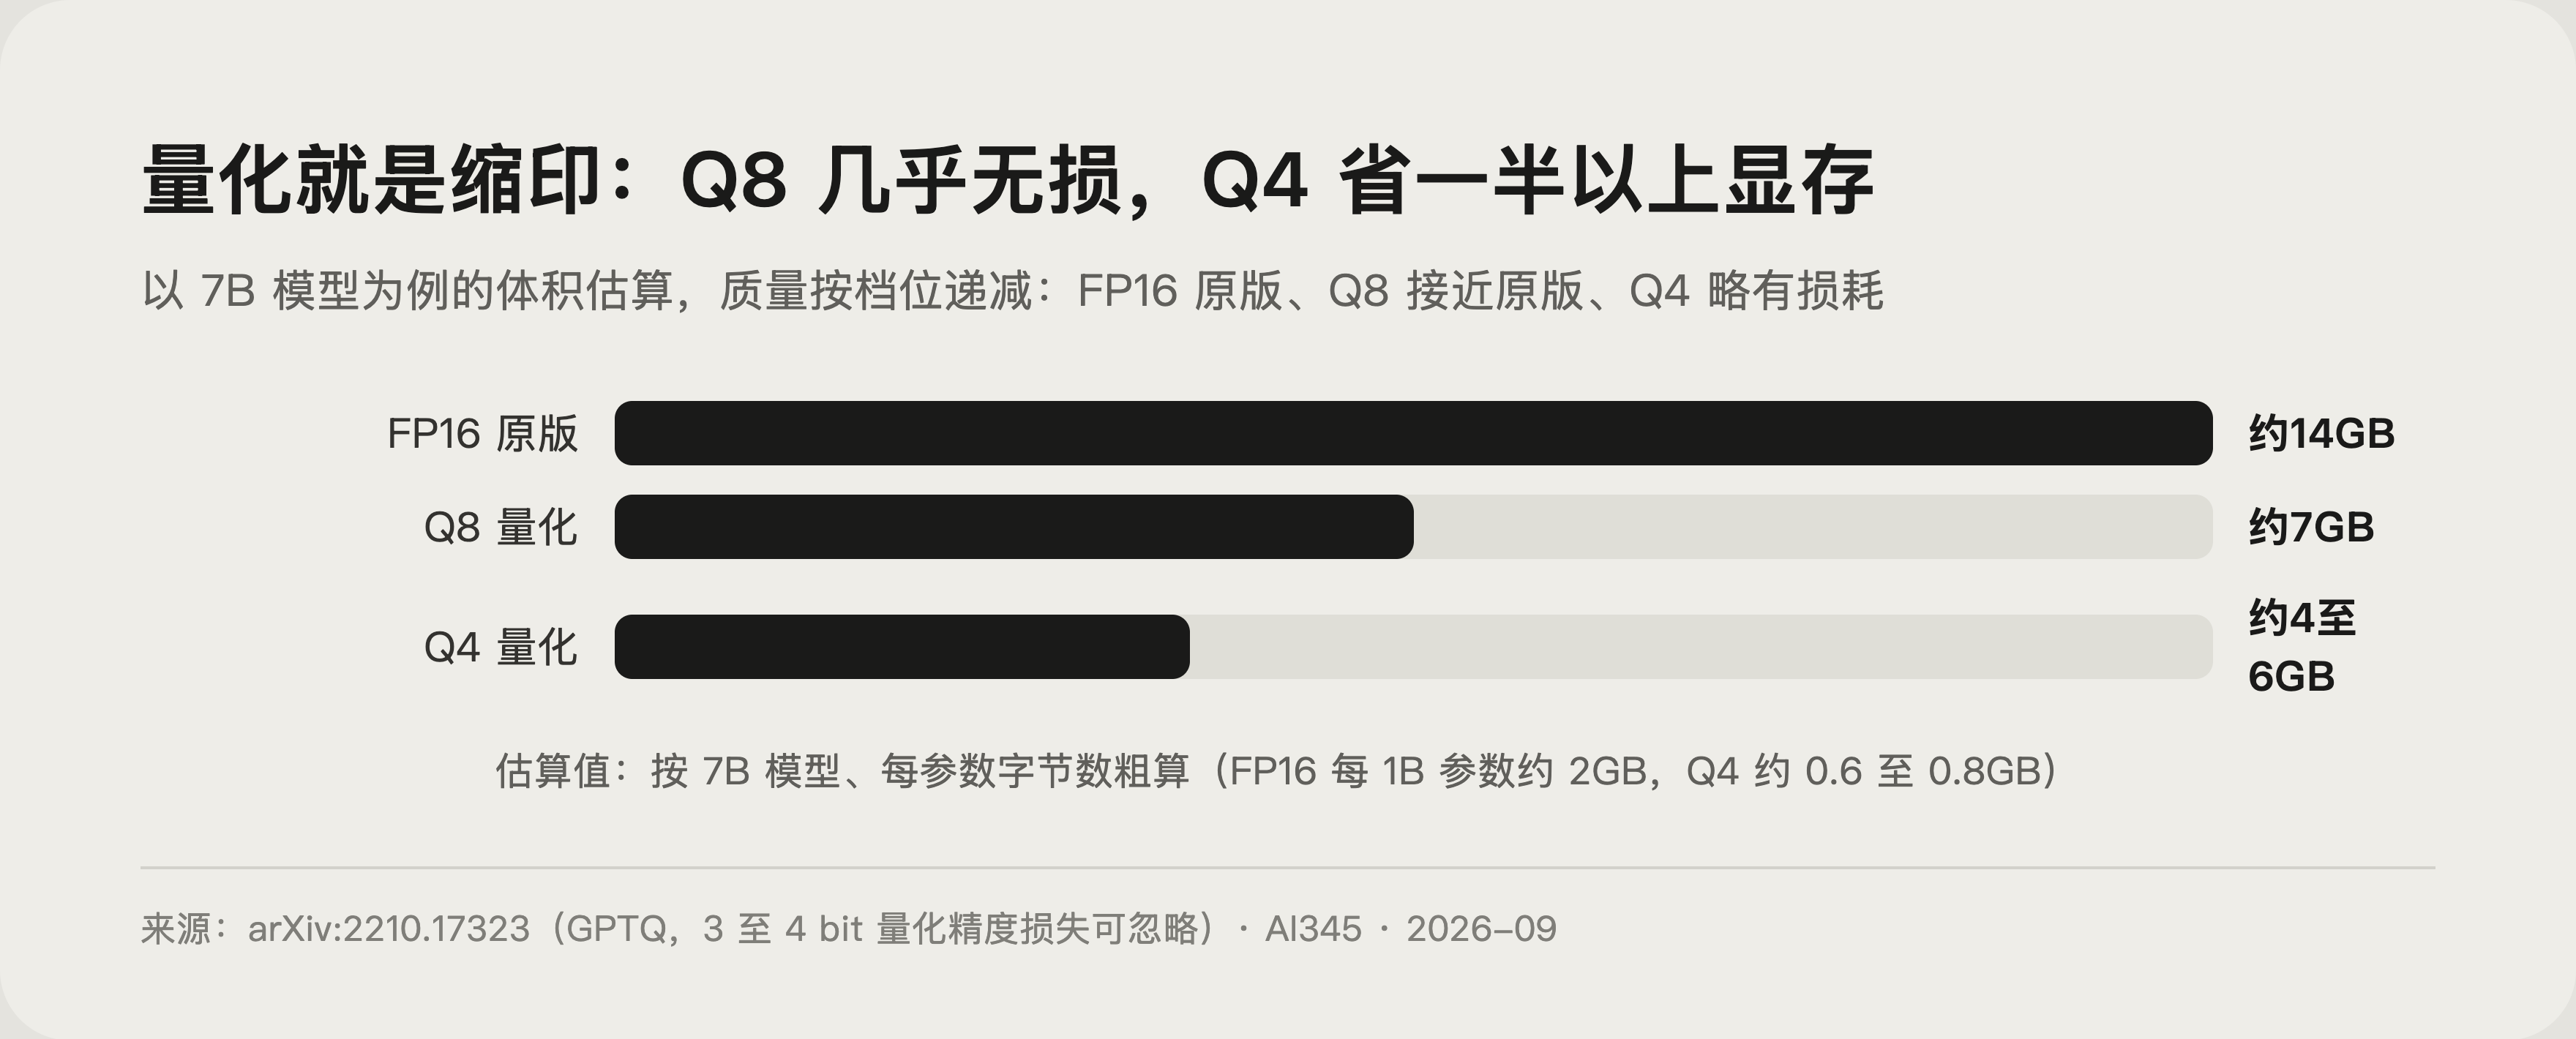
- Q8 量化:缩印成 8 号字,页数几乎省一半,内容基本能读清,几乎无损。
- Q4 量化:缩印成 4 号小字,页数省四分之三,大部分内容还能读,但个别笔画已经糊了,遇到复杂段落会看错字。
这个比喻的关键在于:糊不糊取决于「读什么」。日常聊天、写摘要这类任务,Q4 缩印本读起来和原版差别不大;高难度推理、精确数学,小字导致的看错就会显形。
GGUF、Q4、Q8 到底在说什么
下载本地模型时你一定见过形如「Q4_K_M」「Q8_0」的文件名,拆开看就三层意思:
- GGUF:一种模型文件格式,是开源推理项目 llama.cpp 生态使用的标准容器,把模型权重、分词器和配置打包成单个文件,方便本地加载。
- Q4、Q8:Q 后面的数字是量化位数(bit),Q8 是 8 位量化,Q4 是 4 位量化。位数越低体积越小、损耗越高。
- 后缀变体:Q4_K_M 这类写法表示同一档位下的混合策略,对敏感层用更高精度、其余用低精度,在体积和质量之间取平衡。
量化到底省多少、糊多少:论文里的数字
这不是民间玄学,学术界有系统研究。下面两个数字都来自公开论文:
- GPTQ 论文(ICLR 2023)证明:把 1750 亿参数的模型量化到 3 到 4 bit,精度损失可以忽略不计,量化后 1750 亿参数模型首次能在单张 GPU 上做生成式推理;在 A100 上端到端推理相对 FP16 提速约 3.25 倍(见 GPTQ 论文)。
- QLoRA 论文(2023)进一步把 4 位量化做到极致:用 4-bit NormalFloat 数据类型,单张 48GB GPU 就能对 65B 模型做全流程训练微调(见 QLoRA 论文)。
两条结论合起来读:4 位量化是经过大规模验证的可用档位,不是将就;但 QLoRA 论文同时表明,量化位数的收益在 4 位附近已是工程甜点区,再往下压(2 位)质量会明显撑不住,这也是社区普遍把 Q4 视为「能跑」底线、Q8 视为「舒服」档位的原因。
什么时候该量化,什么时候别硬压
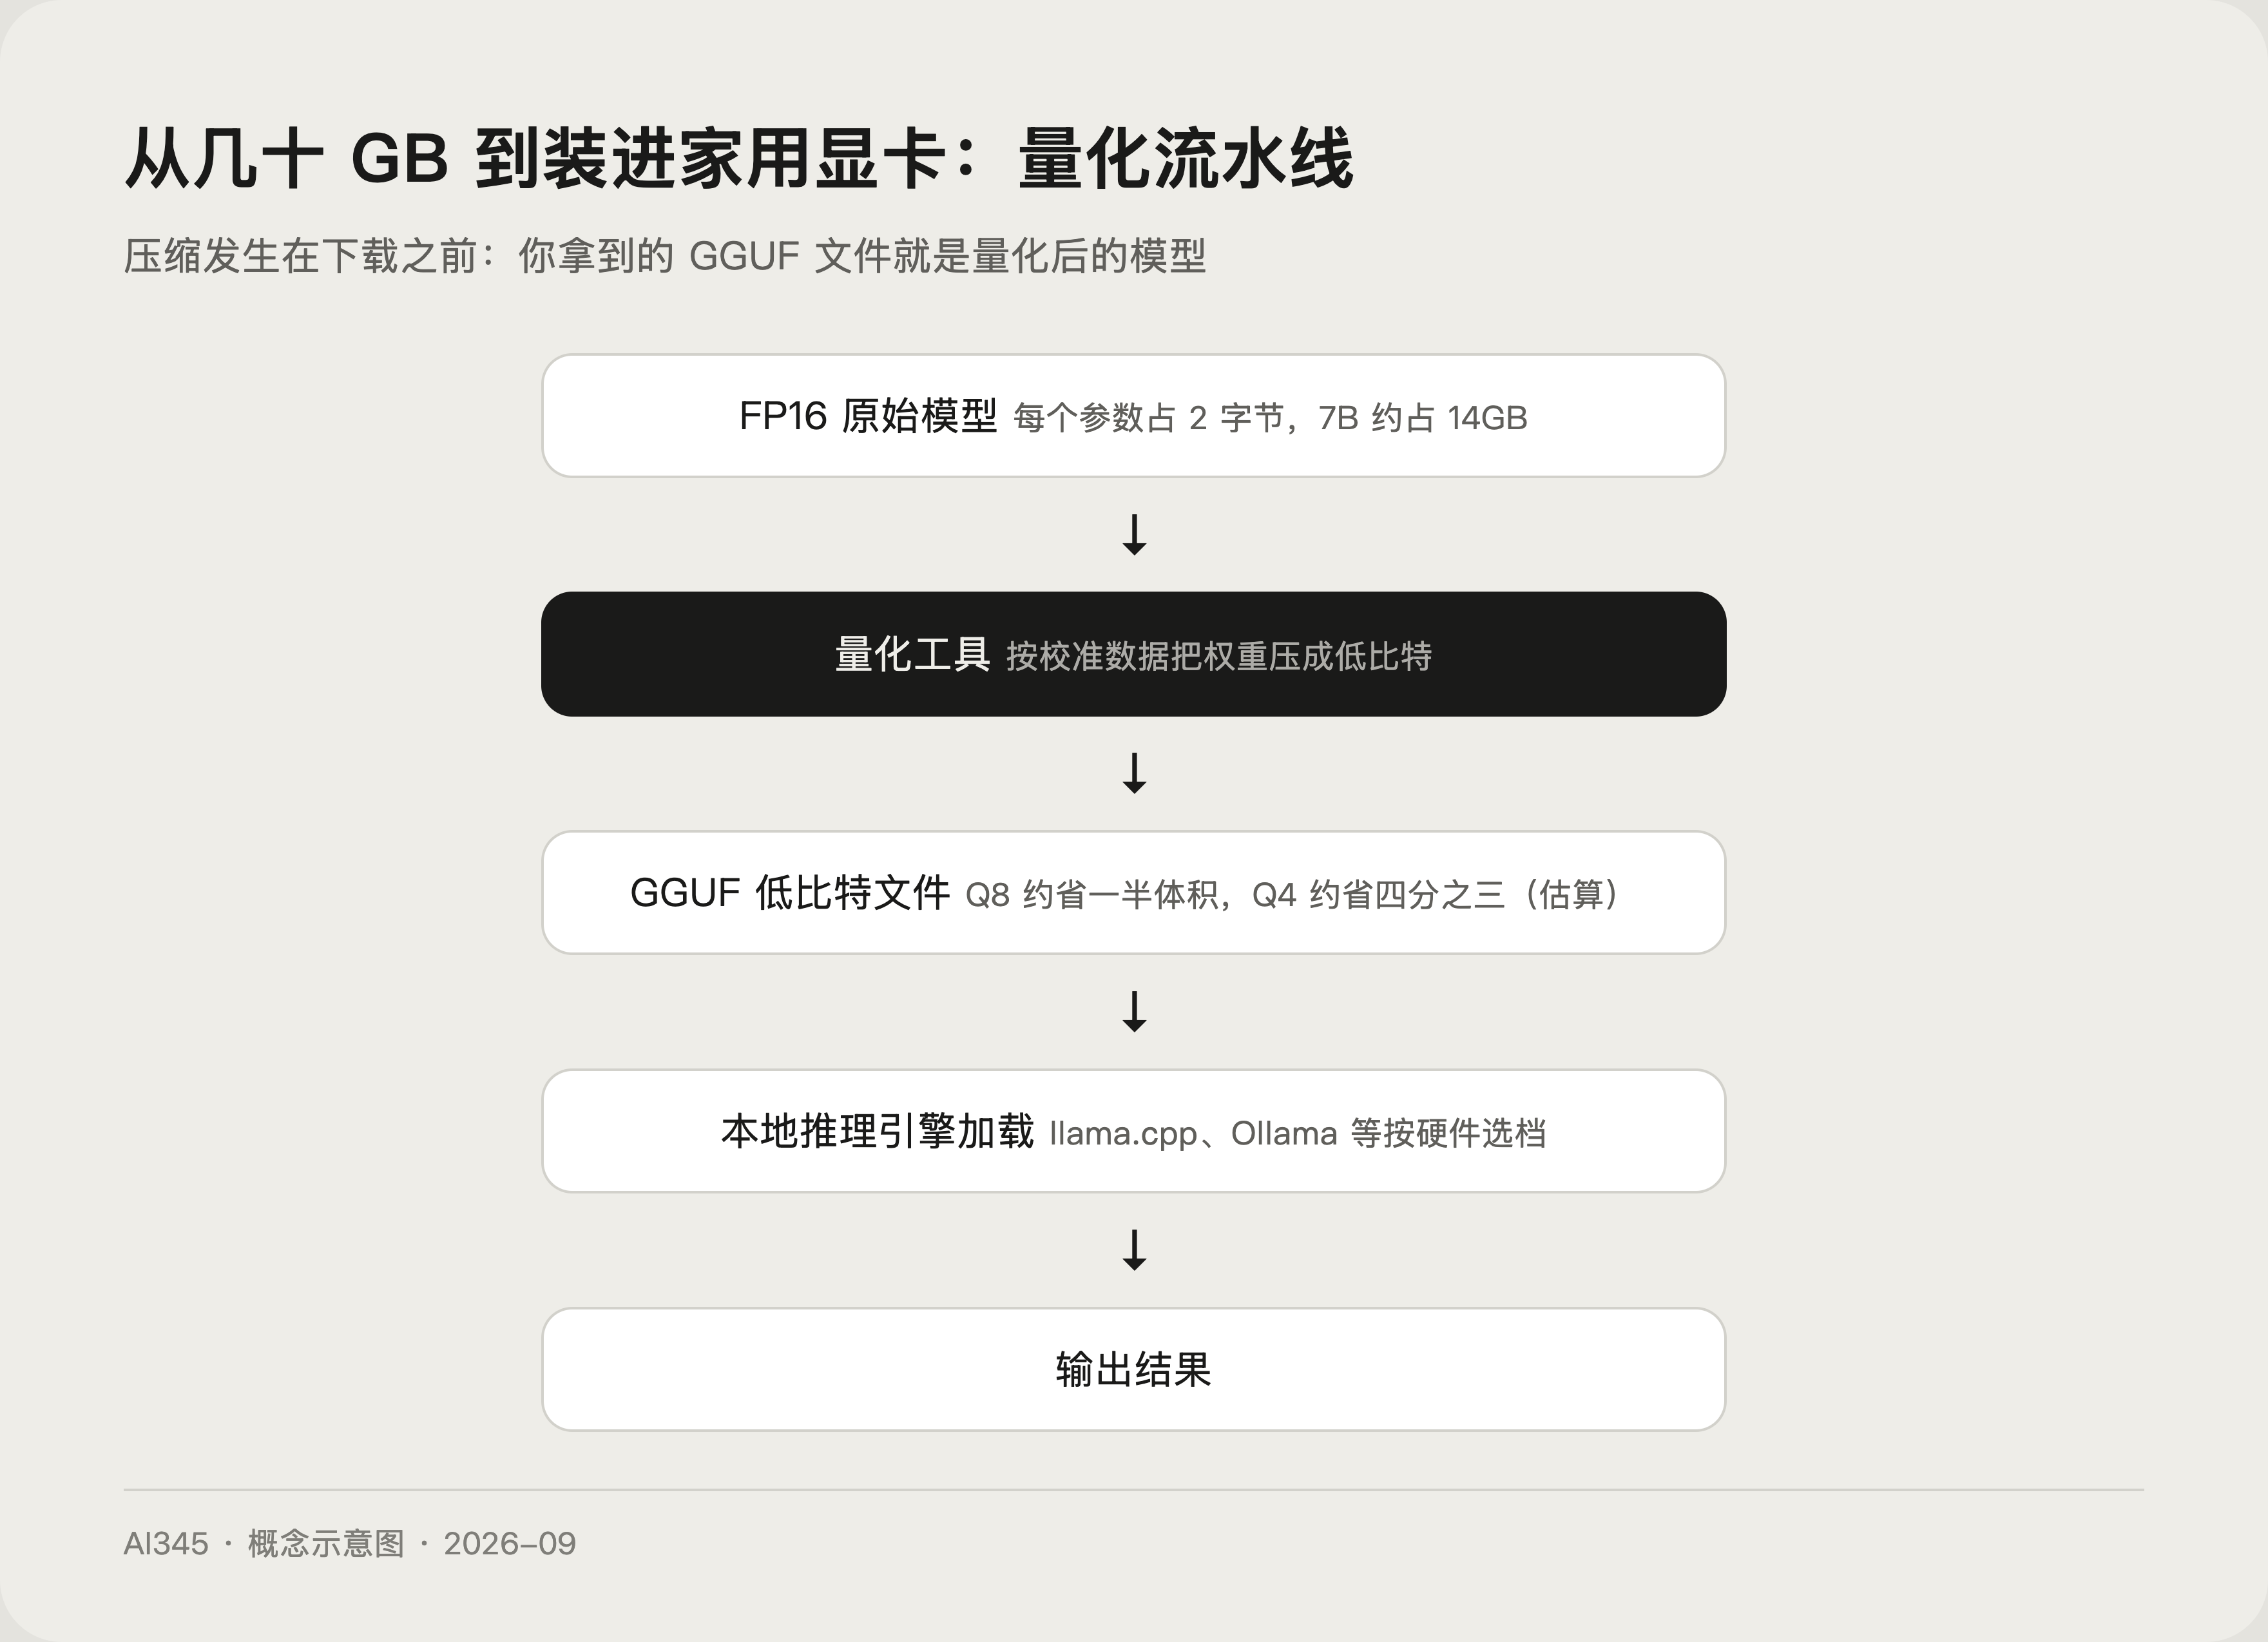
- 显存紧张选 Q4:8GB 显卡想跑 7B 到 14B 级别的模型,Q4 是现实选择,端侧模型基本都靠它上车,比如这篇面壁 MiniCPM 2B 端侧模型的思路;完整的部署步骤可看这篇 openPangu 2.0 本地部署教程。
- 显存宽裕选 Q8 或原版:既然装得下,就没必要为省一点显存牺牲精度。
- 追求极限质量别硬压:法律、财务、复杂代码等高精度任务,低比特量化的错误累积可能被放大,条件允许就用更高精度档位实测对比。
一段话讲清模型量化
可以照这个口径复述:量化是把模型权重从 16 位浮点压成 4 位或 8 位低精度表示的压缩技术,原理是减少每个参数占用的比特数,代价是少量精度损失。它的价值是让大模型能在消费级显卡甚至手机上运行,GPTQ、QLoRA 等研究已证明 3 到 4 位量化在多数任务上损失可控。文件名里的 GGUF 是本地推理的模型文件格式,Q4、Q8 指量化位数,位数越低体积越小、质量越糊,选档要在显存余量和任务精度之间权衡。
常见问题
量化会改变模型的「智力」吗?
答:会有影响但幅度取决于档位和任务。Q8 几乎无感,Q4 在大多数日常任务上损失很小,但在高难度推理上可以感知到差距。
Q4 比 Q8 快吗?
答:通常更快,因为要读的数据量更小。但速度提升幅度受硬件和推理引擎影响,不一定与体积缩减成正比。
GGUF 和 PyTorch 的模型文件是什么关系?
答:GGUF 是面向本地推理的打包格式,强调单文件、可加载;PyTorch 常用的权重文件面向训练和研究。同一个模型可以转换成 GGUF 供本地引擎使用。
手机上跑的大模型也是量化的吗?
答:基本是。手机内存和功耗放不下全精度大模型,端侧模型普遍采用低比特量化甚至更激进的压缩方案。
量化后的模型还能再微调吗?
答:普通用户一般不需要。研究界的 QLoRA 方案证明可以在 4 位量化模型上做低秩微调,但那是训练工程,不是本地聊天场景。
 京ICP备2024094994号-29