
openPangu 2.0 本地部署教程:三条路线与硬件门槛
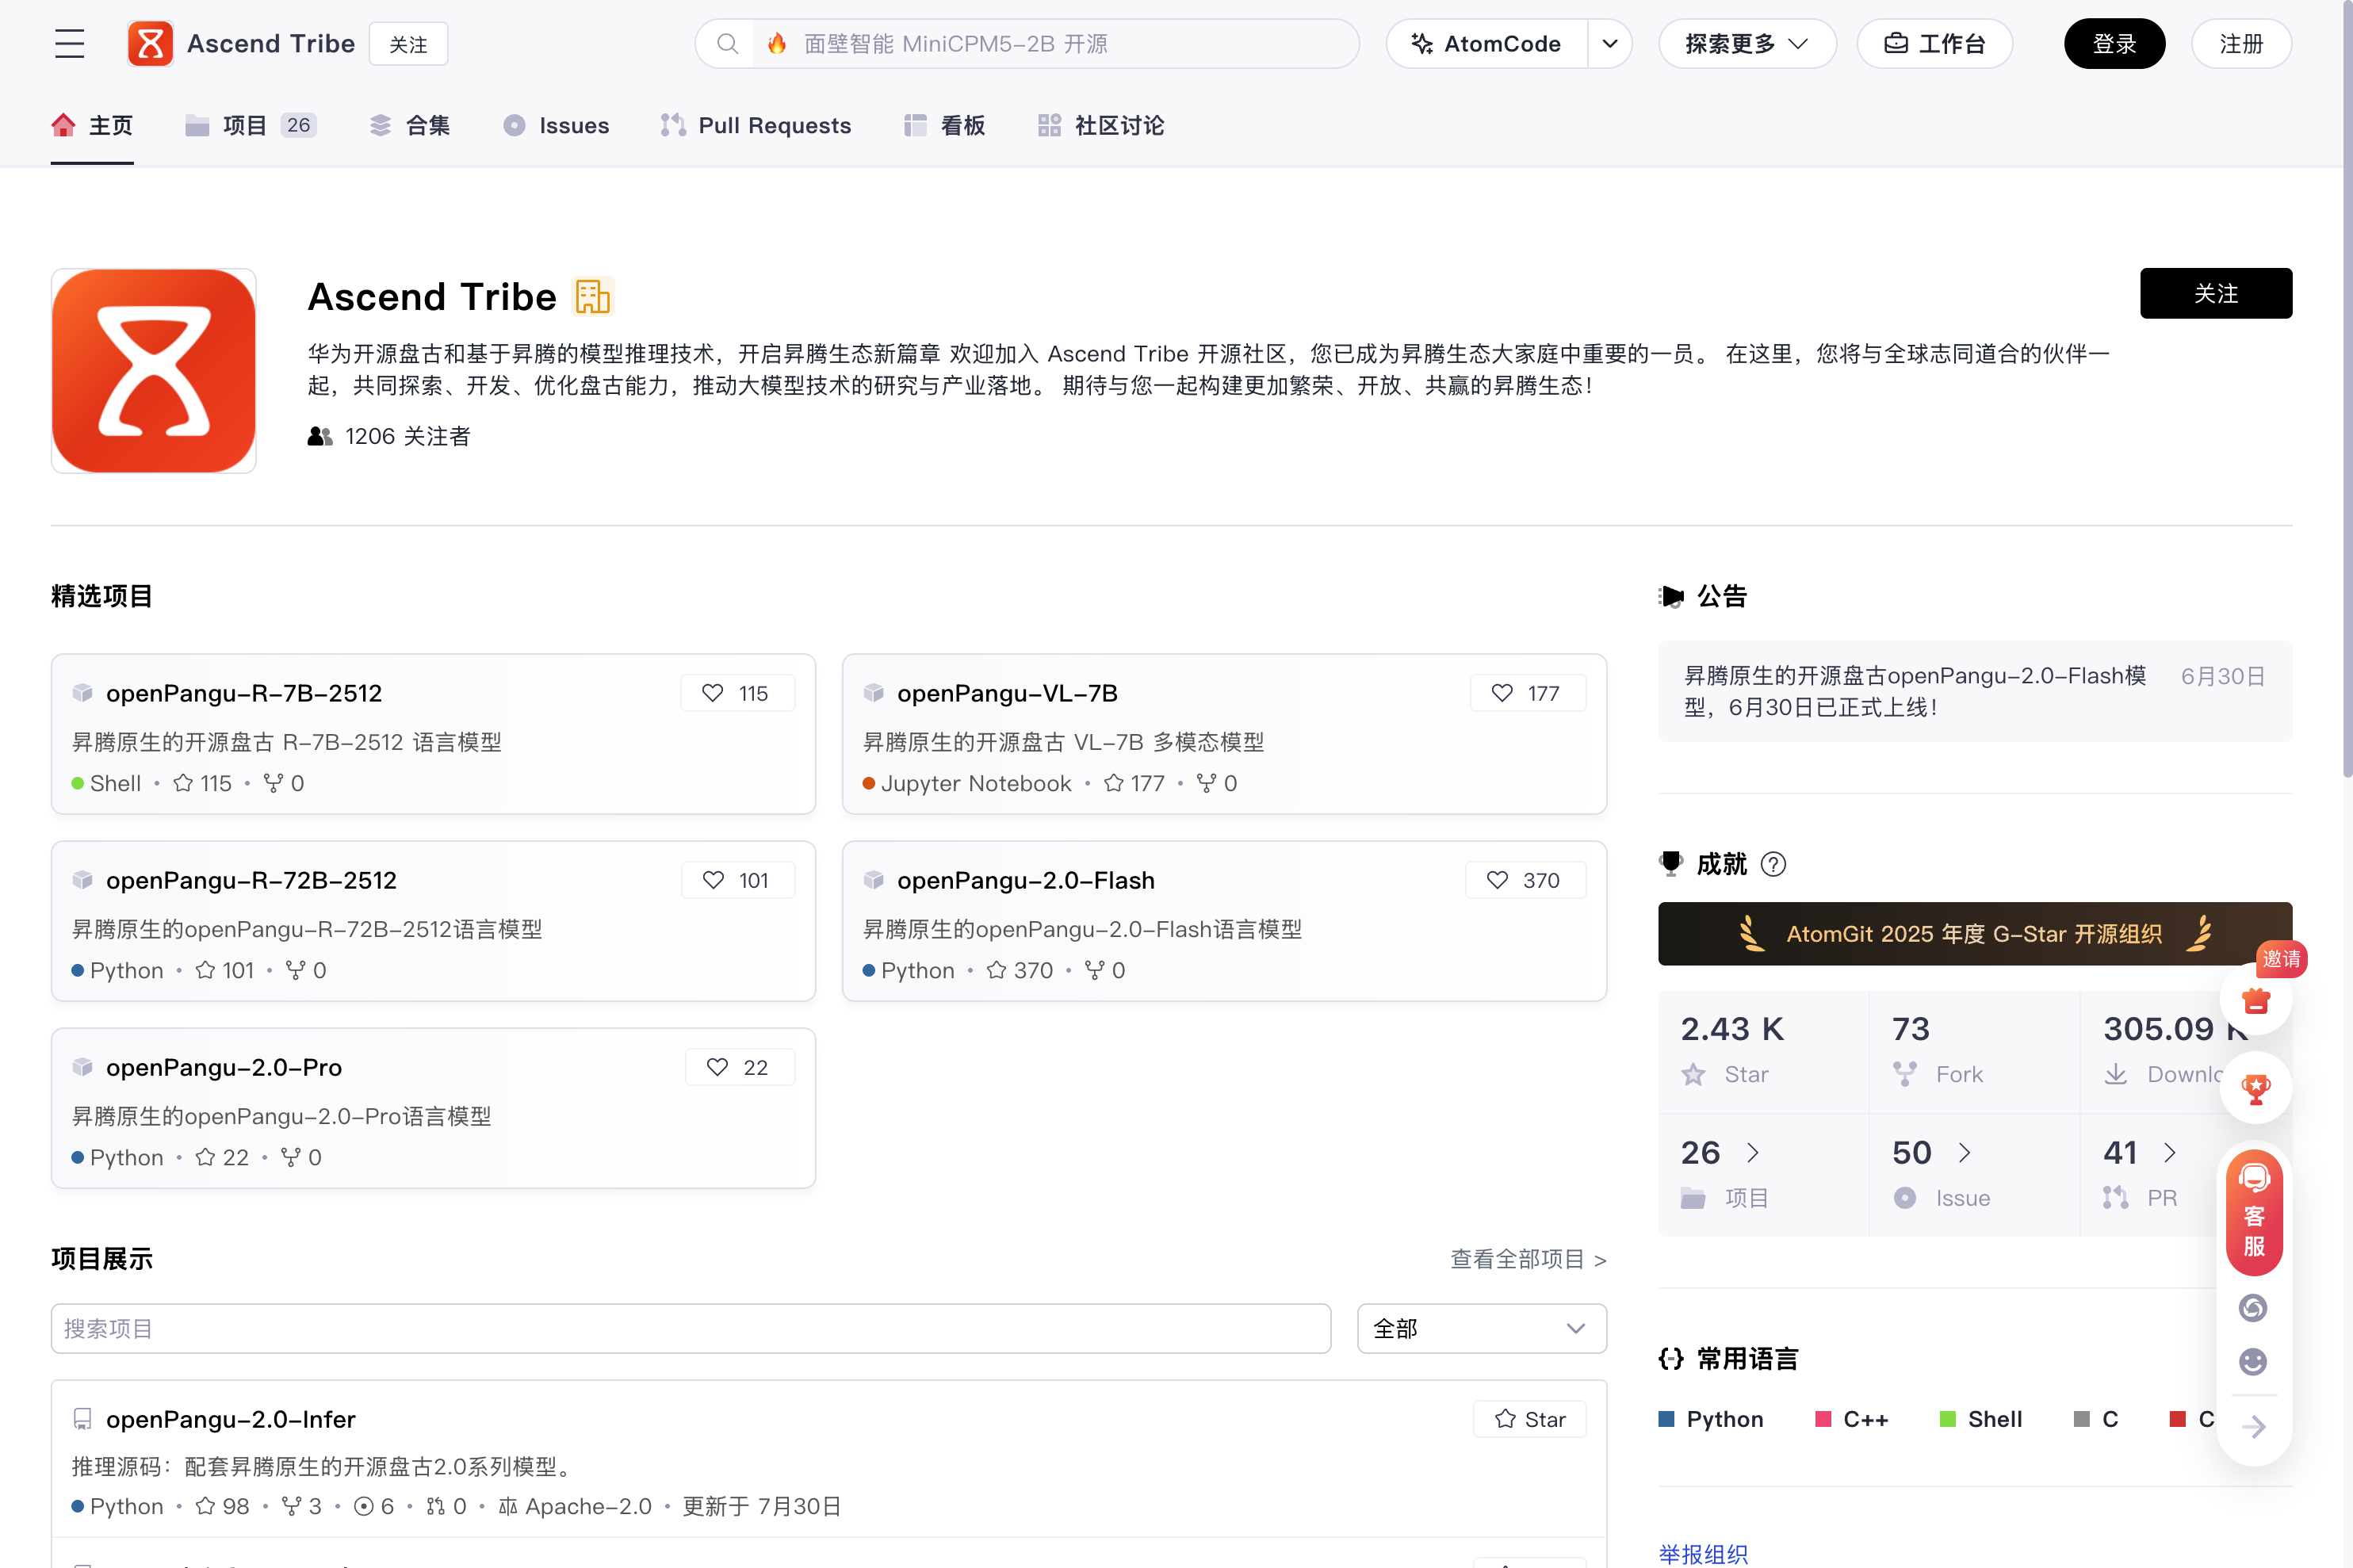
openPangu 2.0 的本地部署有三条路线:有昇腾(Ascend)环境的直接下载官方权重和推理代码部署;没有昇腾硬件的走华为云 MaaS 或 GitCode 在线推理体验;消费级设备用户要认清现实,5050 亿参数的 Pro 档不是个人电脑能跑的量级。2026 年华为已陆续开源 openPangu-2.0-Flash(920 亿参数,6 月 30 日上线)和 openPangu-2.0-Pro(5050 亿参数,7 月 31 日上线),权重和基础推理代码都可以免费下载,推理源码仓库采用 Apache-2.0 许可。
部署前先认清两个版本
| 维度 | openPangu-2.0-Flash | openPangu-2.0-Pro |
|---|---|---|
| 参数量 | 920 亿 | 5050 亿 |
| 开源时间 | 2026 年 6 月 30 日 | 2026 年 7 月 31 日 |
| 开源内容 | 权重 + 基础推理代码 + 训推算子 | 权重 + 基础推理代码 + 技术报告 |
| 架构亮点 | 轻量推理优先 | MLA 注意力,DSA+SWA 独立分层混合 |
| 适合路线 | 企业/实验室昇腾环境自建 | 机构级集群或云端调用 |
| 云端体验 | 华为云 MaaS 已支持快速体验 | 华为云 MaaS 平台可在线调用 |
选择逻辑很简单:先想清楚你的算力盘子里有什么。openPangu 是华为的开源 AI 模型品牌,官方定位是「昇腾原生训练与推理」,权重和算子按昇腾硬件优化,这也是它和 DeepSeek、Qwen 等开源模型最大的生态差异。
官方部署仓库长什么样:先看清真实门槛
很多人卡在第一步,是因为没看清官方推理仓库到底要求什么。openPangu 的推理代码放在 Ascend Tribe 社区的 openPangu-2.0-Infer 仓库里,README 写得很直接,关键信息如下:
| 模型 | ModelName | 配置目录 | 官方推荐部署规模 |
|---|---|---|---|
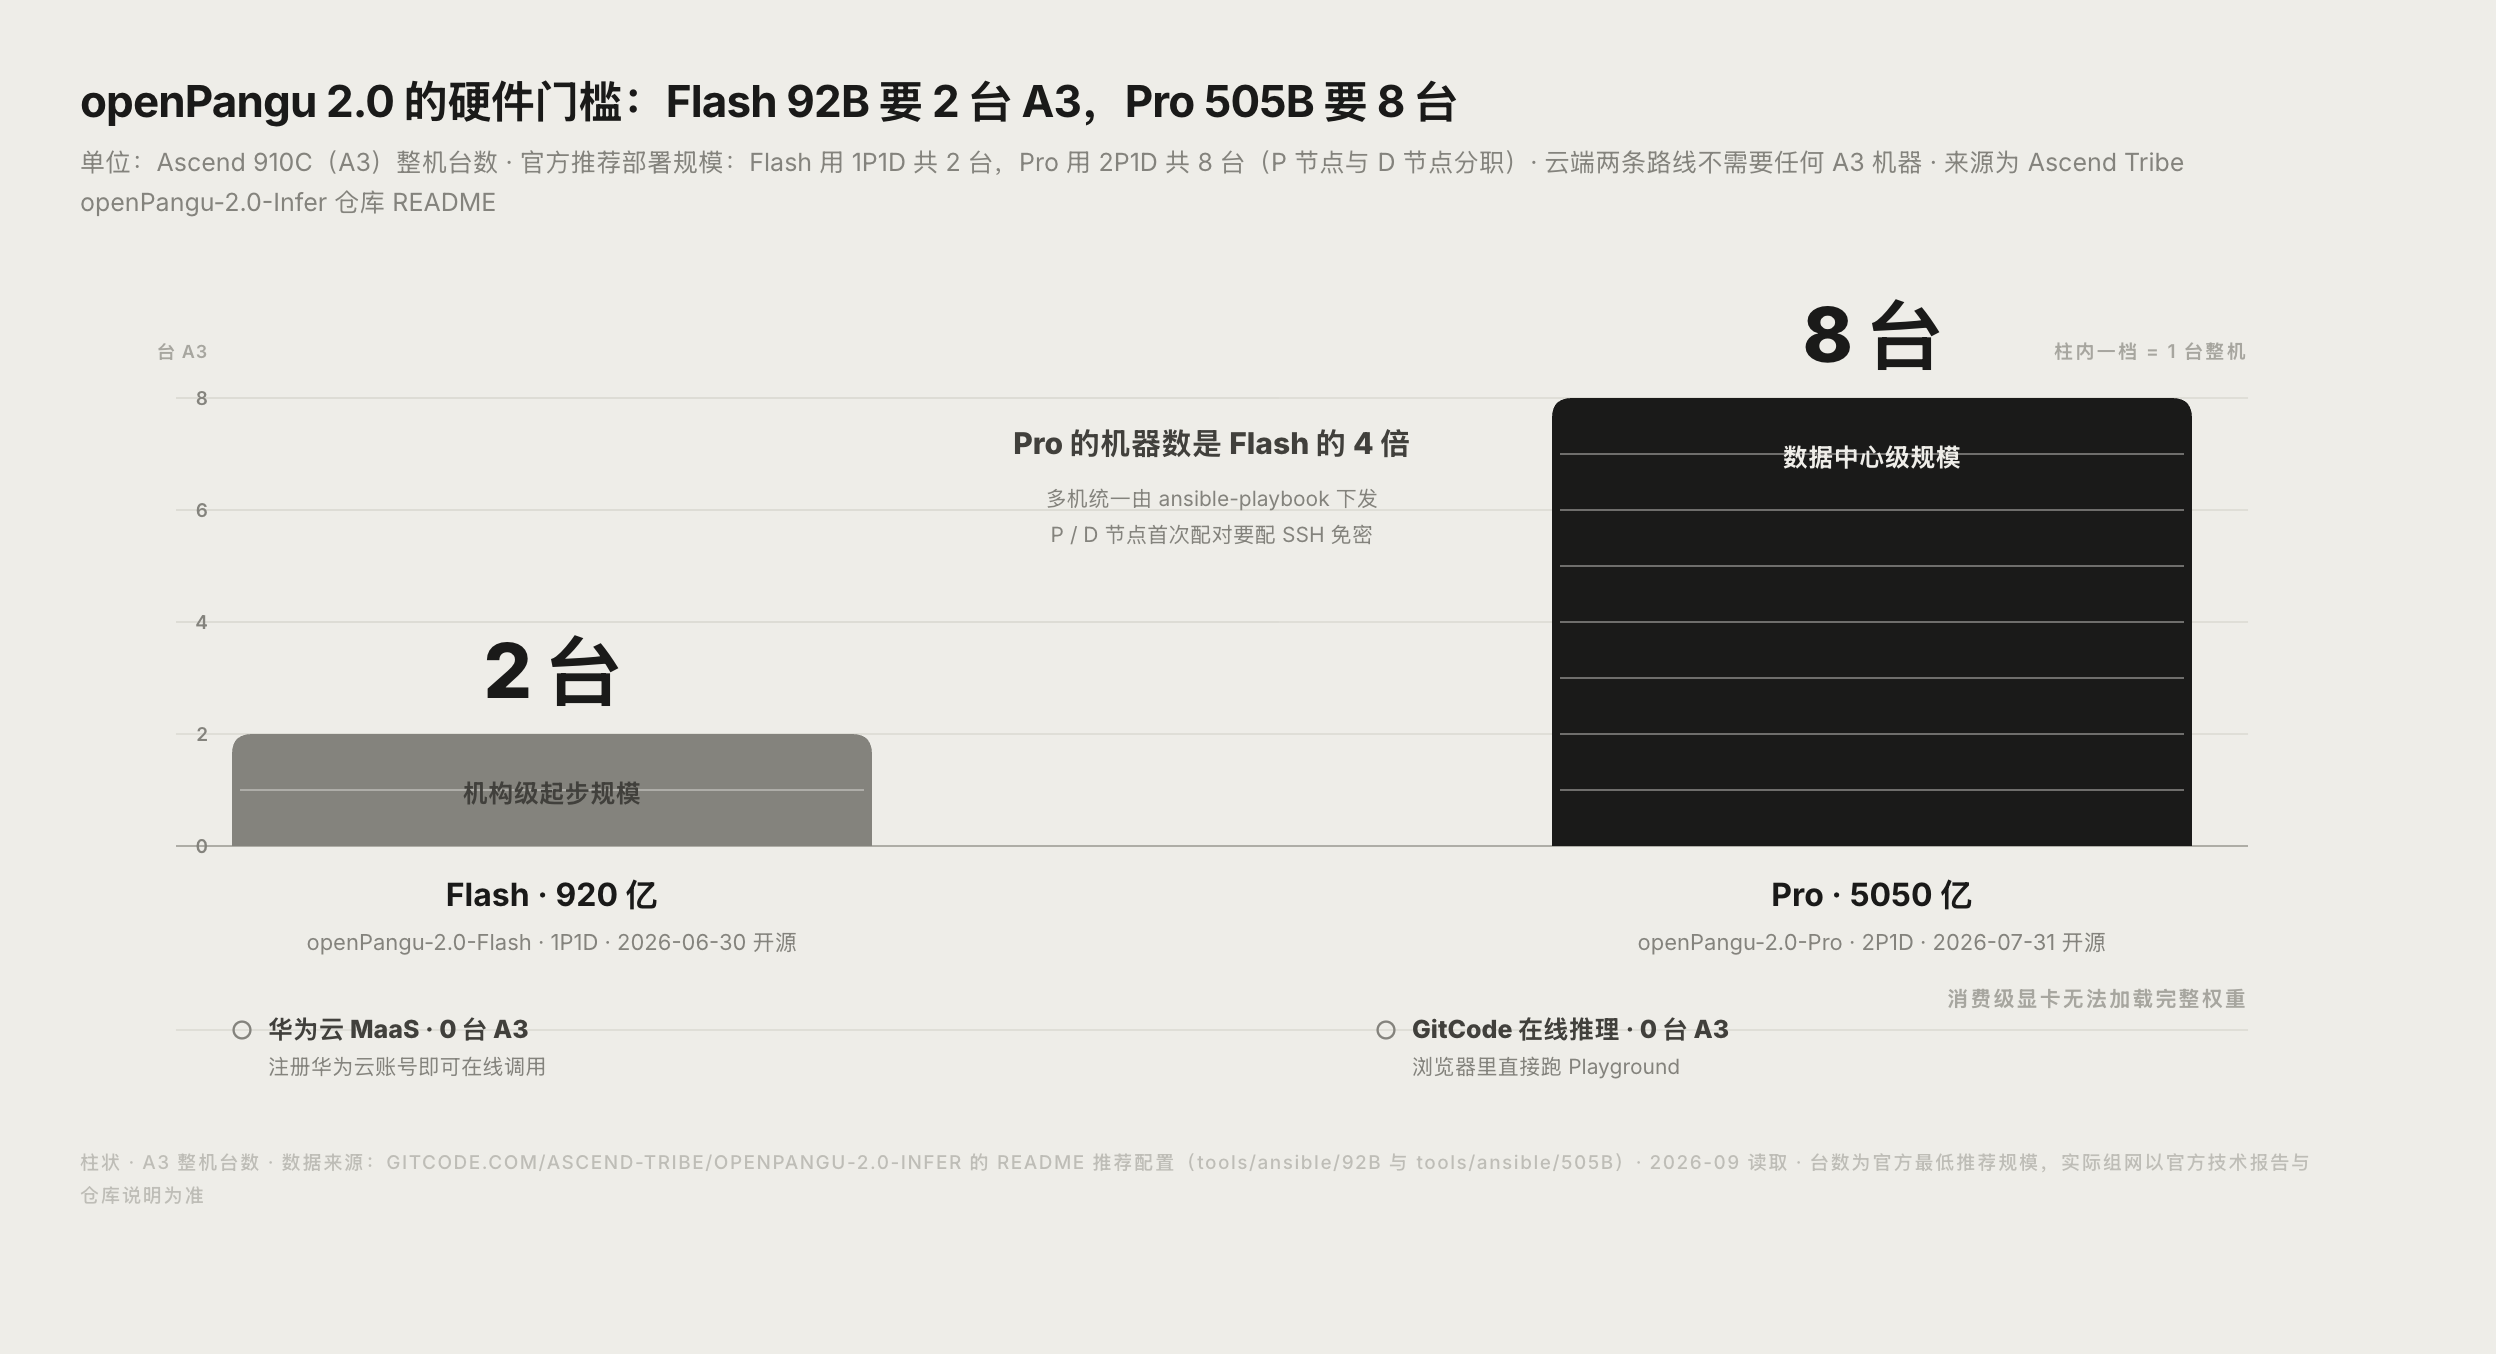
| 92B | openPangu-2.0-Flash | tools/ansible/92B/ | 1P1D,共 2 台 A3 机器 |
| 505B | openPangu-2.0-Pro | tools/ansible/505B/ | 2P1D,共 8 台 A3 机器 |
这里的 A3 指 Ascend 910C 一代整机。也就是说,即使是最小的 Flash 档,官方推荐的 BF16 权重部署也要两台 A3 机器组一套 P 节点加 D 节点,多机部署统一通过 ansible-playbook 从执行机下发,执行机必须先装好 ansible。这不是一台开发机能凑出来的环境。
镜像和依赖同样是硬门槛。官方给出的 A3 镜像地址是 swr.cn-east-4.myhuaweicloud.com/omni-ci/omniinfer-a3-arm:release_1.2.1.post1-202607241407-vllm,镜像里预装的版本组合为:omni-npu 0.2.0、vllm 0.14.0、torch 2.9.0、torch-npu 2.9.0.post3、transformers 4.57.6、Python 3.11.12。也就是说,这不是「一条 pip 命令跑起来」的模型,而是成套的昇腾推理栈。
路线一:昇腾环境自建(标准本地部署)
这是官方主推的部署方式,按仓库 README 走,核心步骤六步:
- 下载权重与推理代码:到 Ascend Tribe 开源社区(gitcode.com/ascend-tribe)或 Hugging Face 的 openpangu 组织页 拉取模型权重,推理代码取 openPangu-2.0-Infer 仓库。
- 准备昇腾环境与镜像:安装对应版本的 CANN 异构计算架构与固件驱动(版本要求以仓库 README 为准),拉取官方给出的 A3 镜像。
- 配置多机免密:在 P、D 节点之间配置 SSH 互信,首次配对必须做;机器此前已用于 PD 分离部署则不用重配。
- 填写 inventory 与模板:修改
omni_infer_inventory_used_for_1P1D.yml(92B)或对应 505B 文件,把 P 节点、D 节点、C 代理节点的 IP 填进去,代理节点设为 P 节点 IP,ansible_host与host_ip都要改。 - 启动容器与服务:先跑
--tags run_docker建容器,再跑--tags run_server,run_proxy起服务,C 节点容器内会启动 nginx 代理做并发分发。 - 验证推理:向代理节点默认 7000 端口发一条
/v1/chat/completions请求,model字段必须和模板里的SERVED_MODEL_NAME一致(92B 默认为 openPangu-2.0-Flash),确认返回正常即跑通。
有一个细节值得单独提:官方模板里 MODEL_LEN_MAX_PREFILL 与 MODEL_LEN_MAX_DECODE 默认给到 524288,也就是 512K 级别的上下文长度,KV_CONNECTOR 用的是 LLMDataDistConnector,服务采用 prefill 与 decode 分离的部署形态。
路线二:华为云 MaaS 与 GitCode 在线推理(零硬件)
不想碰硬件,有两条零硬件路线:
- 华为云 MaaS:到 华为云 MaaS 模型即服务平台 在线体验,官方已上线 openPangu 2.0 系列的快速体验入口,注册华为云账号即可调用,另有官方最佳实践文档说明 Flash 模型的体验流程。
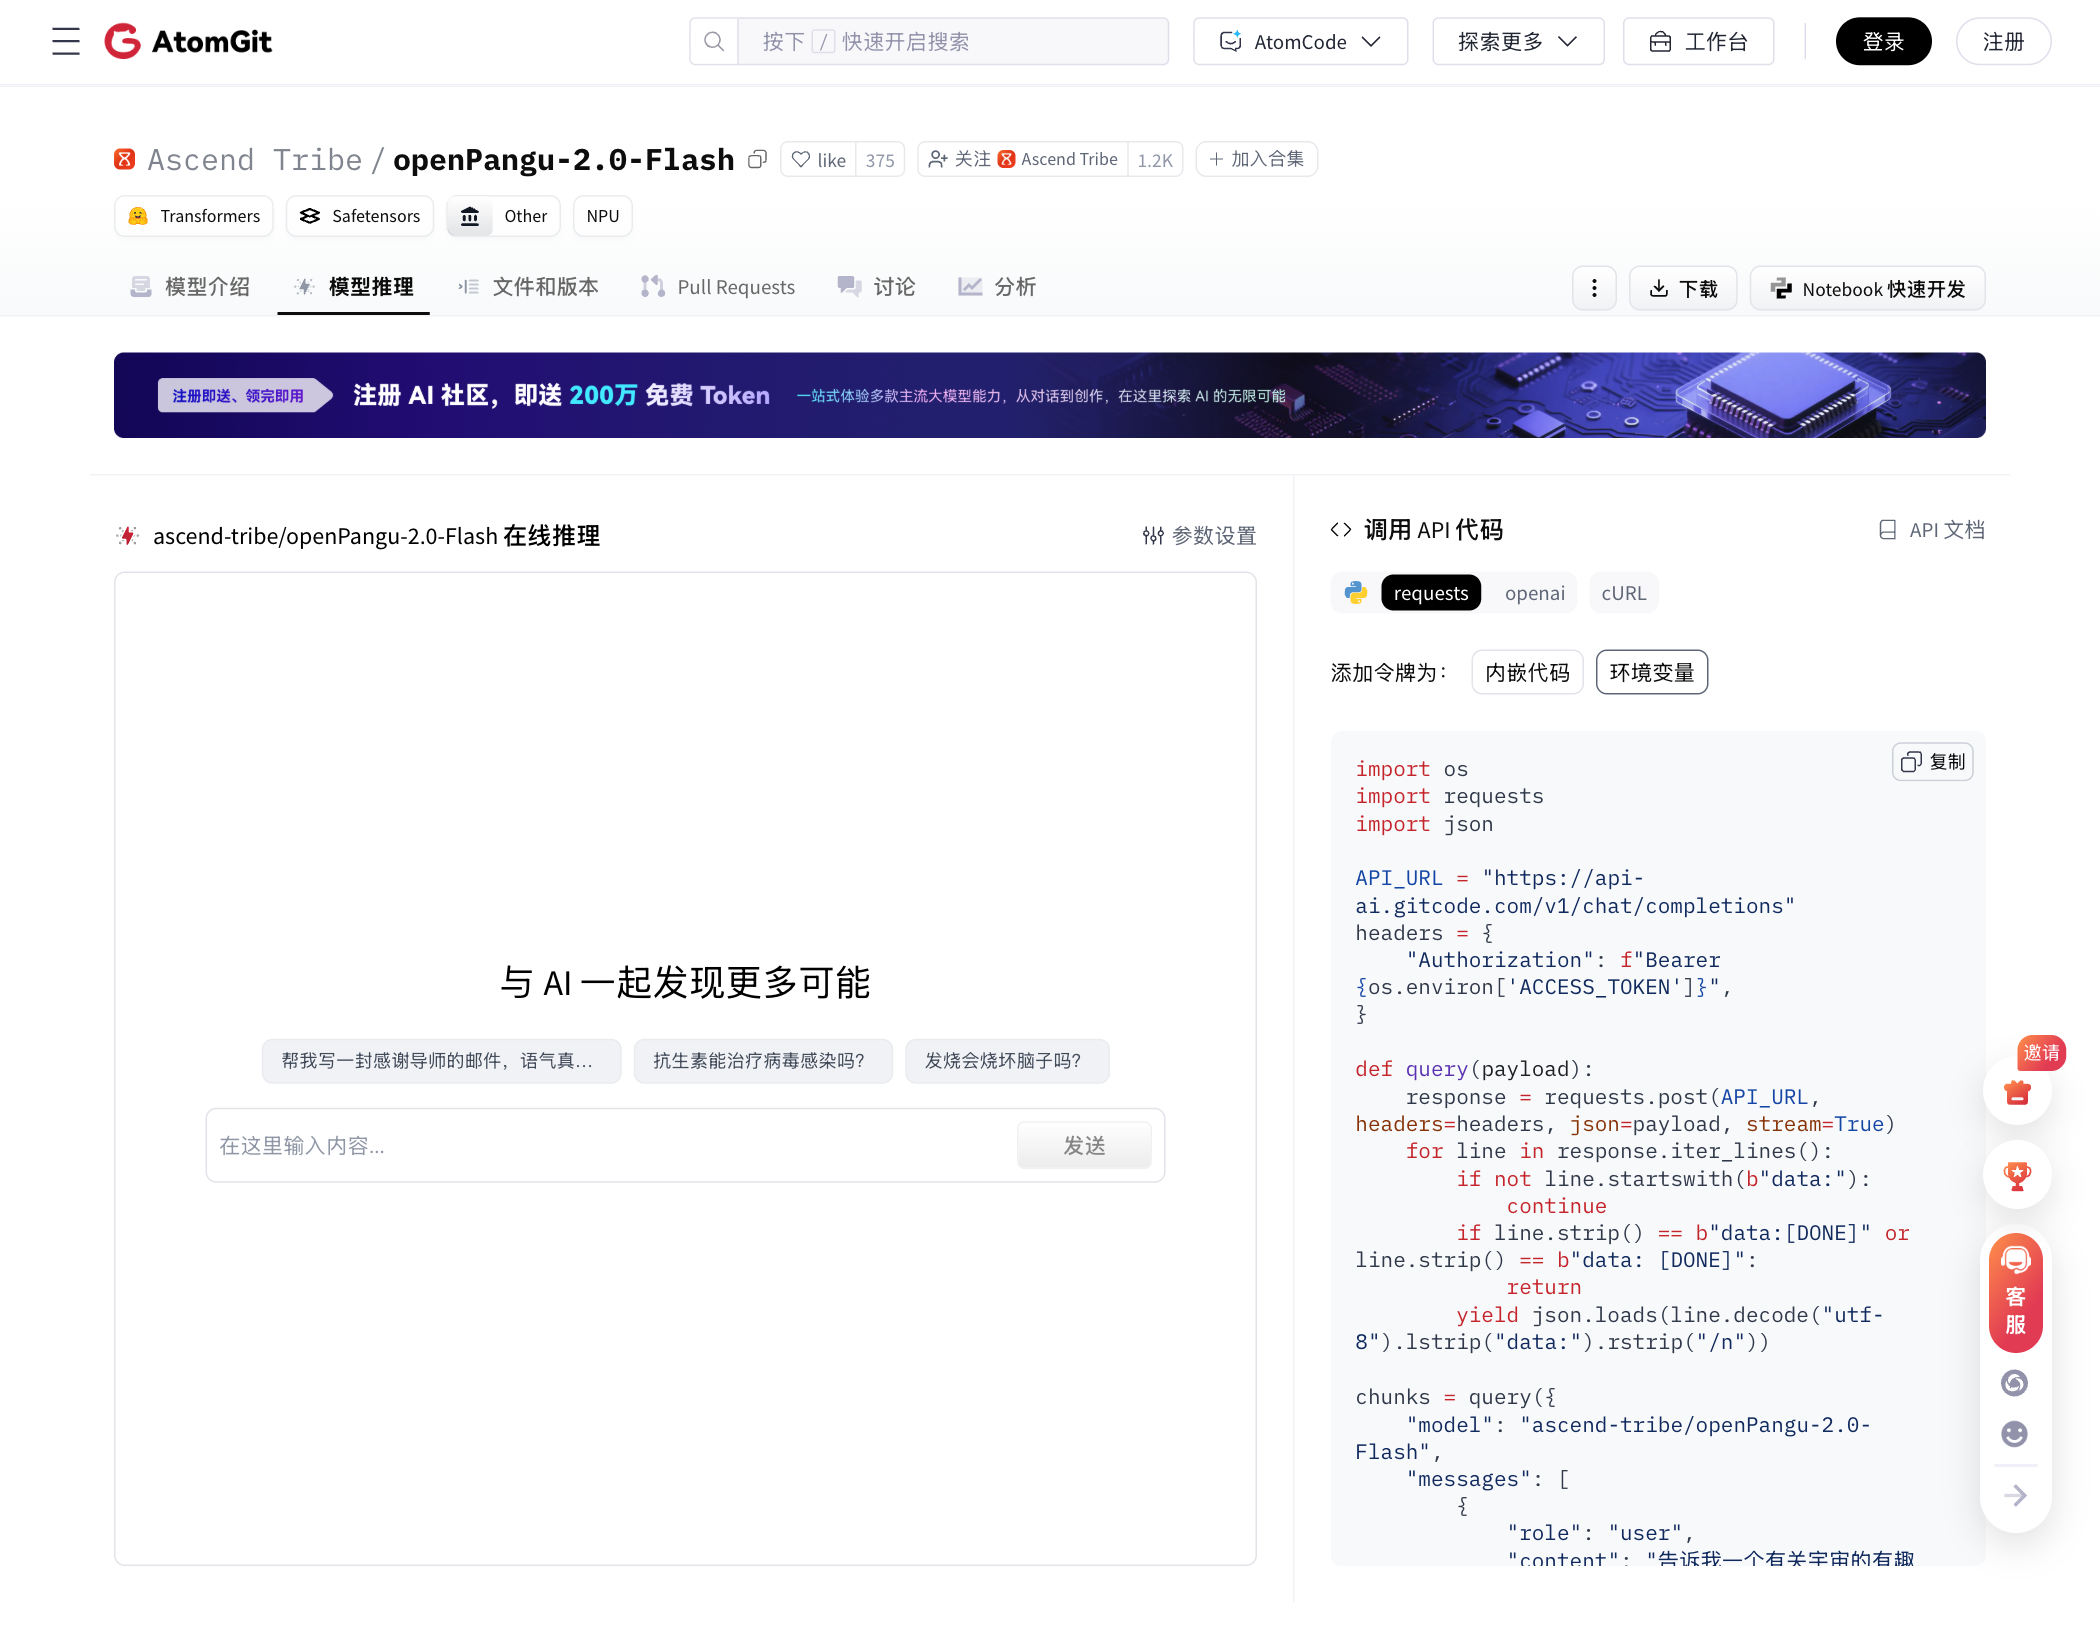
- GitCode 在线推理:在 openPangu-2.0-Flash 模型页 上,社区提供了在线推理 Playground,模型名写
ascend-tribe/openPangu-2.0-Flash,接口地址是https://api-ai.gitcode.com/v1/chat/completions,还支持thinking_budget参数控制思考预算,适合先验证模型能力再决定要不要自建。
路线三:消费级设备,先泼冷水
常见误区是拿个人显卡去跑开源大模型。openPangu 2.0 的权重按昇腾原生设计发布,官方同时提供的是昇腾推理代码,5050 亿的 Pro 档与 920 亿的 Flash 档都远超消费级显卡的显存范围,普通设备无法直接加载完整权重。
个人用户想体验国产开源大模型,更现实的选择是走云端路线,或参考我们整理的 DeepSeek V4 Pro 免费渠道实测、Qwen3.8-27B 本地部署指南 这类按消费级硬件优化过的模型。
需要补充一个容易混淆的点:社区里确实有量化版本,例如 openPangu-R-72B-2512 就有 Int8 量化仓,但 openPangu 2.0 的 Flash 与 Pro 官方目前没有提供面向个人的量化压缩版本,选型时要把这两件事区分开。
硬件门槛速查
- Pro(5050 亿):数据中心级,官方推荐 2P1D、8 台 A3 机器起步,具体组网以官方技术报告与仓库说明为准。
- Flash(920 亿):机构级,官方推荐 1P1D、2 台 A3 机器起步,仍非消费级设备量级。
- 云端体验:无硬件要求,浏览器即可(华为云 MaaS 或 GitCode 在线推理)。
常见坑与报错
- 找不到官方仓库:认准 GitCode 的 ascend-tribe 组织和 Hugging Face 的 openpangu 组织,第三方镜像与个人转存仓库不保证完整性。
- CANN 版本不匹配:昇腾推理对 CANN 版本敏感,装错版本常见算子报错,先查仓库文档的版本对应表再装驱动。
- 多机通信失败:官方明确写到,如果启动因多节点通信问题失败,可以在 prefill 与 decode 的启动命令里加
export HCCL_SOCKET_IFNAME=<网卡名>(用 ifconfig 查)来解决。 - 权重路径不一致:
MODEL_PATH在所有 P、D 节点上必须指向同一份权重,路径不一致会直接起不来。 - 重复执行启动脚本:如果镜像没变,直接复用已有容器即可,重复跑
run_docker会用同名容器覆盖,白等一轮。 - 把 Pro 当 Flash 用:两者定位差距大,机构自建先从 Flash 起步验证链路,再评估 Pro。
部署之外,如果你在比较各大模型该接进自家产品还是按调用付费,可以看 GPT-6 Astra Pro 和 Astra 区别 的订阅决策思路,逻辑是相通的。openPangu 的开源节奏与版本演进,可以配合站内 openPangu 2.0 开源解读 一起看。
常见问题
openPangu 2.0 是完全开源免费吗?
答:Flash 和 Pro 的模型权重、基础推理代码都已官方开源免费下载,推理源码仓库 openPangu-2.0-Infer 标注 Apache-2.0 许可,具体条款以官方仓库的 License 文件为准。
没有昇腾显卡能用吗?
答:本地跑不行,官方推理代码按昇腾优化、基于 Ascend 910C(A3)验证;替代方案是华为云 MaaS 或 GitCode 在线推理,或其他支持 GPU 的开源模型。
Flash 和 Pro 该选哪个?
答:先看算力。官方推荐 Flash(92B)用 1P1D、2 台 A3 机器,Pro(505B)用 2P1D、8 台 A3 机器;有昇腾服务器资源的机构从 Flash 起步验证,Pro 面向数据中心级场景,个人用户建议直接云端体验。
权重从哪里下载最安全?
答:GitCode 的 ascend-tribe 开源社区和 Hugging Face 的 openpangu 官方组织,两个都是华为官方渠道,避免第三方转存。推理代码到 ascend-tribe 的 openPangu-2.0-Infer 仓库取。
部署大概要多久?
答:云端体验分钟级;昇腾自建取决于环境熟悉度,环境就绪且多机免密通好的情况下按 README 走通常一天内可跑通推理,首次建议预留驱动、CANN 版本与多机通信的调试时间。
 京ICP备2024094994号-29