
Ternary Bonsai 2 27B 本地部署:三条路线与硬件门槛
Ternary Bonsai 2 27B 本地部署有三条路线:官方 demo 一键脚本最省事,手搓 GGUF 加官方 llama.cpp fork 最可控,Apple Silicon 走 MLX 原生推理最省心。三条路都免费,需要能访问 Hugging Face 下载权重,硬盘预留 10GB 以上。
本文命令与参数全部来自 Prism ML 官方模型卡与 Bonsai-demo 仓库(2026 年 9 月更新)。
开始之前:先看硬件门槛
| 环境 | 推荐路线 | 内存或显存 | 参考速度 |
|---|---|---|---|
| Apple M5 Max | MLX 或 GGUF | 建议 24GB 统一内存以上 | 约 47 tok/s |
| Apple M5 Pro | MLX 或 GGUF | 建议 16GB 以上 | 28.7 tok/s |
| Apple M4 Pro | MLX 或 GGUF | 建议 16GB 以上 | 18.0 tok/s |
| N 卡 Windows 或 Linux | GGUF(CUDA) | 显存 8GB 起,24GB 更稳 | RTX 4090 约 81 至 91 tok/s |
| 纯 CPU | GGUF(CPU) | 内存 8GB 起 | 明显更慢,适合尝鲜 |
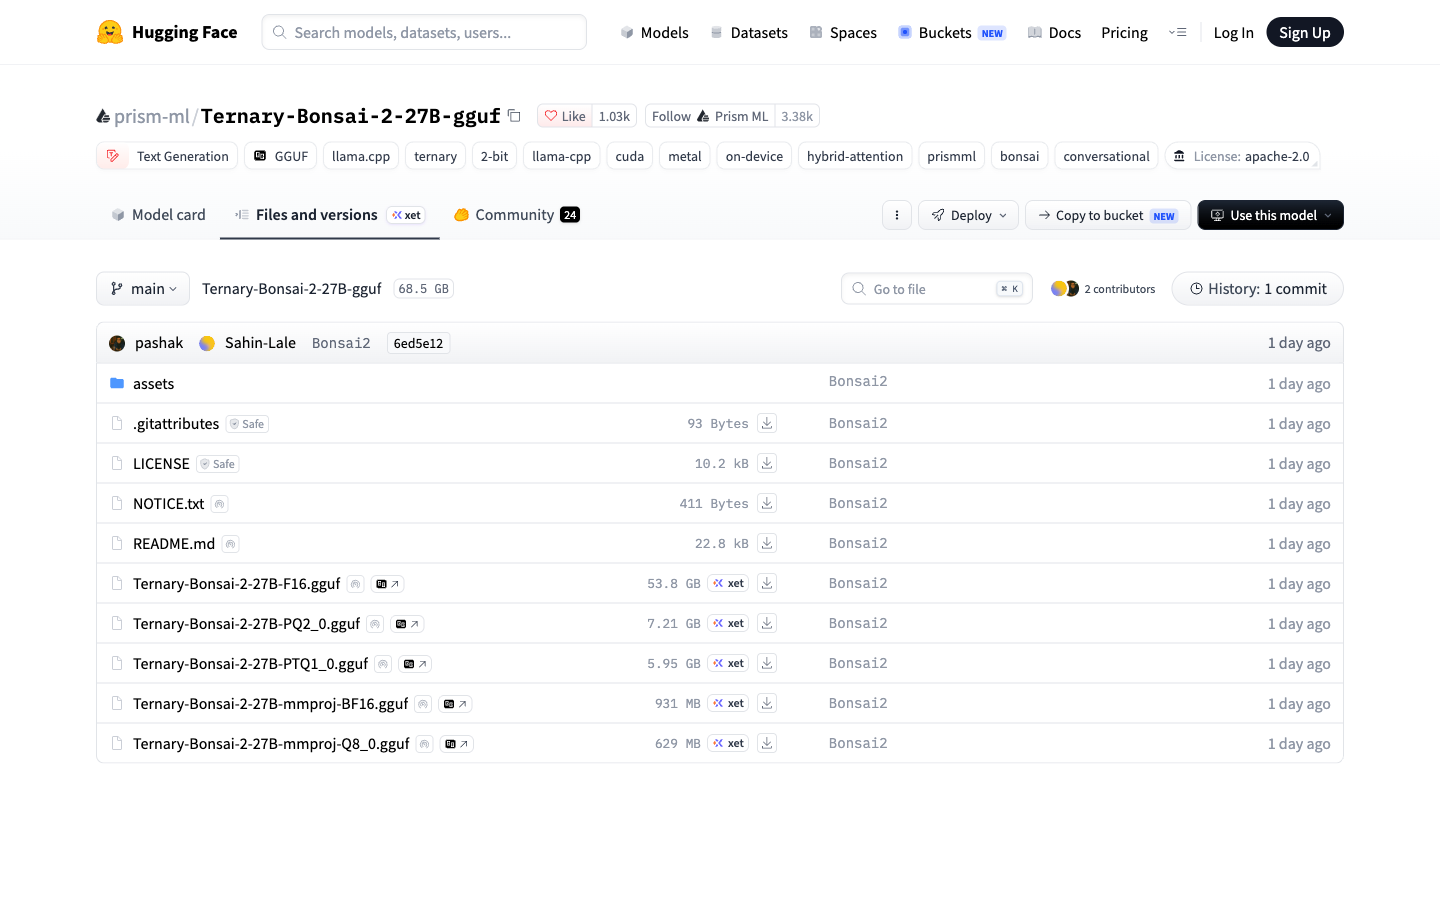
语言模型本体是 5.95GB(PTQ1_0)或 7.21GB(PQ2_0),视觉塔另加约 0.63GB。也就是说 8GB 显存的机器能装下模型,但上下文开大之后依然会紧张。
两个前置条件:
- 需要能访问 Hugging Face 下载权重,国内网络请先确认这一点。
- 需要 Python 与编译环境,官方脚本会自动装 uv、cmake、ninja,不用手动准备。
如果你的设备内存更小,可以先看站内 本地部署大模型需要什么配置?一张表看显存门槛 找到适合自己的量级,或者参考 Qwen3.8-27B Mac 本地部署教程 里 16G 内存的选型思路。
路线一:Bonsai-demo 一键跑通(推荐)
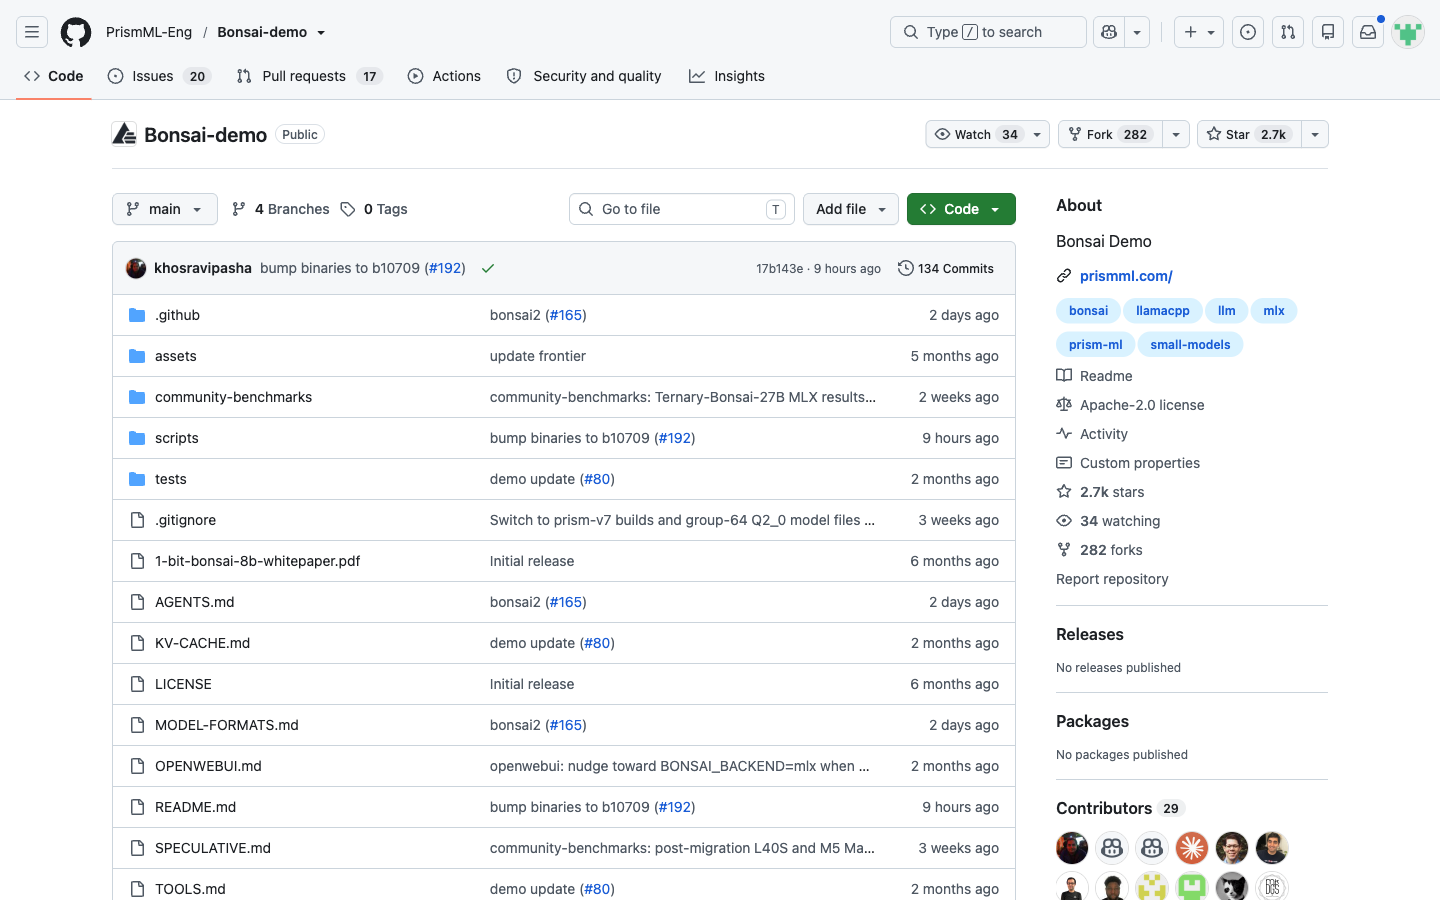
这是官方明确指定的运行参考,脚本会把依赖、二进制和权重一次处理完。
第一步,克隆仓库。
git clone https://github.com/PrismML-Eng/Bonsai-demo.git
cd Bonsai-demo
第二步,执行安装脚本。macOS 与 Linux 用 ./setup.sh,Windows 用 PowerShell 的 ./setup.ps1。
./setup.sh
脚本会依次检查系统依赖、安装 uv、创建虚拟环境、下载模型、下载官方 fork 的预编译二进制;macOS 上还会从源码编译 MLX。默认下载 Bonsai 2 27B 的 PQ2_0 打包,含视觉投影器约 7.8GB。Open WebUI 和代码解释器会额外占用几个 GB 和大部分等待时间,可以用 BONSAI_OPENWEBUI=0 BONSAI_CODE_INTERPRETER=0 跳过。
第三步,启动服务并打开页面。
./scripts/start_llama_server.sh
浏览器访问 http://localhost:8080 就能对话。不想起服务时,也可以直接在终端问一句:
./scripts/run_llama.sh -p "法国的首都是哪里?"
预期结果:终端打印出服务地址,页面能正常对话并显示思考过程。这条路线一次到位,之后换模型只要改环境变量即可。
路线二:手搓 GGUF 加 llama.cpp fork
已有推理环境、想自己控制文件与参数的话走这条。
第一步,下载权重。文件选 PTQ1_0 省空间,选 PQ2_0 换更快的提示处理。文件清单见 Hugging Face 模型卡。
hf download prism-ml/Ternary-Bonsai-2-27B-gguf Ternary-Bonsai-2-27B-PQ2_0.gguf --local-dir .
第二步,拿到官方 fork 的二进制。原版 llama.cpp 跑不了这些文件,必须用 PrismML-Eng/llama.cpp。
git clone https://github.com/PrismML-Eng/llama.cpp && cd llama.cpp
cmake -B build -DGGML_CUDA=ON && cmake --build build -j
macOS 上可以去掉 -DGGML_CUDA=ON,Metal 是默认后端。也可以直接下载官方 Release 里的预编译包,比自行编译省时间。
第三步,用推荐采样参数启动。
./bin/llama-cli -m Ternary-Bonsai-2-27B-PQ2_0.gguf -ngl 99 -fa on -c 32768 --temp 1.0 --top-p 0.95 --top-k 20 -p "用简单的话解释量子计算。" -n 256
参数含义:-ngl 99 表示所有层卸载到 GPU,填 0 就是纯 CPU;-fa on 打开注意力加速;-c 控制上下文长度,最大可以到 262144。
路线三:Apple Silicon 用 MLX 原生推理
MLX 是 Apple 原生路线,但它需要一个容易被忽略的细节:必须用官方包里自带的 runtime,普通 MLX 加载器不会报错,只会给出错误结果。权重仓库见 MLX 2-bit 模型页。
第一步,下载权重。
hf download prism-ml/Ternary-Bonsai-2-27B-mlx-2bit --local-dir bonsai2-27b-mlx
第二步,安装运行环境。
pip install -r bonsai2-27b-mlx/runtime/requirements.txt
第三步,调用模型。模型卡给出的方式是先把包内的 runtime 目录加进模块搜索路径,再用其中的 load_vl_model 加载权重,配合 mlx-vlm 生成结果。不传图片时它就是纯文本模型。这一整套只依赖官方发布的包,不需要额外编译任何 fork。
该权重声明了 model_type: prism_hadamard_qwen35,环境里的普通 MLX 加载器会跳过激活变换和逆嵌入查找,所以输出是错的但不抛异常。这是整条路线里最容易踩的坑。
怎么确认真的跑通了
满足下面三点基本就是正常状态:
- 模型加载日志里能看到 PQ2_0 或 PTQ1_0 这类量化类型,而不是 unknown。
- 回答完整,并且思考内容包在
</think>之前。 - 拿同一个问题对比 FP16 版本或云端 API,答案方向一致,不是胡言乱语。
如果回答读起来通顺但明显答非所问,优先怀疑是不是误用了原版 llama.cpp,这是最常见的原因。
进阶:长上下文、投机解码与工具调用
官方 demo 通过环境变量暴露了这些开关:
| 变量 | 默认值 | 作用 |
|---|---|---|
| BONSAI_CTX | 自动 | 上下文长度,最大 262144 |
| BONSAI_NGL | 自动检测 | GPU 层数,0 为纯 CPU |
| BONSAI_SPECULATIVE | 0 | 开启 dspark 草稿模型投机解码 |
| BONSAI_KV4 | 0 | 4 比特 KV 缓存,适合长上下文 |
| BONSAI_MODEL | 27B | 切换 27B / 8B / 4B / 1.7B |
| BONSAI_FAMILY | bonsai2 | 切换 bonsai2 / ternary / bonsai |
工具调用方面,模型原生支持 OpenAI 风格的 tool_calls,demo 的两个界面都内置了 MCP 服务器。视觉能力在 llama.cpp 和 MLX 上都可用,可以传图片、截图与 PDF。
需要提醒的一点:投机解码依赖 demo 自带的二进制,别用旧版发布包,否则草稿模型文件对不上。
常见报错速查
| 现象 | 原因 | 解法 |
|---|---|---|
| 加载报 unknown type | 用了原版 llama.cpp | 换成 PrismML-Eng/llama.cpp 的二进制 |
| 输出全是乱码 | 加载了 Q2_0 但缺少 Hadamard 变换 | 改用 PQ2_0 或 PTQ1_0 文件 |
| MLX 输出错乱但不报错 | 用了普通 MLX 加载器 | 引入包内的 runtime 目录再加载 |
| 显存不足直接退出 | 上下文设置过大 | 降低 -c 数值,或开启 BONSAI_KV4 |
| 下载速度极慢 | 直连 Hugging Face 受限 | 使用国内镜像或提前离线下载 |
| 对话卡住不动 | 首次加载未完成或内存吃紧 | 等待加载日志结束,或降低模型规格 |
同类模型的部署思路上,也可以参考站内 MiniMax H3 是什么?8GB 显存本地部署与 API 价格全解(2026) 与 openPangu 2.0 本地部署教程:三条路线与硬件门槛,对比不同量级模型的资源占用。
常见问题
Ternary Bonsai 2 27B 本地部署要多大显存?
答:语言模型本体 5.95GB 或 7.21GB,加上上下文开销,建议 8GB 显存起步,24GB 更稳。Apple 设备按统一内存计算。
Windows 能跑吗?
答:能。官方提供 PowerShell 脚本 setup.ps1,走 GGUF 加 CUDA 路线,流程和 macOS 一致。
为什么一定要用官方 fork 的 llama.cpp?
答:三元打包需要运行时的 Hadamard 激活变换,原版还没有合入这个能力,加载会失败或者静默输出乱码。
MLX 和 GGUF 该选哪个?
答:Apple Silicon 想要原生性能、少折腾选 MLX;要跨平台或者用 CUDA 推理就选 GGUF。两条路用的是同一份三元权重。
部署这套模型要花钱吗?
答:模型权重免费,Apache 2.0 许可也没有商用限制,成本只在自己的硬件和电费上。
 京ICP备2024094994号-29