
GLM-6.0 能本地部署吗?现状、硬件门槛与替代
GLM-6.0 现在不能本地部署。截至 2026 年 9 月 17 日,智谱官方只披露了它的技术路线和资金安排,既没有发布模型,也没有开放权重,本地无从下手。如果你手上只有一张显卡、想找个能私有化部署的 GLM,现在能跑的是开源 GLM-5.3 系列;本文把现状、硬件门槛和部署路径一次讲清。
一句话结论:GLM-6.0 未发布、无权重,本地部署不了;能本地部署的开源 GLM 是 GLM-5.3 / GLM-5.3-Flash,但它们需要服务器级多卡,个人更适合走 API。
GLM-6.0 为什么还不能本地部署
原因只有两条:
- 没发布:智谱在 2026 年 8 月 31 日半年度业绩会上由创始人唐杰首次披露 GLM-6.0 的「全自训练(Full Self-Training)」路线,但没有公布模型、参数或发布时间表(来源:新浪财经·观点网)。
- 没权重:开源组织 zai-org 上只有 GLM-5、GLM-5.1、GLM-5.2、GLM-5.3 的权重,没有任何 GLM-6.0 的模型文件。
9 月 12 日智谱再募约 393 亿港元、约六成投向下一代模型与算力,这只是给 GLM-6.0 备好了钱和算力,不代表它已经就绪。
现在能本地部署的开源 GLM 有哪些
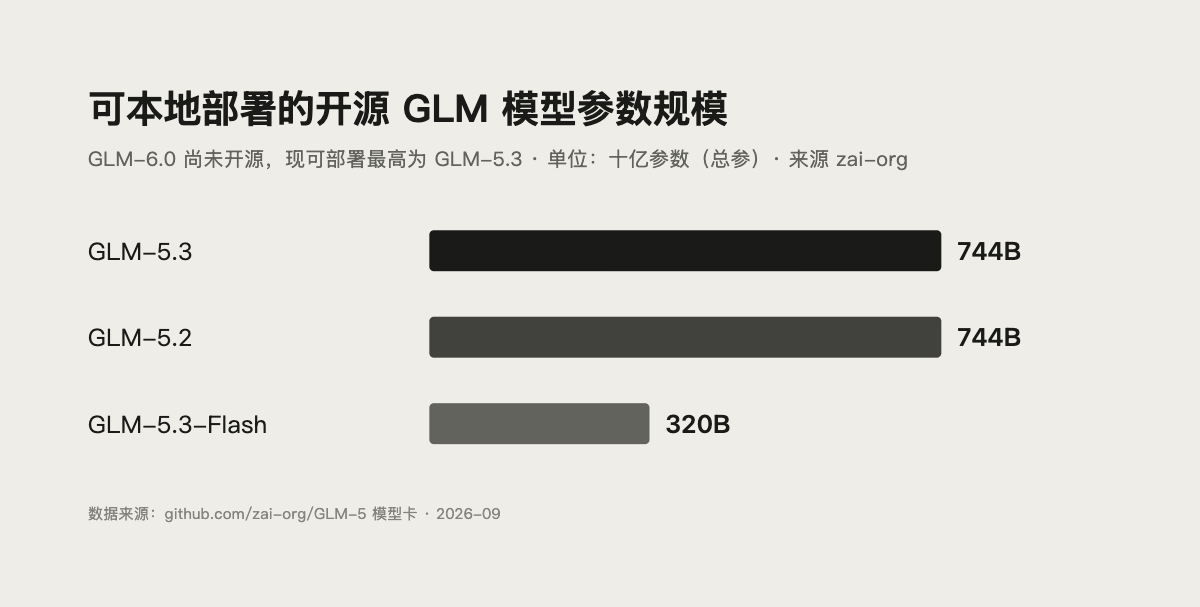
截至 2026 年 9 月 17 日,能在 Hugging Face 和 ModelScope 下载权重的 GLM 主要是 GLM-5 系列:
| 模型 | 规模 | 精度 | 是否开放权重 |
|---|---|---|---|
| GLM-5.3 | 744B(激活 40B) | FP8 / BF16 | 是 |
| GLM-5.3-Flash | 320B(激活 18B) | FP8 / BF16 | 是 |
| GLM-5.2 | 744B(激活 40B) | BF16 / FP8 | 是 |
| GLM-6.0 | 未公布 | 未公布 | 否 |
上面这些模型的权重可以直接在 Hugging Face 的 zai-org 主页 找到,FP8 版本的体积明显小于 BF16。
硬件门槛:为什么个人电脑跑不动
- 体量太大:GLM-5.3 是 744B 参数,即便按 FP8 存储,权重也是数百 GB 量级;GLM-5.3-Flash 也有 300GB 量级。
- 显存不够:一张消费级显卡的显存通常在 8GB 到 24GB,连最小的开源 GLM 权重都放不下,需要多张 80GB 级显存的服务器卡。
- 显存之外还有开销:实际运行时还要为 KV 缓存、并行调度留出显存,真实需求高于权重体积。
结论:想本地跑 GLM-5.3 系列,基本等于租或买一台多卡 GPU 服务器,个人电脑和单卡工作站都不现实。
官方推荐的本地部署路径
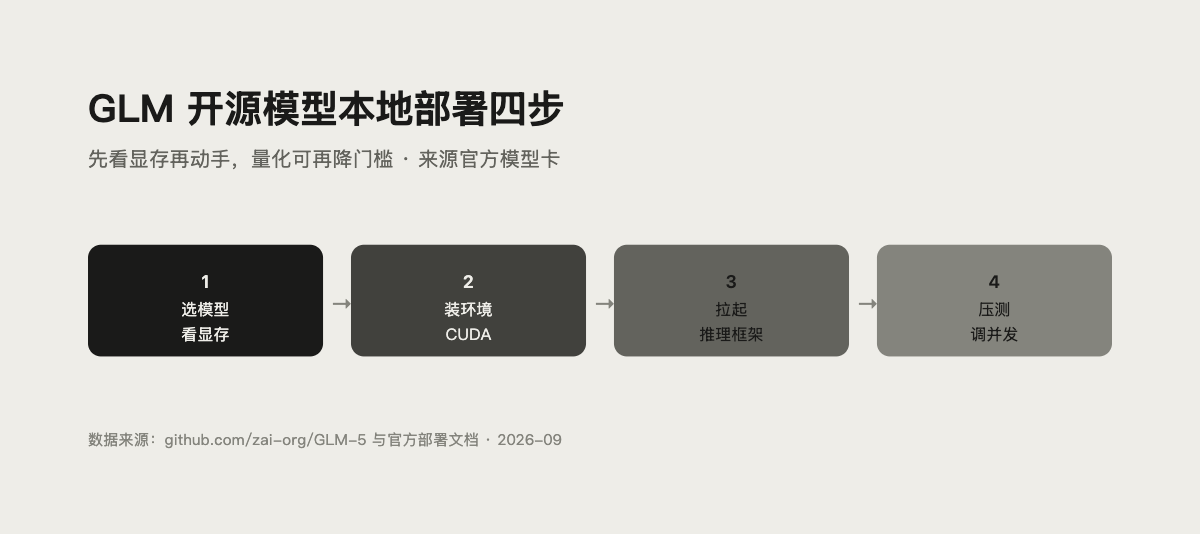
智谱官方给的部署方式是 SGLang、vLLM 和 Transformers。大致流程是:
- 准备多卡 GPU 服务器与匹配的 CUDA 环境。
- 从 Hugging Face 或 ModelScope 下载 GLM-5.3(FP8 版本体积更小)权重。
- 按官方 recipe 用 vLLM 或 SGLang 启动服务,对外暴露 OpenAI 兼容接口。
- 用 OpenAI SDK 指向本地地址做冒烟测试,确认能正常返回。
- 华为昇腾 NPU 环境可用 vLLM-Ascend、xLLM 或 SGLang,官方仓库有对应示例。
如果只是想「在本地玩一玩」,这条路径的成本和运维负担都很高,性价比不如直接用 API。
部署前先算清三笔账
- 硬件账:GLM-5.3 级别的模型需要多卡 GPU 服务器,自购或按小时租云 GPU,前期投入都不小。
- 运维账:模型服务要持续维护推理框架版本、显存调优和扩容,需要专人跟进,这部分成本常被低估。
- 合规账:只有当数据必须留在本地(如内部敏感数据)时,自部署才值得;否则 API 的总体成本通常更低。
一句话:如果你的理由只是「想自己跑一下」,API 更划算;如果理由是「数据不能出内网」,再考虑自部署。
个人和小团队的现实选择
- 直接用 API:通过智谱 BigModel 或 Z.ai 调用 GLM-5.3,按量付费,不用买卡,能力与价格可看 GLM-5.3 评测。
- 用轻量版:GLM-5.3-Flash 更便宜,适合日常编码,参考 GLM-5.3-Flash 使用教程。
- 云 GPU 按小时租:如果必须做私有化验证,租一台多卡云服务器按小时计费,比自建划算。
- 等 GLM-6.0:关注官方渠道,发布后再评估部署方案,进展可看 GLM-6.0 最新进展。
GLM-6.0 发布后怎么迁移
按智谱以往节奏(官方博客 + API + 权重开源),GLM-6.0 发布后大概率也会开放权重。到那时,本地部署的路径与 GLM-5.3 一致:换成新权重、按官方更新的 recipe 启动即可,硬件需求以官方公布为准。
常见问题
GLM-6.0 发布了吗?
答:没有。截至 2026 年 9 月 17 日,官方能用的最新模型是 GLM-5.3,GLM-6.0 未发布、也未开源,官方没有时间表。
网上有 GLM-6.0 本地部署教程,可信吗?
答:不可信。模型和权重都不存在,任何号称「教你部署 GLM-6.0」的教程都缺少真实对象,建议等官方发布后再看。
现在能用哪个 GLM 做本地部署?
答:GLM-5.3(744B,激活 40B)和 GLM-5.3-Flash(320B,激活 18B),均已在 Hugging Face 和 ModelScope 开放权重。
一张 4090 能跑 GLM-5.3 吗?
答:不能。GLM-5.3 权重在数百 GB 量级,单张消费级显卡的显存放不下,需要多张 80GB 级显存的服务器卡。
不想买卡又想用 GLM 怎么办?
答:用智谱 BigModel 或 Z.ai 的 API 按量付费,或租云 GPU 按小时验证,都比自建服务器省事。
 京ICP备2024094994号-29