
Kolibri 本地部署教程:78B参数MoE模型要什么配置
Kolibri 本地部署教程:78B参数MoE模型要什么配置
Kolibri 能本地部署,但门槛在显卡而不在价格:780 亿总参数、FP8 权重约 78GB,官方推荐双卡 A100/H100(80GB)或单卡 H200/B200。权重按 Apache 2.0 免费开放,部署步骤见下。
Kolibri 是什么:780 亿参数只激活 30 亿的英德双语模型
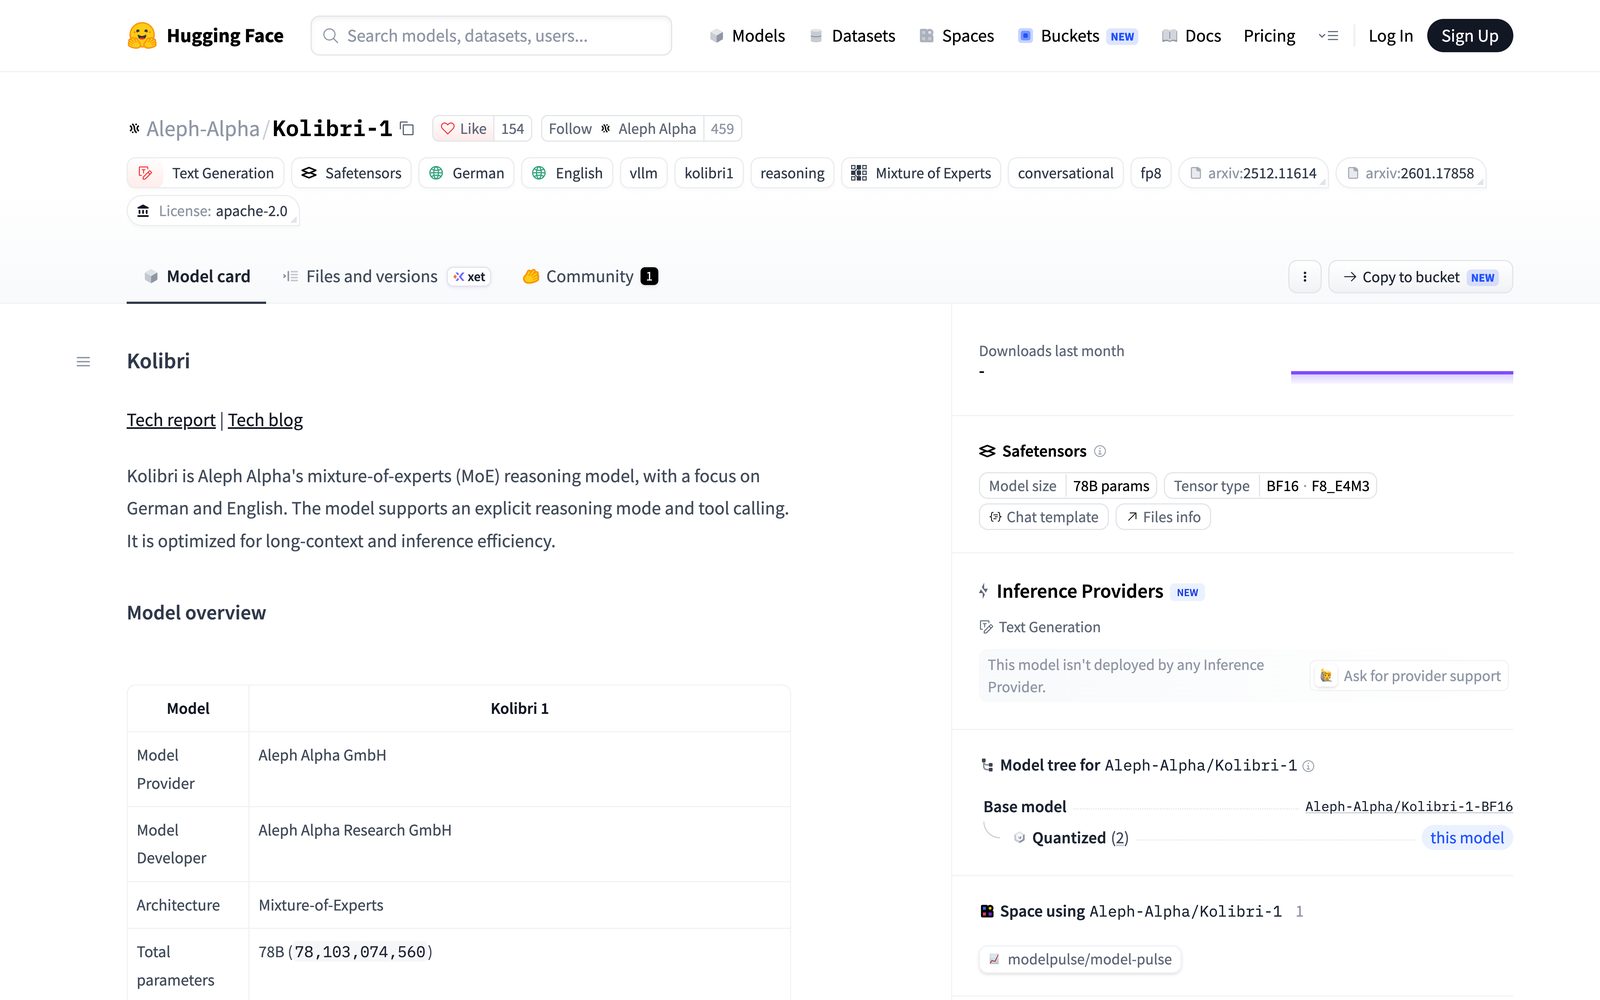
Kolibri 是德国公司 Aleph Alpha 于 2026 年 10 月 3 日(德国统一日)发布的开放权重大模型。它是英德双语混合专家(MoE)Transformer:总参数 780 亿(78.1B),每个 token 只激活约 30 亿(3.46B)参数,计算量接近小模型,内存却要按全部权重算。
模型原生上下文 262,144 token,官方实测验证到 100 万 token。完整权重在 Hugging Face 按 Apache 2.0 免费开放,可商用。
它面向公共管理、工业、航空航天等受监管行业,预训练语料 21.3% 为德语。官方发布博客见 Aleph Alpha 官网,中文唯一报道是网易新闻。
官方用弃权数据和 Merlin-Arthur 协议训练:答案不在上下文时,模型会主动说「我不知道」,做 RAG 比硬答省心;推理可选 none/low/medium/high 四档思考强度。
先弄清同名项目:Kolibri、Colibri 是两回事
搜「Kolibri」很容易踩坑:2026 年 9 月底 GitHub 上另一个项目 Colibri 正火,那是开发者 JustVugg 写的纯 C MoE 推理引擎(JustVugg/colibri),主打 25GB 内存笔记本跑 744B 的 GLM-5.2,和 Aleph Alpha 的 Kolibri 没有任何关系。区别就三点:
- 拼写不同:模型叫 Kolibri(多一个 k),引擎叫 Colibri
- 性质不同:Kolibri 是被推理的模型,Colibri 是跑模型的引擎
- 来源不同:一个来自德国公司 Aleph Alpha,一个是个人开源项目
搜到「本地部署 Kolibri」的资料时先看说的是哪个:如果内容是「SSD 当显存、25GB 内存、GLM-5.2」,那是 Colibri 引擎,别拿它的硬件门槛来套 Kolibri。
本地部署前置检查:先确认显存与框架
1. 显存账:MoE 也要装下全部 78B 权重
MoE 稀疏激活是性能关键,但内存不能省:每个 token 只算 3B 激活参数,推理时全部专家权重都要加载。官方模型卡给出 FP8 约 78GB,其他精度按字节换算(估算):
| 精度 | 权重体积 | 说明 |
|---|---|---|
| FP8 | 约 78GB | 官方口径,推荐 2×A100/H100(80GB)或单卡 H200/B200/B300 |
| BF16 | 约 156GB | 按 2 字节/参数换算的估算 |
按 78GB 权重加 KV cache 余量,单卡 96GB(RTX Pro 6000 Blackwell、H200)有机会跑通;HN 用户实测 fp8 约 170 tokens/s(HN 讨论帖)。消费级 24GB 显卡装不下全量权重,截至发稿也没有官方 GGUF 或 4-bit 版本。想找 8GB 显存就能跑的开源模型,可看 MiniMax H3 本地部署指南。
2. 框架:目前只有 vLLM 官方插件路线
官方推理路径是 vLLM 加 Aleph Alpha 的插件 aleph-alpha-inference,只支持特定 vLLM 版本;llama.cpp / Ollama 生态截至发稿未适配,也没有官方托管 API。
低显存部署可参考 GLM-6.0 本地部署教程 与 MiniCPM 5 的 Ollama 部署教程。
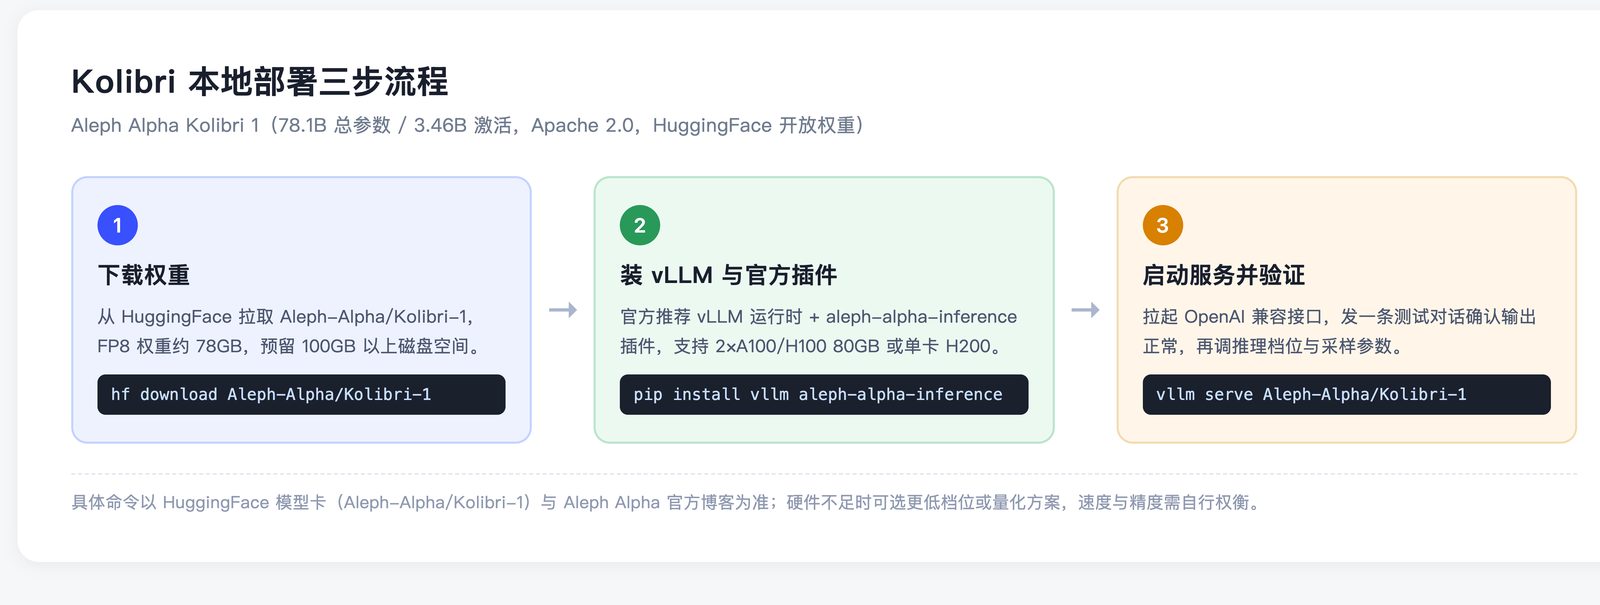
第一步:下载 Kolibri 权重
- 打开模型页 huggingface.co/Aleph-Alpha/Kolibri-1,确认许可为 Apache 2.0
- 国内加速:设置镜像环境变量
export HF_ENDPOINT=https://hf-mirror.com,再执行下载 - 用官方 CLI 拉取完整权重:
huggingface-cli download Aleph-Alpha/Kolibri-1 --local-dir kolibri-1
- 下载后核对 config.json、tokenizer 与权重齐全,体积约 78GB 再继续
第二步:安装 vLLM 与官方推理插件
- 创建 Python 3.10+ 环境,按插件 README 安装匹配的 vLLM 版本
- 安装官方插件:
pip install 'aleph-alpha-inference>=1'
- 确认版本对齐,否则启动时找不到解析器
第三步:启动本地服务
- 按官方 README 启动 vLLM:
vllm serve Aleph-Alpha/Kolibri-1 --kv-cache-dtype fp8 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
- 看到服务监听 http://localhost:8000 且权重加载完成即成功
- 模型卡推荐采样参数:temperature=1.0、top_p=0.97、top_k=128;对延迟敏感场景,上下文建议不超过 262,144 token
第四步:调用并验证跑通
服务是 OpenAI 兼容接口,任意 OpenAI SDK 都能连:
from openai import OpenAI
client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")
resp = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{"role": "user", "content": "Erkläre kurz, was ein Mixture-of-Experts-Modell ist."}],
    extra_body={"chat_template_kwargs": {"reasoning_effort": "high", "enable_thinking": True}},
)
print(resp.choices[0].message.content)
验证成功的 3 个信号:
- 首次请求正常返回,无 CUDA OOM 或 vLLM 报错
- 德语与英语输出都流畅
- 问一个上下文里没有答案的问题,模型回答「我不知道」而不是硬编
进阶:开启 100 万上下文
Kolibri 原生 262,144 token,官方实测到 100 万,需要更长上下文时加两个参数:
vllm serve Aleph-Alpha/Kolibri-1 --kv-cache-dtype fp8 \
  --max-model-len 1048576 \
  --hf-overrides '{"max_position_embeddings": 1048576}'
100 万上下文的 KV cache 显存占用非常大。官方对比:同样两张 H100 上,123B 模型只能同时处理 3 个 256k token 长上下文请求,78B 的 Kolibri 能处理 18 个,解码还快 28%,部署时要按并发预留显存。
常见报错速查
| 错误现象 | 原因 | 解法 |
|---|---|---|
| CUDA out of memory | 显存放不下 78GB 权重 + KV cache | 确认用 FP8;上下文降到 262k;换官方推荐的双卡或更大显存 |
| 找不到 kolibri1 parser | vLLM 与插件版本不对齐 | 按插件 README 对齐 vLLM 版本后重装 |
| 下载卡住或极慢 | 直连 Hugging Face 网络不稳 | 设 HF_ENDPOINT=https://hf-mirror.com 后重试 |
| 输出全是「我不知道」 | 答案不在上下文,模型按设计拒答 | 用 RAG 把资料放进上下文;这是特性不是 bug |
| 响应慢、思考 token 偏多 | reasoning_effort 开太高 | 改成 low 或 none,深度推理时再开 high |
常见问题
Kolibri 能在普通游戏显卡上跑吗?
答:不能。FP8 权重约 78GB,官方推荐 2×A100/H100(80GB)或单卡 H200/B200/B300;24GB 显卡装不下全量权重,也没有官方 GGUF 量化版本。
Kolibri 和 GitHub 上的 Colibri 是同一个东西吗?
答:不是。Kolibri 是 Aleph Alpha 发布的英德双语 MoE 大模型;Colibri(JustVugg/colibri)是纯 C 推理引擎,两者只是名字像。
Kolibri 免费吗?可以商用吗?
答:权重免费。按 Apache 2.0 开放可商用;Aleph Alpha 保留训练代码与方法版权。没有官方托管 API,需自己部署或联系销售。
国内用户怎么下载这 78GB 权重?
答:设置 `export HF_ENDPOINT=https://hf-mirror.com` 后用 huggingface-cli 下载,命令见上文「第一步」。
100 万上下文对显存要求高吗?
答:非常高。原生 262,144 token 已够大多数场景;开满 100 万时 KV cache 会吃掉大量显存。官方测过 78B 在两张 H100 上可并发 18 个 256k 长上下文请求,部署请按并发预留显存。
为什么 Kolibri 总回答「我不知道」?
答:这是设计特性。官方用 Merlin-Arthur 协议与弃权数据训练,答案不在上下文时会主动拒答。做 RAG 把资料放进上下文即可。
 京ICP备2024094994号-29