
MiniCPM 5 本地 Ollama 部署教程:量化与实测
MiniCPM 5 本地 Ollama 部署教程:量化与实测
MiniCPM5-2B 用 Ollama 部署只需要四步:装 Ollama、拉官方 GGUF、写一份 Modelfile、创建并运行模型,全程不需要 Python 环境和 CUDA 工具链,模型免费。默认推荐 Q4_K_M 量化,磁盘占用只有 1.56GB,普通笔记本就能跑起来。
前置准备:装 Ollama
macOS 用 Homebrew:
brew install ollama
Linux 用官方脚本:
curl -fsSL https://ollama.com/install.sh | sh
装完建议在启动前把两个环境变量打开,尤其在做长上下文任务时:
OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 ollama serve &
这两个变量分别开启 Flash Attention 和把 KV 缓存量化到 q8_0,目的是在上下文变长时压低显存和内存占用。
如果你用的是 Apple 芯片的 Mac,官方还提供 MLX 路径,文档里把 MLX 列为 Apple Silicon 上的另一个选择,官方说它在 Q4 量化下比 GGUF 更快。完整命令可以对照 官方 Ollama 部署文档。
选量化:三档体积与质量怎么选
官方对 MiniCPM5-2B 给了三档量化,体积差距很大,选错了会白白多吃内存:
| 量化 | 磁盘占用 | 质量 | 建议 Ollama 标签 |
|---|---|---|---|
| F16 | 5.04 GB | 参考基准 | :fp16 |
| Q8_0 | 2.68 GB | 官方称与 F16 几乎无法区分 | :q8 |
| Q4_K_M | 1.56 GB | 有轻微下降,官方称最适合笔记本 | :q4_k_m(默认推荐) |
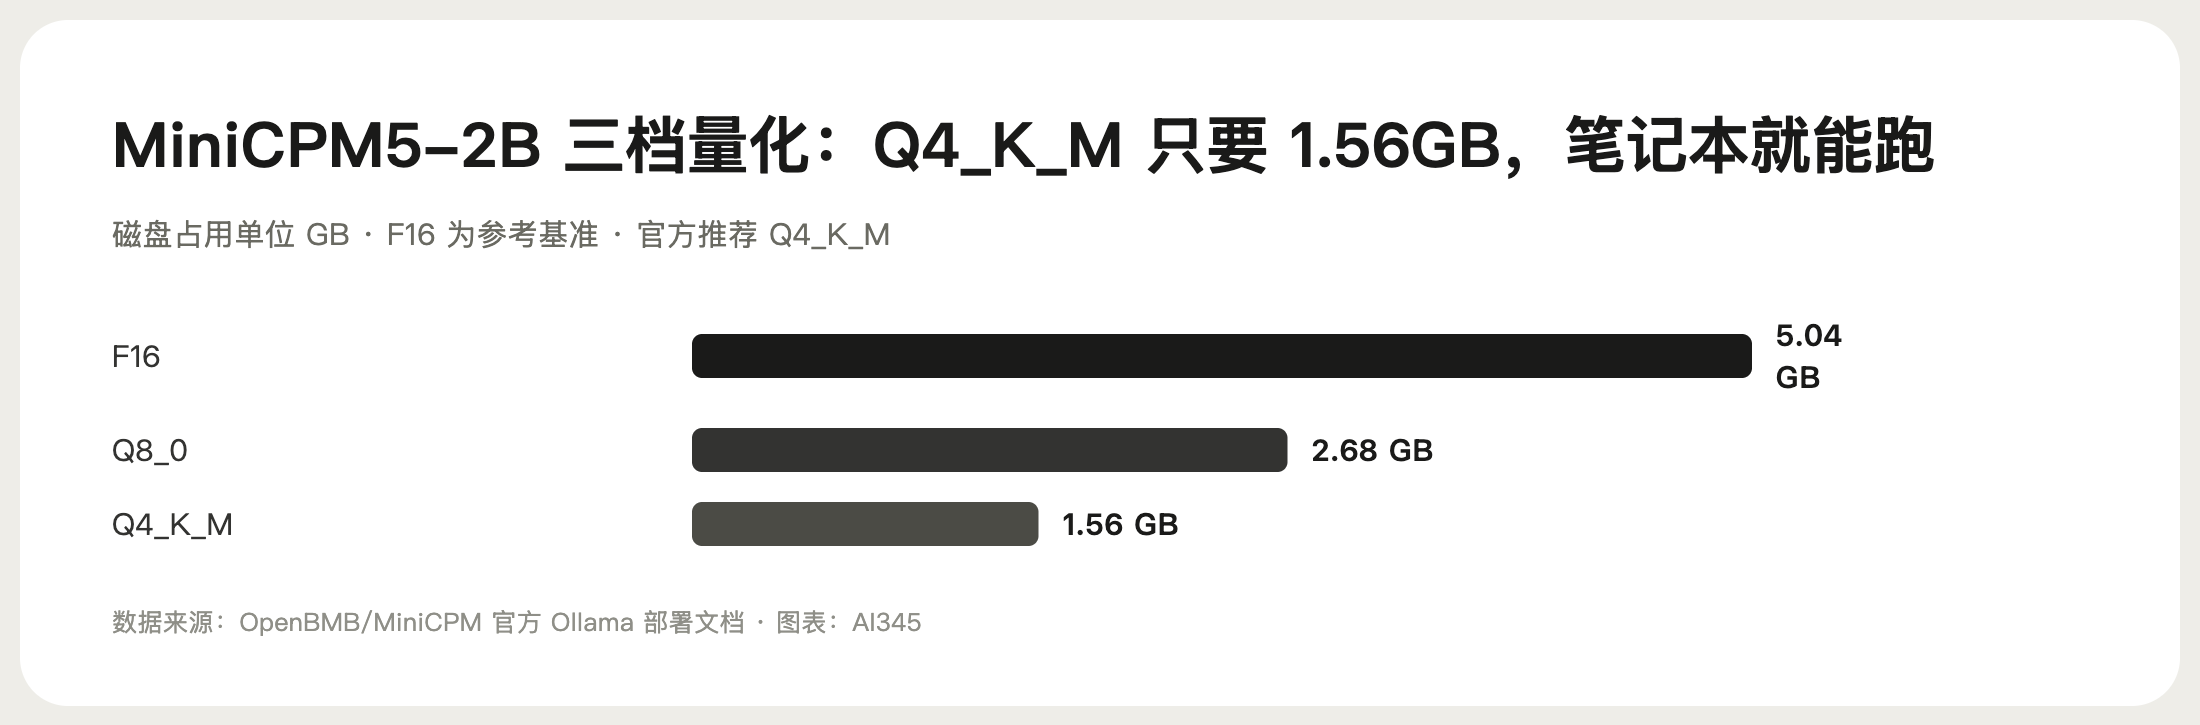
怎么选:笔记本和内存紧张的设备直接上 Q4_K_M;有 16GB 以上内存、想尽量贴近原始质量,用 Q8_0;F16 一般只在需要参考基准做对比时用,日常没必要。
拉 GGUF 并创建模型
先建目录,把 MiniCPM5-2B-GGUF 里的 Q4_K_M 文件拉下来:
mkdir -p ~/minicpm5-2b && cd ~/minicpm5-2b
huggingface-cli download openbmb/MiniCPM5-2B-GGUF MiniCPM5-2B-Q4_K_M.gguf --local-dir .
然后在同目录下写一份 Modelfile。这里是最容易出错的一步,照抄官方写法:
FROM ./MiniCPM5-2B-Q4_K_M.gguf

TEMPLATE """{{- if .Messages -}}
{{- range .Messages -}}
<|im_start|>{{ .Role }}
{{ .Content }}<|im_end|>
{{ end -}}
<|im_start|>assistant
{{ end -}}"""

PARAMETER stop "<|im_end|>"
PARAMETER stop "</s>"

PARAMETER temperature 1.0
PARAMETER top_p 0.95
PARAMETER num_ctx 8192
创建并运行:
ollama create minicpm5-2b -f Modelfile
ollama run minicpm5-2b
为什么必须手写 TEMPLATE?官方文档写得很清楚:Ollama 0.24 不会直接解析 GGUF 里内嵌的 Jinja 对话模板,它会尝试把识别到的 Jinja 模板映射成内置的 Go 模板,MiniCPM5 不在这套映射里,所以要显式给一段 Go 的 TEMPLATE 块。漏掉这一步,模型会用错误的对话格式,表现就是答非所问或者格式混乱。
跑通验证:命令对话加本地 API
命令行直接聊,能正常中文问答就算跑通:
ollama run minicpm5-2b
再验证一下 OpenAI 兼容接口,端口固定是 11434:
curl http://localhost:11434/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "minicpm5-2b",
        "messages": [{"role": "user", "content": "用一句话解释 GQA。"}],
        "temperature": 1.0, "top_p": 0.95, "max_tokens": 1024
    }'
第一次运行会先把模型加载到内存,稍等几秒再输入问题。判断是否真跑通,看两点:能不能用中文正常回答,以及回答有没有出现重复循环或格式错乱,后者通常说明模板没配对。
如果你要把它接进自己的代码,看到 http://localhost:11434/v1 就说明接口通了,后面按 OpenAI SDK 的写法接就行。
调到更好用:三处常用调整
长文档场景调上下文:官方文档默认
num_ctx设的是 8192,MiniCPM5-2B 支持到 131,072。长文档或大代码文件场景,把 Modelfile 里改成PARAMETER num_ctx 32768,同时保持 Flash Attention 与 q8_0 KV 缓存开启。进 think 模式:Ollama 0.24 走不通模板里的 think 路径,官方给的办法是用 raw 模式手动前置思考标记:
curl http://localhost:11434/api/generate -d '{
    "model": "minicpm5-2b",
    "raw": true,
    "prompt": "<|im_start|>user
你的问题<|im_end|>
<|im_start|>assistant
<think>
",
    "options": {"temperature": 1.0, "top_p": 0.95}
}'
- 采样参数对齐官方:官方推荐 temperature 1.0、top_p 0.95、min_p 0.0。注意
min_p这一项,llama.cpp 默认是 0.05,官方指出这个默认值会过滤掉概率低于最高概率 token 5% 的候选,结果就是把打破重复循环要用的那个 token 也滤掉了,所以必须显式设成 0.0。
常见报错速查
| 现象 | 原因 | 解法 |
|---|---|---|
| 输出反复重复同一段 | 默认 min_p 为 0.05,把破循环的 token 滤掉了 | 设 min_p=0.0,仍重复再加 repetition_penalty=1.05 |
| 能对话但答非所问、格式乱 | 没写显式 Go TEMPLATE,Ollama 套用了错误模板 | 按官方 Modelfile 补上 TEMPLATE 块与 stop 参数 |
| 拉 GGUF 很慢或失败 | Hugging Face 直连慢 | 用镜像,或从 ModelScope 下载同一份 GGUF 再本地加载 |
| 长文档回答被截断 | num_ctx 默认只有 8192 |
调高 num_ctx(如 32768),并开启 Flash Attention 与 q8_0 KV 缓存 |
| 内存吃紧、加载失败 | 选了 F16 量化(5.04GB) | 换 Q4_K_M(1.56GB)或 Q8_0(2.68GB) |
| 想要 think 模式没反应 | Ollama 0.24 不直接解析 Jinja 模板 | 用 raw 模式手动前置 <think> |
进阶:什么时候该换后端
Ollama 适合个人本地用,但有几类需求它不合适,官方也给了替代路径:
要做工具调用(function calling):官方推荐 SGLang,启动时加
--tool-call-parser minicpm5,它能把模型输出的 XML 风格工具调用转成 OpenAI 兼容的tool_calls。要跑并发服务:用 vLLM,官方给出的启动方式是
vllm serve openbmb/MiniCPM5-2B --port 8000。想在 Mac 上跑得更快:走 MLX 路径;想要桌面图形界面加 OpenAI 服务,用 LM Studio;手机与 IoT 设备可以用 LiteRT-LM 的
.litertlm运行时。要国产芯片:官方通过 FlagOS 适配了 9 种 AI 芯片,包括昇腾、海光、沐曦、天数智芯、摩尔线程等,权重在 FlagRelease 上有对应版本。
常见问题
MiniCPM5-2B 用 Ollama 跑要什么硬件?
答:要求不高。Q4_K_M 量化只有 1.56GB,普通笔记本就能跑;官方称这是最适合笔记本的一档。想要更好质量可以用 Q8_0(2.68GB),F16 是 5.04GB,一般只在做质量基准对比时用。
Ollama 里能直接 pull 到 MiniCPM5-2B 吗?
答:官方给的路径是自己拉 GGUF 再用 Modelfile 创建,并没有直接 `ollama pull` 的官方模型名。注意别和多模态的 MiniCPM-V 混淆,MiniCPM-V 4.6 已经在 Ollama 官方模型库里,那是另一个模型。
为什么模型输出老是重复?
答:最常见原因是 min_p 参数。llama.cpp 默认 min_p 为 0.05,官方说明这个默认值会过滤掉低概率候选,连打破重复循环需要的 token 也一起过滤掉。显式设成 min_p=0.0 即可,仍重复就再加 repetition_penalty=1.05。
上下文能开到多长?
答:模型本身支持到 131,072。Ollama 的官方 Modelfile 默认写的是 num_ctx 8192,需要按官方建议手动调高,例如 32768,同时开启 OLLAMA_FLASH_ATTENTION=1 与 OLLAMA_KV_CACHE_TYPE=q8_0 来压住内存占用。
想用它做工具调用,Ollama 够吗?
答:可以跑,但官方推荐用 SGLang 做工具调用后端,因为它内置的 minicpm5 解析器能把模型输出的 XML 风格工具调用直接转成 OpenAI 兼容格式。要稳定的 Agent 与工具调用流程,建议换到 SGLang 或 vLLM。
国内下载 GGUF 慢怎么办?
答:官方在 Hugging Face 和 ModelScope 都放了权重,包括 GGUF 版本。国内直连 Hugging Face 慢的话,改用 ModelScope 下载同一份量化文件,放到本地目录后再用 Modelfile 的 FROM 指向本地路径即可。
 京ICP备2024094994号-29