
开源模型和闭源模型怎么选?一张对比表讲清 6 个真实成本
开源模型和闭源模型怎么选?一张对比表讲清 6 个真实成本
结论先行:要快、要省心、用量不稳定,选闭源 API;要数据不出门、用量巨大且稳定、想深度定制,选开源自建。判断的关键不是"谁更强",而是下面六项真实成本你愿意付哪些。
先纠正一个误解:开源不等于免费
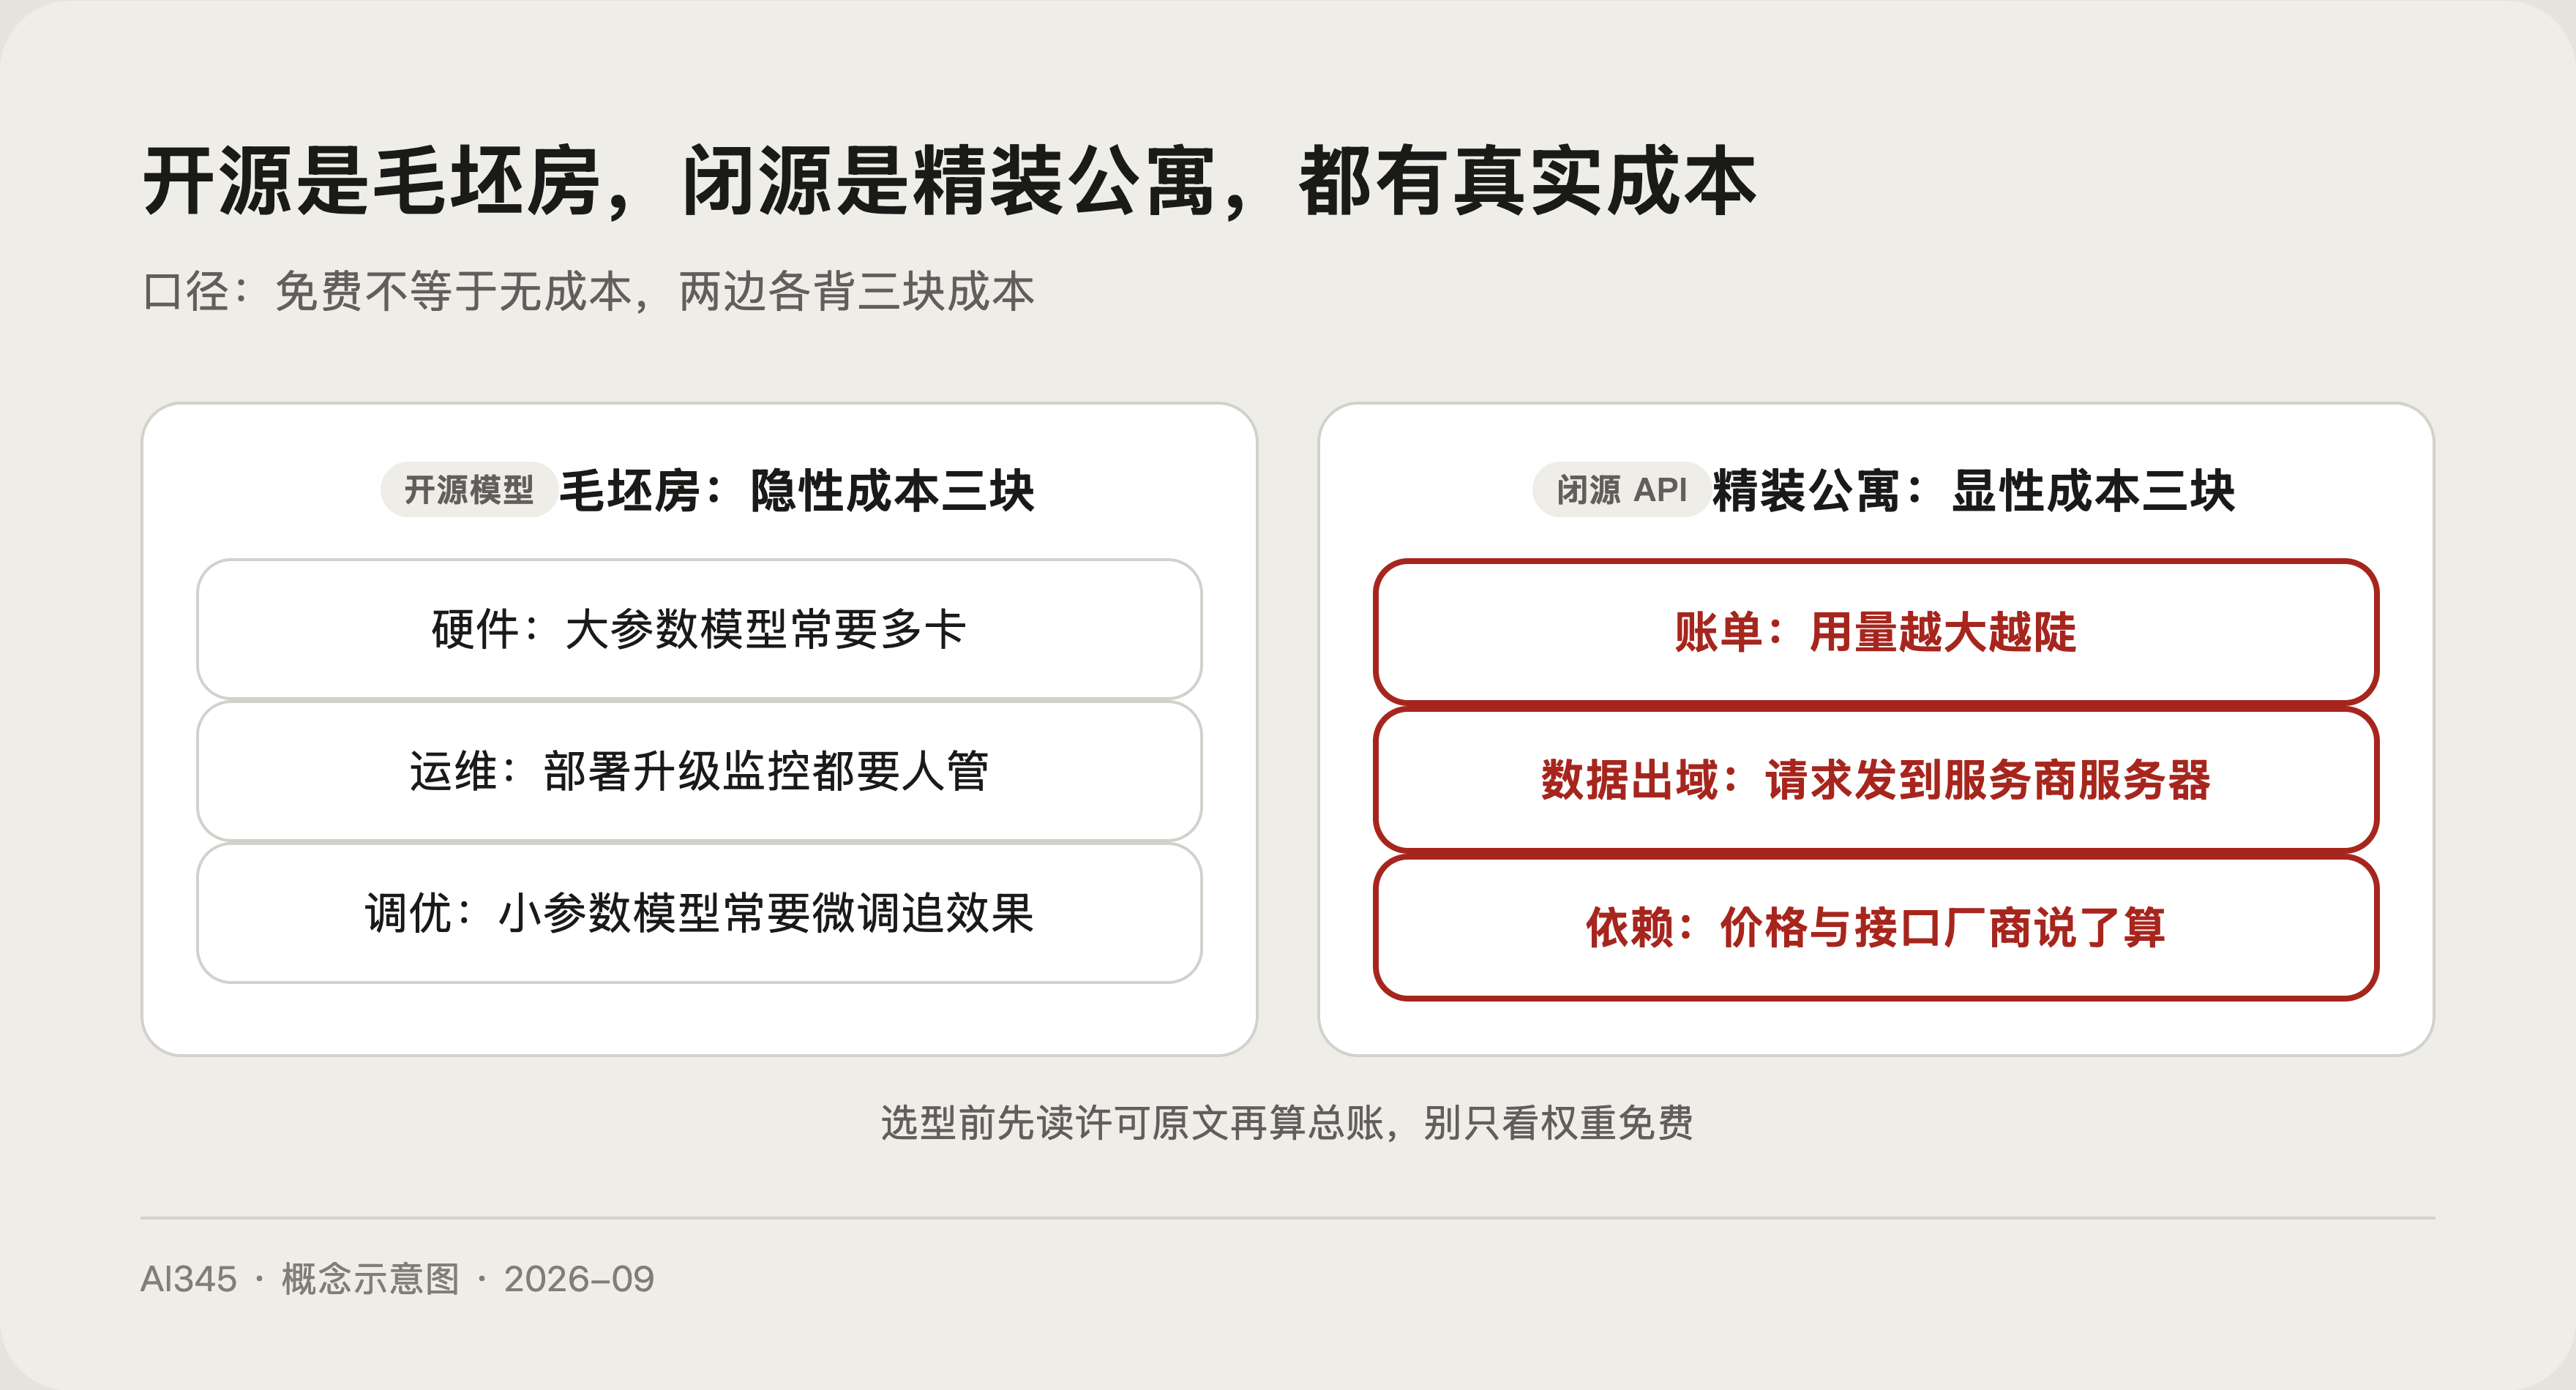
用房子打比方:开源模型像免费送你一套毛坯房,房子本身不要钱,但装修(部署)、物业(显卡和电费)、维护(运维人力)都要自己掏;闭源模型像拎包入住的酒店式公寓,按月付房租(API 按量计费),房东包办一切,但房规房东定。
开源的真实成本有三块:一是硬件,大参数模型要占大量显存,常常要多卡;二是运维人力,部署、升级、监控都得有人管;三是效果调优,小参数开源模型想追平闭源效果,往往要微调或写更精细的提示词。
闭源的真实成本也有三块:一是按量付费,用量越大账单越陡;二是数据出域,所有请求都发到服务商服务器;三是依赖风险,价格调整、接口变更、服务下线都由厂商说了算。
license 也算成本:免费的房子要先读房产证
开源模型的"开放程度"写在许可证里,各家差别很大,选型前必须逐条读原文:
- Llama 3 社区许可:允许商用,但附带一个特殊条款,如果产品月活超过 7 亿,需要向 Meta 单独申请许可(来源:Llama 3 官方许可页)。对绝大多数团队没有实际影响,但条款确实存在。
- DeepSeek-R1:采用 MIT 许可,商用限制极少(来源:DeepSeek-R1 模型页)。
- Qwen2.5-7B-Instruct:采用 Apache 2.0 许可,可自由商用并附带专利授权条款(来源:Qwen 模型页)。
闭源 API 的"许可"则是服务条款:能否用输出训练竞品、数据保留多久、企业版和普通版的隐私承诺差异,都要在采购前确认。
六项成本对比表
| 成本项 | 开源模型 | 闭源 API |
|---|---|---|
| 显性费用 | 权重免费,硬件自购 | 按 token 计费 |
| 数据隐私 | 数据不出本地 | 数据出域到服务商 |
| 可控性 | 权重在手,可微调可替换 | 受厂商版本与条款约束 |
| 运维成本 | 自己部署与运维 | 基本零运维 |
| 效果上限 | 旗舰开源模型已接近闭源 | 通常是当期最强闭源版本 |
| 扩容弹性 | 受硬件限制,扩容要买卡 | 弹性扩容随时生效 |
效果那一行要说明:旗舰开源模型在多数通用任务上已经接近闭源,比如首次开源的 Qwen3.8-Max(见我们的解读)和字节开源 36B 档的 Seed-OSS-36B(见解读),差距在持续缩小,但"接近"不等于"相同",关键业务仍要按自己的评测数据验证。
什么场景选哪个:一张决策表
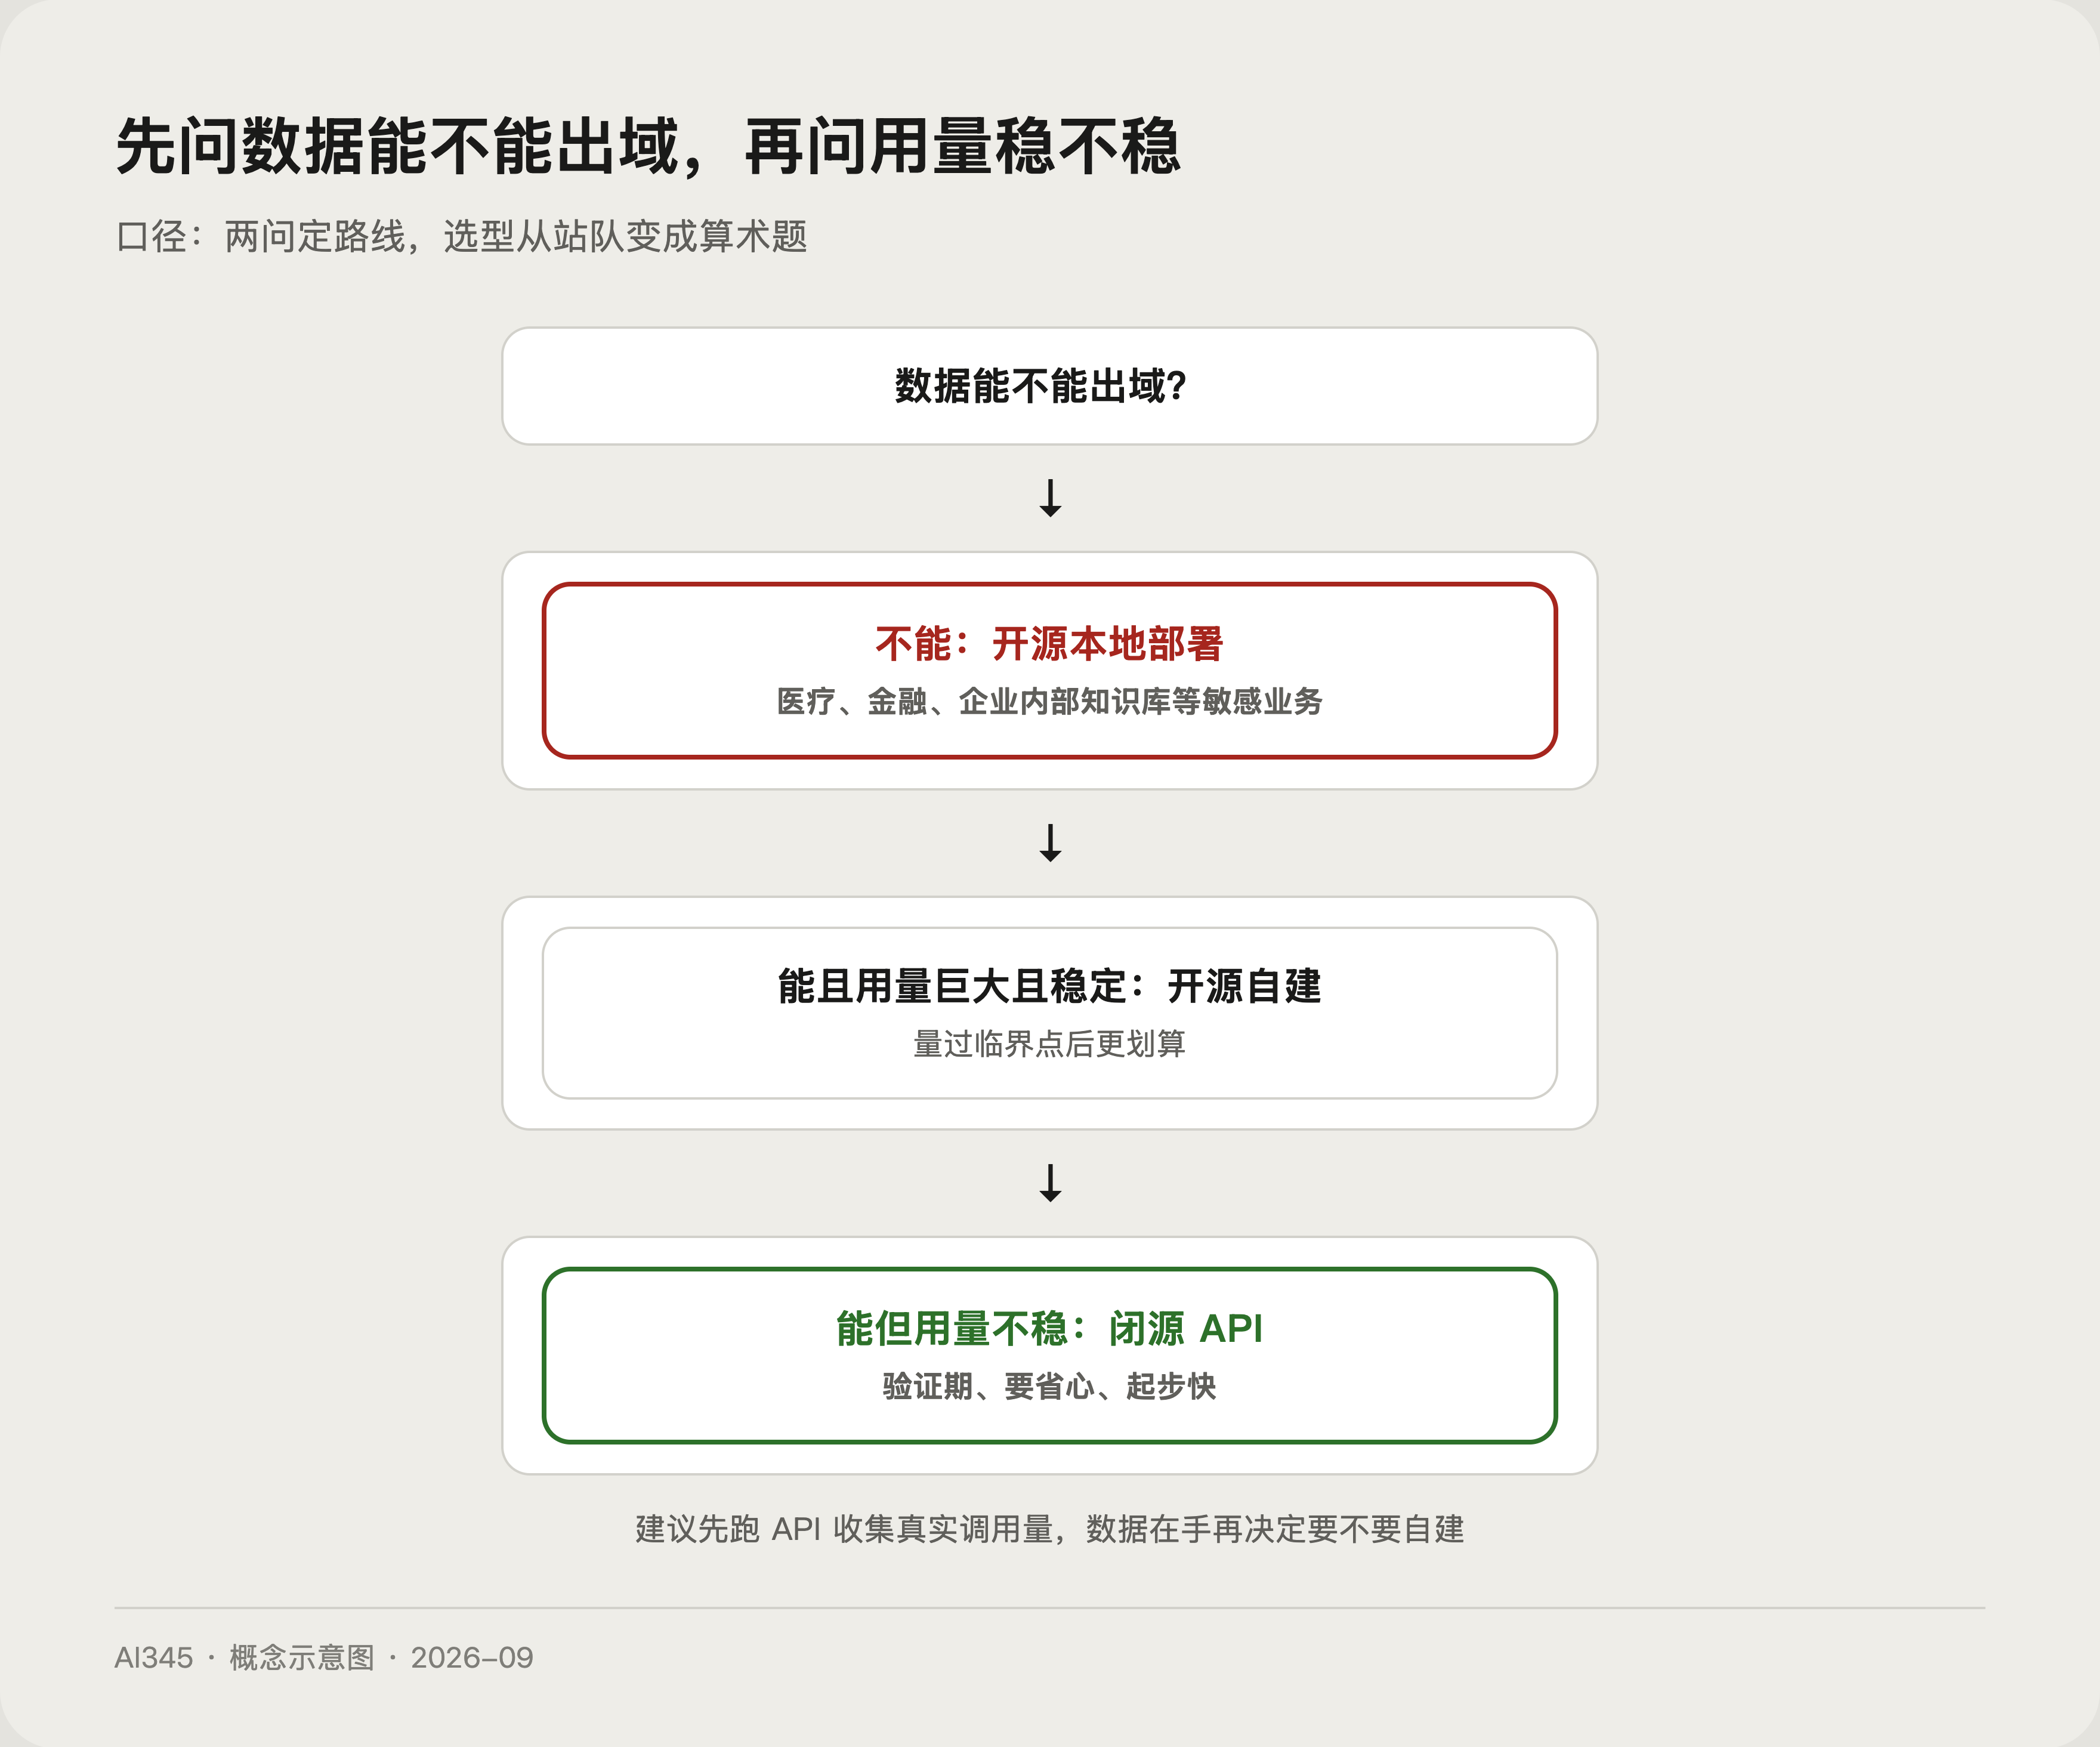
- 个人学习和写 demo:闭源 API 起步,几行代码就能用,不用先买显卡。
- 创业产品验证期:闭源 API 快速试错,跑通商业模式再算自建账。
- 用量巨大且稳定的成熟业务:把月调用量乘单价,和自建硬件运维成本放一起算,量过临界点后开源更划算(临界点因模型报价和硬件而异,需按实际报价估算)。
- 数据敏感业务(医疗、金融、企业内部知识库):开源本地部署,数据不出门。
- 深度定制需求:开源可以微调模型行为,闭源只能靠提示词和外围工程。定制不只是微调,还包括把模型和自有系统深度整合,这类需求闭源 API 很难满足。
想感受开源模型目前的规模上限,可以看两个代表:5050 亿参数的openPangu 2.0 开源解读,以及 Meta 开源 30B 档的Muse Glimmer 本地模型。
自建和 API 的账怎么算
把两边各列一个公式,账就清楚了:
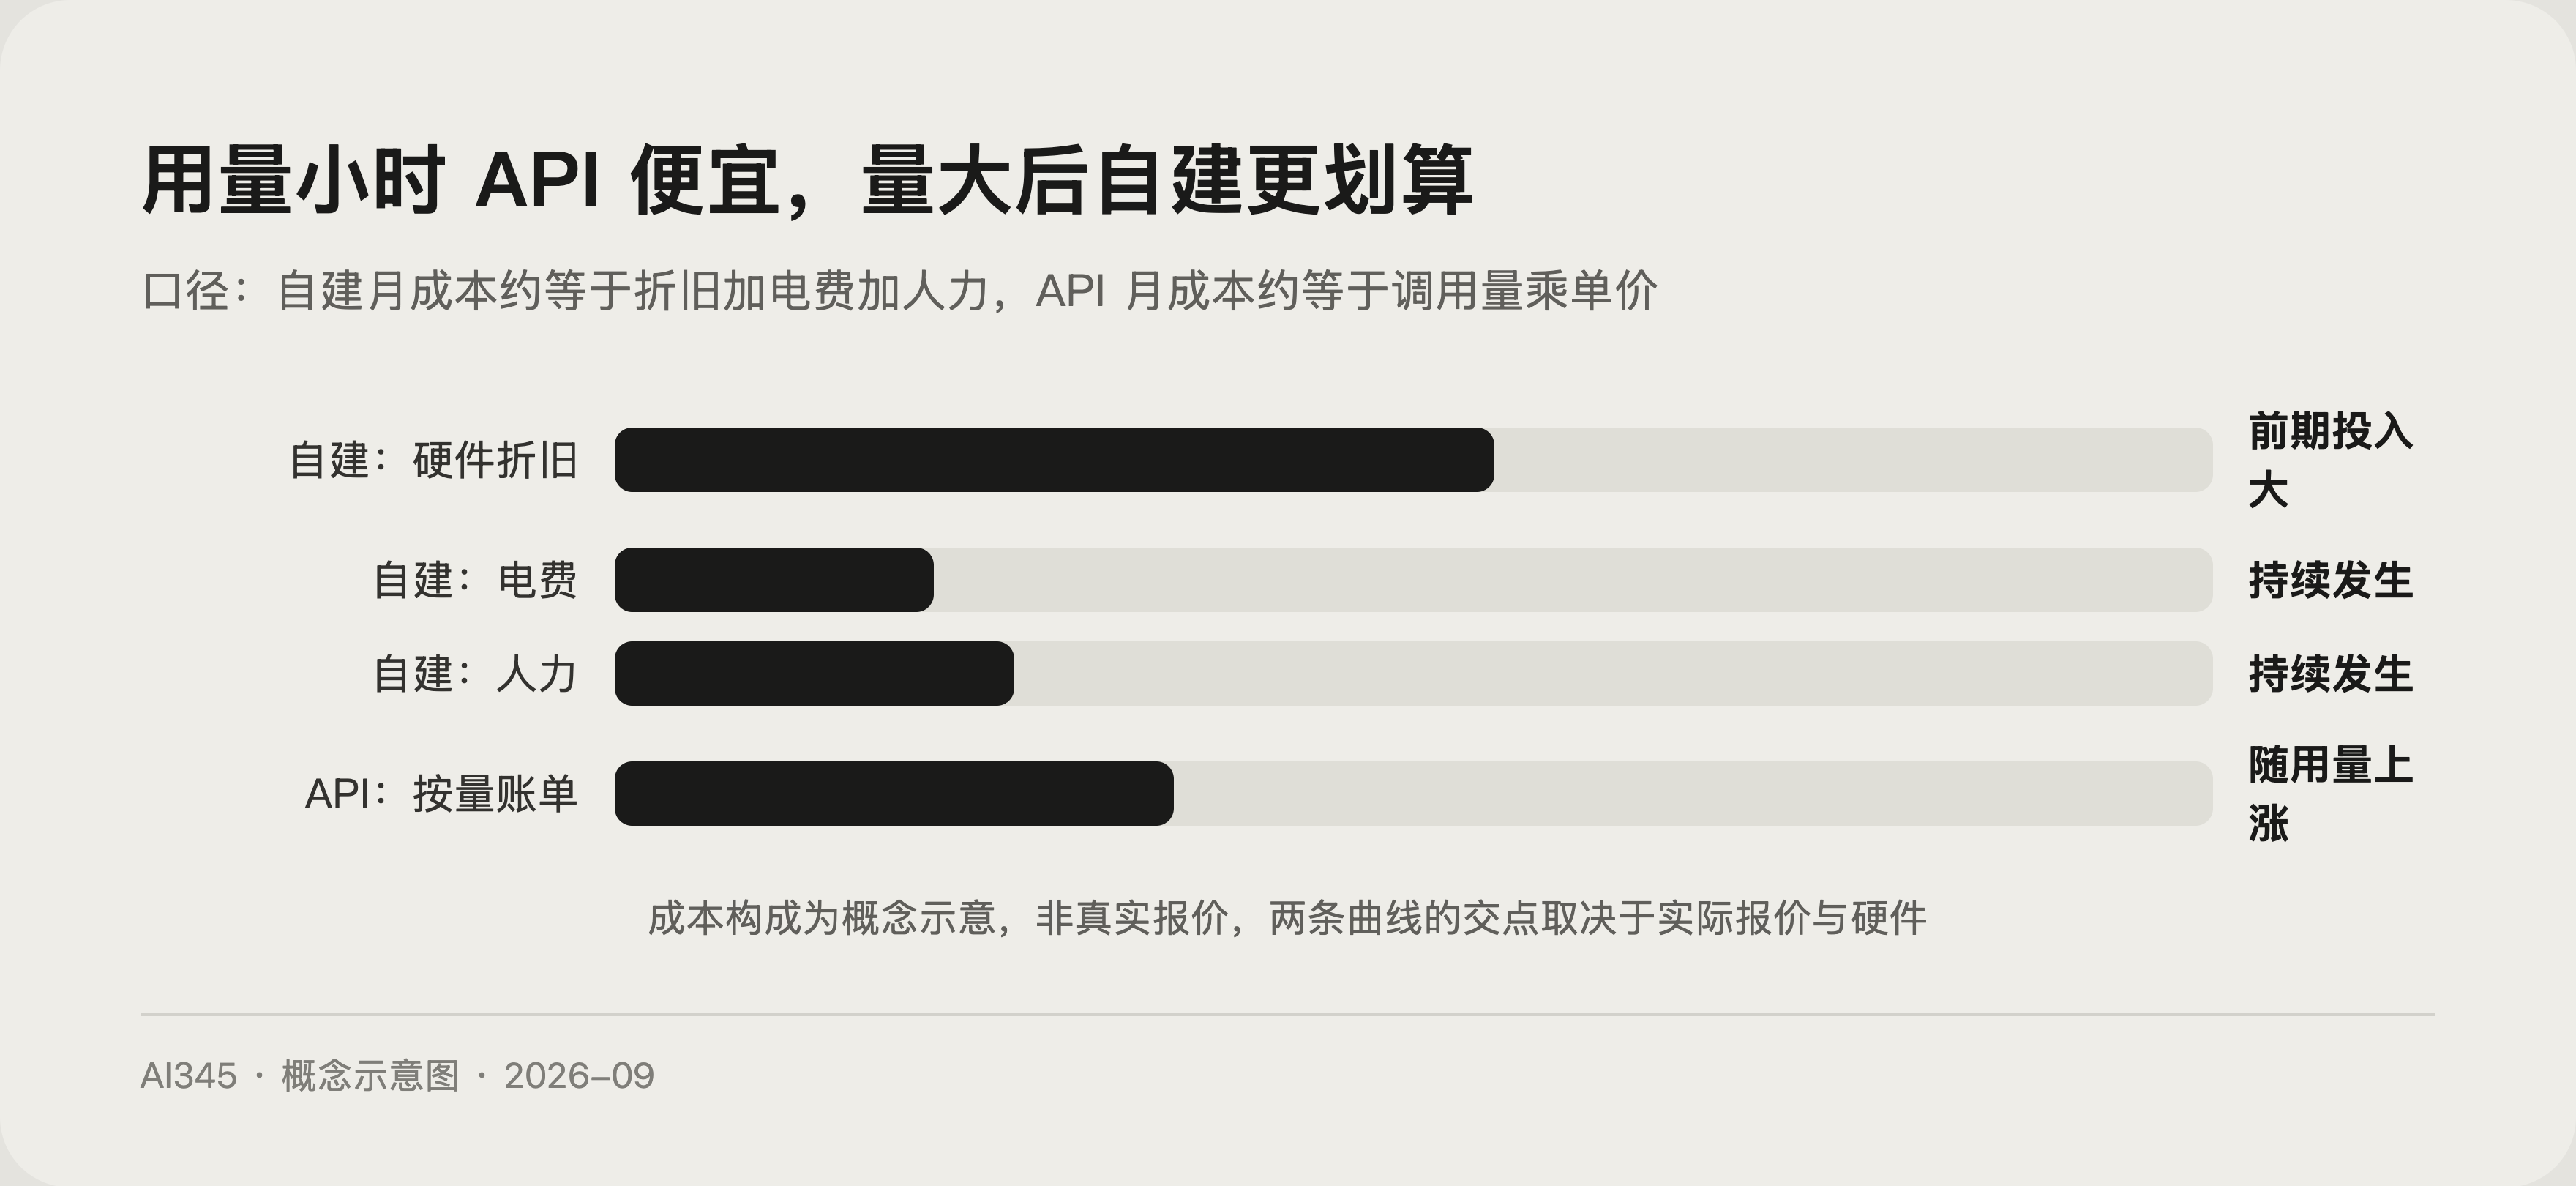
- 自建月成本约等于显卡折旧加电费加人力,前期投入大,边际成本低。
- API 月成本约等于月调用量乘以单价加集成成本,起步为零,线性上涨。
两条成本曲线一定有一个交点:用量小时 API 便宜,用量越大自建越划算。交点在哪取决于模型报价、硬件价格和你的运维能力,需要按实际报价估算,别照搬别人的临界值。这也是为什么建议先跑 API 收集真实调用量,再决定要不要自建,数据在手,账才算得准。
一段话讲清开源闭源怎么选
可以背这个口径:
选型核心是算总账。闭源 API 像租精装房,起步快、零运维,但按量付费、数据出域、规则在厂商手里;开源模型像自建房,权重免费但许可条款要逐条读,比如有的社区许可对超大月活产品有额外申请要求,硬件和运维才是大头。数据敏感、用量大、要定制选开源;验证期、用量不稳、要省心选闭源。
常见问题
开源模型真的完全免费吗?
答:权重免费,但硬件、电费、运维人力是真实成本,大参数模型还可能需要多卡支撑。
Llama 商用要付钱吗?
答:社区许可允许商用,月活超过 7 亿才需要向 Meta 单独申请,一般公司不受影响。
MIT 和 Apache 2.0 有什么区别?
答:两者都宽松且可商用,Apache 2.0 额外包含明确的专利授权条款,企业采用更安心。
闭源 API 的数据会被拿去训练吗?
答:看服务商条款。企业版通常承诺不用于训练,普通版未必,采购前要逐条确认。
小团队应该从开源还是闭源起步?
答:多数从闭源 API 起步,验证需求成立后再评估开源自建的经济性。
开源模型效果追得上闭源吗?
答:旗舰开源模型在通用任务上已接近闭源,垂直场景要用自己的数据实测后判断。
 京ICP备2024094994号-29