
RSIAgent 是什么?让开源模型不训练也能超越 GPT-6 Astra
RSIAgent 是 Aether AI 团队 2026 年 9 月 15 日发布并开源的 Agent 自进化框架:它不更新模型参数,而是让 Agent 自己进入陌生软件环境里探索、试错、验证,把学到的经验存进一个可复用的记忆库(Memory),从而让 Kimi-K3、GLM-5.3 这类开源模型在两项高难度基准上超过了 GPT-6 Astra。论文、代码、项目主页都已公开(链接见文末),采用 Apache 2.0 协议。
这篇文章会讲清楚三件事:RSIAgent 到底是怎么工作的、它的实测成绩含金量如何、以及如果你想自己跑一遍该怎么上手。
一句话理解 RSIAgent:不 Scale 模型,改 Scale 经验
过去几年大模型变强主要靠一件事:把模型越训越大。但模型部署之后呢?一个 Agent 进入一个从没见过的软件、工具或企业系统,新的交互逻辑、隐藏约束、失败模式全都要重新适应。过去的做法是收一批新数据、重新微调(想了解微调可以看我们的什么是微调(Fine-tuning)入门),成本高,而且很多企业内部数据根本不能拿去训练。
RSIAgent 换了一条路:模型参数一个都不动,让 Agent 自己去环境里"刷经验"。论文里管这叫 Scaling Experience,不扩大模型,而是扩大经验。它想回答的问题是:AI 能不能像人一样,进了新环境自己摸索出"什么操作会带来什么结果",并且把学到的因果规律存下来反复用?
如果对 Agent 这个概念还不熟悉,建议先看我们的AI Agent 入门指南,再回来看这篇会顺畅很多。
RSIAgent 怎么工作:三个 Agent + 一个会长大的记忆库
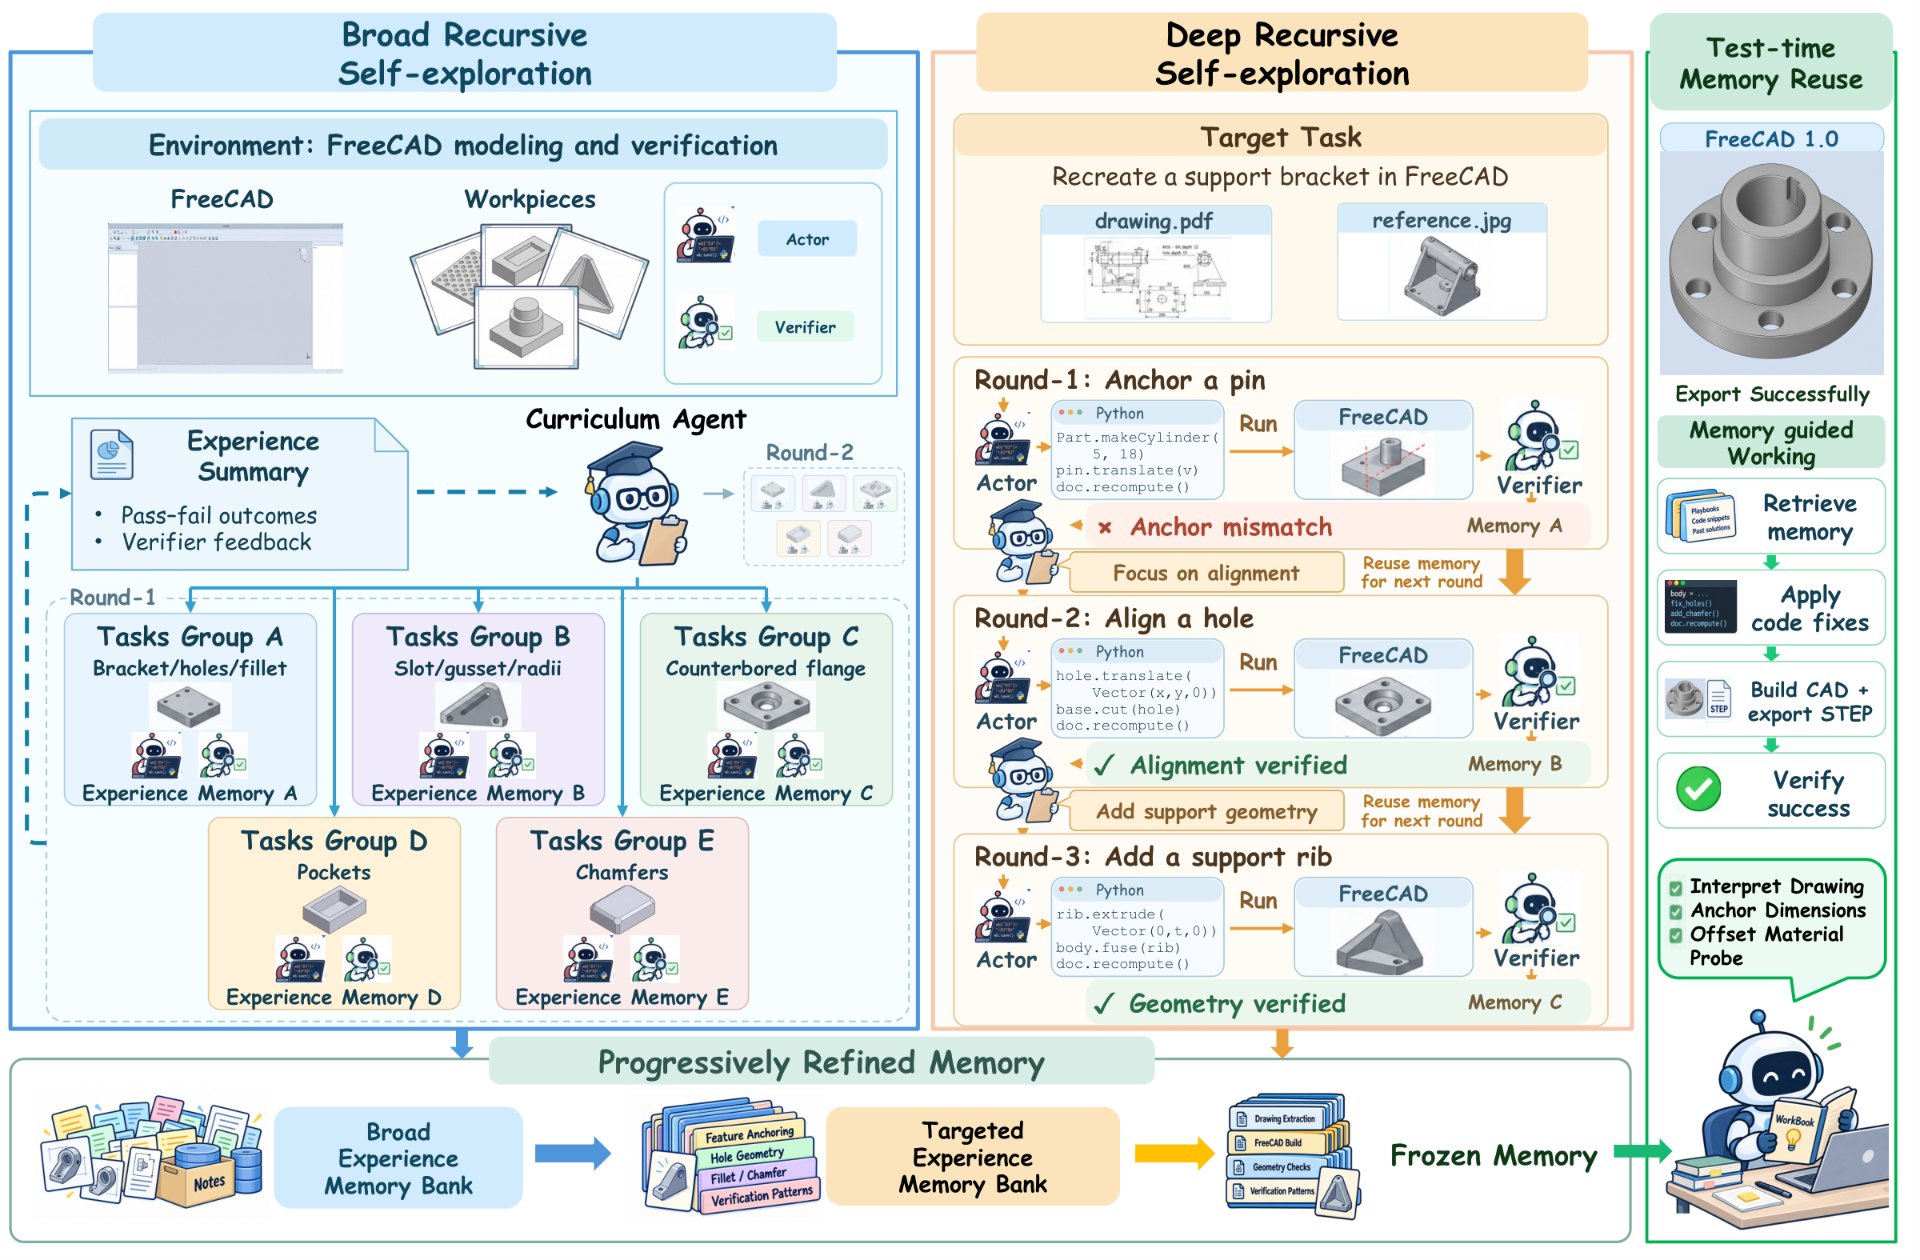
RSIAgent 的核心是一套多智能体递归闭环,三个角色分工明确:
- Curriculum Agent(课程 Agent):决定"接下来探索什么"。它根据已有经验挑选最有信息量的探索任务。
- Actor Agent(执行 Agent):真正进入软件干活,通过执行 Python/Bash 代码和观察界面来操作环境。
- Verifier Agent(验证 Agent):独立检查任务要求和实际环境状态,判断 Actor 的结果是否可靠。它看不到 Actor 的私有推理过程,防止"自己批改自己的作业"。
每次探索验证完,有效的经验(动作、条件、结果之间的因果关系,包括失败教训)会被沉淀进 Memory。整个探索结束后,Memory 被冻结,直接用于后续真实任务的执行。
两个探索阶段:先铺广度,再攻难点
RSIAgent 的探索分两步走,思路类似大模型训练里的预训练和后训练:
| 阶段 | 类比 | 做什么 | 探索方式 |
|---|---|---|---|
| 第一阶段:Broad Recursive Self-exploration | 预训练 | 快速建立对环境的广泛认知,覆盖常见规则、操作流程和失败模式 | 每轮同时生成多个方向的探索任务,多组 Actor/Verifier 并行执行验证 |
| 第二阶段:Deep Recursive Self-exploration | 后训练 | 攻克关键难点:难、隐蔽、容易出错、只在复杂情况才暴露的问题 | 顺序递归,每一轮根据上一轮暴露的失败设计更难的任务 |
消融实验显示,拿掉任何一方都会明显影响探索的广度或深度,只广不深会漏掉边界情况,只深不广则缺乏整体认知。
RSIAgent 实测成绩:开源模型真的赢了吗?
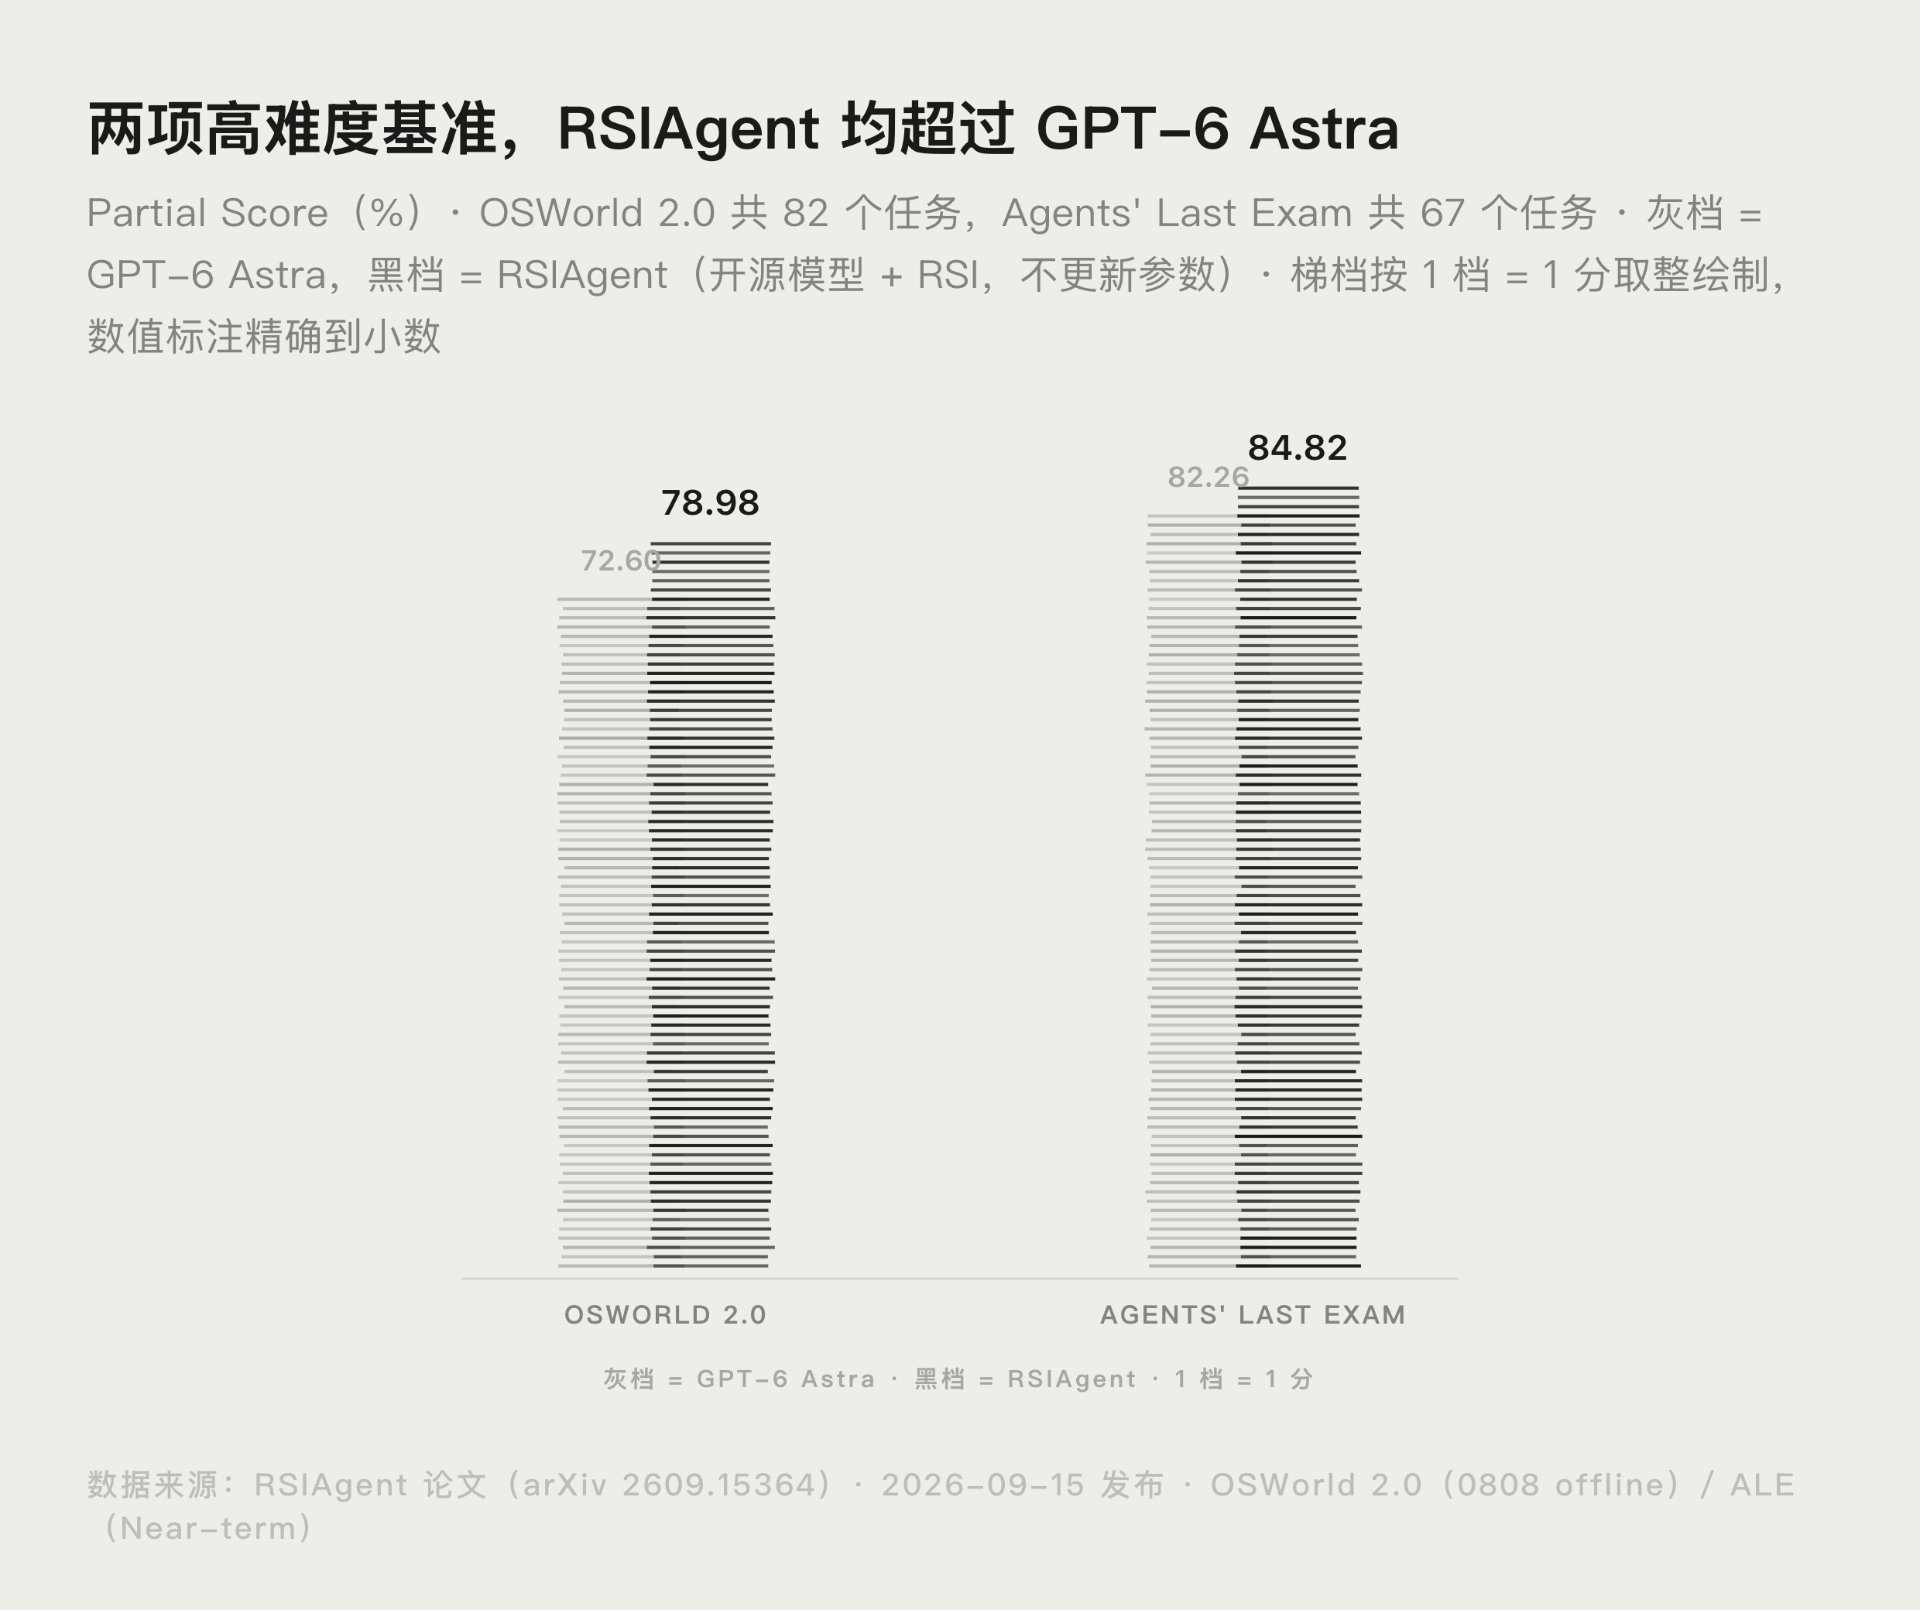
直接看数字。在不更新任何模型参数的情况下,RSIAgent 基于 GLM-5.3 和 Kimi-K3 这两个开源模型(GLM-5.3 的详细表现可以看我们的GLM-5.3 深度评测),在两项公认的高难度 Agent 基准上超过了闭源前沿模型:
| 基准 | 任务数 | 不做 RSI 基线 | RSIAgent | GPT-6 Astra |
|---|---|---|---|---|
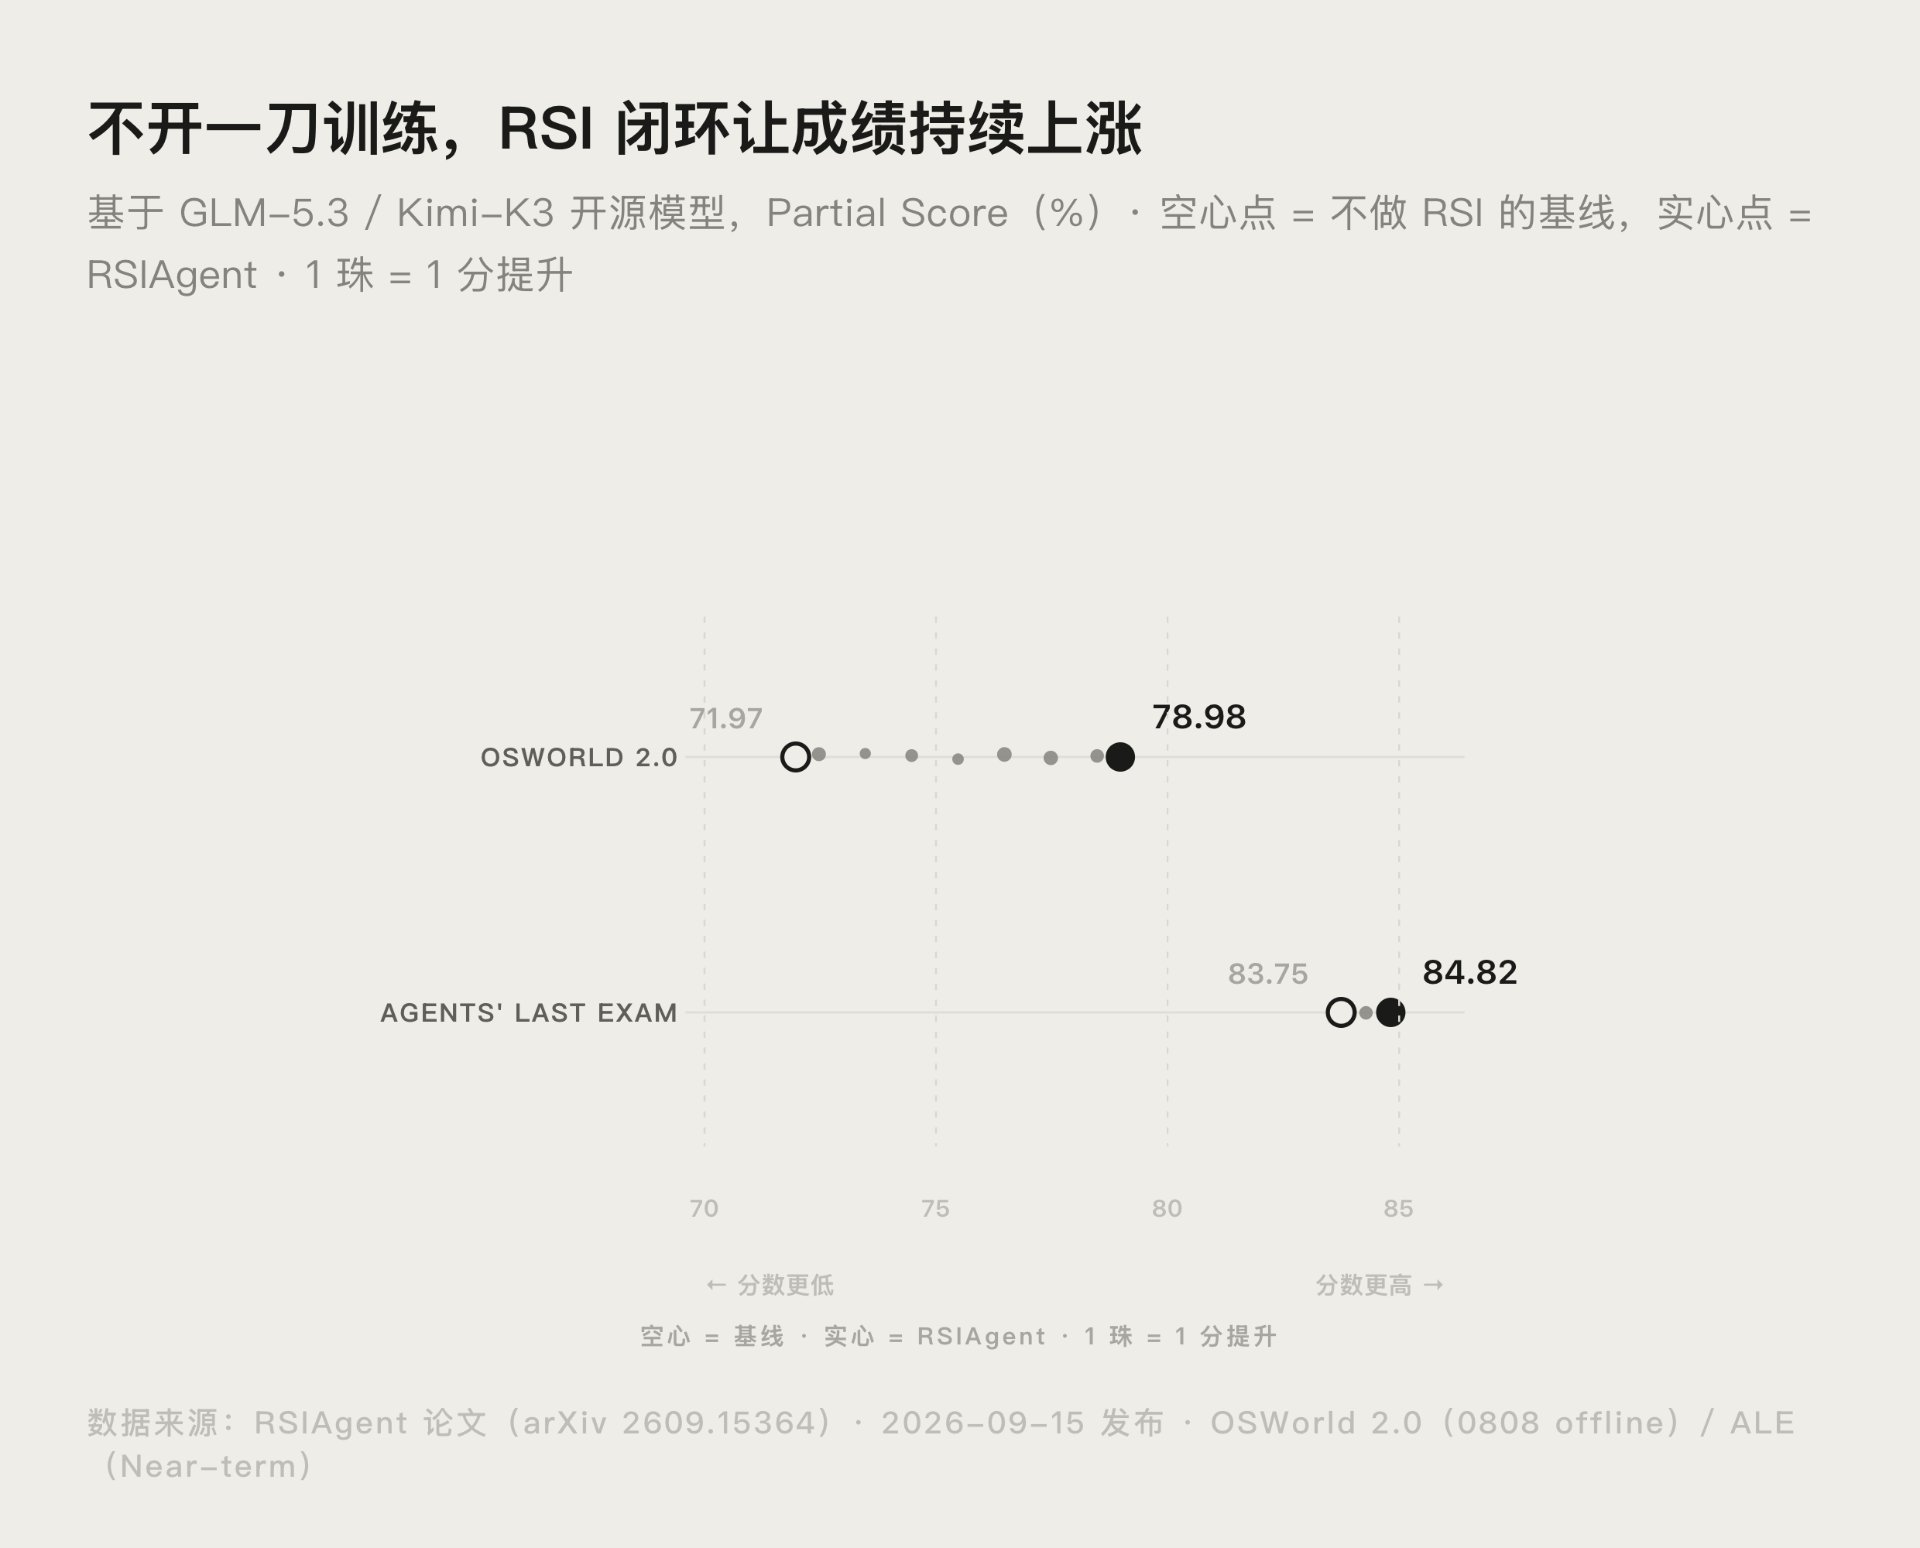
| OSWorld 2.0(0808 offline) | 82 | 71.97% | 78.98% | 72.60% |
| Agents' Last Exam(Near-term) | 67 | 83.75% | 84.82% | 82.26% |
几个值得注意的点:
- 提升主要来自 RSI 闭环本身。OSWorld 2.0 上基线是 71.97%,开一轮轮探索后涨到 78.98%,涨了 7 个百分点,而模型从头到尾没变过。
- 官方口径很透明。README 里明确说明 RSI 列的聚合方式(OSWorld 用了 41 条 RSI 记录、ALE 用了 19 条),还特意注明这不是严格匹配的重复实验平均值。这种把口径摊开说的做法在刷榜文里不多见。
- 任务越难,进化越明显。论文报告一些初始成功率只有 0-40% 的任务,随着 RSI 轮次增加最终达到 100%,简单任务几轮就收敛,复杂任务需要更多轮探索。
另外,团队把同样的机制用到了 GameCraft-Bench 自主游戏开发任务上,在玩法机制、深度、视觉等维度都有提升,说明这套"探索-验证-记经验"的循环不挑环境类型。
RSIAgent 和 GPT-6 Astra 差在哪:一个靠参数,一个靠经验
这个对比值得多说一句。GPT-6 Astra 代表的是 Scaling Model 路线的顶端(GPT-6 发布时的情况可以看我们的GPT-6 发布解读):能力烧在训练阶段的参数里,部署后基本定型。RSIAgent 代表的是另一条路:底层模型可以是开源中档货,但进入具体环境后通过自主探索持续长本事。
对企业的实际意义在于:如果你的业务环境是私有的、数据不能拿去训练,RSIAgent 这类"训练无关"(training-free)的方案提供了一种让 Agent 适配你环境的新选择,不用动模型,让它在你的系统里自己摸爬滚打一遍,把经验存下来就行。
当然,两者不是替代关系。RSIAgent 提升的是"特定环境里的任务能力",不改变模型本身的通用智能水平。
RSIAgent 本地运行教程:想自己跑一遍看这里
代码在 GitHub 的 AetherLabsAI/RSIAgent 仓库(截至发稿 92 star,Apache 2.0 协议),目前主要面向复现论文基准的场景,门槛不低,先说清楚要求:
环境要求:Python 3.12、uv 包管理器、Linux 主机、Docker、可访问 /dev/kvm 的虚拟化支持。
基础安装步骤:
git clone https://github.com/AetherLabsAI/RSIAgent.git
cd RSIAgent
cp .env.example .env
# 编辑 .env,填入你的 OPENROUTER_API_KEY
跑 OSWorld 2.0 基准(需要先装指定版本的 OSWorld-V2):
git clone --branch v2026.08.08 https://github.com/xlang-ai/OSWorld-V2.git ../OSWorld-V2
cd ../OSWorld-V2 && uv sync --frozen
uv pip install --python .venv/bin/python -r ../RSIAgent/requirements.txt
source .venv/bin/activate && cd ../RSIAgent
python run_osworld.py --arm both --name osworld_run_01 --dry-run   # 先看计划
python run_osworld.py --arm both --name osworld_run_01 --concurrency 1
--arm 参数三选一:baseline(只跑任务不学习)、rsi(先探索学习再评估)、both(两者都跑)。建议先用 --dry-run 看任务计划,再从 --concurrency 1 开始。
注意事项(README 原文强调的):
- ALE 基准的虚拟机镜像很大:Linux 镜像约 167 GiB,Windows 约 157 GiB,还要预留下载和工作空间,硬盘不够别硬跑。
- 每次运行要用新的
--name/--output目录,已有输出不会被覆盖。 - 官方说明:smoke 测试通过只代表运行机制正常,想复现论文分数需要按锁定的配置跑完整实验。
冷静看待:RSIAgent 自己承认的三个局限
官方 README 有一段少见的坦诚话,指出了这套机制的天花板:
- 练习可能没练到点子上,探索跑了很多轮,但没碰到真正的薄弱环节;
- 验证可能放水,Verifier 可能接受了不完整的工作成果;
- 记忆可能记错,Memory 可能固化一条错误的规则,后面一直照着错。
换句话说,这套机制的上限取决于探索、验证和记忆整理的质量,不是无限堆轮次就能一直涨分。这也是所有"自我进化"系统的共同挑战。
另外要区分:搜 RSIAgent 时你还会看到一个叫 gitsofaryan/rsi-agent 的学习型项目,以及大量讨论 RSI(Recursive Self-Improvement,递归自我改进)这个概念的文章(比如翁荔 2026 年 7 月的 Harness Engineering 长文)。它们和本文介绍的 Aether AI 的 RSIAgent 不是一回事,别混淆。
总结
RSIAgent 的价值不在于"赢了一次跑分",而在于它验证了一条可复用的路径:模型不动,靠"课程生成 → 执行 → 验证 → 记忆演化"的递归闭环,让开源 Agent 在陌生环境里自己长本事。对用不起闭源旗舰模型、又想让 Agent 适配私有环境的团队来说,这是一个值得 star 下来跟进的开源项目。项目刚发布,代码和文档还在快速迭代,建议持续关注官方仓库更新。
外部参考来源:
- 论文:RSIAgent: Autonomous Exploration for Recursive Self-improvement in New Environments(arXiv 2609.15364),作者 Sibo Zhu、Shicheng Fan、Xinyue Wang、Wenyi Wu、Kun Zhou、Biwei Huang
- 代码:GitHub - AetherLabsAI/RSIAgent
- 项目主页:aetherlabsai.github.io/RSIAgent
- 中文首发报道:机器之心:在多项高难度 Benchmark 超越 GPT-6 Astra,RSIAgent 让开源模型自主探索新环境
相关阅读(站内):
常见问题
RSIAgent 是免费的吗?
答:是。RSIAgent 采用 Apache 2.0 协议在 GitHub 开源,个人和商用都可以免费使用。不过运行时需要自己提供底层模型的 API 凭证(通过 OpenRouter 等渠道),这部分调用费用自理。
RSIAgent 需要训练或微调模型吗?
答:不需要。RSIAgent 是 training-free 框架,全程不更新模型参数,靠"探索-验证-记忆"闭环积累经验。这也是它适合企业私有环境的主要原因:不用把业务数据拿去训练。
RSIAgent 用的是哪些模型?效果如何?
答:论文实验用的是 GLM-5.3 和 Kimi-K3 两个开源模型。配上 RSI 闭环后,两者在 OSWorld 2.0(78.98%)和 Agents' Last Exam(84.82%)上都超过了 GPT-6 Astra(72.60% / 82.26%)。
RSIAgent 和翁荔说的 RSI(递归自我改进)是什么关系?
答:RSI 是一个研究方向的概念,指系统用现有能力改进"产生能力的机制"。RSIAgent 是 Aether AI 把这个概念在数字环境里的一次具体工程实现,此外 GitHub 上还有其他同名的学习型项目,搜索时注意区分作者和来源。
普通人能用 RSIAgent 做什么?
答:目前它主要面向研究者和工程师复现基准、做二次开发,没有一个"开箱即用"的面向普通用户的产品。普通用户可以关注它后续是否推出更易用的形态;想理解 Agent 自进化这个方向,这篇文章的原理部分就够用了。
RSIAgent 的成绩可以复现吗?
答:官方提供了锁定的基准版本、运行脚本和验证工具,环境要求 Linux + Docker + KVM,硬盘需求较大(ALE 镜像超过 150 GiB)。官方说明 smoke 测试通过只验证运行机制,复现论文分数需要按锁定配置跑完整实验。
 京ICP备2024094994号-29