
GPT-5.6 / GPT-6 Astra 降智?别再用知识截止日期验模型:2026 最新排查指南
最后更新于 2026 年 9 月 20 日 · 作者:AI345
先给结论:感觉 Astra 回答质量下降是真实可能的,但目前没有可靠证据证明 ChatGPT 会因为多设备登录或高并发,把 GPT-6 Astra 偷偷换成 GPT-4o。 更关键的是,此前流传很广的两个"Astra 验真方法",包括询问知识截止日期、让模型画"鹈鹕骑自行车 SVG",都不足以证明后台实际调用了哪个模型。怀疑自己遇到"降智",真正该排查的是产品入口、套餐权限、推理档位、额度、上下文污染、工具与安全限制,以及模型本身的随机波动。
本文已按 OpenAI 官方资料全面修订:GPT-6 Astra 模型文档、GPT-5.6 与 GPT-6 Pro 套餐说明、GPT-4o 退役公告,核实截至 2026 年 9 月 20 日。9 月初版本中"实锤被换成 GPT-4o"的说法已被官方资料推翻,特此更正。官方策略随时可能调整,发现失效欢迎反馈。
GPT-5.6 和 GPT-6 Astra 是什么关系?
先把两代模型分清楚,它们不是同一个模型:
| 模型 | 定位 | 官方知识截止日期 | API 价格(每百万 token,输入/输出) |
|---|---|---|---|
| GPT-5.6 Sol | GPT-5.6 系列旗舰 | 2026 年 2 月 16 日 | $4 / $20 |
| GPT-6 Astra | 新一代旗舰 | 2026 年 4 月 30 日 | $10 / $50 |
GPT-6 Astra 于 2026 年 9 月 3 日发布,主攻复杂推理、编程、Computer Use、研究和专业工作,官方 API 版本拥有 105 万 token 上下文窗口,最大输出 128K token。GPT-5.6 Sol 目前 $4/$20 是官方促销价,至少持续到 2026 年 11 月 21 日。网上常说的"GPT 5.6 Astra"其实是把两代模型的名字混在了一起。想看 Pro 档的区别,可以读《GPT-6 Astra Pro 和 Astra 有什么区别》。
最重要的更新:知识截止日期不能用来"验明正身"
此前社区流传一种检测办法:新会话里问模型"你的知识截止日期是什么时候",回答 2024 年 6 月就是被换成 GPT-4o,回答 2025 年以后就是正版 Astra。
这个判断方法并不可靠。
第一,OpenAI 已经在官方模型文档里公开了 GPT-6 Astra API 的知识截止日期:2026 年 4 月 30 日。这个日期是公开信息,任何模型都可能"背出"它。
第二,大语言模型回答"我是什么模型""我的知识截止到什么时候",本质上仍然是在生成文本。除非产品系统明确把模型身份写进上下文,否则它完全可能答错。OpenAI 开发者社区近期讨论 Astra"降智"时,也有人专门指出:模型自报的知识截止日期,以及一次 SVG 任务失败,都不能作为模型身份的证据。
所以,知识截止日期可以当作异常线索,但不能当作验真工具。
"被偷偷换成 GPT-4o"的说法也要修正
9 月初社区流传一种说法:账号出现多人共享、多设备同时使用或高并发后,OpenAI 会检测并发,把 Astra 请求静默路由到 GPT-4o。
截至 2026 年 9 月 20 日,没有任何 OpenAI 官方资料确认这套机制存在。而且有一个重要事实与这个说法直接冲突:
GPT-4o 已于 2026 年 2 月 13 日正式退出 ChatGPT。 Business、Enterprise 和 Edu 在自定义 GPT 中保留的 GPT-4o 访问也已于 2026 年 4 月 3 日结束。GPT-4o 目前仍可通过 API 调用,但已经不是 ChatGPT 里正常提供的文本聊天模型。
因此,社区用户观察到的"回答突然像 4o",最多只能说明回答质量或风格发生了变化,不能进一步推出后台实际调用的就是 GPT-4o。
为什么 Astra 会突然感觉"变笨"?
目前更值得排查的是下面 5 类原因。
1. 你实际使用的产品入口不同
这是现在最容易混淆的一点。OpenAI 帮助中心最新说明:
- GPT-6 Pro(由 GPT-6 Astra 驱动)在标准 Chat 中面向 Pro $100、Pro $200、Business 和 Enterprise 套餐开放
- Plus 套餐只在 ChatGPT Work 和 Codex 中包含 GPT-6 Astra,标准 Chat 里运行的是 GPT-5.6 家族模型
也就是说,"Plus 有 Astra"并不等于你打开任意普通聊天窗口,背后运行的一定是 Astra。判断模型前,先确认自己处于 Chat、Work、Codex 还是 API。
2. 推理档位不同
同一个模型,用不同 reasoning effort,表现可能差很多。GPT-6 Astra API 官方支持 low、medium、high、xhigh、max 五个档位,复杂编程、数学和 Agent 任务在低推理预算下尤其容易给出一个"看起来正确"但未经充分验证的答案。
还有一个 9 月的新变化值得注意:9 月 14 日起,OpenAI 面向全球 Plus 和 Pro 用户取消了 Instant 到 Thinking 的自动切换,网页版的"Higher intelligence"设置也一并移除。以前复杂问题会自动升级思考档位,现在需要在模型选择器里手动选择 Medium 或 High。最近很多"突然变笨"的感受,其实来自这个官方调整,而不是模型被替换。
3. 使用额度或套餐限制
不同套餐的 Astra 额度并不相同,例如 Pro $200 在标准 Chat 中每周 200 条 GPT-6 Pro,Pro $100 为每周 50 条。OpenAI 也明确说明,Astra 执行复杂任务时可能比 GPT-5.6 Sol 更快消耗 Work 和 Codex 额度,具体取决于任务长度、输入输出规模、推理设置和 Fast 模式。额度用完后系统会切换到其他可用模型,体验自然下降。先检查界面上的模型、剩余额度和当前模式,不要仅凭答案风格下结论。
4. 长对话导致上下文污染
这是最常见但最容易被误认为"降智"的原因。连续几十轮修改代码后,上下文里通常已经塞满旧需求、失败方案、互相冲突的指令、废弃代码和模型此前的错误判断。即使底层模型没变,结果也会越来越差。
最快的验证方法是新建一个空白会话,只提供完成任务真正需要的信息重新执行。新会话明显恢复,问题就更可能出在上下文,而不是模型身份。
5. Agent、工具和安全系统的影响
Astra 不只是一个裸模型。在 ChatGPT Work、Codex 或 Computer Use 中,实际结果还取决于工具调用、权限、自动审查和安全系统。OpenAI 在发布说明中明确提到,Astra 部署了额外的安全监控,检测到可疑情况时对话可能被暂停或中断供人工确认;Astra 也是 OpenAI 第一个达到其 Preparedness Framework 中 Critical 网络安全能力门槛的公开模型,防护措施明显加强。合法任务在某些情况下同样可能被拦截,这类现象也会让人感觉"模型变笨了"。
现在应该怎么测试 Astra 有没有异常?
比"问知识截止日期"更靠谱的方法,是做可重复的 A/B 测试。
选择一个你非常熟悉、结果可以客观判断的任务,例如:修复一个有明确测试用例的代码 Bug、根据固定截图还原前端页面、处理一份固定 Excel 并核对最终数据、完成一个答案唯一的逻辑或数学问题。然后固定提示词和输入材料,在不同会话或模型中各测试数次。
重点观察:正确率、是否遵循要求、是否主动验证结果、工具调用是否成功、最终产物是否真正可用。
这种测试仍然不能告诉你服务器内部到底调用了哪个模型,但它能回答真正重要的问题:当前这个入口的实际能力,是否达到了你的工作要求。
感觉质量下降,按这个顺序排查
- 确认产品和模型:先看自己在 Chat、Work、Codex 还是 API,以及界面当前实际显示的模型
- 检查推理等级:复杂任务手动调到更高的 reasoning effort 再比较
- 开新会话:把必要上下文重新整理后测试,排除旧对话污染
- 检查额度和客户端版本:Astra 要求 ChatGPT Desktop 保持最新,Codex CLI 需要 0.153.0 或更新版本
- 用固定任务做 A/B 测试:不要通过语气、措辞或模型自报身份判断
如果这些条件完全相同,连续多次结果仍显著异常,再考虑向 OpenAI 提交可复现案例。额度相关的细节可以参考《GPT-6 Astra 每周额度指南》。
正版 Astra 到底什么水平:官方跑分
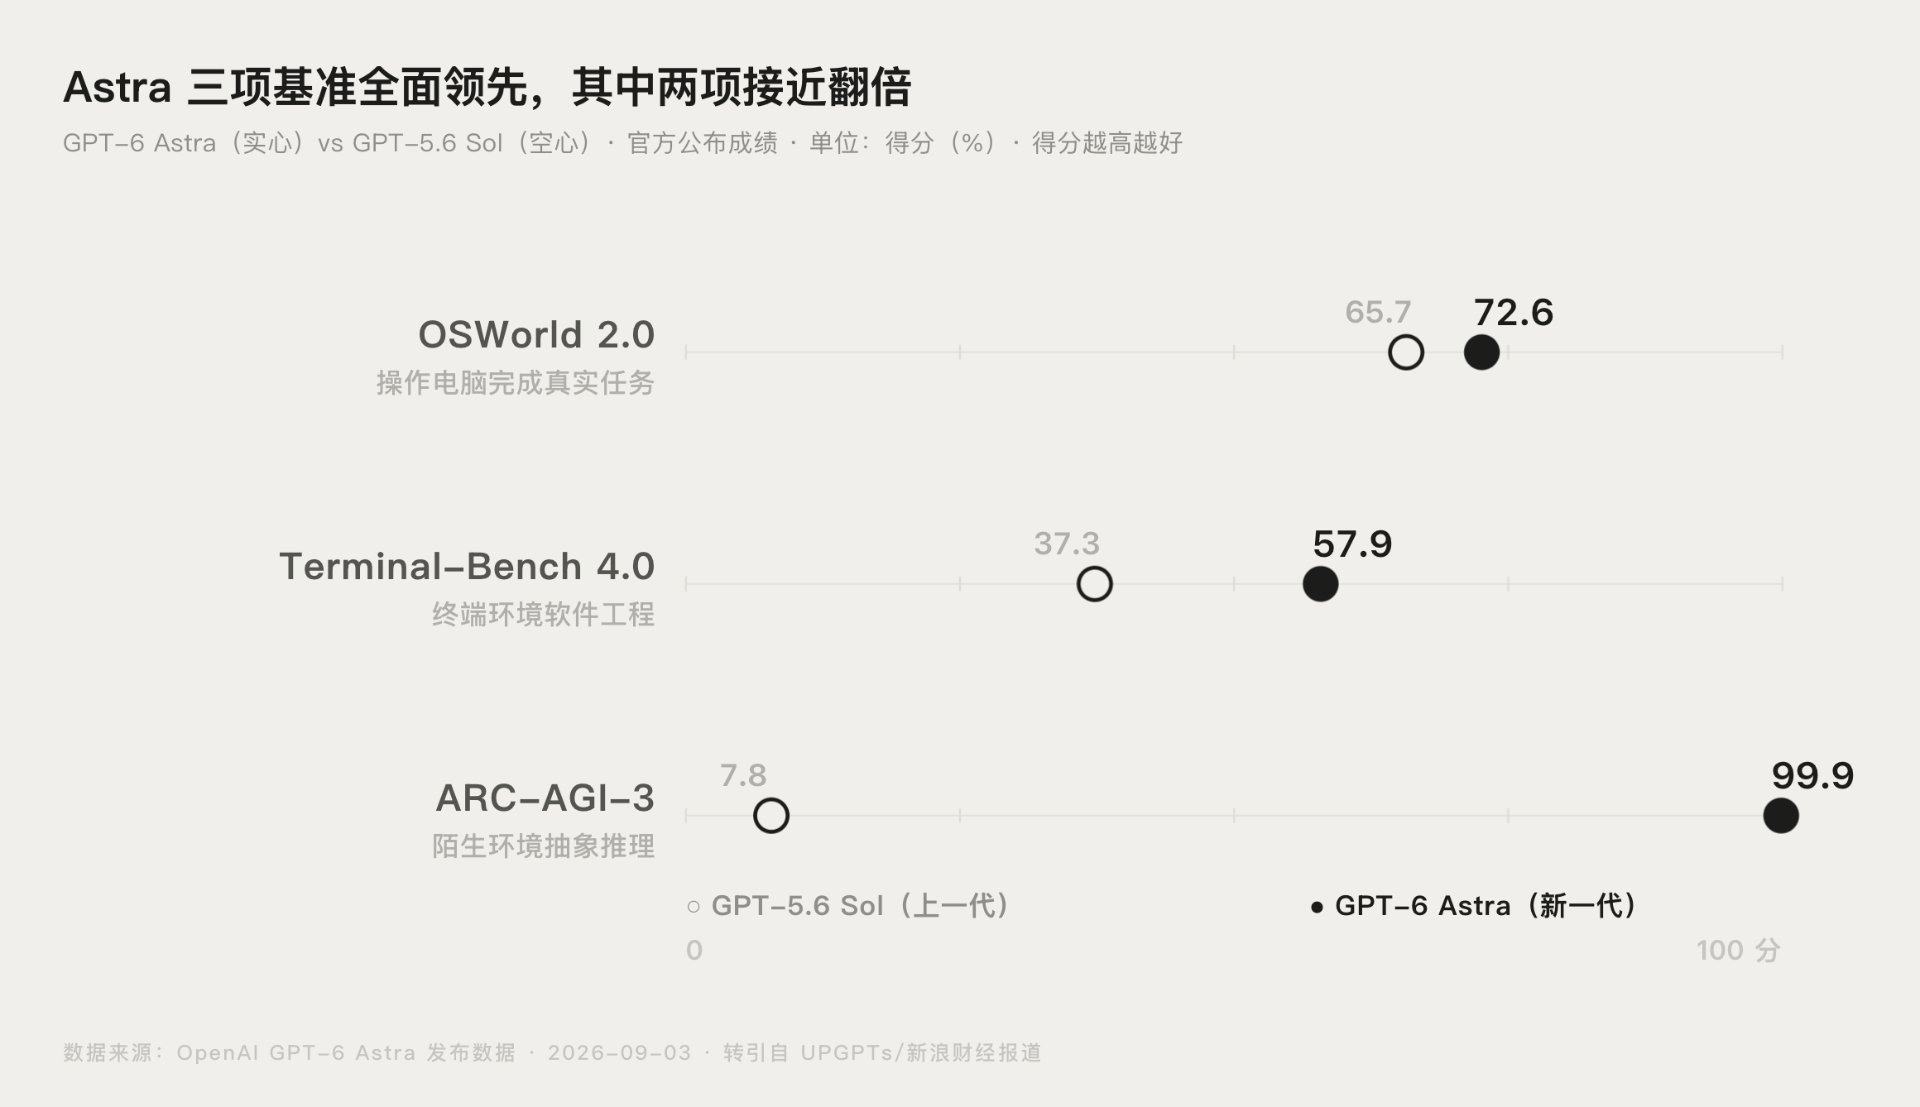
讨论"降智"之前,先看看官方公布的能力基准线:
| 基准测试 | GPT-6 Astra | GPT-5.6 Sol | 测什么 |
|---|---|---|---|
| OSWorld 2.0 | 72.6% | 65.7% | 操作电脑完成真实任务 |
| Terminal-Bench 4.0 | 57.9% | 37.3% | 终端环境里的软件工程 |
| ARC-AGI-3 | 99.9% | 7.8% | 陌生环境的抽象推理 |
OSWorld 2.0 中,Astra 完成任务所需时间还缩短约 47%。但基准成绩代表的是特定测试条件下的能力上限,并不意味着每一次普通对话都会表现出同样水平。这正是讨论"降智"时最容易忽略的一点:模型能力、产品配置和你这一轮实际获得的回答质量,是三个不同的问题。
总结
GPT-6 Astra 发布后,确实出现了不少关于"降智"的用户反馈。但截至 2026 年 9 月 20 日,更准确的结论是:用户体验下降值得调查,"并发触发后被偷偷换成 GPT-4o"则没有可靠证据支持。尤其不要再把模型自报的知识截止日期和某一道固定 SVG 测试题当成模型身份证。真正有效的排查方法是确认模型和产品入口、检查推理等级与额度、清空上下文,然后用可评分、可重复的真实任务做 A/B 测试。同类问题在 Claude 生态里也存在,排查思路可以参考《Claude Opus 5 降智排查指南》。
参考资料
- OpenAI 官方发布页:GPT-6 Astra: A new generation of intelligence:https://openai.com/index/gpt-6-astra/
- OpenAI API 模型文档:GPT-6 Astra:https://platform.openai.com/docs/models/gpt-6-astra
- OpenAI API 模型文档:GPT-5.6 Sol:https://platform.openai.com/docs/models/gpt-5.6-sol
- OpenAI 帮助中心:GPT-5.6 and GPT-6 Pro in ChatGPT:https://help.openai.com/en/articles/20001354-gpt-5-6-and-gpt-6-pro-in-chatgpt
- OpenAI 帮助中心:ChatGPT Work and Codex:https://help.openai.com/en/articles/20001275-chatgpt-work-and-codex
- OpenAI 帮助中心:Retiring GPT-4o and other ChatGPT models:https://help.openai.com/en/articles/20001051-retiring-gpt-4o-and-other-chatgpt-models
- OpenAI 安全概览:Safety overview: GPT-6 Astra:https://openai.com/index/safety-overview-gpt-6-astra/
常见问题
GPT 5.6 Astra 是一个模型吗?
答:不是。GPT-5.6 是一代模型,包括 Sol、Terra、Luna;GPT-6 Astra 是 2026 年 9 月 3 日发布的下一代旗舰。搜索时把两个名字连在一起,通常是想问"Astra 有没有降智"。
问知识截止日期还能判断是不是 Astra 吗?
答:不能可靠判断。Astra 官方 API 知识截止日期是 2026 年 4 月 30 日,但模型自己回答什么日期并不能证明服务器实际使用的模型,它本质上只是在生成文本。
回答"2024 年 6 月"就说明被换成 GPT-4o 吗?
答:不能这样判断。GPT-4o 已于 2026 年 2 月 13 日退出 ChatGPT,目前没有任何官方证据证明 Astra 会因为并发被静默切换成 GPT-4o。模型自报的日期不是身份凭证。
为什么同一个 Astra 有时候很强、有时候很弱?
答:可能涉及推理档位、上下文污染、Work/Codex/Chat 产品差异、工具执行情况、安全机制、使用额度以及模型生成本身的随机性。一次回答失败不足以证明模型被替换。
Plus 能用 Astra 吗?
答:能,但要区分产品。截至 2026 年 9 月 20 日,Plus 套餐包含 GPT-6 Astra 在 ChatGPT Work 和 Codex 中的使用额度;标准 Chat 中的 GPT-6 Pro 则面向 Pro、Business 和 Enterprise 套餐开放。
 京ICP备2024094994号-29