
ARC-AGI 是什么?一文讲透 GPT-6 Astra 的 99.9% 与 Omen Alpha 盲测
ARC-AGI 是一个专门测量 AI「学新技能效率」的基准:题目对人类很轻松、对 AI 极难,靠记忆和堆知识拿不了分。2026 年 9 月,OpenAI 的 GPT-6 Astra 在它的最新一代 ARC-AGI-3 上拿出了 99.9% 的成绩,同期 OpenCode 的匿名模型 Omen Alpha 也把社区目光拉回这个考场。本文用大白话讲透它的规则、三代演进、这个 99.9% 怎么读,以及它和 Omen Alpha 盲测的关系。
要点速览
- ARC-AGI 是 François Chollet 在 2019 年论文中提出的基准,测的是「技能习得效率」,不是知识量。
- 最新一代 ARC-AGI-3 是交互式游戏基准:AI 要自己探索规则、定目标、做规划,全部关卡人类都能 100% 解出。
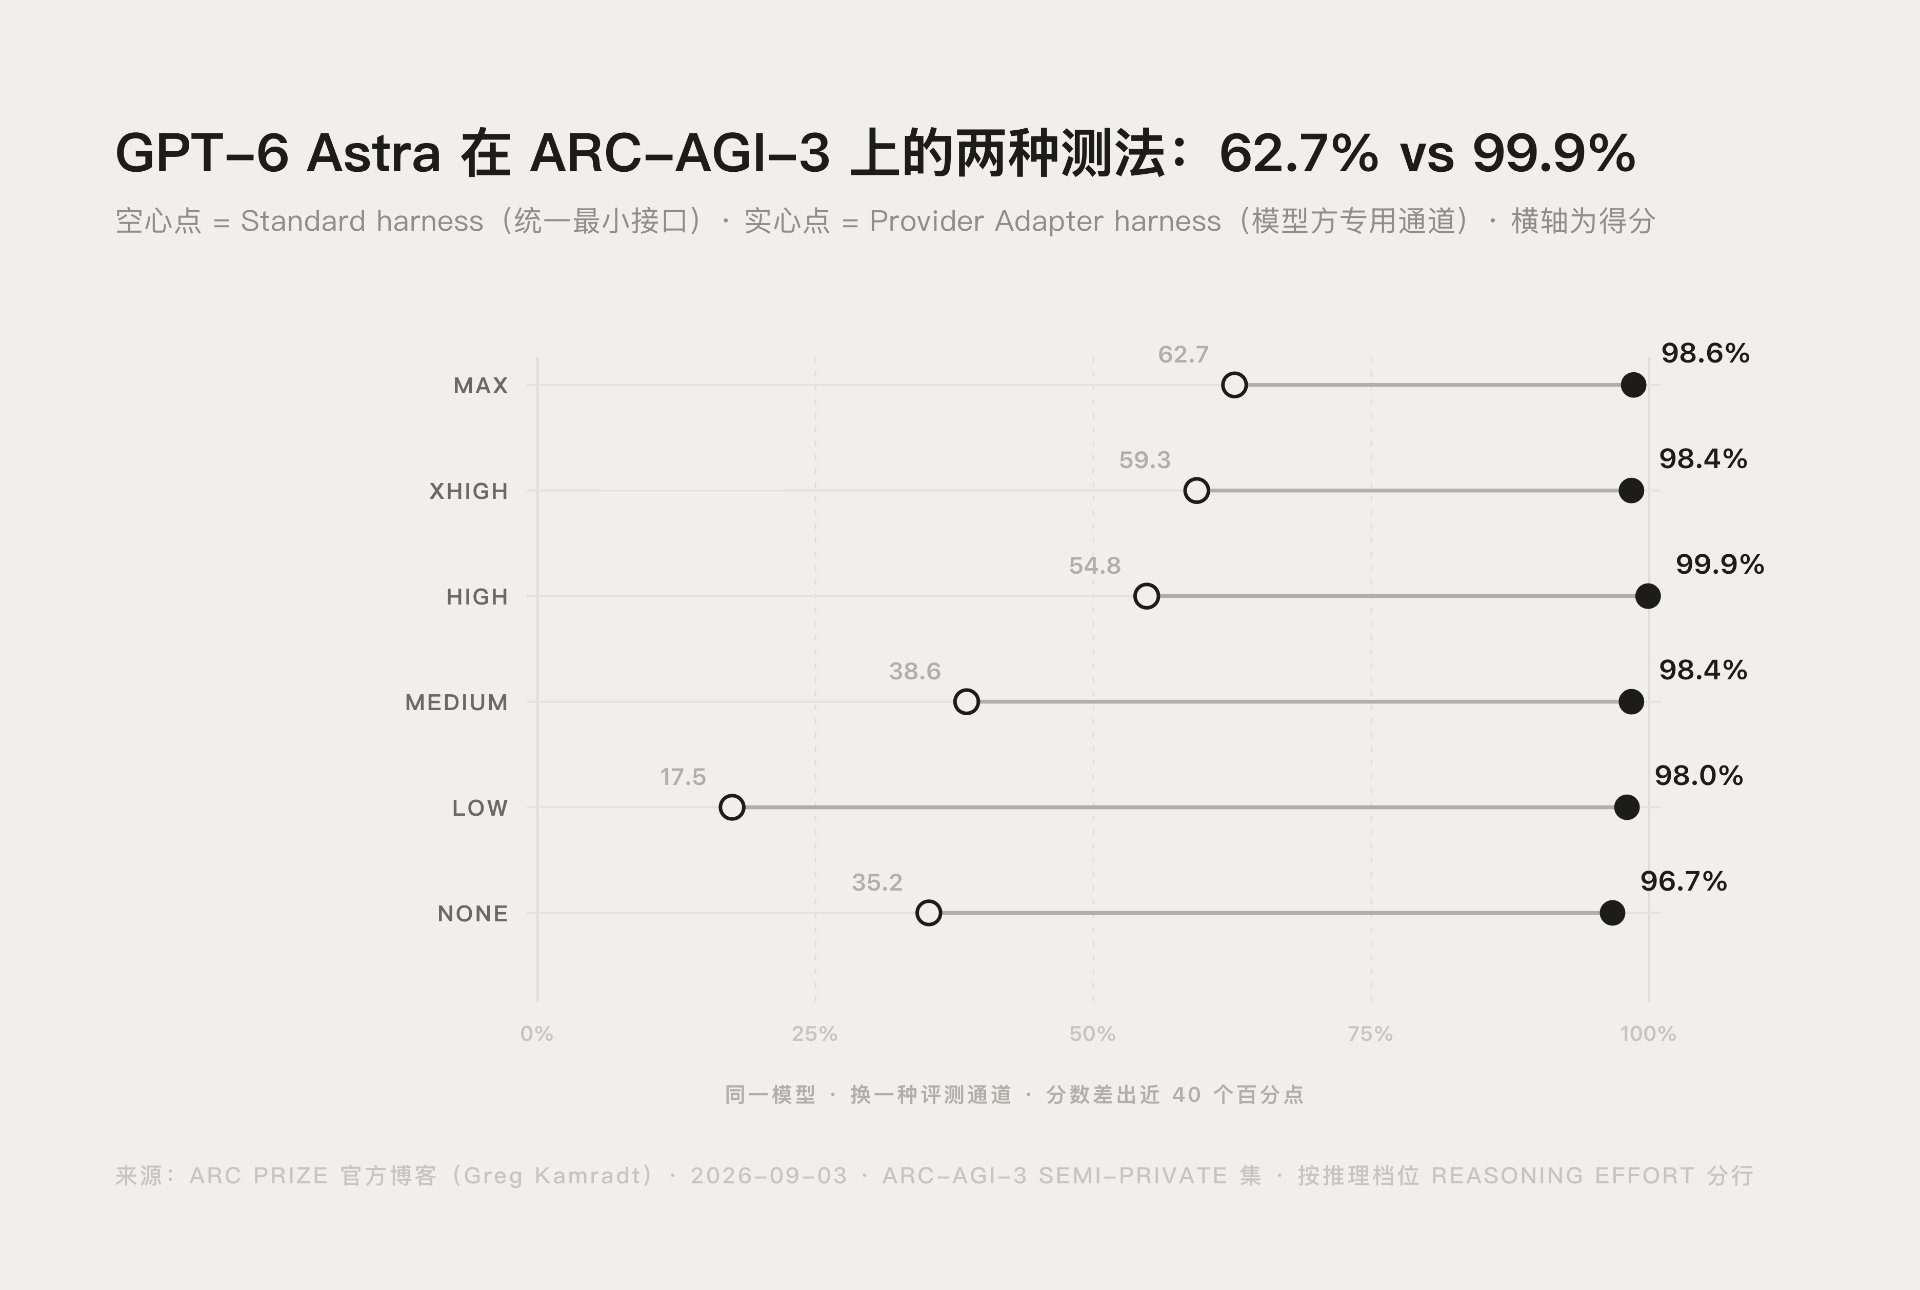
- GPT-6 Astra 在 ARC-AGI-3 半私密集上有两个分数:标准测法 62.7%、模型方适配测法 99.9%(ARC Prize 官方博客),后者在 96% 的关卡上动作数比人类中位数还少。
- Omen Alpha 是 OpenCode 第三代隐身模型,上线即被社区拿去「盲测」;ARC-AGI 这类人类易、AI 难的基准,正是给匿名模型「验明正身」的考场。
这两天为什么大家都在聊 ARC-AGI
2026 年 9 月 3 日到 4 日,两件事把「ARC-AGI」推上了热搜:
第一件:GPT-6 Astra 发布。 OpenAI 称它是「新一代智能」,官方页面点名它在 ARC-AGI-3 上拿到 99.9% 的分数,把 ExploitBench 也刷到了 100%(OpenAI 官方发布页)。发布详情、定价与接入方式我们在《GPT-6 Astra 正式发布》里做过完整解读。
第二件:Omen Alpha 上线。 OpenCode 在 Go 订阅里悄悄上架了第三代隐身模型,厂商保密、社区盲测火热。我们已经在《Omen Alpha 是什么》里详细拆解过这个模型本身。
两件事表面上不相干,实际上都指向同一个关键词:ARC-AGI。一个用它证明自己的模型「像个聪明人」,一个等着被它「验明正身」。要看懂这两波热点,就得先搞懂 ARC-AGI 到底在测什么。
ARC-AGI 是什么:一句话讲清定义
ARC-AGI(Abstraction and Reasoning Corpus for Artificial General Intelligence,通用人工智能抽象与推理语料库)是 François Chollet 在 2019 年论文《On the Measure of Intelligence》(arXiv:1911.01547)中提出的基准。
它的核心思想一句话就能说清:智能不是你已会多少技能,而是你学新技能有多快。
ARC-AGI 不考知识记忆,只给每题少量示例,要求测试者从示例里推断出抽象规律,再应用到全新输入上。为了让人类和 AI 站在同一起跑线,题目只用「核心知识先验」——那些人类天生就有或极早期习得的认知能力(物体恒存、目标导向、简单计数、基本空间关系),不含任何语言、文化或专业知识。这就是认知心理学家 Elizabeth Spelke 提出的 Core Knowledge 理论在 AI 评测里的应用。
所以它的题目有两个特点:
- 人类一眼就会:ARC Prize 的设计哲学叫「Easy for Humans, Hard for AI」,普通人在ARC 任务上可以轻松拿高分。
- AI 背题无效:任务是全新的,预训练见过再多数据也没用,靠的是泛化和推理。
ARC Prize 基金会据此给出的 AGI 定义也很直白:能匹配人类学习效率的系统。在他们看来,只要 AI 和人类在学习效率上还有差距,AGI 就没有到。
三代基准:ARC-AGI-1 → 2 → 3
ARC-AGI 不是一张卷子,而是一个随前沿模型进化而升级的系列。
| 版本 | 形态 | 测什么 | 关键节点 |
|---|---|---|---|
| ARC-AGI-1 | 静态网格谜题 | 从示例推断图案变换规律 | 2019 年提出;2024 年底 o3 首次大幅突破 |
| ARC-AGI-2 | 更难的抽象谜题 | 抬高推理门槛,让「纯堆算力」也难拿分 | 2025 年发布,上线初期前沿模型接近零分 |
| ARC-AGI-3 | 交互式游戏环境 | 探索、建模、定目标、规划执行的完整智能体能力 | 2026 年成为 ARC Prize 主赛道 |
ARC-AGI-1 时代,模型在静态谜题上的分数逐年爬升,到 2024 年底 OpenAI 的 o3 第一次把成绩拉到接近人类水平,ARC-AGI「防背题」的机制开始失效。于是 2025 年发布的 ARC-AGI-2 重新抬高难度,而 2026 年的 ARC-AGI-3 干脆换了个玩法:让 AI 玩它从没见过的游戏。
ARC-AGI-3 怎么测:让 AI 自己玩没说明书的新游戏
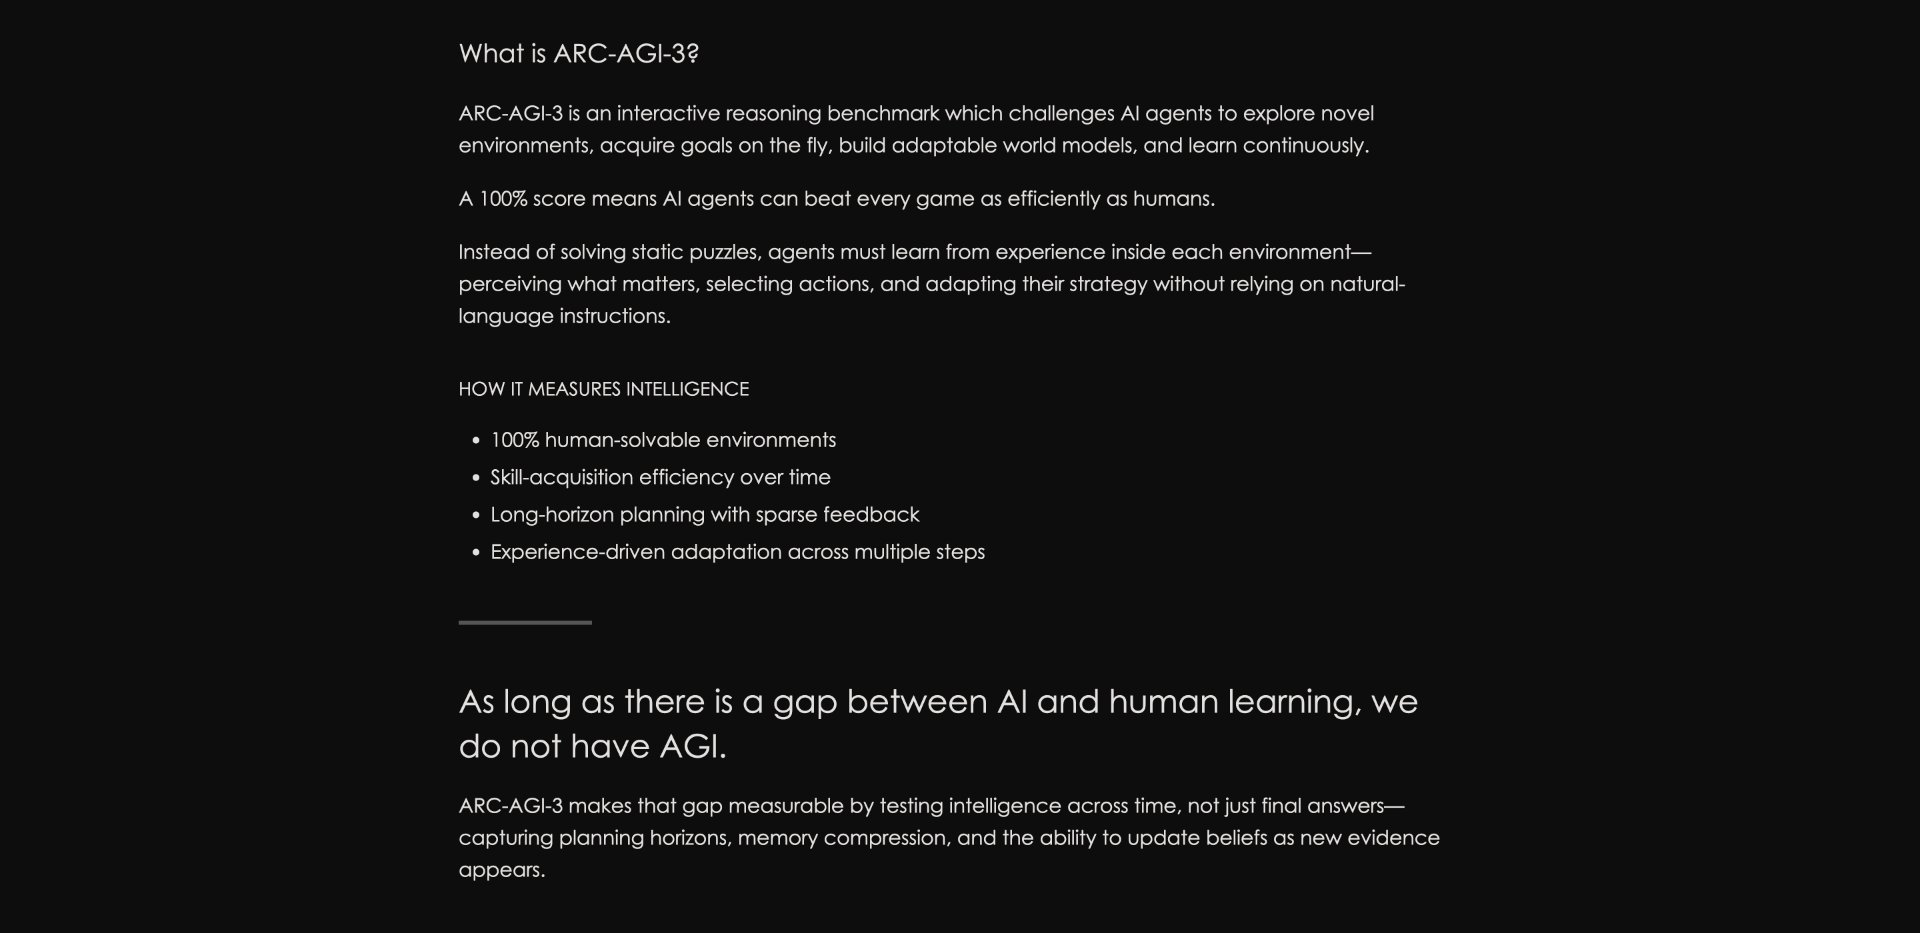
按 ARC Prize 官方的定义,ARC-AGI-3 是第一个交互式推理基准:AI 智能体被扔进一个个新颖的抽象回合制游戏环境里,没有说明书,要靠自己在环境里探索。
每个游戏都考察四种能力:
- 探索(Exploration):信息不会主动给你,必须动手试。
- 建模(Modeling):把看到的现象整理成能预测未来的规则模型。
- 定目标(Goal-setting):奖励信号极其稀疏,目标要自己推断。
- 规划与执行(Planning & execution):从当前状态推演出通往目标的一串动作,并随新信息修正。
关键设定是:所有关卡人类都能解出来。ARC Prize 在上线前找了约 500 名普通公众做对照测试,每关的「人类基线」取完成该关玩家的中位数动作数。所以 ARC-AGI-3 的满分含义非常具体:AI 像人类一样高效地通关每一局。
你也可以亲自玩:官方把游戏开放在 arcprize.org/tasks/ls20,注册后就能体验 AI 同款考题。试过之后你大概率会同意它「对人类简单」这个前提——但也会发现,把「我先试试这个按钮会发生什么」这种直觉变成程序,有多难。
GPT-6 Astra 的 99.9%,要拆成两个数字读
ARC Prize 在 2026 年 9 月 3 日发布了独立评测(作者 Greg Kamradt),Astra 的成绩其实是两套测法下的两个数字,差别大到像一个模型:
| 推理档位 | 标准测法(Standard harness) | 模型方适配测法(Provider Adapter) |
|---|---|---|
| max | 62.7%(花费约 2.6 万美元) | 98.6%(约 1.7 万美元) |
| high | 54.8% | 99.9% |
| medium | 38.6% | 98.4% |
| none | 35.2% | 96.7% |
两套测法的区别要说清楚:
- 标准测法:统一的最小接口,所有模型一视同仁,只给完成任务所需的最基本信息。Astra 在这之下最高 62.7%。
- 模型方适配测法:允许模型接入 OpenAI 自己的工具链。换到 high 档,分数直接跳到 99.9%。
怎么读这组数字,是本次事件里最容易被带偏的地方。我们的判断是:99.9% 证明「OpenAI 的完整工具链 + Astra」能通关 ARC-AGI-3;62.7% 才是「Astra 模型本体」在公平裸接口下的成绩。 两套数据 ARC Prize 都公开了,这恰恰是负责任的做法,但传播时只剩一个 99.9%,需要注意口径。
另外两个同样重要的官方结论:
- 动作效率超过人类:在适配测法下,Astra(max)在 96% 的关卡上用的动作数比人类中位数还少,平均每关少 51.7%。ARC Prize 原话是「有效达到人类平价」,这是他们评测过的最强模型。
- 成本依然惊人:跑完一轮评测花费 1.7 万到 2.6 万美元不等。对照组的人类受试者每 90 分钟收 115 美元外加每关 5 美元奖金。分数追平了,单价还差着几个数量级。
评测回放里还有个有趣的细节:Astra 会自己发明一套紧凑的代数符号做笔记,记录游戏状态、多步计划和控件坐标;在允许写代码的 PRO-LONG 测试环境里,它甚至给每个游戏自建工具文件——解迷宫写 maze_solver.py,处理巡逻兵写 patrol_solver.py。这些行为比分数更能说明「泛化」长什么样。
Omen Alpha 和 ARC-AGI 有什么关系
Omen Alpha 本身跟 ARC Prize 没有官方关系。它们被绑在一起,是因为「隐身模型」这个玩法的鉴定流程:
匿名模型上线后,社区会通过分词器指纹、错误码风格、视频 token 增速等线索猜它的血缘。前两代隐身模型的答案都有迹可循:Pony Alpha 后被证实是 GLM-5 早期测试版,Ox Alpha 约两周后揭晓为 GLM-5.3-Flash(完整鉴别过程见《Ox Alpha 深度解读》,模型本体实测可参考《GLM-5.3 评测》)。这一代 Omen Alpha 上线不到一天,OpenCode 自己的数据页就把它挂在 zhipu/omen-alpha 路径下,但评论区也出现了「确认不是 ZAI」的反方说法,社区各执一词。
在这场猜谜里,ARC-AGI 这类基准的角色是考场:神秘模型想证明自己不是换壳货,最硬的方式就是在人类易、AI 难、无法背题的基准上拿分。海外社区已经有用户把 Omen Alpha 接进编程任务实测(约 180 token/秒、10 分钟完成平时半天的工作量),ARC-AGI-3 官方排行榜则随时欢迎任何模型提交。隐身模型能不能在硬基准上站住,几周内见分晓。
先看官方证据。OpenCode Go 官网的模型列表里,Omen Alpha 的位置和数字一目了然:
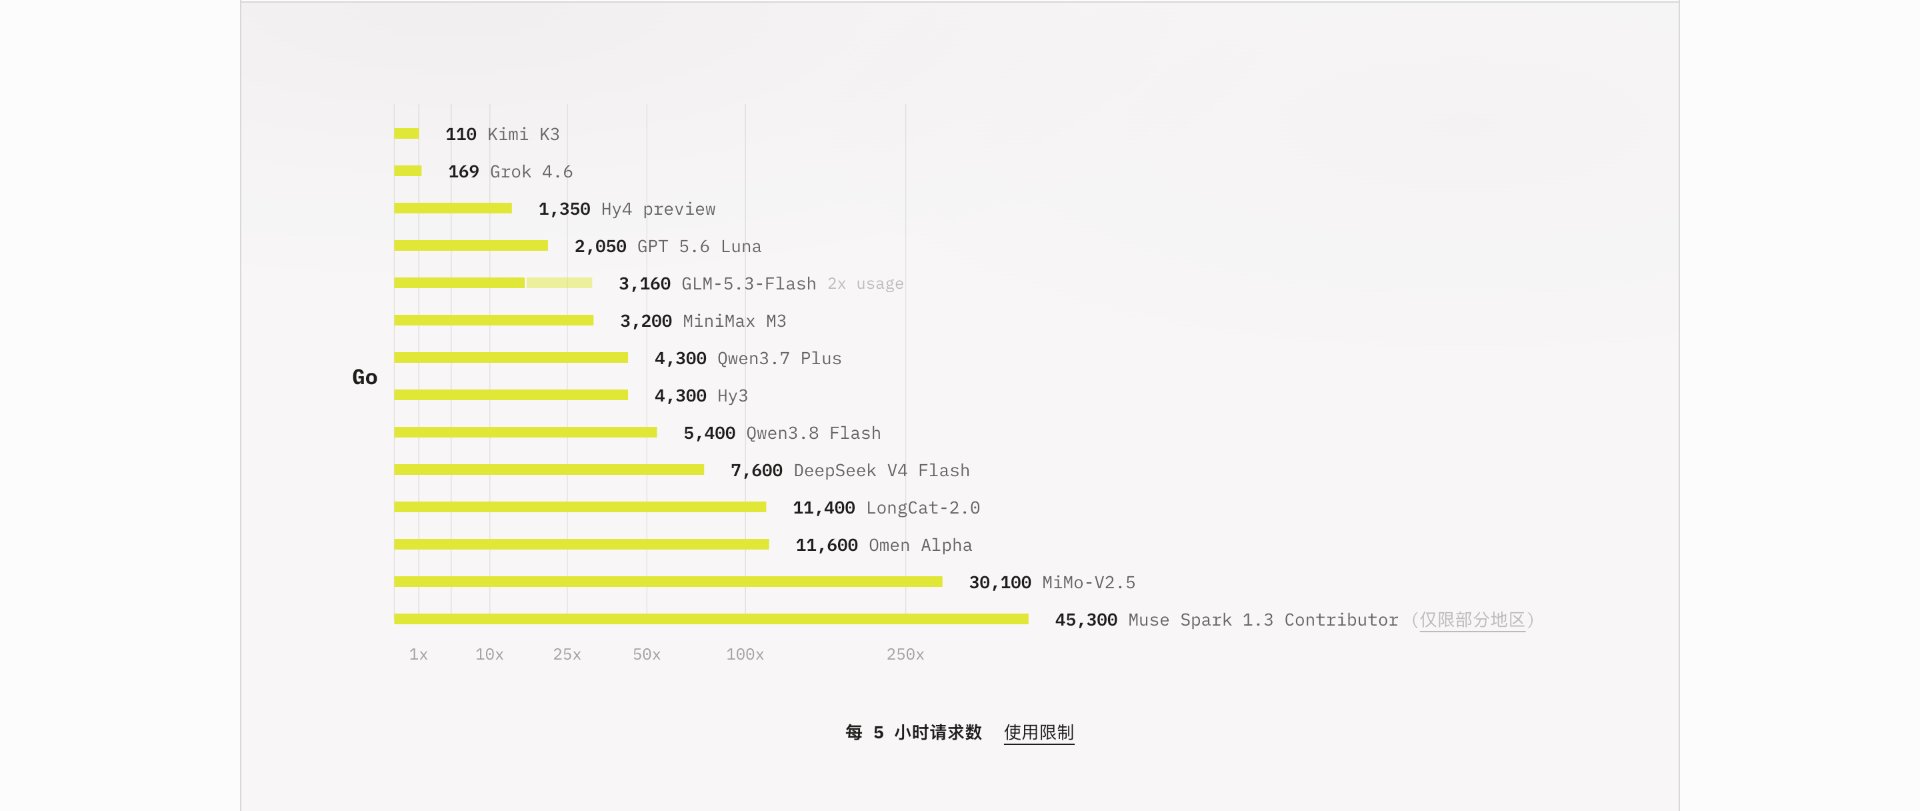
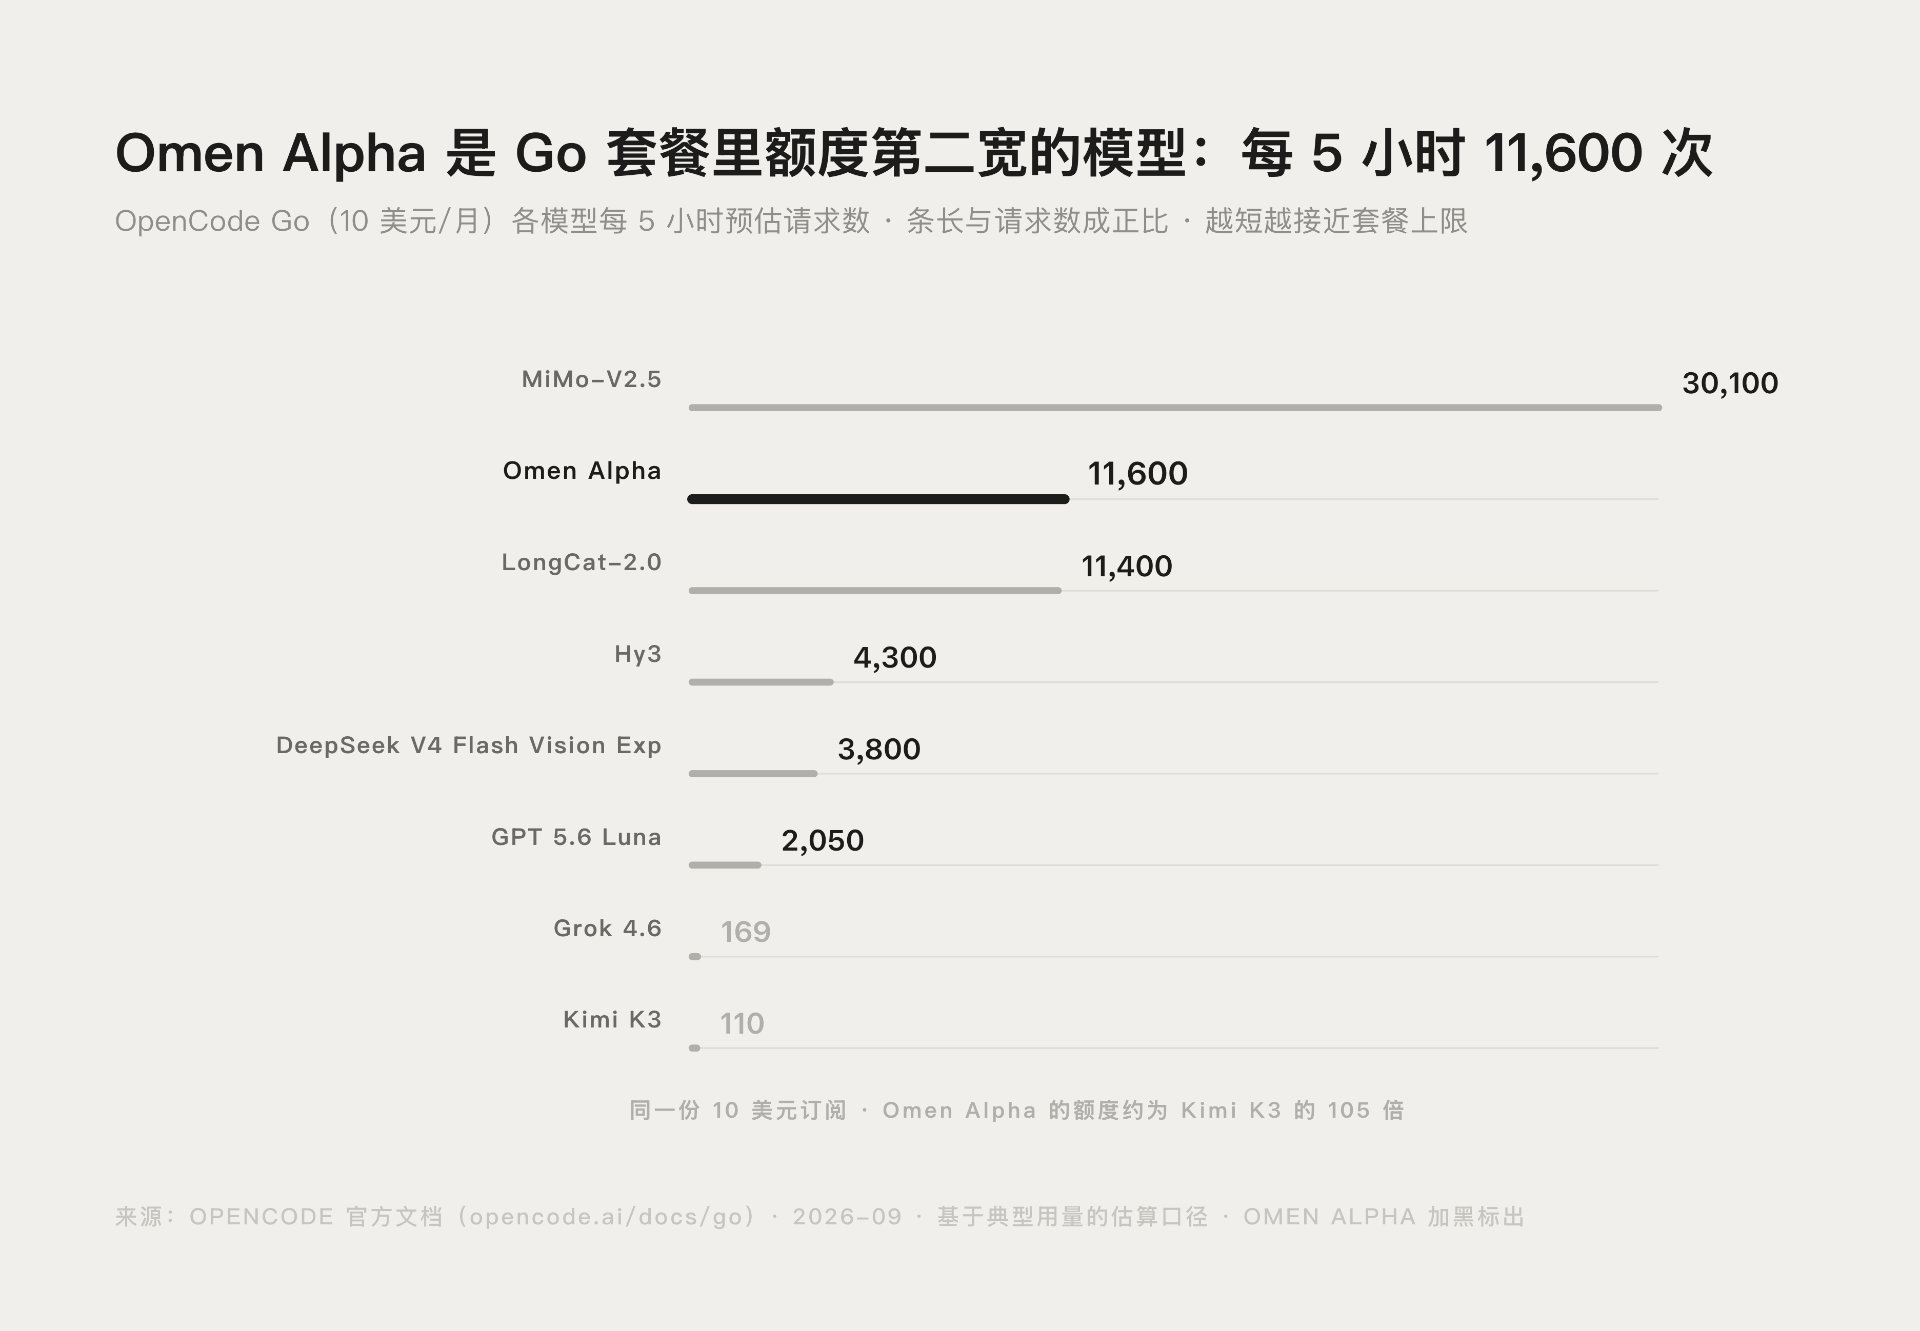
顺带说一个容易被忽略的细节:Omen Alpha 在 Go 订阅里的额度属于最宽松的一档,每 5 小时约 11,600 次请求,约是 Kimi K3 的 105 倍、Grok 4.6 的 68 倍。额度宽说明它的推理成本低,也从侧面印证了它与 MiMo-V2.5、LongCat-2.0 这类低价档模型同档的定位。
我们该怎么用 ARC-AGI 的分数做判断
结合两天的信息,给三类读者的务实建议:
如果你在选模型(开发者):ARC-AGI 分数反映的是「没见过的抽象任务上的学习效率」,跟你的日常 CRUD、代码补全场景不完全相关。选编程模型,优先看 Terminal-Bench、社区实测速度和你的真实任务集;ARC-AGI 分数当作「泛化上限」参考。
如果你在看热闹(普通用户):记住三个数就够了——62.7% 是裸考成绩,99.9% 是带工具链的成绩,人类是 100%。分数追平人类值得记住,但离「AGI 实现了」还有距离,ARC Prize 自己也只说「达到人类平价」而非「通过 AGI」。
如果你在做内容(媒体/博主):转述时请带上口径。只写 99.9% 不写测法,是这波传播里最常见的失真。
总结
ARC-AGI 讲到底就一件事:考「学新东西的速度」,不考「已知的东西」。它让 o3 在 2024 年底一战成名,让 ARC-AGI-3 在 2026 年成了 GPT-6 Astra 的加冕台,也让 Omen Alpha 这类匿名模型有了一个无法作弊的考场。
对普通人来说,看懂三个数(62.7%、99.9%、人类 100%)就能在热点里保持清醒:AI 的泛化能力在快速逼近人类,但成本、口径和真实场景适配都还没到「可以用分数替代判断」的程度。
我们会持续跟踪 Omen Alpha 的身份揭晓和 ARC-AGI-3 排行榜变化,有更新就回来刷新这篇文章。
最后更新于 2026 年 9 月 4 日。本文由 AI345 编辑部基于 ARC Prize、OpenAI、OpenCode 官方一手信源整理撰写,关键数据均标注来源;对模型的实测描述均来自社区公开分享,不代表官方口径。
常见问题
ARC-AGI 是什么基准?
答:ARC-AGI 是 François Chollet 2019 年提出的通用智能基准,测量 AI 从少量示例中学习新规律的效率。题目只用人类天生就懂的核心知识,不依赖任何专业知识,因此人类轻松、AI 困难,靠背题无法得分。
GPT-6 Astra 的 99.9% 是真的吗?
答:是真的,ARC Prize 官方已独立复核。但准确说法是:在「模型方适配测法」(允许接入 OpenAI 工具链)下取得 99.9%;在统一裸接口的标准测法下,最高档成绩是 62.7%。两个分数官方都公开了。
ARC-AGI-3 拿高分等于 AGI 实现了吗?
答:不等于。ARC Prize 对 AGI 的定义是「学习效率匹配人类」,Astra 在动作效率上达到人类平价是重要里程碑,但单次评测花费仍高达 1.7 万美元以上,且评测范围限于特定抽象游戏。距离「像人一样高效学会任何技能」还有明确差距。
ARC-AGI-3 人类可以亲自玩吗?
答:可以。ARC Prize 开放了公开游戏集,入口在 arcprize.org/tasks/ls20,无需任何专业知识即可上手。官方还有人类排行榜,你可以和全球玩家以及 AI 模型比拼效率。
Omen Alpha 和 ARC-AGI 有什么关系?
答:没有官方关系。Omen Alpha 是 OpenCode 的匿名隐身模型,ARC-AGI 是独立基准。两者被联系在一起,是因为隐身模型需要硬基准「验明正身」,而 ARC-AGI 这类人类易、AI 难的考试正是社区最关注的考场之一。
ARC-AGI 和 ARC Prize 是什么关系?
答:ARC-AGI 是基准测试本身,ARC Prize 是运营它的非营利基金会,每年举办百万美元级竞赛。2026 年的竞赛主赛道就是 ARC-AGI-3,在 Kaggle 上设有人类与 AI 两条排行榜。
 京ICP备2024094994号-29