
微调是什么?和提示词、RAG 怎么选,一张对比表讲透
一句话结论:想让 AI 输出稳定的格式、语气或固定完成某个任务,才考虑微调;只是觉得模型知识不够新、不够全,用 RAG;剩下的绝大多数问题,把提示词写好就够了。
先看一个比喻:三种方案对应三种考试
把「让 AI 干活」想象成一场考试,三种方案就是三种考法:
- 提示词像给一个聪明人出考题:他本身什么都会,你把题目说清楚,他就能答好。成本几乎为零,立刻见效。
- RAG 像开卷考试:他不背书,你把资料摊在桌上让他照着答。适合知识经常更新的场景。
- 微调像把孩子送艺校:入学前是普通孩子,经过长时间专门训练,出来后就带着固定的唱法和台风。适合需要固定风格和技能的场景。
提示词:最便宜、最灵活的第一选择
提示词就是你发给模型的指令。模型本身已经学过海量知识,多数时候你只需要把要求说清楚:背景是什么、要什么格式、给一两个例子。它的好处是零成本、秒级见效、随时能改,不满意推翻重来就行。
想系统学怎么写,可以看这篇《如何向 AI 提问:普通人可直接套用的提示词方法》:https://www.ai345.info/ai-guide/prompt-writing-guide
RAG:开卷考试,专治「知识不够新」
RAG(检索增强生成)的做法是:先从你的资料库里检索出相关内容,再把检索结果连同问题一起交给模型,让它照着资料回答。
它解决的是模型「不知道」的问题:训练数据里没有的私有知识、过时的信息、需要天天更新的内容,都靠 RAG 补。代价是每次都要多付检索和更长上下文的 token 费用(怎么省钱可以看这篇省 token 指南:https://www.ai345.info/ai-guide/how-to-save-token),资料塞太多还可能触发上下文超限,比如《Ox Alpha 报错怎么办》里讲到的上下文超限就是典型场景:https://www.ai345.info/ai-guide/ox-alpha-errors-fix
微调:送艺校,专治「行为不稳定」
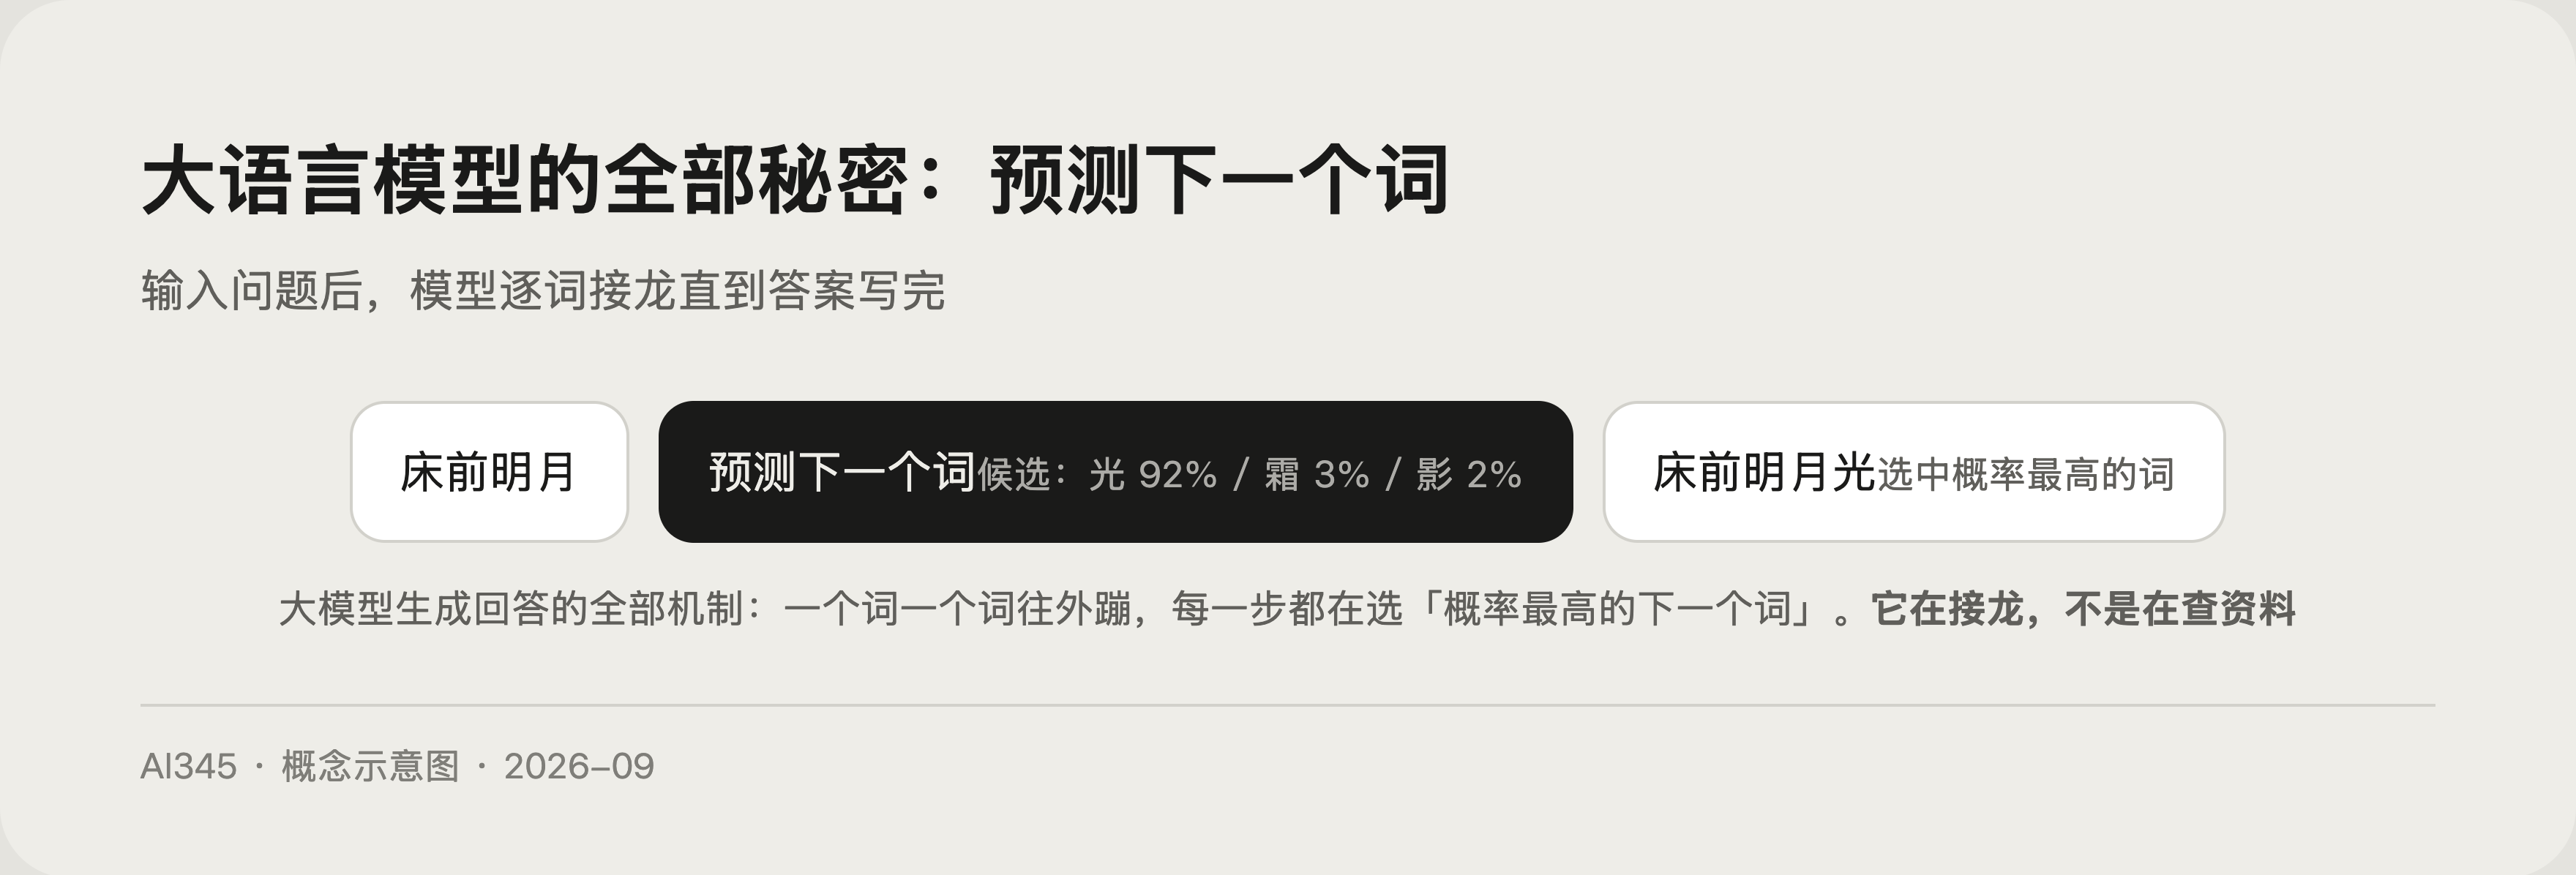
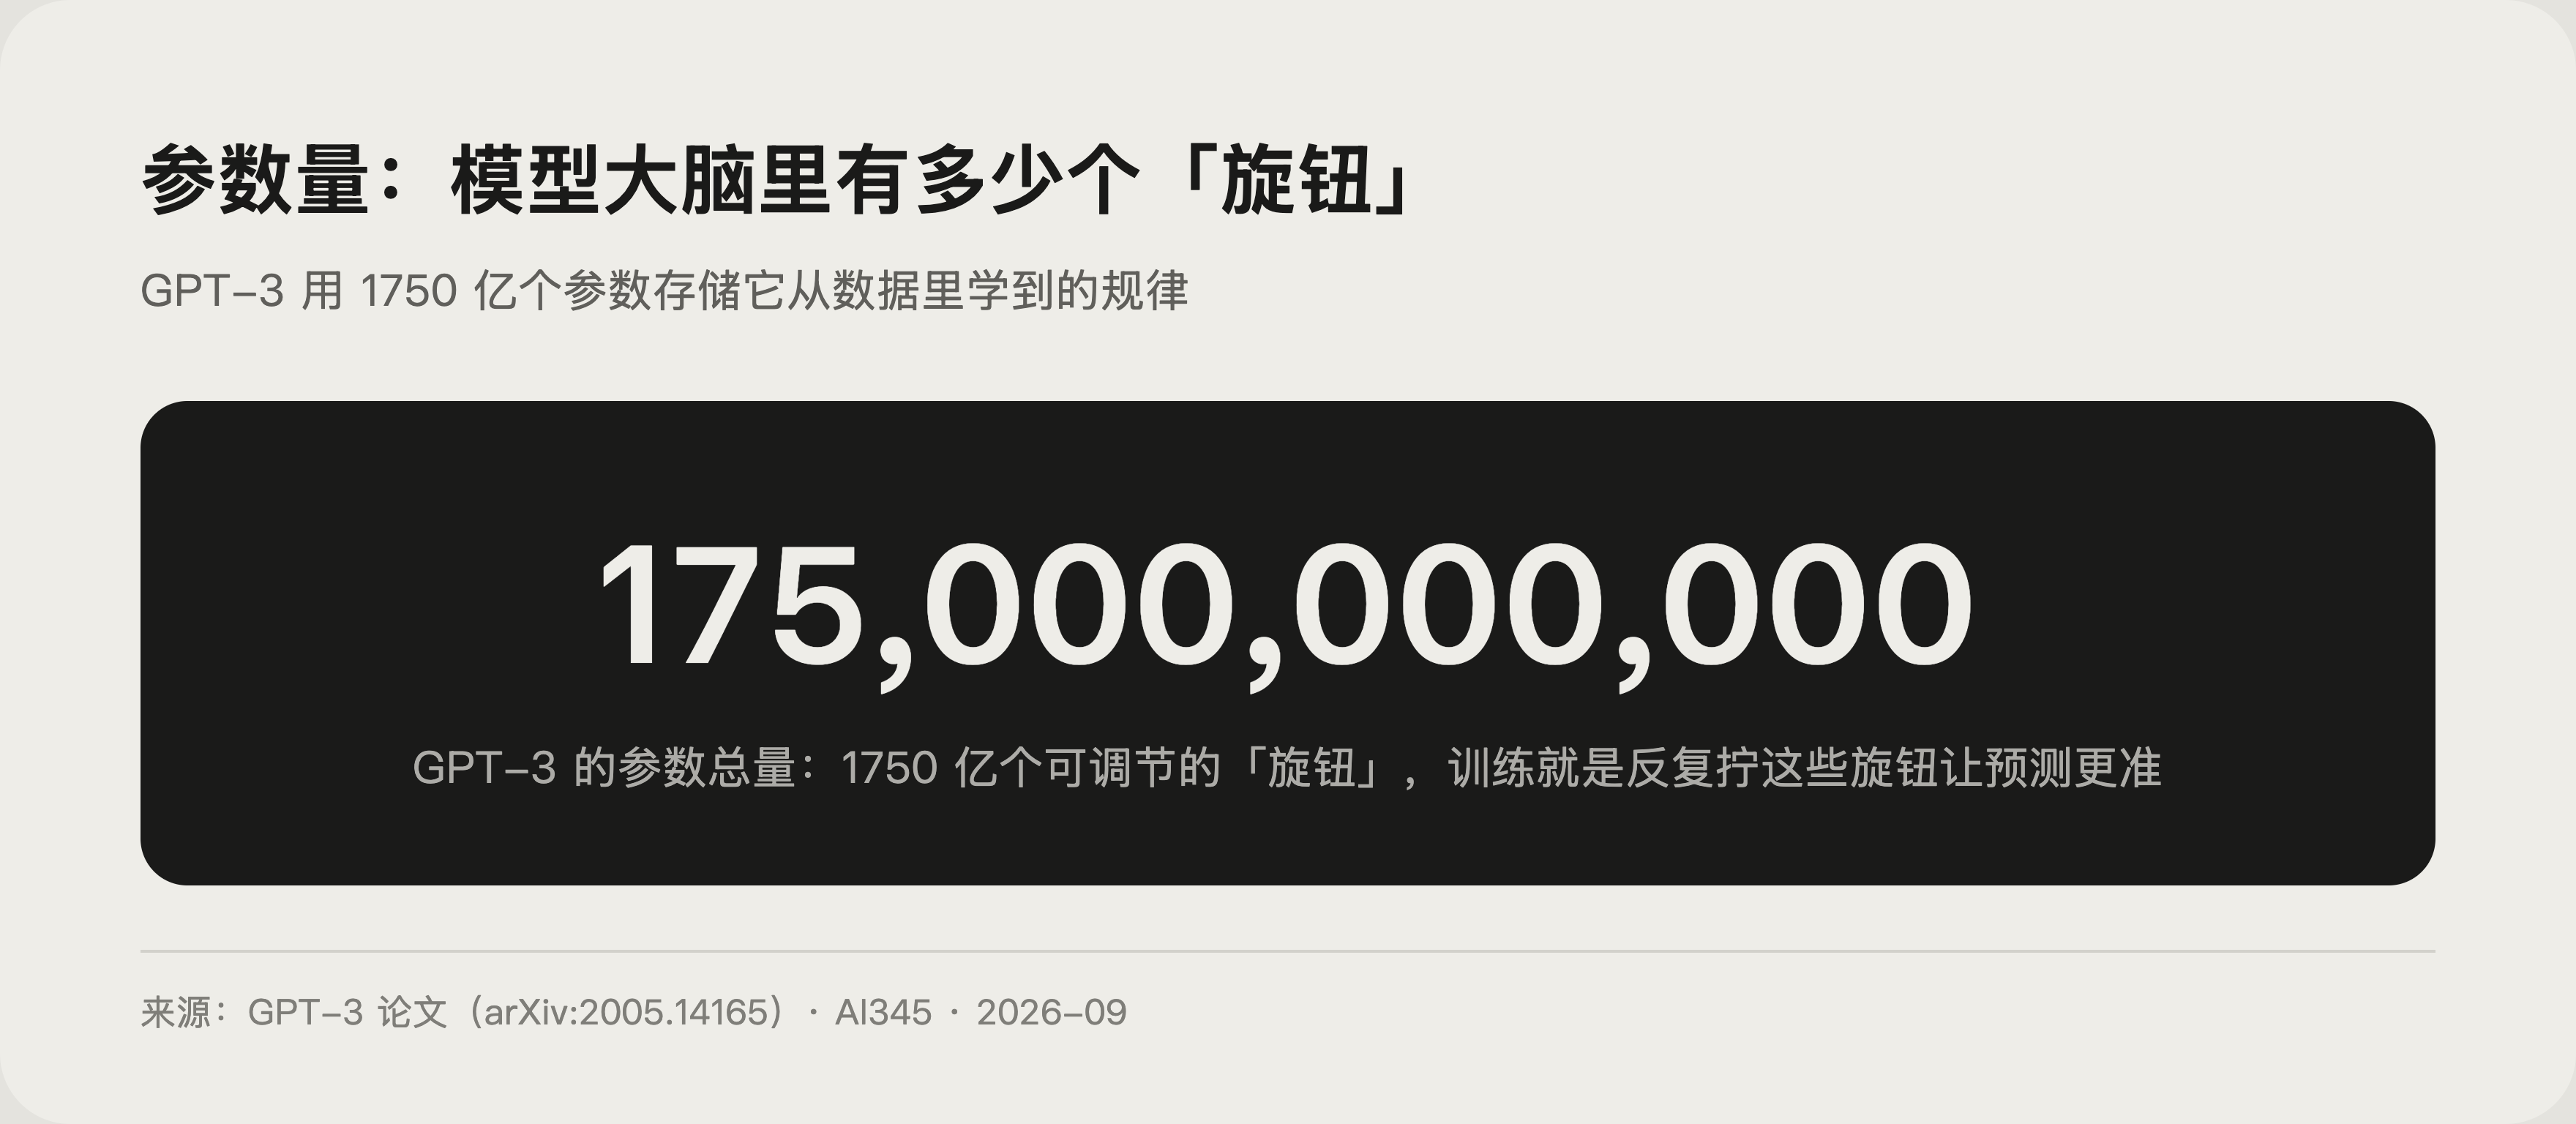
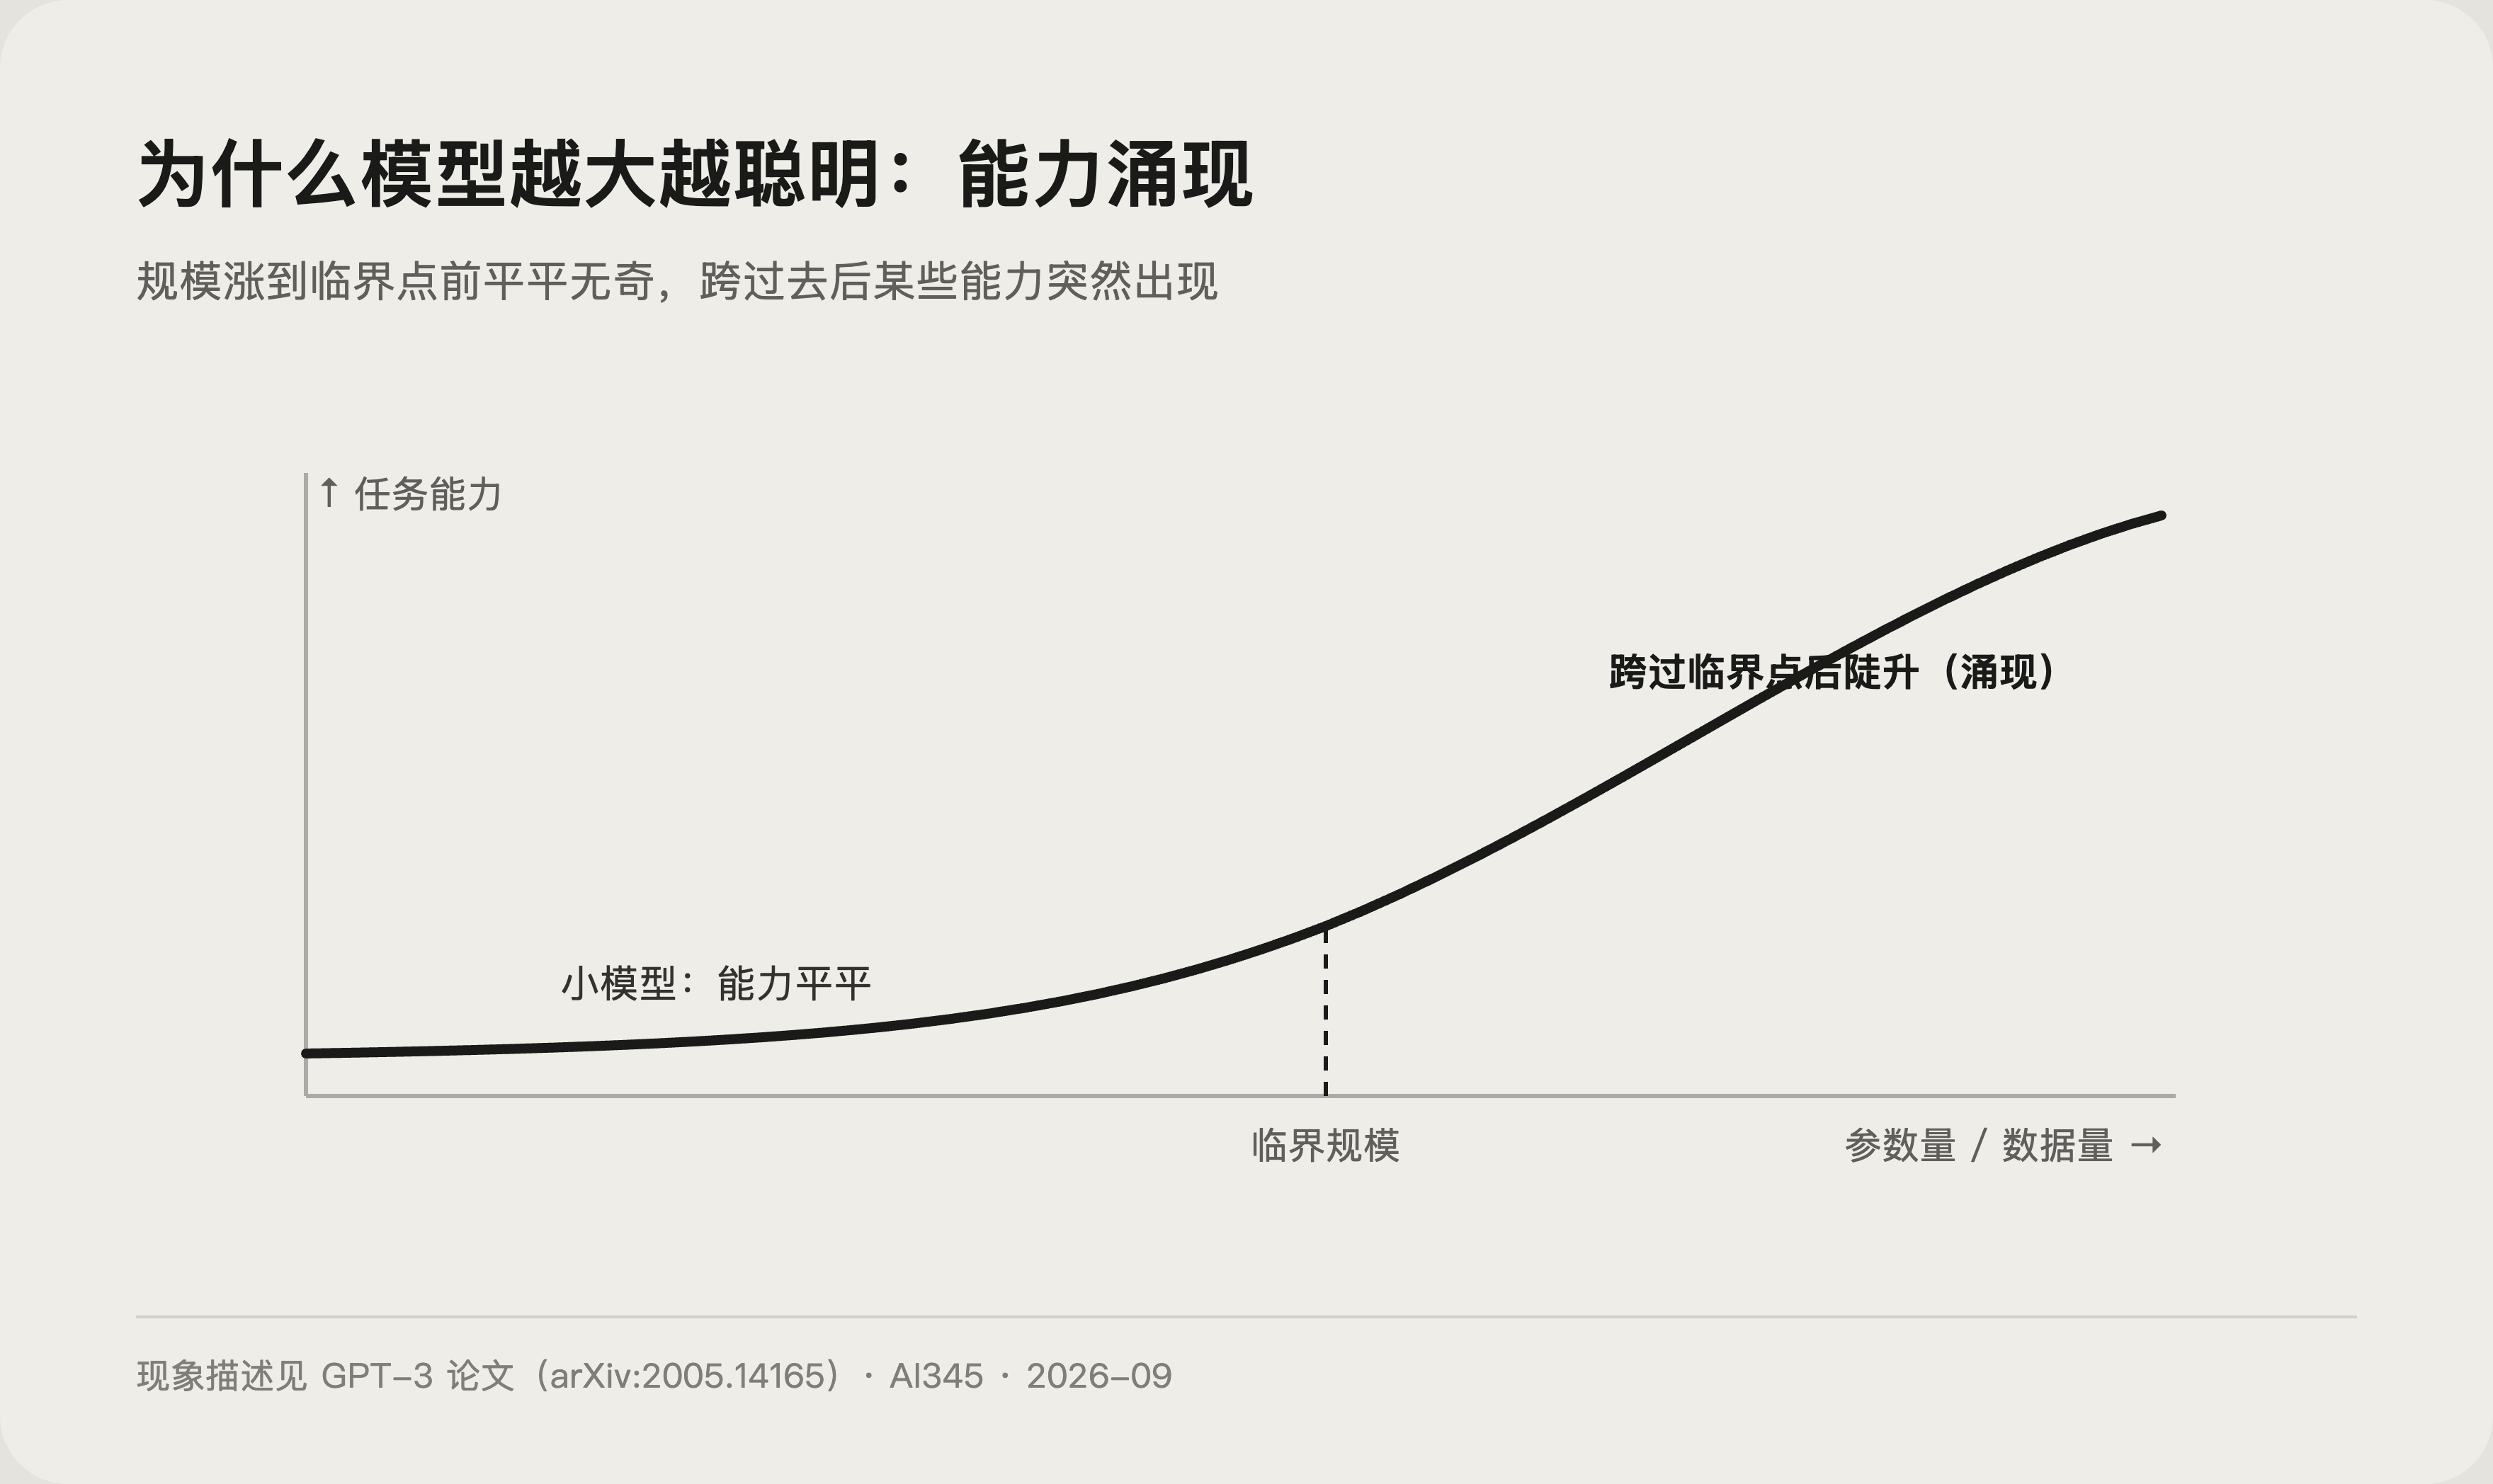
微调(fine-tuning)是在一个已经训练好的模型上,用你自己的示例数据再训练一轮,让它在特定任务上表现更稳定。按维基百科的定义(https://en.wikipedia.org/wiki/Fine-tuning_(deep_learning) ),它属于迁移学习的一种:复用模型原来学到的知识,去适配一个更具体的任务。
OpenAI 官方文档对监督微调的描述很直白:用「正确答案示例」训练模型,让它更可靠地输出你想要的风格和内容。门槛也不高:最少 10 条示例,官方建议先准备 50 条高质量示例去试效果,50 到 100 条通常就能看到明显提升。
但要注意:微调擅长改变「行为」(格式、语气、风格、任务熟练度),不擅长补充「知识」。想让模型知道你公司最新的产品价格,微调不是正确答案,RAG 才是。
一张对比表讲透三方案
| 维度 | 提示词 | RAG | 微调 |
|---|---|---|---|
| 解决什么问题 | 任务表达不清楚 | 知识缺失或过时 | 输出格式风格不稳定 |
| 成本 | 几乎为零 | 每次多付检索与上下文 token 费 | 训练费用加长期维护 |
| 见效速度 | 分钟级 | 天级(要搭好检索链路) | 周级(数据、训练、评测) |
| 知识更新 | 不更新,靠模型自带 | 实时换资料即可 | 训完即定版,更新要重新训练 |
| 适合场景 | 日常问答、写作、翻译 | 客服知识库、文档问答 | 固定格式输出、品牌语气、垂直任务 |
官方也是这么建议的
OpenAI 在官方优化指南里把三条路讲得很清楚:先从提示词开始打基线;如果模型缺知识(训练集里没有、已经过时、属于私有信息),走上下文优化,也就是 RAG;如果输出格式不一致、语气不对、推理不稳定,才动微调。官方还特别强调提示词工程「通常是最好的起点」,像摘要、翻译这类任务,把提示词写好就可能直接达到生产可用。详见 Optimizing LLM Accuracy。
场景化推荐:如果你是这几种人
- 产品经理做功能验证:先用提示词,快,随时推翻重来,别一上来就想着训练模型。
- 做客服机器人或企业文档问答:选 RAG,知识库天天变,只有开卷考试跟得上。
- 每天大批量产出固定格式内容(工单摘要、商品文案、周报初稿):提示词调到极限还不稳,再上微调。
- 大多数实际项目是组合拳:官方给出的典型优化路径就是微调提升稳定性,再用 RAG 补知识,两者叠加使用。
微调不是银弹:三个坑
- 数据质量决定一切:示例里有什么毛病,模型就学什么毛病,垃圾进垃圾出。
- 先评测再投入:官方明确提醒,先搭好评测,确认微调后的模型确实比原模型好,再继续加数据,否则钱白花。
- 平台在收缩:OpenAI 已宣布微调平台不再对新用户开放,动手前先确认你用的平台还支持这个能力。
延伸阅读
把这篇吃透后,建议按这个顺序接着读:
常见问题
微调和提示词是二选一吗?
答:不是。它们解决不同问题,实际项目里经常叠加使用:微调负责固定行为,提示词负责每次任务的具体要求。
微调需要准备多少数据?
答:官方口径是最少 10 条,建议从 50 条高质量示例开始,50 到 100 条通常就有明显提升。质量远比数量重要。
微调一次要多少钱?
答:费用按训练数据量计算,各平台差异很大,没有统一数字,具体价格可以参考《千帆大模型平台价格表》这类平台报价:https://www.ai345.info/ai-guide/baidu-cloud-2026-guide 。建议先用 50 条示例小规模试跑,确认有效再扩大投入。
微调之后模型会变笨吗?
答:有可能。训练数据太窄会让模型在其他任务上表现下降。所以官方建议先做评测,对比微调前后的整体表现再决定。
普通人应该先学哪个?
答:先学提示词,成本最低、收益最快。RAG 和微调是工程手段,等确认提示词确实解决不了问题再考虑。
 京ICP备2024094994号-29