
AI 润色怎么用?5 步提示词工作流,改完不显 AI 味(2026 实测)
AI 润色的正确用法不是把文章丢给 AI 说"帮我润色一下",而是分 5 步:先锁定不能改的事实,再让 AI 只调结构,然后把抽象词换成具体事,补进你自己的细节,最后由人通读负责。直接让 AI"润色"反而会越润越有 AI 味。下面给出原因、实测数据和可直接复制的提示词模板。
本文目录:AI 润色是什么 · 为什么越润越有 AI 味 · 改写前后实测 · 5 步工作流 · 提示词模板 · 自查清单 · FAQ
AI 润色是什么?
AI 润色指的是用大语言模型(ChatGPT、Claude、DeepSeek、Kimi、豆包等)帮你修改文章的表达:删掉啰嗦的句子、理顺逻辑、调整语气、修正语病。它和"让 AI 从零写一篇"不同,润色的前提是你已经有一份初稿,AI 负责把初稿改得更通顺、更易读。
但从 2024 年到现在,几乎所有主流模型生成的中文都带明显的"AI 腔":动辄"赋能""闭环",开头"随着……的发展",结尾"总而言之"。开源项目 Humanizer-ZH 把这些现象总结为五类:大词轰炸与职场黑话、过度夸大的虚假里程碑、欧化翻译腔、机械清单式排版、对话机器人残留和鸡汤结尾(见 Humanizer-ZH 项目说明)。维基百科社区的 Signs of AI writing 清单记录的英文 AI 写作特征几乎一一对应。
所以"AI 润色"有一个隐藏陷阱:用带 AI 腔的模型去润色,输出很可能比你自己的初稿更像 AI 写的。
为什么"帮我润色一下"越润越有 AI 味?
原因有三个,都和模型的训练方式有关:
- 模型被奖励"工整"。训练数据里高分作文、官方通稿、营销文案占比很高,模型倾向把你的句子改得"更规范":段落长度变均匀、句式变整齐,而这恰恰是读者一眼认出 AI 的信号。
- 模型爱加连接词和总结句。"不仅……更……""综上所述"是模型最顺手的话术,润色一轮,套话密度上升。
- 模型会磨平细节。你写的"上周三改到凌晨一点",模型可能改成"经过了长时间的努力"——更通顺,但人味没了。
开源改稿项目 qu-ai-wei 的做法正好相反:删掉不提供信息的套话、保留数字和判断、不替作者编细节(项目规则见 qu-ai-wei GitHub 仓库)。这给我们的启发是:润色的方向应该是"做减法",而不是"做美化"。
实测:一段文案改写前后差多少?
我们统计了 Humanizer-ZH 项目公开的两段改写示例(一段产品文案、一段旅行随笔),用 17 个高频 AI 套话词(赋能、闭环、里程碑、极致、协同效应等)做量化对比,结果如下:
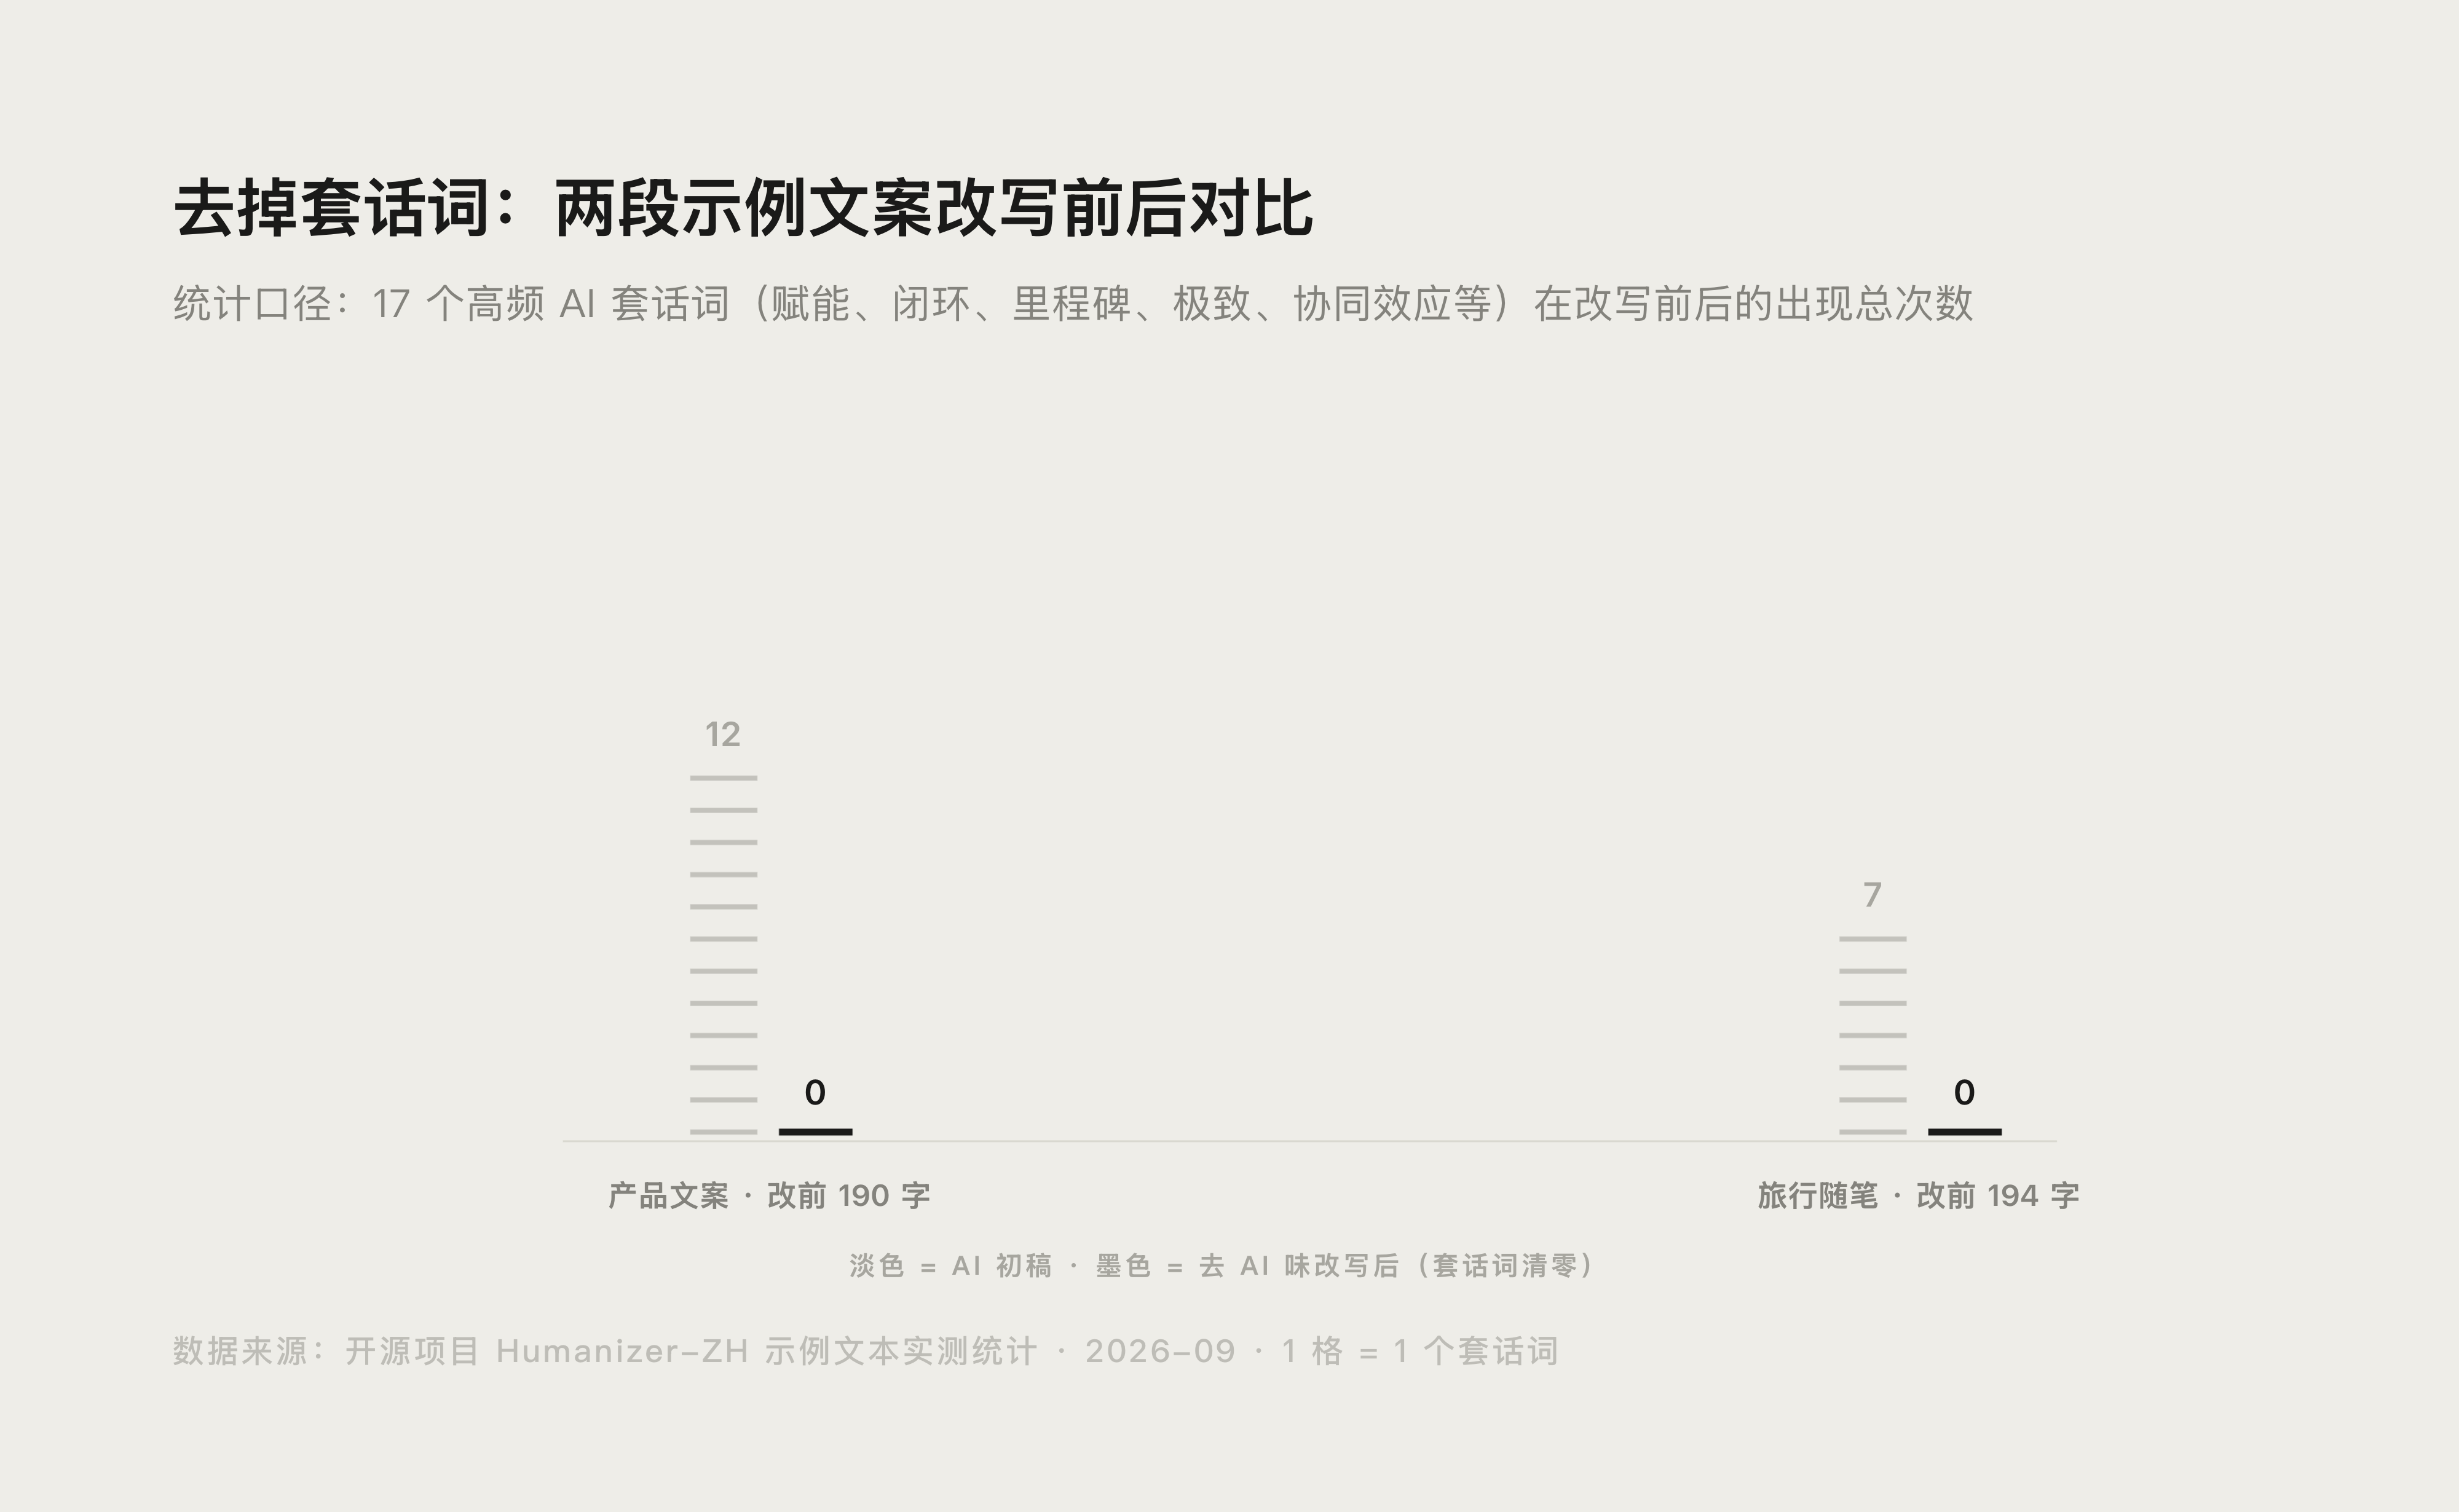
- 产品文案:改写前 190 字、命中 12 个套话词;改写后 93 字、套话词清零,篇幅砍掉一半,信息一点没少。
- 旅行随笔:改写前 194 字、命中 7 个套话词;改写后 149 字、套话词清零。
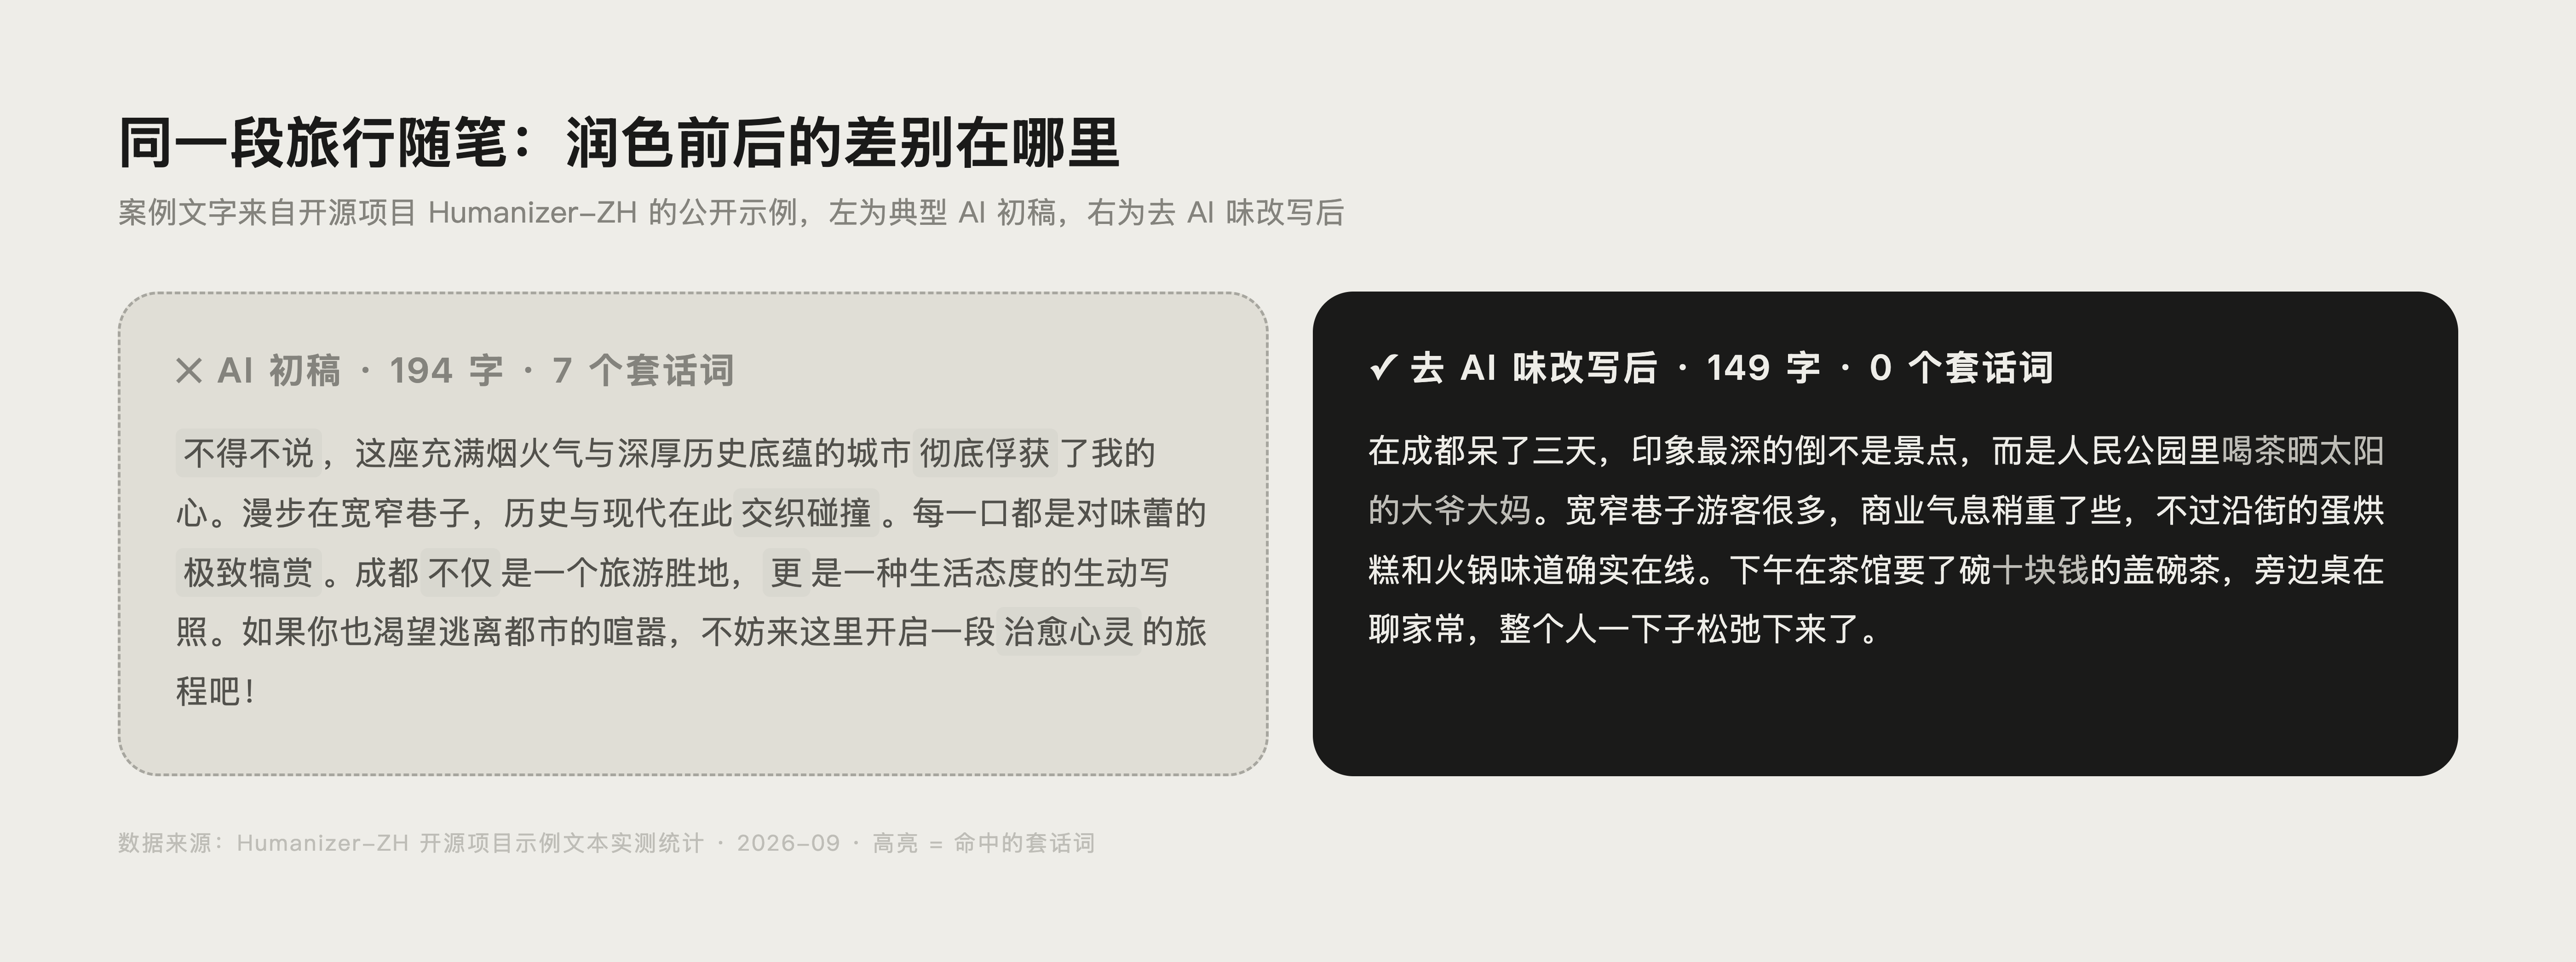
看对比图能直观感受到差别:初稿里"彻底俘获了我的心""极致犒赏""治愈心灵的旅程"全是正确但空洞的表达;改写后变成"人民公园里喝茶晒太阳的大爷大妈""十块钱的盖碗茶"——具体名词和数字回来了,人味自然就有了。
这个实测说明一件事:好的润色不是换同义词,而是删空话、补具体。这也是下面 5 步工作流的设计逻辑。
AI 润色的正确顺序:5 步工作流
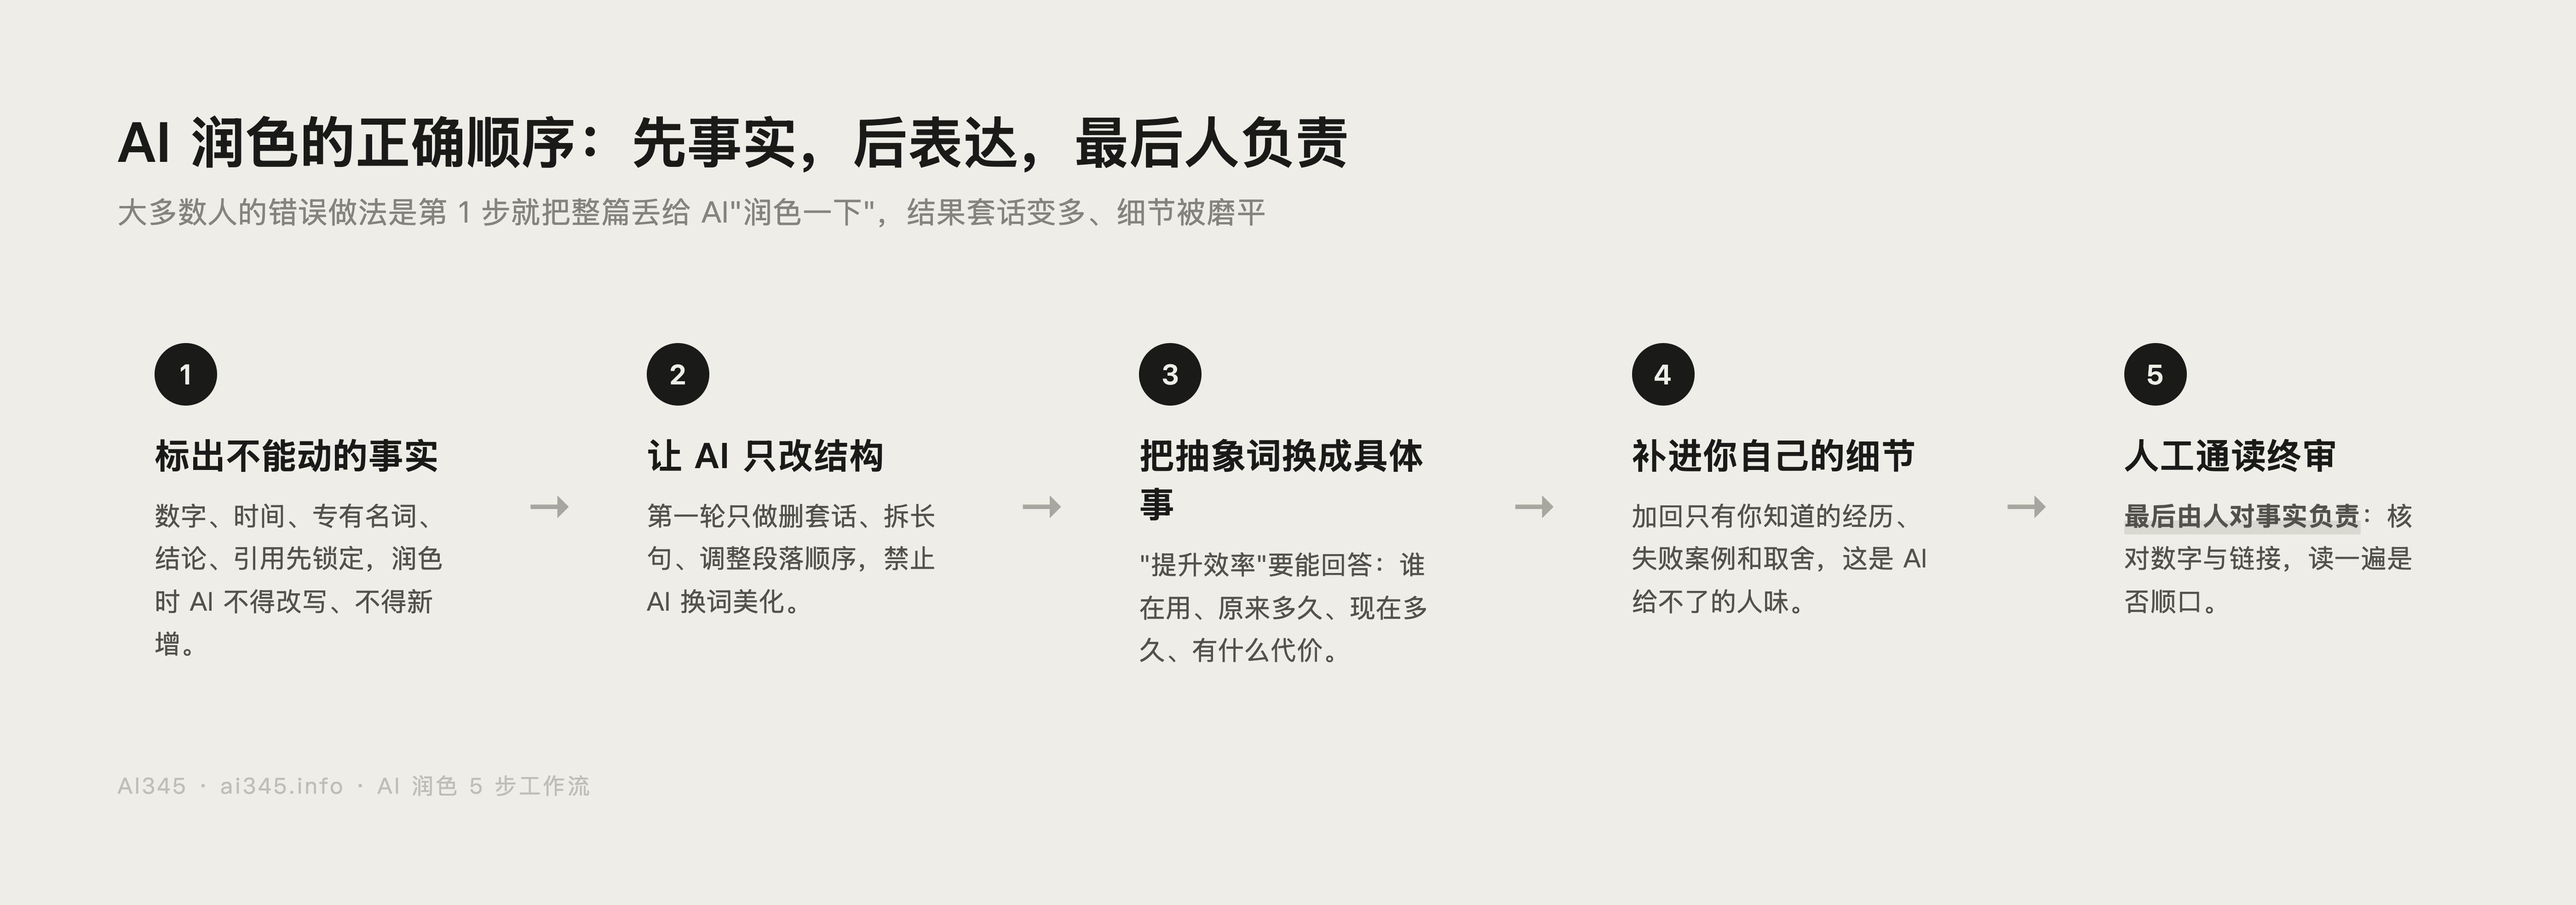
第 1 步:标出不能动的事实
把数字、时间、人名、产品名、结论、引用先列出来告诉 AI:"这些内容一个字不许改,也不许新增任何事实。"这一步是防止 AI 润色时"脑补"的关键。
第 2 步:让 AI 只改结构
第一轮润色只做三件事:删套话、拆长句、调整段落顺序。明确禁止 AI 替换你的用词、美化表达。改动越小,细节越安全。
第 3 步:把抽象词换成具体事
"提升效率""优化体验"这类话,让 AI 提出替换建议,但具体数字必须你提供。一个抽象判断要能回答三个问题:谁在用?原来怎么做、现在怎么做?结果和代价是什么?
第 4 步:补进你自己的细节
AI 给不了的人味只有你能给:真实的失败经历、当时的取舍、踩过的坑。这一步必须自己做,或者把你的经历口述给 AI 让它整理,而不是让 AI 编。
第 5 步:人工通读终审
最后通读一遍,核对所有数字和链接,读出声看是否顺口。发布即负责:文章里每个事实的责任人是你,不是 AI。
不同场景的侧重点
| 场景 | 润色重点 | 特别注意 |
|---|---|---|
| 公众号 / 自媒体 | 删套话、加个人视角、长短句节奏 | 别让 AI 补案例,编的经历会被读者识破 |
| 工作汇报 / 方案 | 结论先行、量化指标、删口号 | "赋能""闭环"要么给对象要么删掉 |
| 邮件 / 日常沟通 | 第一句直接说事,删客套 | AI 爱加的"希望对您有帮助"可以直接删 |
| 技术文档 | 只清理铺垫,术语和参数不动 | 命令、版本号、路径绝对不许改 |
可直接复制的 AI 润色提示词模板
下面这段模板把上面 5 步压缩成一段话,适用于 ChatGPT、Claude、DeepSeek、Kimi、豆包等常见模型:
你是一名严格的中文编辑。请润色以下文章,遵守这些规则:

【锁死】专有名词、数字、时间、引用、结论原样保留;不新增任何事实、案例和数据。
【第一轮】只删除不提供信息的部分:宏大开场("随着……的发展")、模板收尾("总而言之")、空洞强调("值得注意的是")。
【第二轮】把抽象表达改成具体动作或结果;如果缺少事实支撑,标注"需要作者补充",不要编造。
【表达】长短句交错,去掉"不仅……更……"式对仗;保留我原有的语气,不要过度口语化。
【输出】先列出你删除和修改的内容清单,再给出全文,方便我核对。

我的文章如下:
[粘贴初稿]
如果你在用 Claude Code、Codex 等编程 Agent 写作,可以直接安装去 AI 味 Skill 把这套规则固化下来,选型和安装方法见站内这篇实测:去AI味 Skill 实测全指南。
润色完怎么自查:去 AI 味检查清单
发布前花两分钟过一遍:
- 删掉开头第一句和结尾最后一句,文章信息量是否几乎没变?是 → 这两句该删。
- 全文搜"赋能、抓手、闭环、极致、深度、全面",每个词后面有没有具体内容?没有 → 删或改具体。
- 段落长度是不是太均匀?所有段落都差不多长 → 手动制造一两个一句话短段。
- 每个观点后面有没有例子、数字或反例?全是大道理 → 补细节。
- 数字、产品名、链接逐个核对过吗?AI 润色最容易悄悄改错的就是这些。
更系统的改写方法(含检测工具实测)可以继续阅读站内这篇:去AI味技巧:2026最新实测与提示词全攻略。提示词写不好可以参考普通人可直接套用的提示词方法,写工作文档可以看AI 写作工具怎么用:从需求输入到事实校对的工作流。
总结
AI 润色的核心不是找一句"万能润色提示词",而是控制改稿的顺序和边界:先锁事实、只改结构、换具体表达、补真实细节、人工终审。用开源项目示例的实测数据说,一次合格的去 AI 味润色能删掉 40% 以上的篇幅和全部套话,同时保住所有信息。想让文章真正像人写的,最有效的一步永远是第 4 步:把你自己的经历写进去。
作者:AI345|最后更新:2026 年 9 月 7 日|数据说明:套话词统计基于 Humanizer-ZH 开源项目公开示例文本,统计口径见文中说明。
常见问题
AI 润色会被检测出来是 AI 写的吗?
只让 AI"润色一下"的文本,AI 特征反而会更明显,因为润色会增加套话和工整度。按本文 5 步流程做,补进你自己的细节后,被误判的概率会显著下降,但任何检测工具都有误判,不建议以"过检测"为目标。
AI 润色和去 AI 味是一回事吗?
不是。AI 润色是让 AI 帮你把初稿改得更通顺,是"改稿手段";去 AI 味是消除文本中的机器感,是"质量目标"。实践中两者是一条流水线:先按 5 步润色,再做一次去 AI 味自查。
有免费的 AI 润色工具吗?
ChatGPT、豆包、Kimi、DeepSeek 的免费版都能做润色,效果取决于提示词而不是工具本身。不想写提示词可以用开源改稿 Skill(如 qu-ai-wei、Humanizer-ZH,均为 MIT 协议免费),安装方法见站内 Skill 选型指南。
论文可以用 AI 润色吗?
语法和表达层面的润色一般被允许,但各校和期刊规定不同,用前先确认规则;绝不能让 AI 新增论据或改写结论。学术场景可以关注专门的学术润色工具(如 2026 年 8 月发布的 academic humanizer),并以学校规定为准。
为什么我让 AI 润色后,文章变长了很多?
模型默认倾向"把话说满",会不自觉地补充背景、连接词和总结句。在提示词里明确写上"只删不增、总字数不得增加",并在输出要求里让它先报告删除清单。
 京ICP备2024094994号-29