
Kolibri 是什么:德国 78B 开源模型,百万上下文免费用
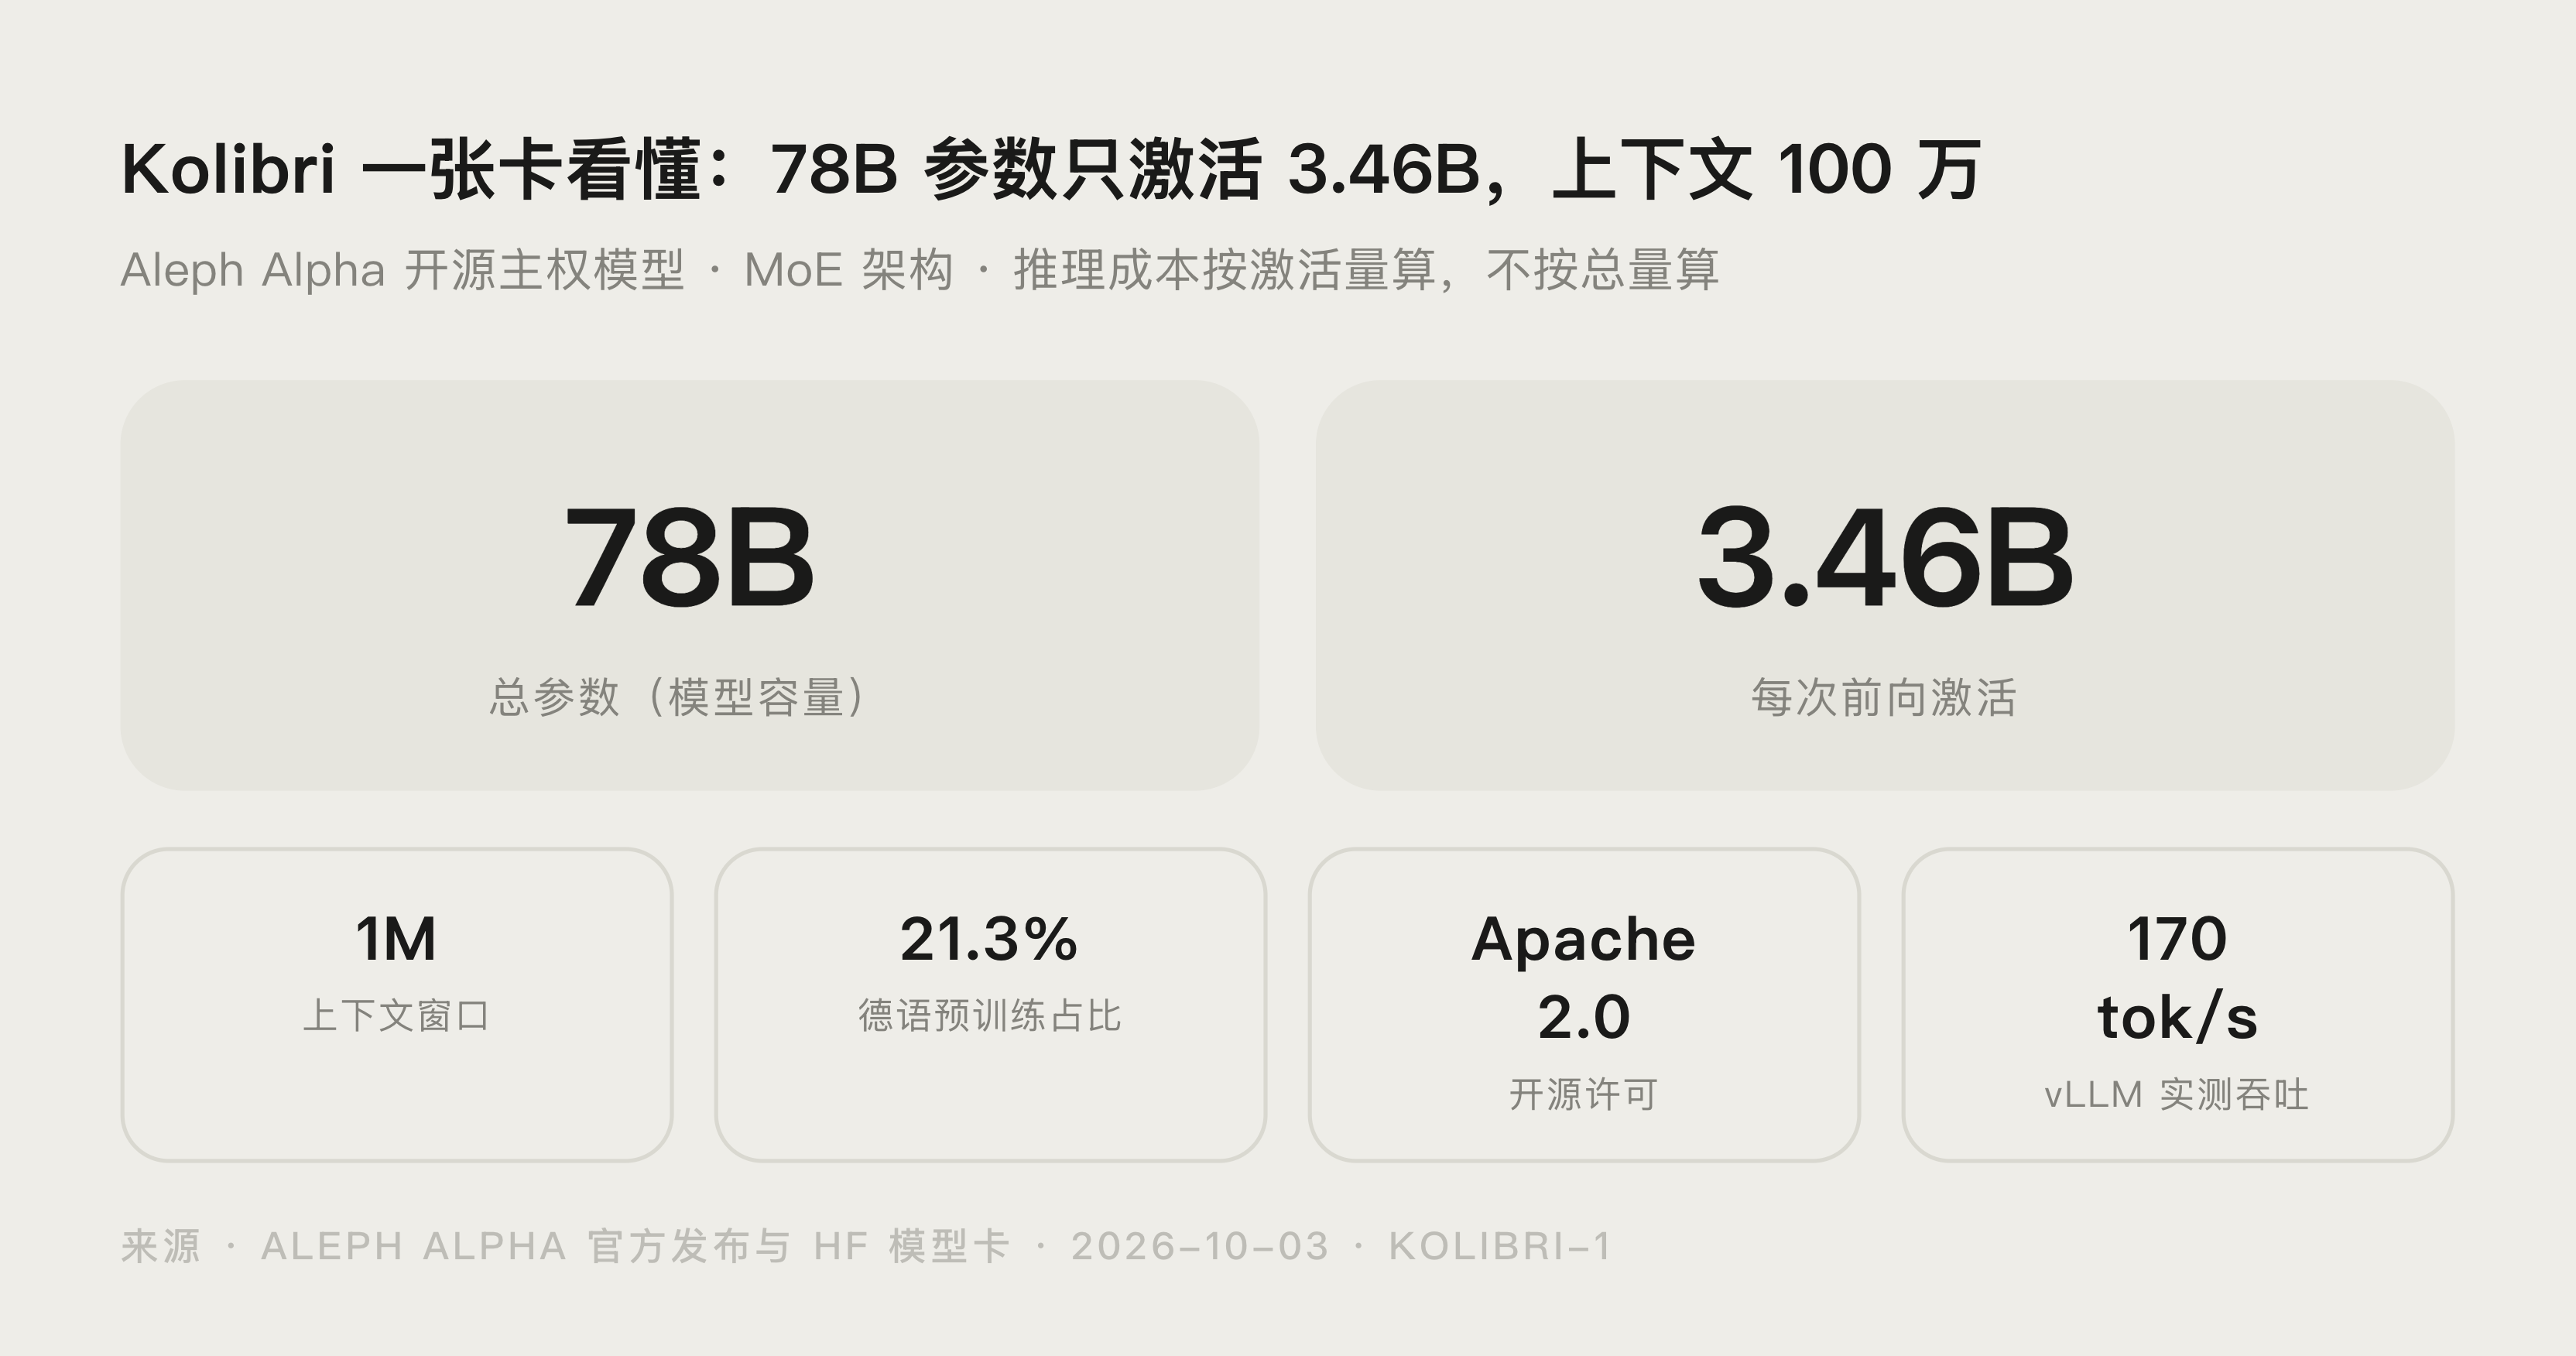
Kolibri 是德国 AI 实验室 Aleph Alpha 开源的一个英德双语 MoE 大模型:总参数约 78B,但推理时只激活 3.46B,上下文窗口拉到 100 万 token,权重以 Apache 2.0 开放。它的卖点很聚焦,就是把「长上下文」和「推理效率」两项放进同一模型,同时从预训练阶段就按欧盟合规规则设计。
先分清一件事:此 Kolibri 是模型,别和同样叫法相近的「colibri 推理引擎」「Colibri 教育 LMS」混淆(见下方同名辨析)。想看怎么跑起来,站内已有《Kolibri 本地部署教程》(/ai-guide/kolibri-local-deployment-tutorial),本文只讲它是什么。
Kolibri 是谁:德国 Aleph Alpha 的开源一步
Aleph Alpha 是德国著名 AI 实验室,做主权 AI(sovereign AI)方向,一直把「欧洲本土可控」当作卖点。Kolibri 就是在「开源 + 长上下文 + 合规」这条线上的一次发货:除法国 Mistral 外,它被认为是欧盟范围内第一批达到这一性能水平的通用模型之一(材料用词是「可能」),发布后在 Hacker News 上两天拿下 400+ 赞。对不想把数据载出欧盟或德国本地的团队来说,Apache 2.0 权重可下载、可自托管、可商用,是个可选坐标。
三个关键数字,普通开发者怎么理解
- 78B 总参数 / 3.46B 激活:这是 MoE 架构。78B 是模型总容量,每次前向只调用约 3.46B,推理成本按激活量算、不按总量算,所以长上下文不在它跑不快。
- 100 万 token 上下文:能一次性「吃下」长文档、大代码库、多轮长对话,这是长上下文涉主攻击点。
- 21.3% 德语预训练 token:它专门做了德语/英语双语分词器,并在训练全程喂德语数据。德语在这模型里被当一等公民,对德企场景的中文用户/第三方工具很友好,但中文并非它的主攻,中文做产品要谨慎评估。
核心能力:长上下文、显式推理、工具调用、自托管
- 显式推理模式(explicit reasoning)与工具调用:官方口径面向推理和效率优化,能做多步推理并调用工具。
- Apache 2.0:权重可下载、可自研、可商用、可改,限制少。
- 合规内置:从底层设计就考虑欧盟 AI 法案、通用 AI 行为准则和 GDPR(版权法单列为重点),合规不是发布后补的。发布与参数也可见网易报道(https://www.163.com/dy/article/L8C6RJAM05561FZF.html)。权重完整在 HuggingFace Aleph-Alpha/Kolibri-1 开放下载,官方口径以 Aleph Alpha 官网为准。
和 Mistral、GLM 的定位区别
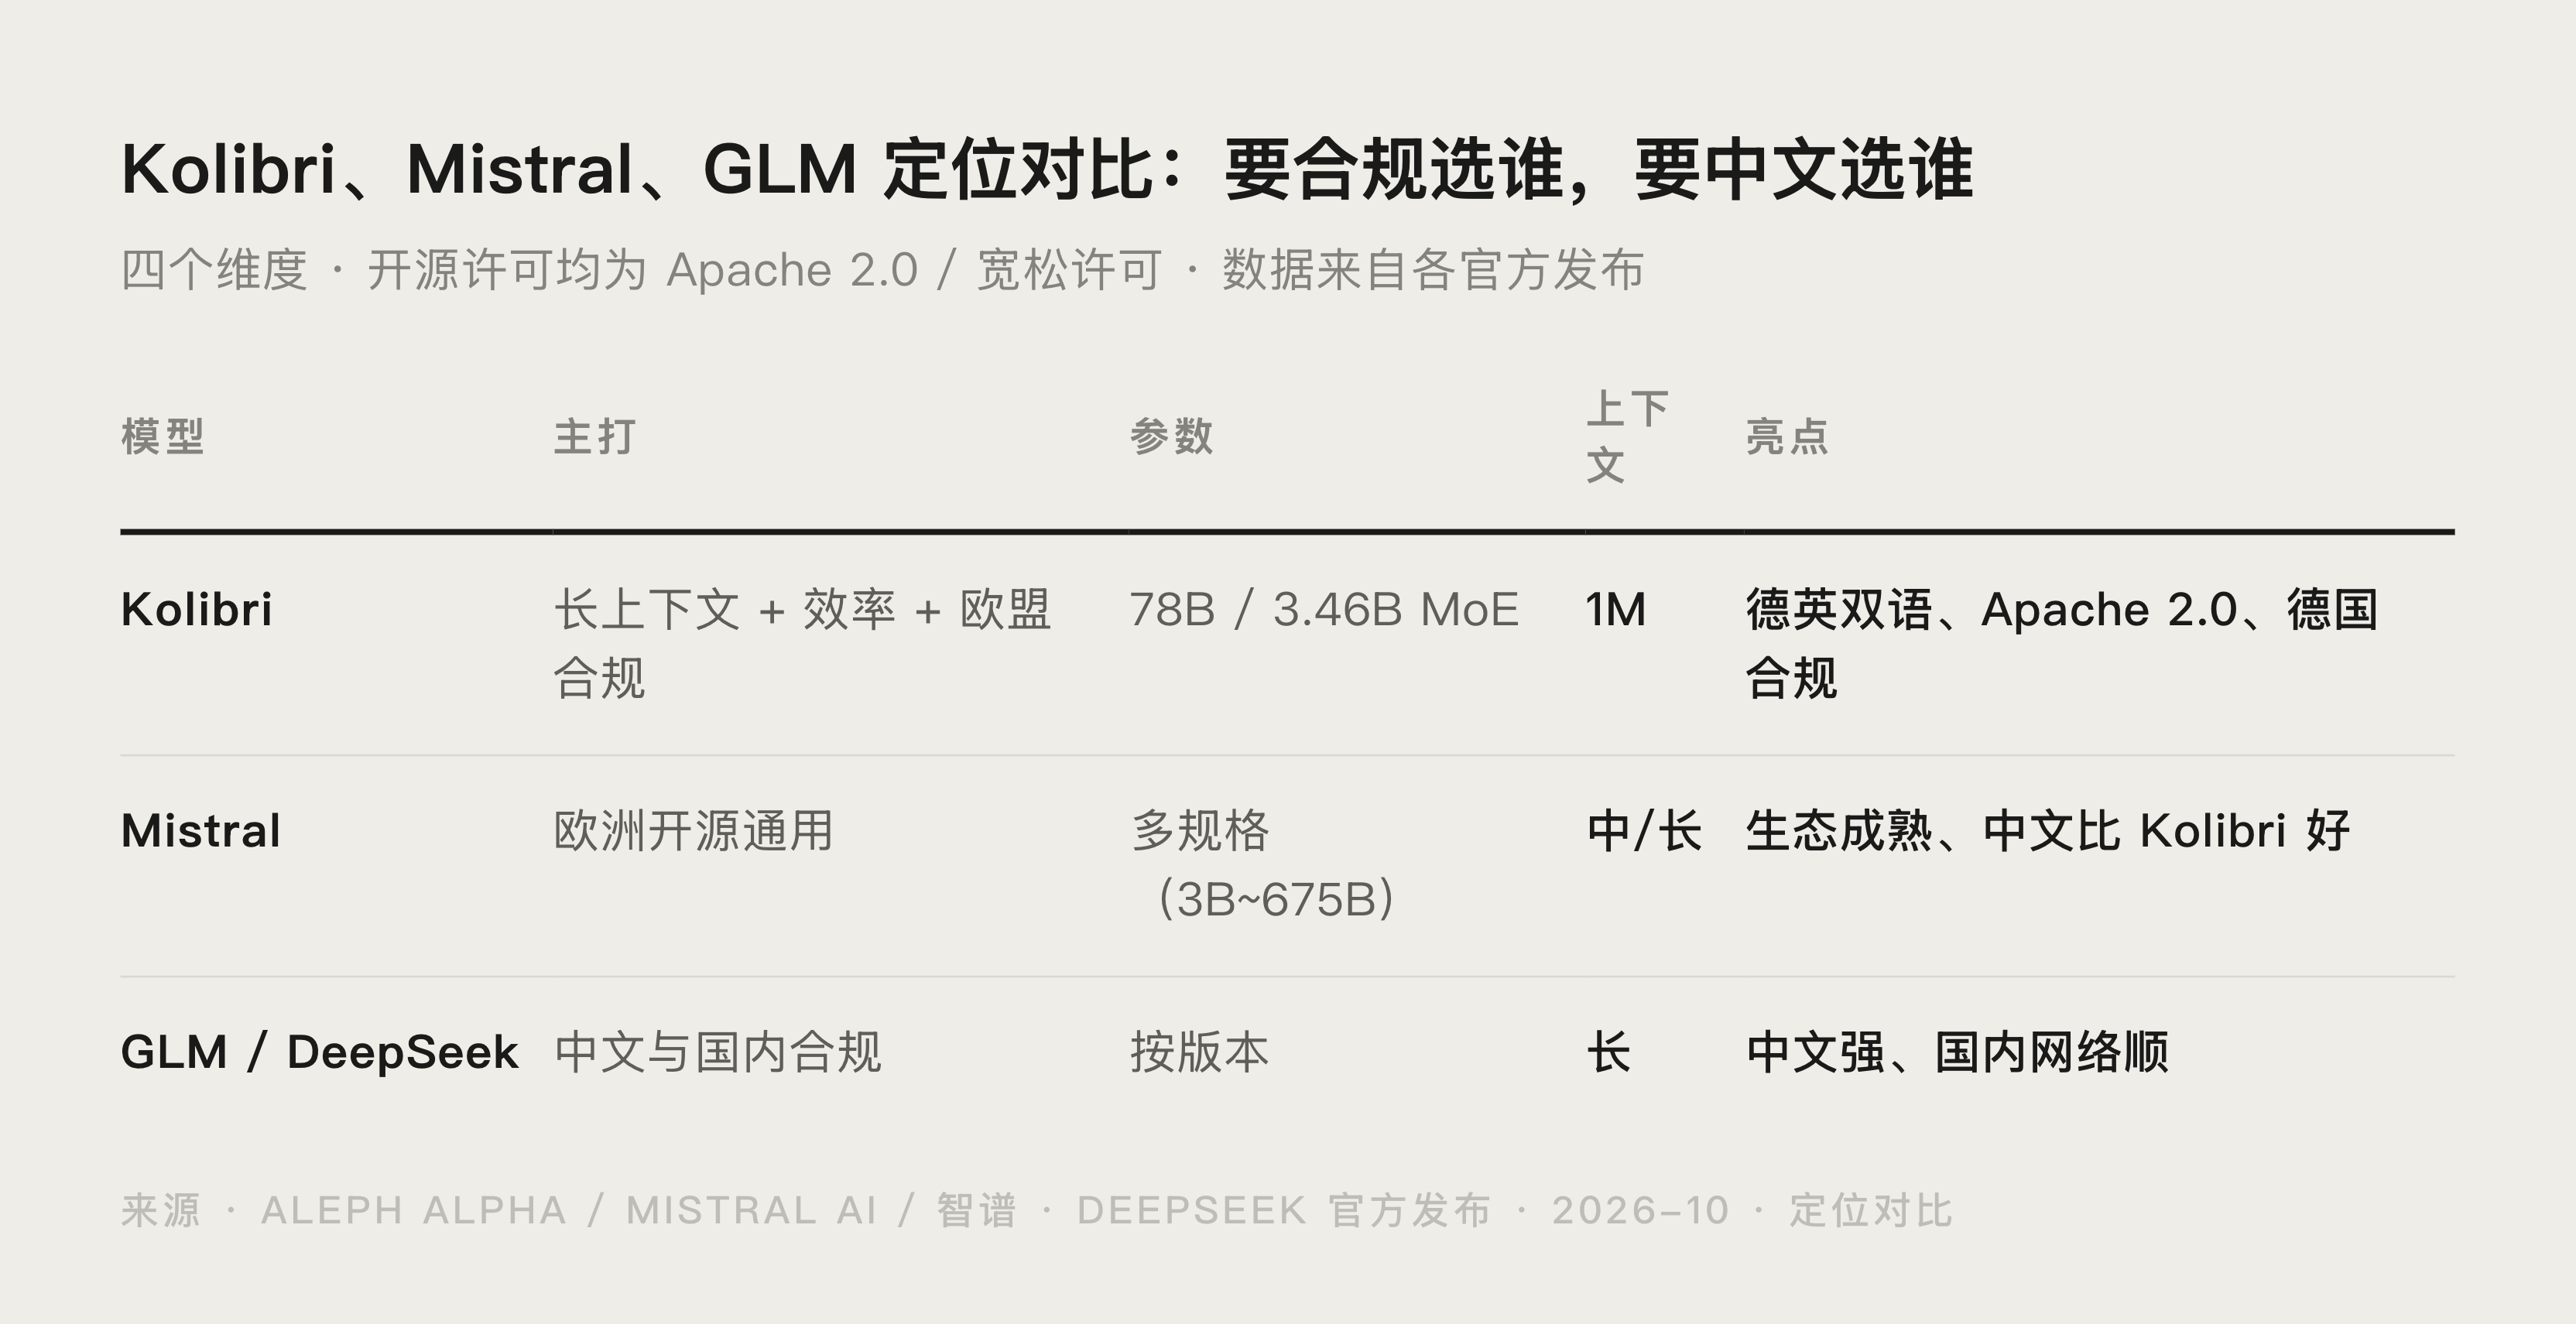
| 模型 | 主打 | 参数/激活 | 上下文 | 亮点 |
|---|---|---|---|---|
| Aleph Alpha Kolibri | 长上下文 + 效率 + 欧盟合规 | 78B / 3.46B MoE | 1M | 德语/英语、Apache 2.0、德国合规 |
| Mistral | 欧洲开源通用 | 多规格(3B~675B) | 中/长 | Apache 2.0、多语言生态、中文比 Kolibri 好 |
| GLM / DeepSeek | 中文/国内合规 | 按版本 | 长 | 中文强、网络顺 |
如果你既想开源、又要中文好,Mistral 或 GLM 更顺手;如果「长上下文 + 德语/欧盟合规 + 本地自托管」是刚需,Kolibri 更有针对性。想先理清 MoE 与稠密模型的差异,可看站内 MoE 是什么;对开源与闭源该选哪套有困惑,参考 开源模型和闭源模型怎么选。
普通用户能用它做什么(不跑部署也能判断)
- 长文档/法律、合同、报告问答:100 万上下文能整本读;结合工具调用做多步查证。
- 多语言客服/本地部署:德语、英语含量高,适合欧洲语种行业;中文要自己实测。
- 研究与实验:Apache 2.0,权重自己控,适合在线用不了外网的项目。真要跑起来,配置与踩坑见站内 Kolibri 本地部署教程:78B 参数 MoE 模型要什么配置。
同名易混源:别找错货
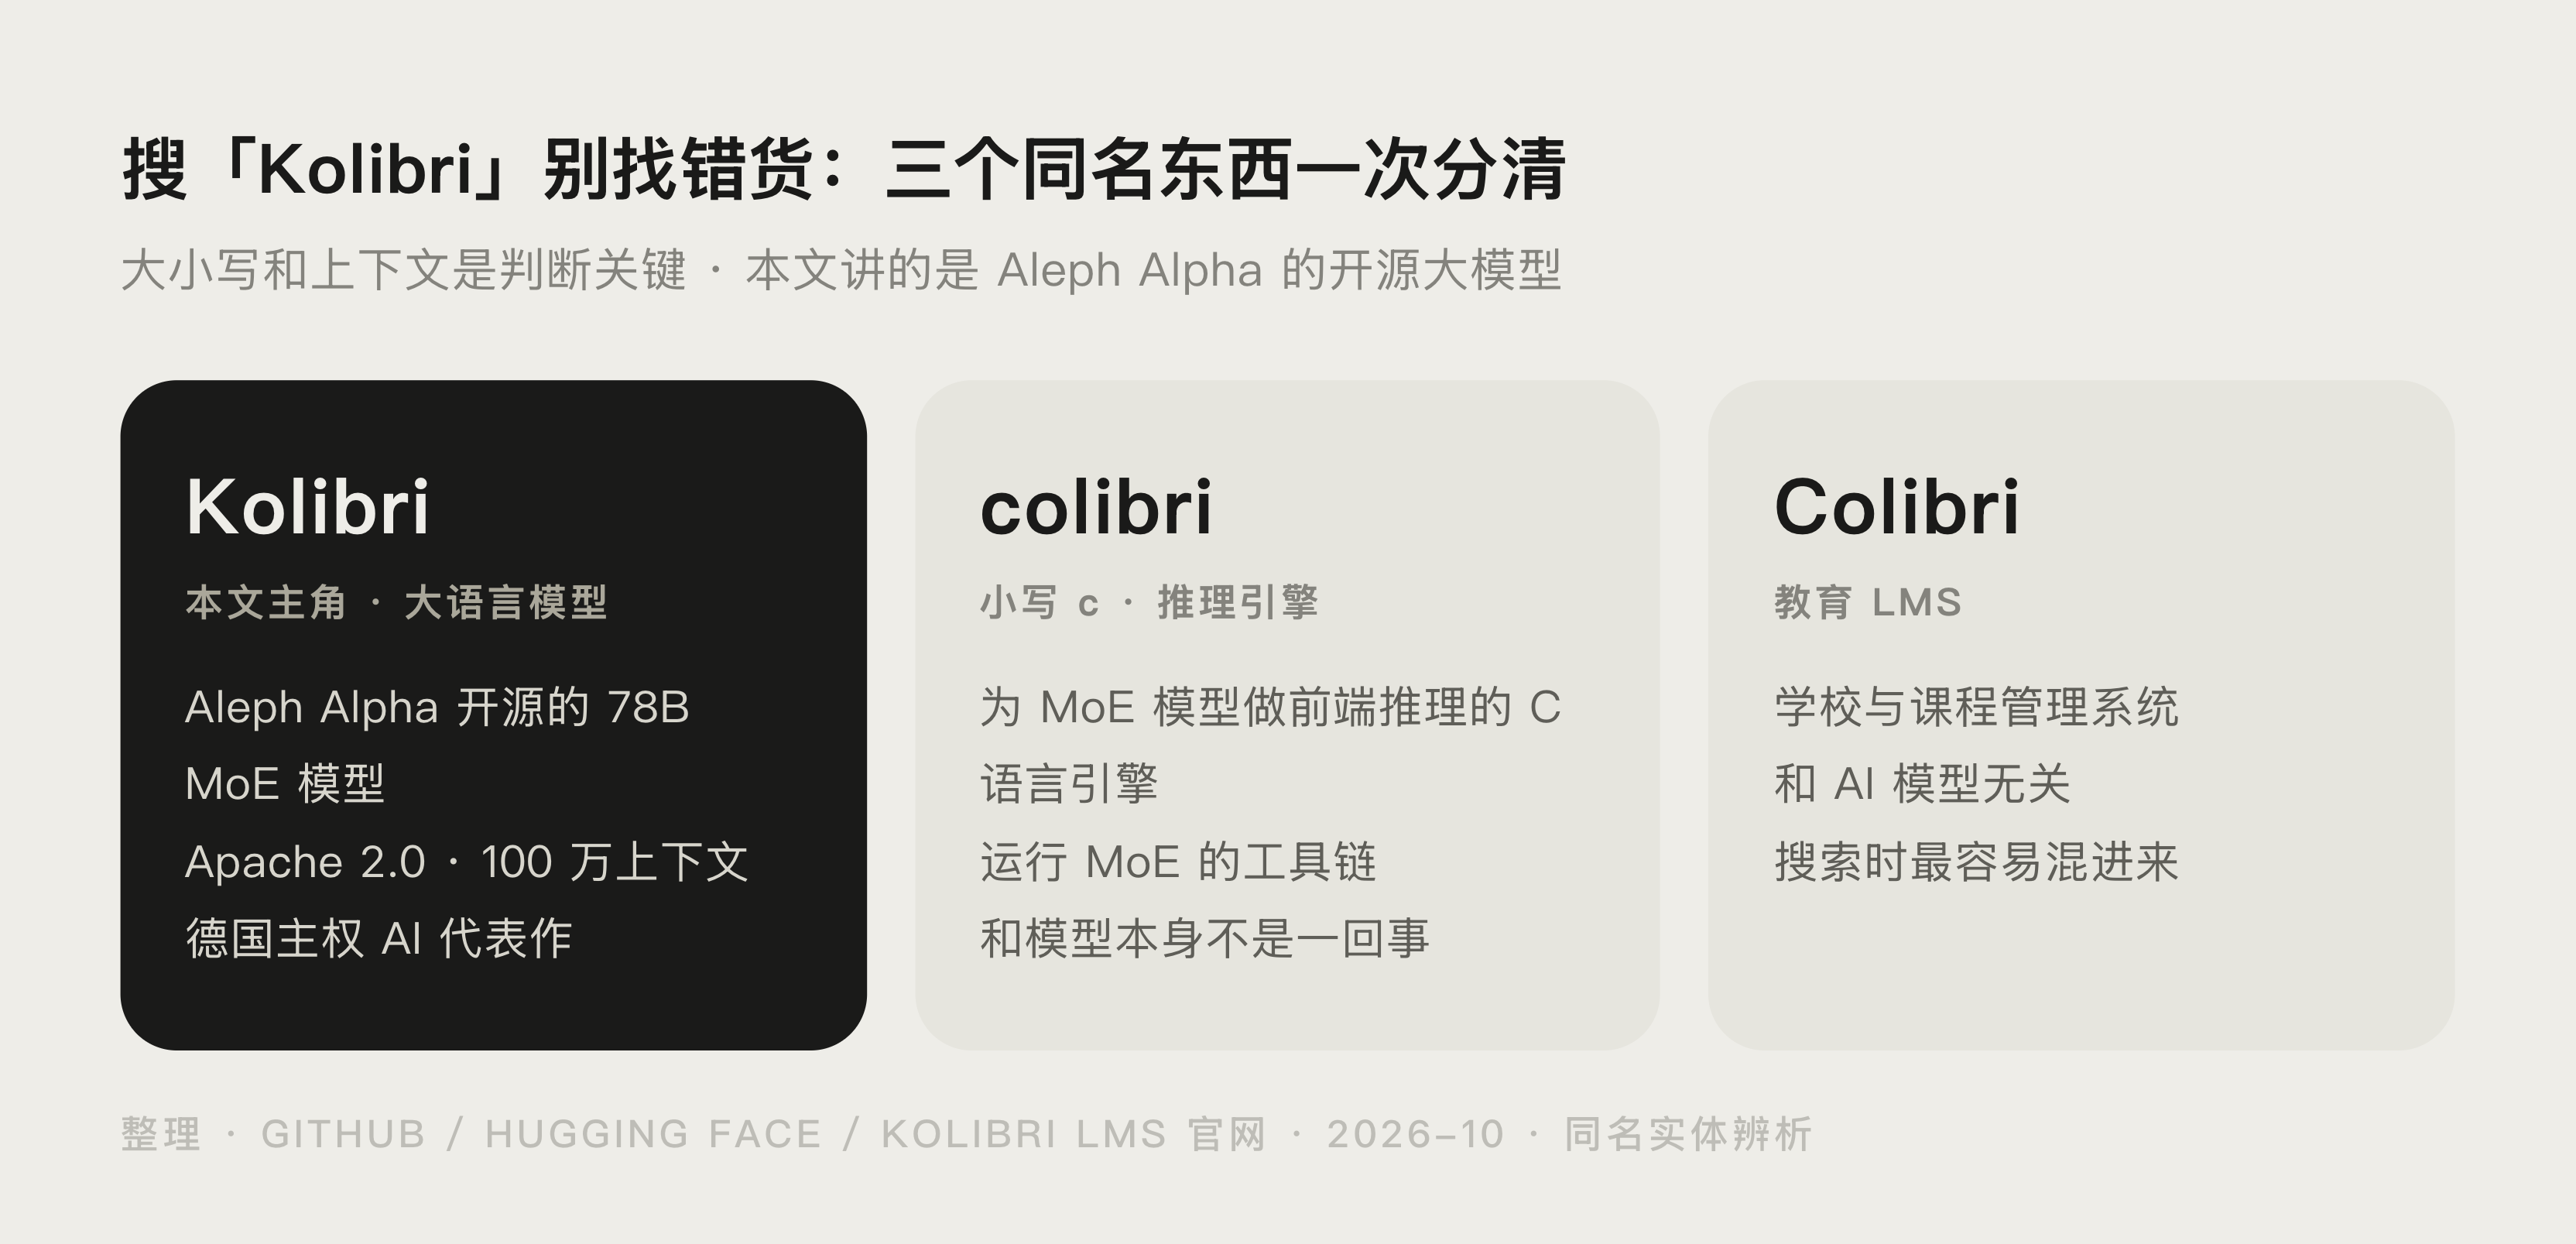
「Kolibri(模型)」容易搜到同名项目,需要区分:
| 名称 | 是什么 | 关联 |
|---|---|---|
| Aleph Alpha Kolibri(本文) | 78B MoE 德国开源大语言模型 | Apache 2.0、长上下文 |
| colibri(推理引擎) | 为 MoE 模型做前端推理的 C 语言引擎 | 运行 MoE 的工具链 |
| Colibri(教育 LMS) | 学校/课程管理系统 | 和 AI 模型无关 |
(部署细节、硬件要求见站内 Kolibri 本地部署教程。)
常见问题
Kolibri 是免费的吗?能不能商用?
答:模型权重以 Apache 2.0 开源发布,可在自己的硬件上跑,可商用,限制很少。具体命令与硬件要求见站内部署教程。
Kolibri 中文能力强不强?
答:它是德语/英语双语模型,18 个模型预训中德语 token 占比 21.3%,对中文做词建议先实测。要做中文产品或强中文家族,优先考虑 Mistral/GLM/DeepSeek。
为什么说它对欧盟合规友好?
答:它在训练和 Repo 就从底层设计考虑欧盟 AI 法案、通用 AI 行为准则与 GDPR,版权法务列为工作重点,属于「训练前就内置约束」而非事后声明。
要什么配置才能跑?
答:78B 总参数的模型就算激活只用 3.46B,本地也要规划显存。具体配置、部署步骤和踩坑见站内 Kolibri 本地部署教程,本文不带部署步骤。
Kolibri 和 colibri、Colibri 是不是同一个项目?
答:不是。Kolibri(Aleph Alpha)是开源大语言模型;colibri(小写 c)是给 MoE 模型的 C 推理引擎;Colibri 是教育 LMS。命名相近,容易搜混淆。
 京ICP备2024094994号-29