
MoE 是什么?图解大模型参数多却便宜的专家混合
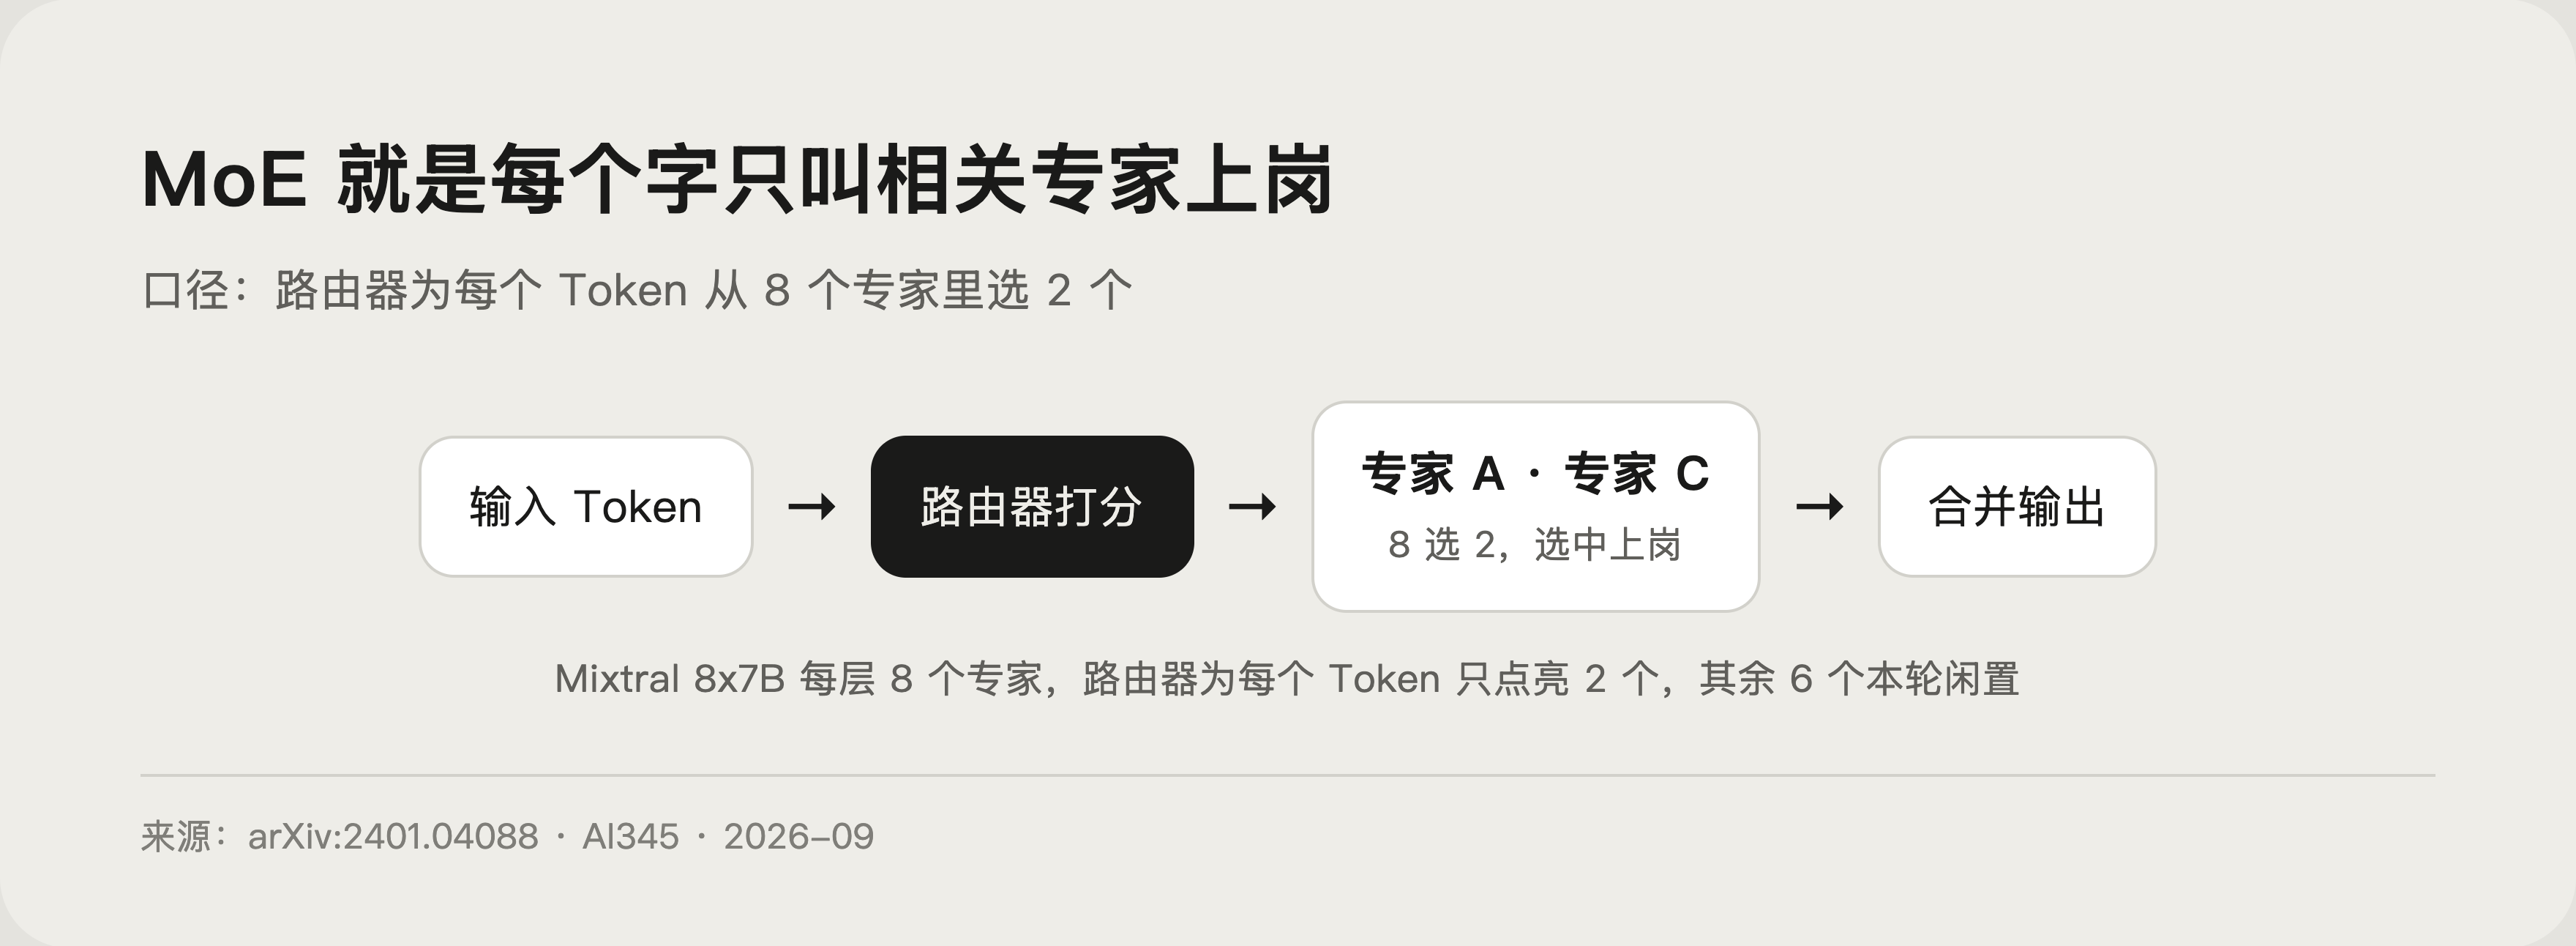
MoE(Mixture of Experts,专家混合)是一种「不全班上阵,只叫相关专家」的大模型架构:总参数可以做得非常大,但每个字推理时真正用到的参数只是一小部分,所以能力上限高、单次推理成本还能压下来。它和稠密模型相对,稠密就是每个词都动用全部参数。
比喻主线:一家会分诊的医院
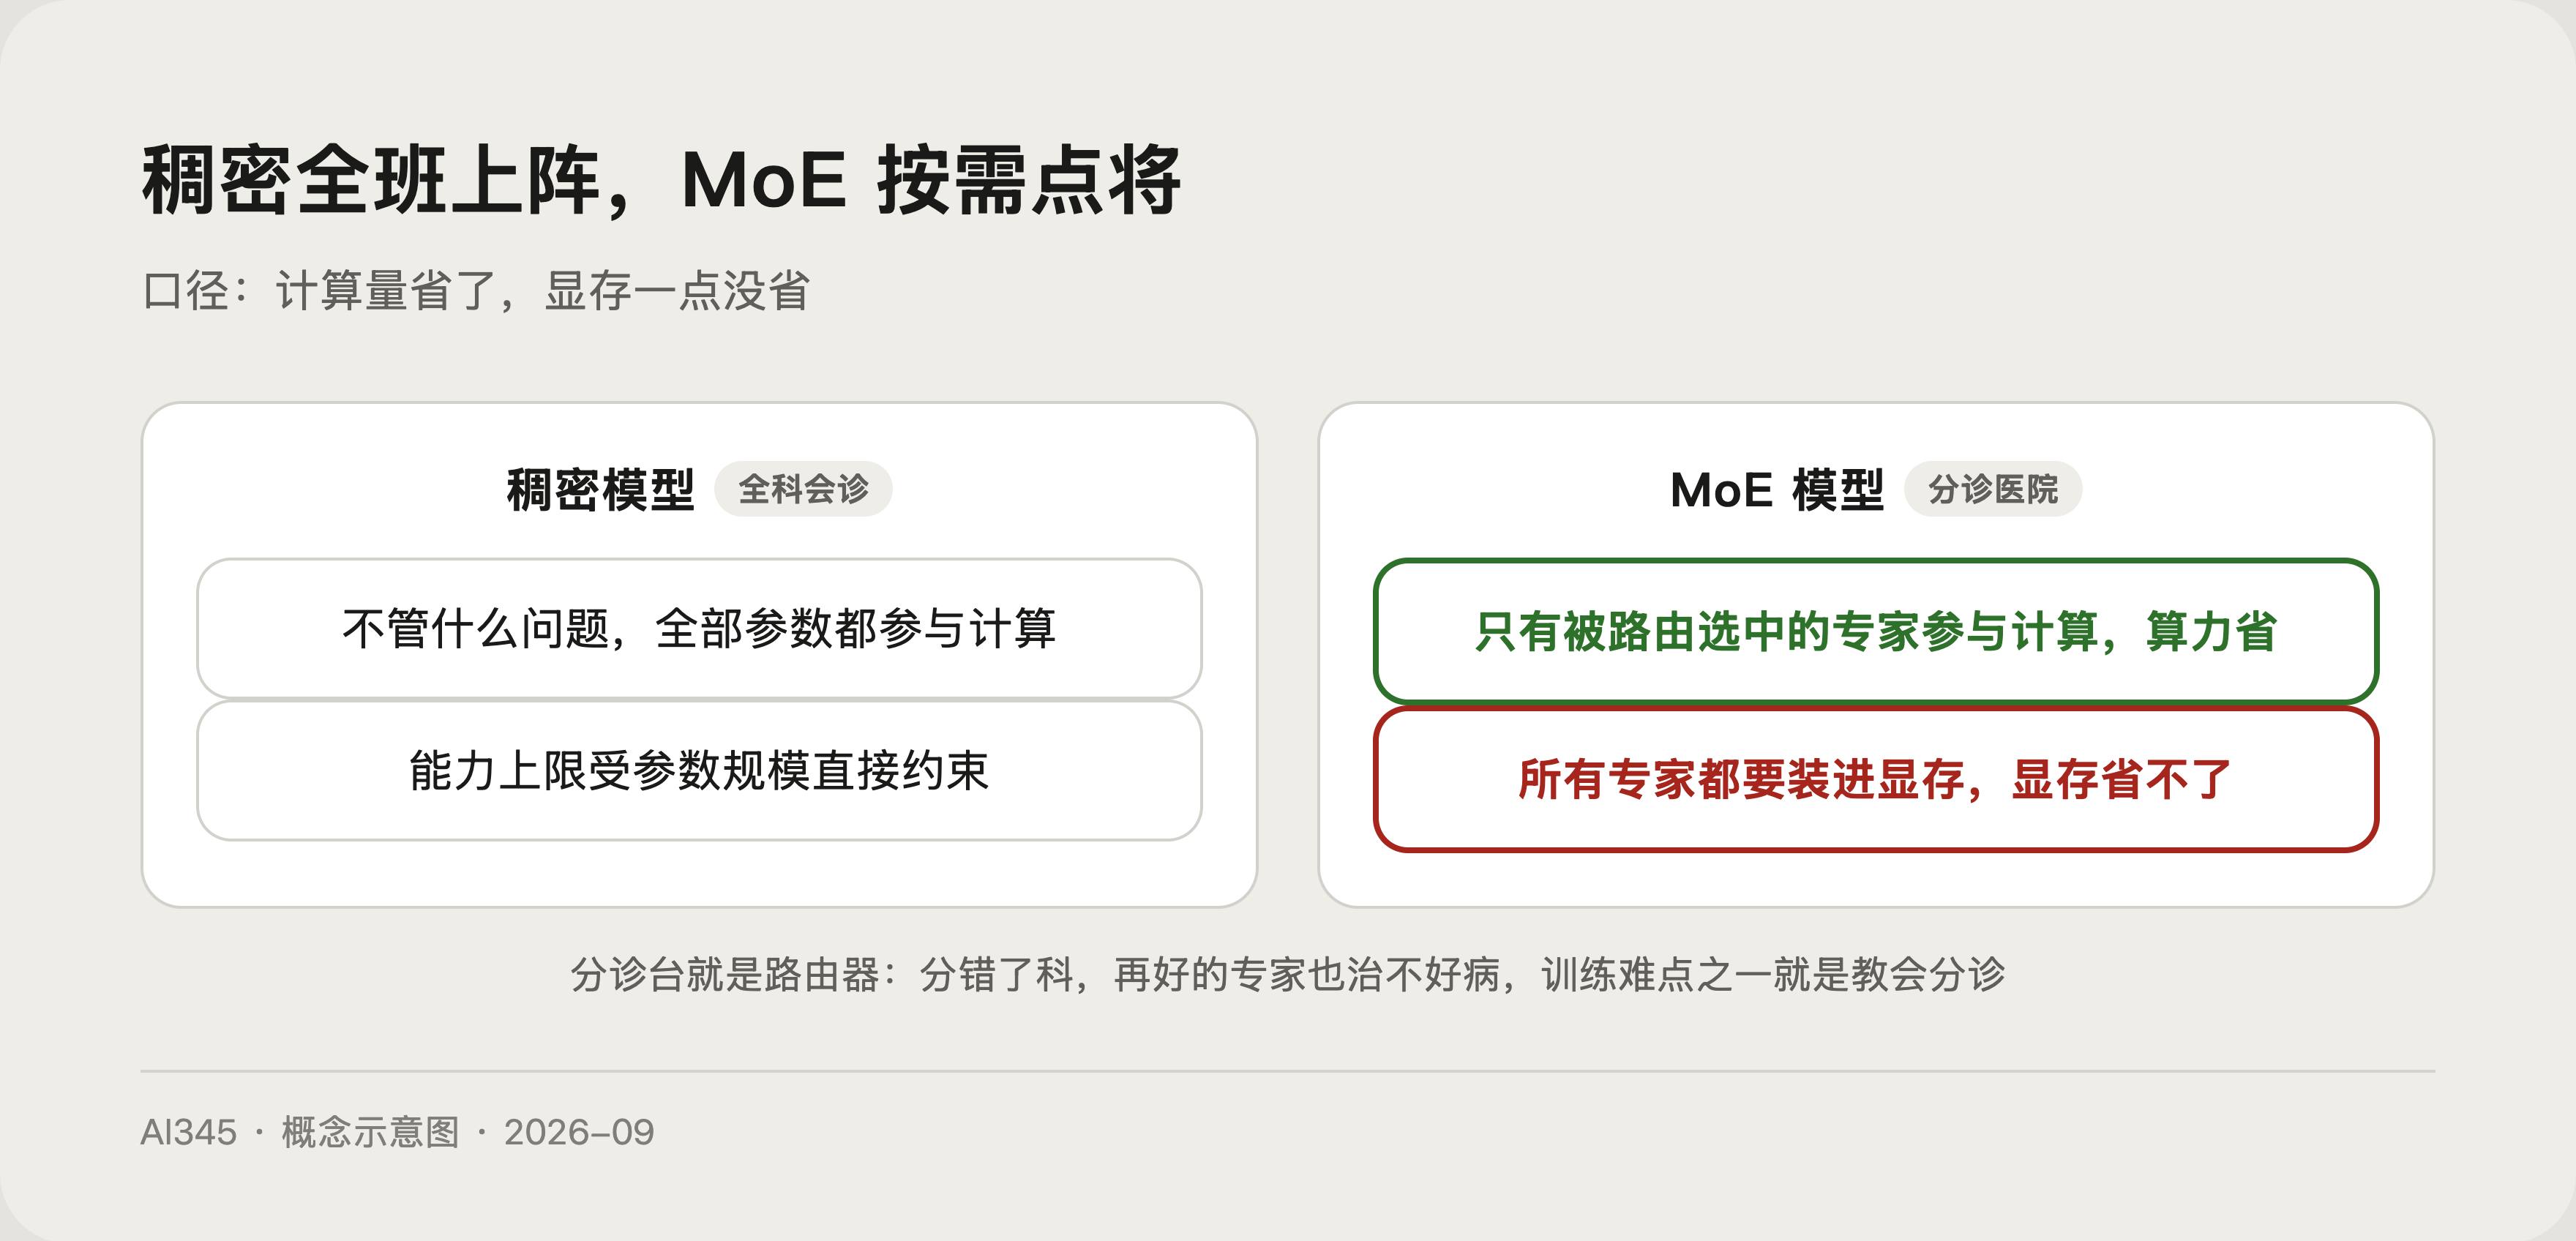
普通稠密大语言模型像一家「全科会诊医院」:不管你是感冒还是骨折,全院医生都来给你会诊一遍,人人体格好,但浪费严重。
MoE 模型像一家「分诊医院」:你一进门,分诊台看一眼症状,把你指给最对口的两位专科医生。医院里养着一整栋楼的专家(参数全都在),但每个病人只占用其中两三位的时间。养专家花的是房租(显存),看诊省的是医生的时间(算力)。分诊台的水平就是路由器的能力:分错了科,再好的专家也治不好病,所以 MoE 的训练难点之一,就是把分诊教会。
Mixtral 实测:47B 参数只激活 13B
MoE 最常被引用的实证是 2024 年 1 月 Mistral AI 发布的 Mixtral 8x7B 论文:模型每一层有 8 个专家(8 份前馈网络),一个路由网络为每个 Token 挑出 2 个专家处理,再把输出合并。路由这件事每个词、每一层都要做一次,不同词选中的专家可以完全不同。
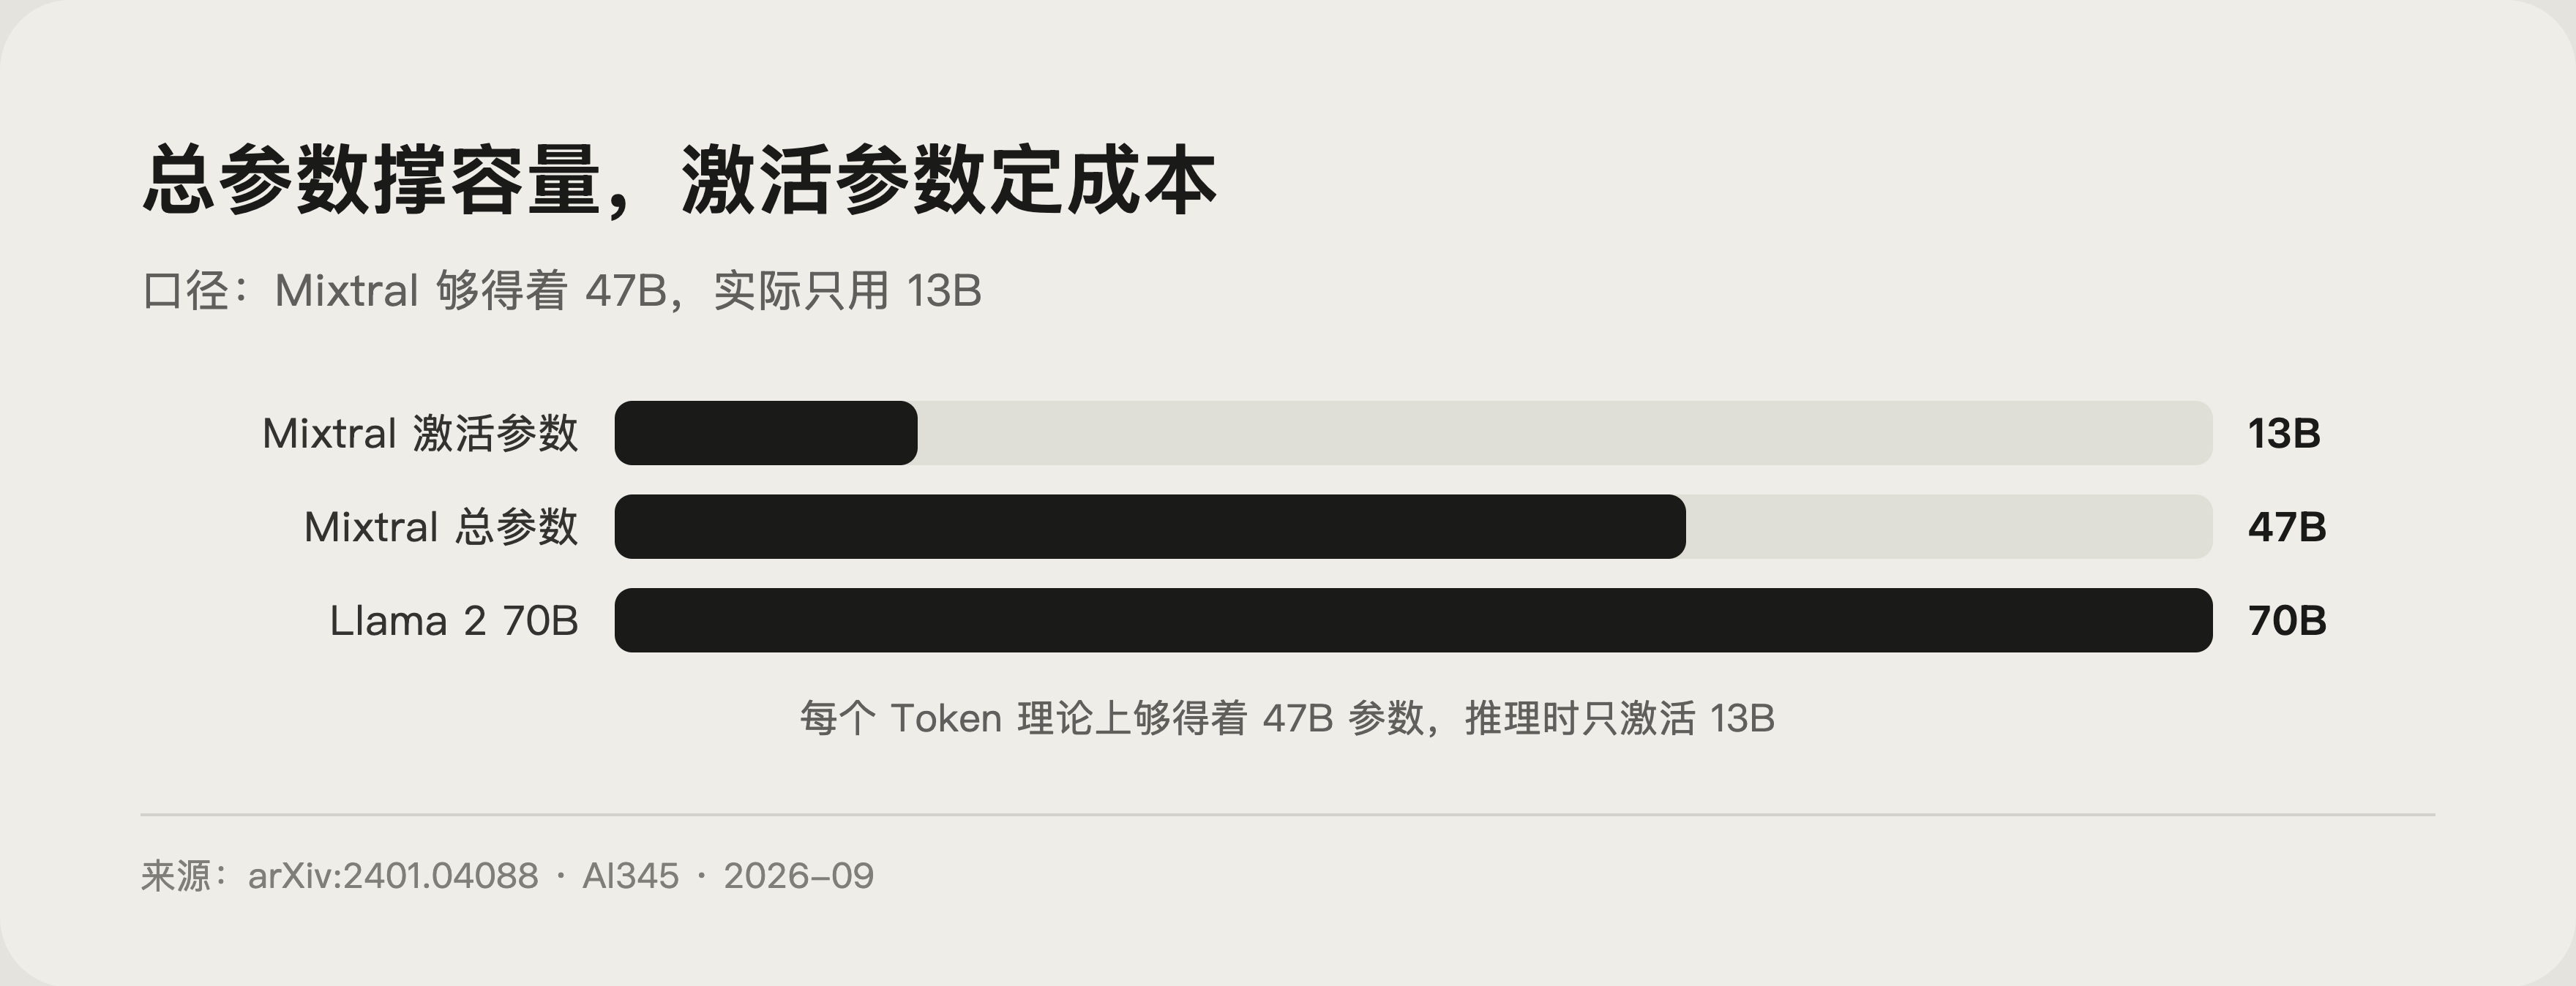
结果是:每个 Token 理论上「够得着」47B 参数,但推理时只激活 13B。论文报告它在数学、代码生成和多语言基准上超过或比肩 Llama 2 70B 与 GPT-3.5,并以 Apache 2.0 协议开源,官方公告见 Mistral 博客。
为什么 MoE 能让推理更便宜
- 每个词只算一小部分参数:推理计算量取决于激活参数而不是总参数,13B 的激活量只相当于一个中型稠密模型。
- 容量放在「库存」里:47B 总参数像仓库,撑起更大的知识容量,但取用是按需的。
- 同等效果账单更低:相对同能力的稠密模型,MoE 用更少的计算拿到接近的效果,这也是很多大模型产品敢把 API 价格打下来的架构底气之一。
想算清这笔账,需要先分清总参数和激活参数,具体可以看我们讲模型参数量的那篇。
MoE 不是免费午餐:显存和训练都不省
- 显存省不了:所有专家都要装进显存,47B 的模型占的就是 47B 级别的显存,本地部署门槛反而更高。
- 训练更讲究:路由器和专家一起训练,要靠负载均衡约束,否则所有 Token 涌向少数热门专家,其他专家「闲死」,容量就浪费了。
- 微调和量化工具链相对复杂:开源生态对稠密模型的支持通常更成熟,MoE 模型的部署选项更挑剔。
为什么不干脆把小模型做大
有人会问:既然推理时只激活 13B,为什么不直接用 13B 的稠密模型?差别在「知识容量」。13B 稠密模型从头到尾只有 13B 参数的记忆容量;Mixtral 虽然每次只用 13B 的算力,但 47B 的总参数都可能被路由到,等于用小模型的电费,维持着大模型的藏书量。
这也解释了 MoE 在业界的地位:它不是「便宜货」,而是「贵但划算」,前置投入(显存、训练)更高,换来的是单位 token 的推理成本更低。选型时如果你的流量大、问答密集,这个划算才有意义;流量小、偶发调用,直接用小模型可能更实惠。
一段话讲清 MoE
「MoE 是专家混合架构:把模型里的前馈层复制成多份专家,再加一个路由器,每个 Token 只激活其中两三个专家。效果是总参数量可以很大、知识容量高,但推理时每个词只用到一小部分参数,算力成本接近小模型。代表是 Mistral 的 Mixtral 8x7B,总参数 47B、每 Token 只激活 13B。代价是显存占用不降,训练要处理专家负载均衡。」
如果被追问「MoE 和稠密模型怎么选」,可以答:显存充足、追求上限选 MoE;部署资源紧张、任务简单,稠密小模型更省心。顺带能带出架构背景:MoE 模块插在 Transformer 的前馈层位置,底座还是那套注意力机制。
常见问题
MoE 模型的参数量看总数还是激活数?
答:两个都看。总参数代表知识容量上限,激活参数决定推理速度和单次成本,对比模型时最好同时报两个数。
MoE 和小模型怎么选?
答:显存充足、任务复杂、追求更强能力,选 MoE;设备或预算受限、任务简单,小模型更省心。
路由器是怎么学会分诊的?
答:路由器和专家一起端到端训练,训练中用负载均衡损失约束,避免 Token 都涌向同一个专家。
哪些知名模型用了 MoE?
答:Mixtral 8x7B 是最常被引用的开源代表;GPT-4 是否采用 MoE 官方从未证实,属于广泛流传的猜测;国内多款万亿参数级模型也公开采用 MoE 路线。
MoE 模型微调更难吗?
答:相对更复杂。要考虑路由是否稳定、专家是否均衡,微调数据和显存需求也更挑剔,建议用成熟框架。
 京ICP备2024094994号-29