
模型参数量是什么?7B 到万亿参数 3 分钟讲透差距
模型参数量就是模型里可学习数字的总个数,7B 是 70 亿个,70B 是 700 亿个。参数量决定模型的知识容量上限,但不直接等于能力,这是这篇要讲透的核心,也是最常被追问的细节。
参数是什么:模型里有多少个旋钮
把模型想象成一台巨大的调音台,上面有几十亿个旋钮,每个旋钮的当前位置共同决定这台机器的行为。参数就是旋钮的个数:旋钮越多,理论上能调出的「声音」越丰富。不过一台调音台能演奏的音乐类型有上限,曲子好不好听,还要看调音的人(训练方法)和乐谱(数据)质量。
在 Transformer 架构里,参数主要集中在两个地方:注意力层负责「该看哪里」,前馈层负责「记住什么知识」,后者的参数通常占大头。
权重是什么:每个旋钮上的刻度
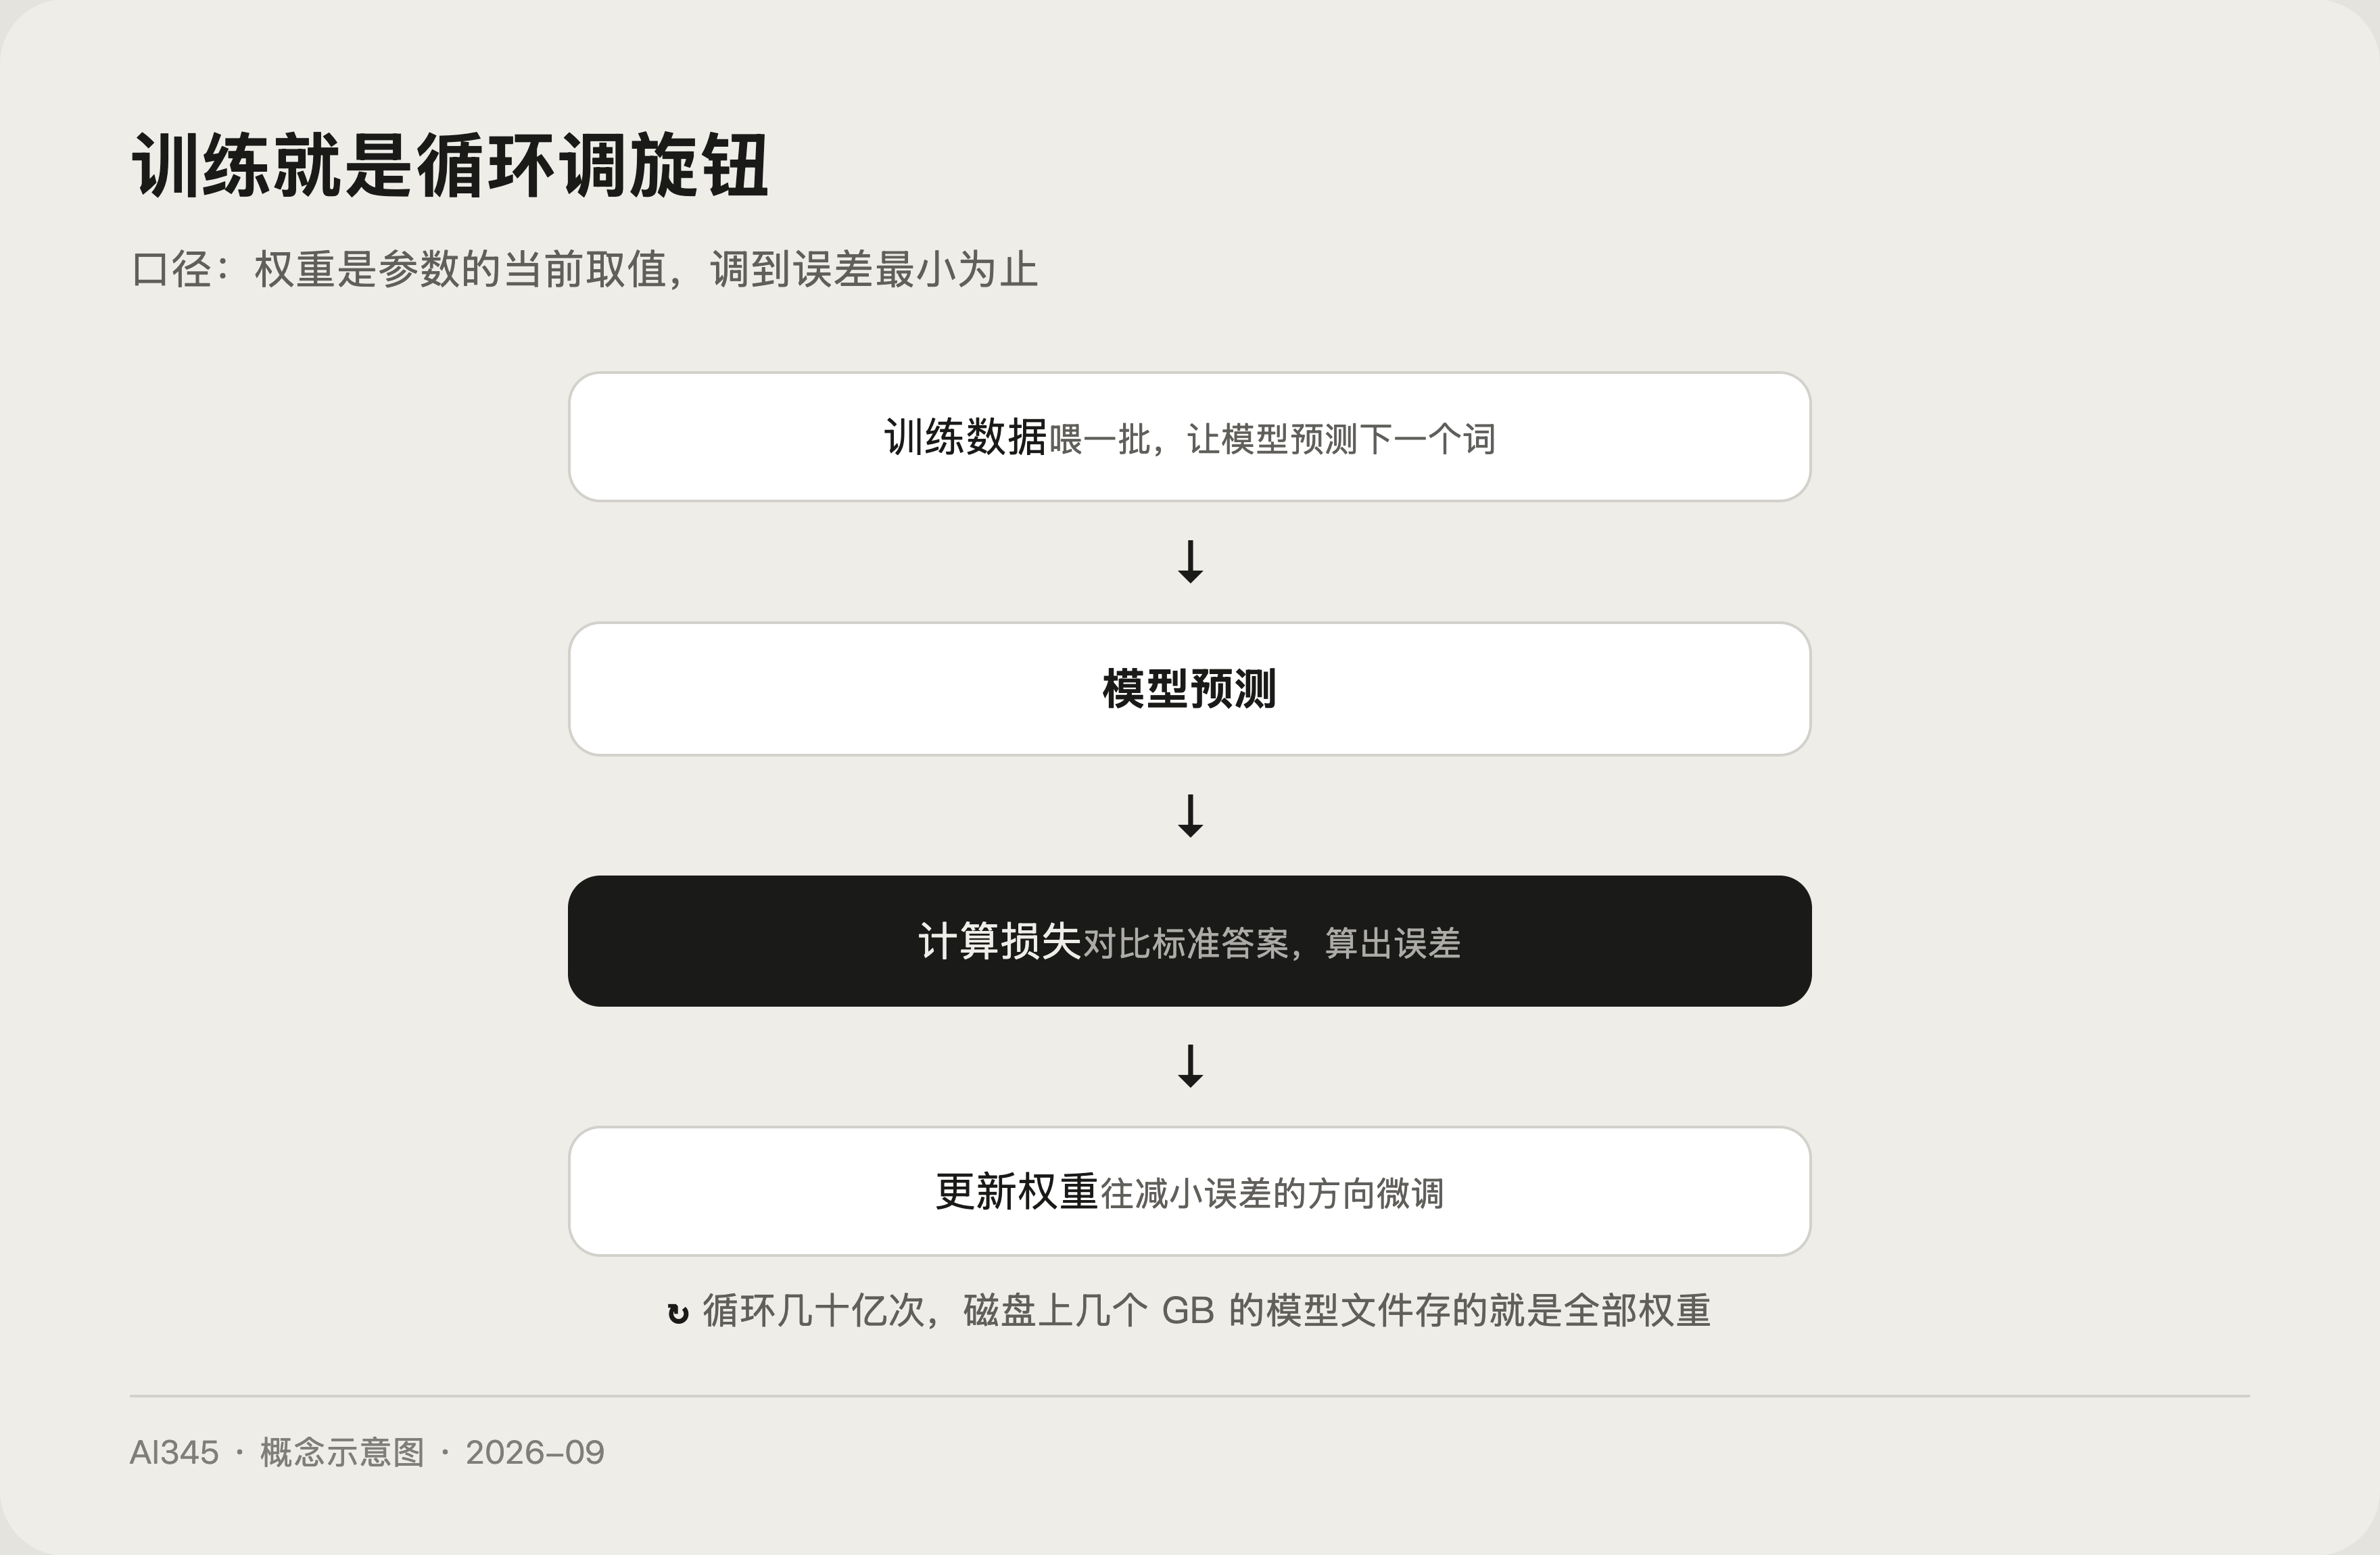
参数的「当前刻度」叫权重(Weight)。训练就是调旋钮的过程:
- 喂一批数据,让模型预测下一个词。
- 对比标准答案,算出误差。
- 往减小误差的方向微调所有旋钮,循环几十亿次。
训练结束后,磁盘上那个几个 GB 到几百 GB 的模型文件,存的就是全部权重数值。所谓「下载开源模型」,下载的就是这套权重;想在通用模型上改出领域专用版本,就是微调要干的事。
7B、70B、万亿参数差在哪
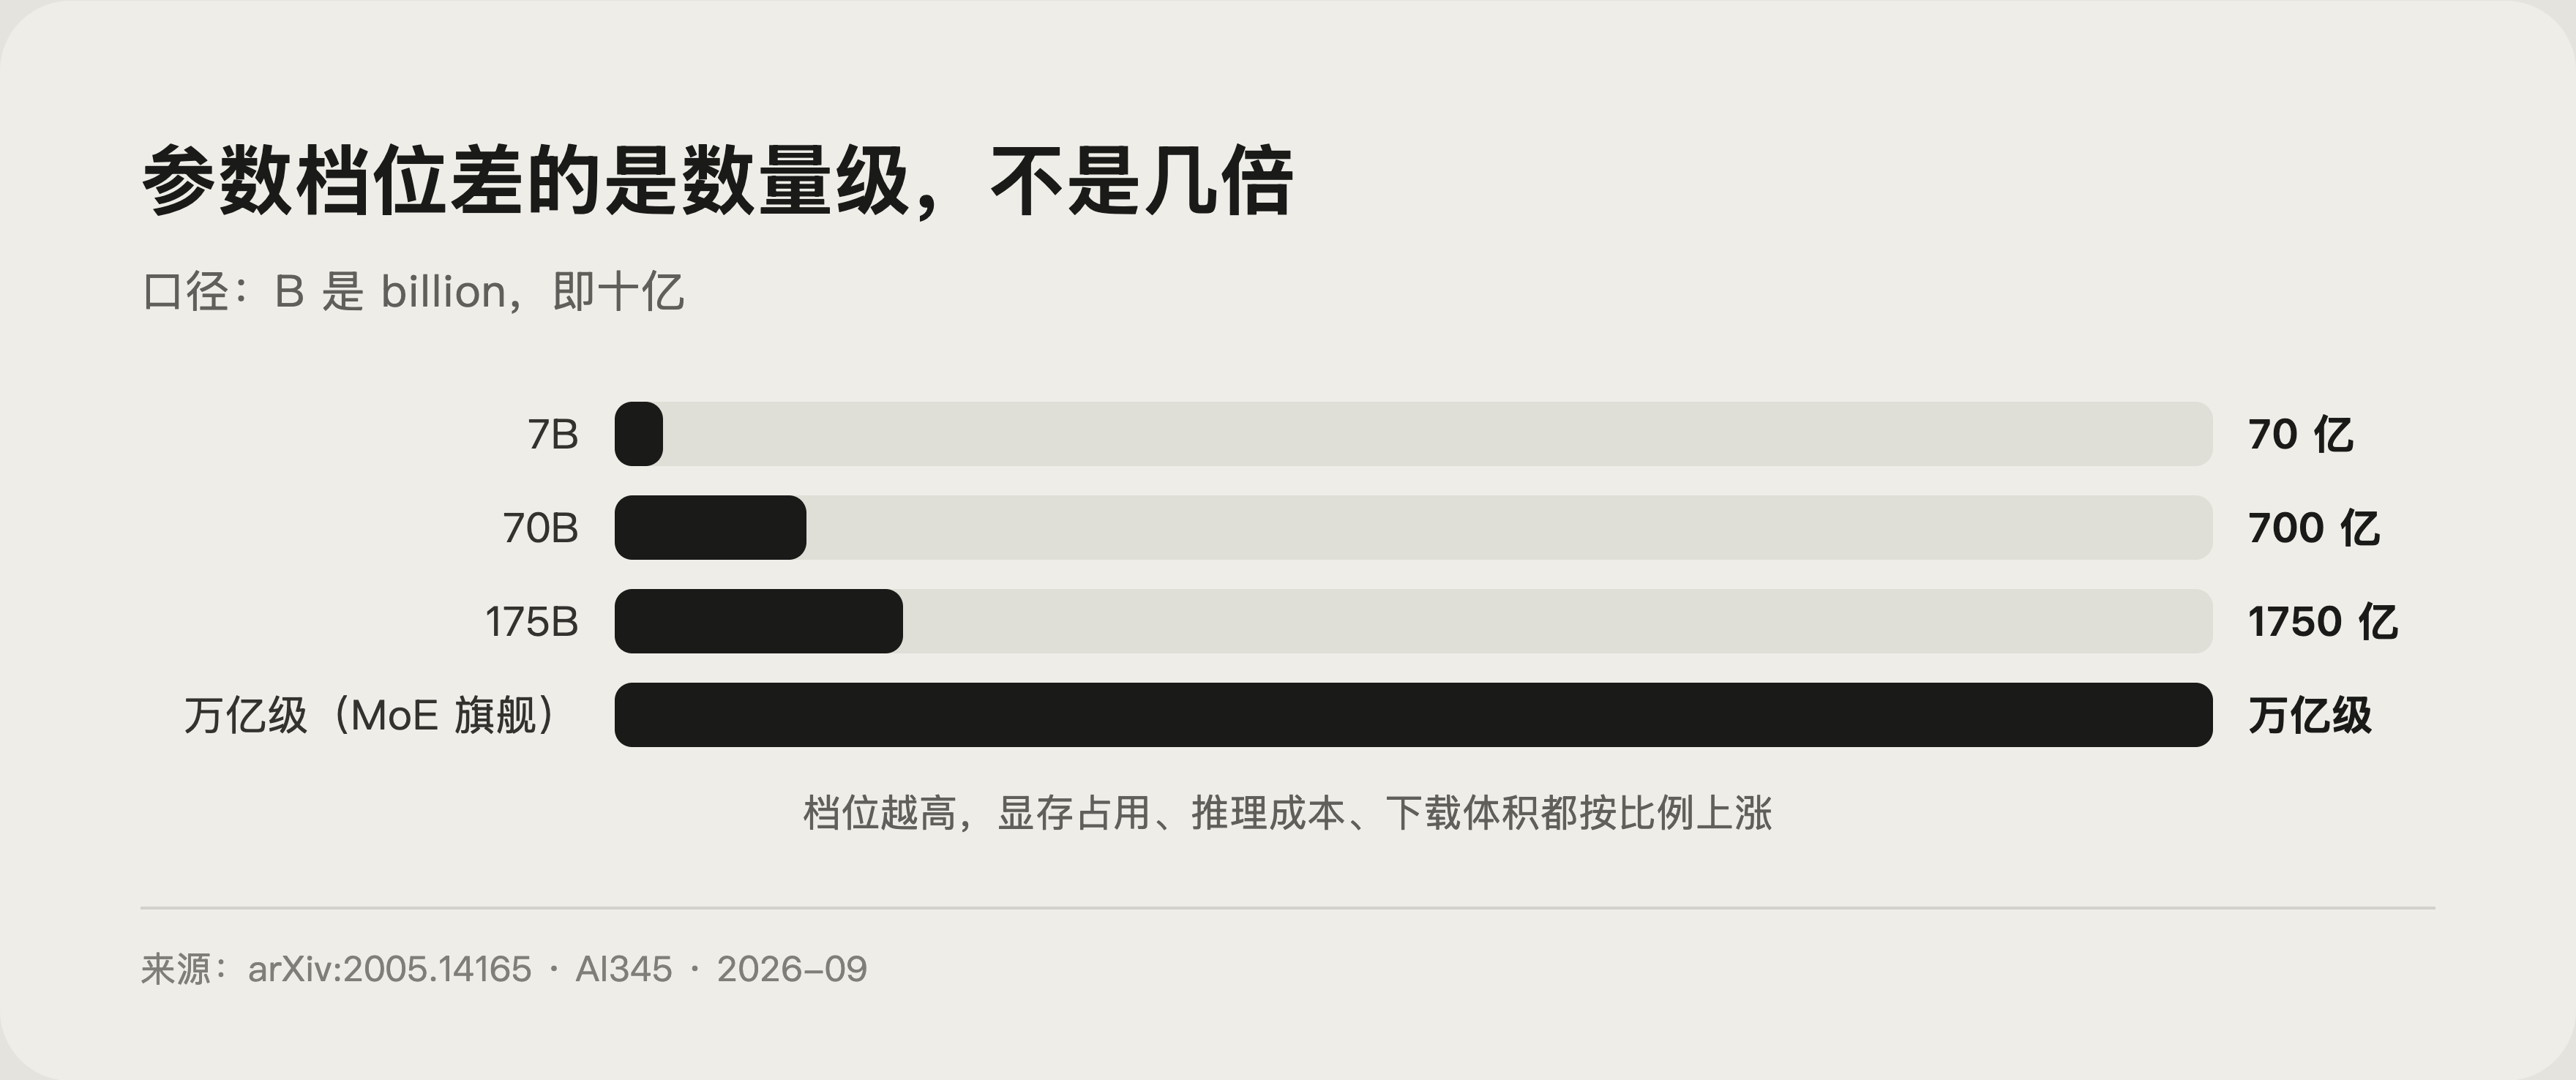
这三个档位不是 2 倍 3 倍的差距,而是数量级的差距,能力、成本、部署方式都完全不同:
- 7B 级:笔记本或高端手机有希望跑起来,适合摘要、改写这类轻任务。
- 70B 级:需要高端显卡或多卡部署,能力明显更强,是开源模型的主力档位。
- 千亿到万亿级:基本是 MoE 架构的旗舰,总参数巨大但按需激活。
注意 B 是 billion(十亿)。参数每上一个台阶,显存占用、推理成本、下载体积都按比例涨,这也是端侧小模型成为独立赛道的原因。
参数量和能力的真实关系
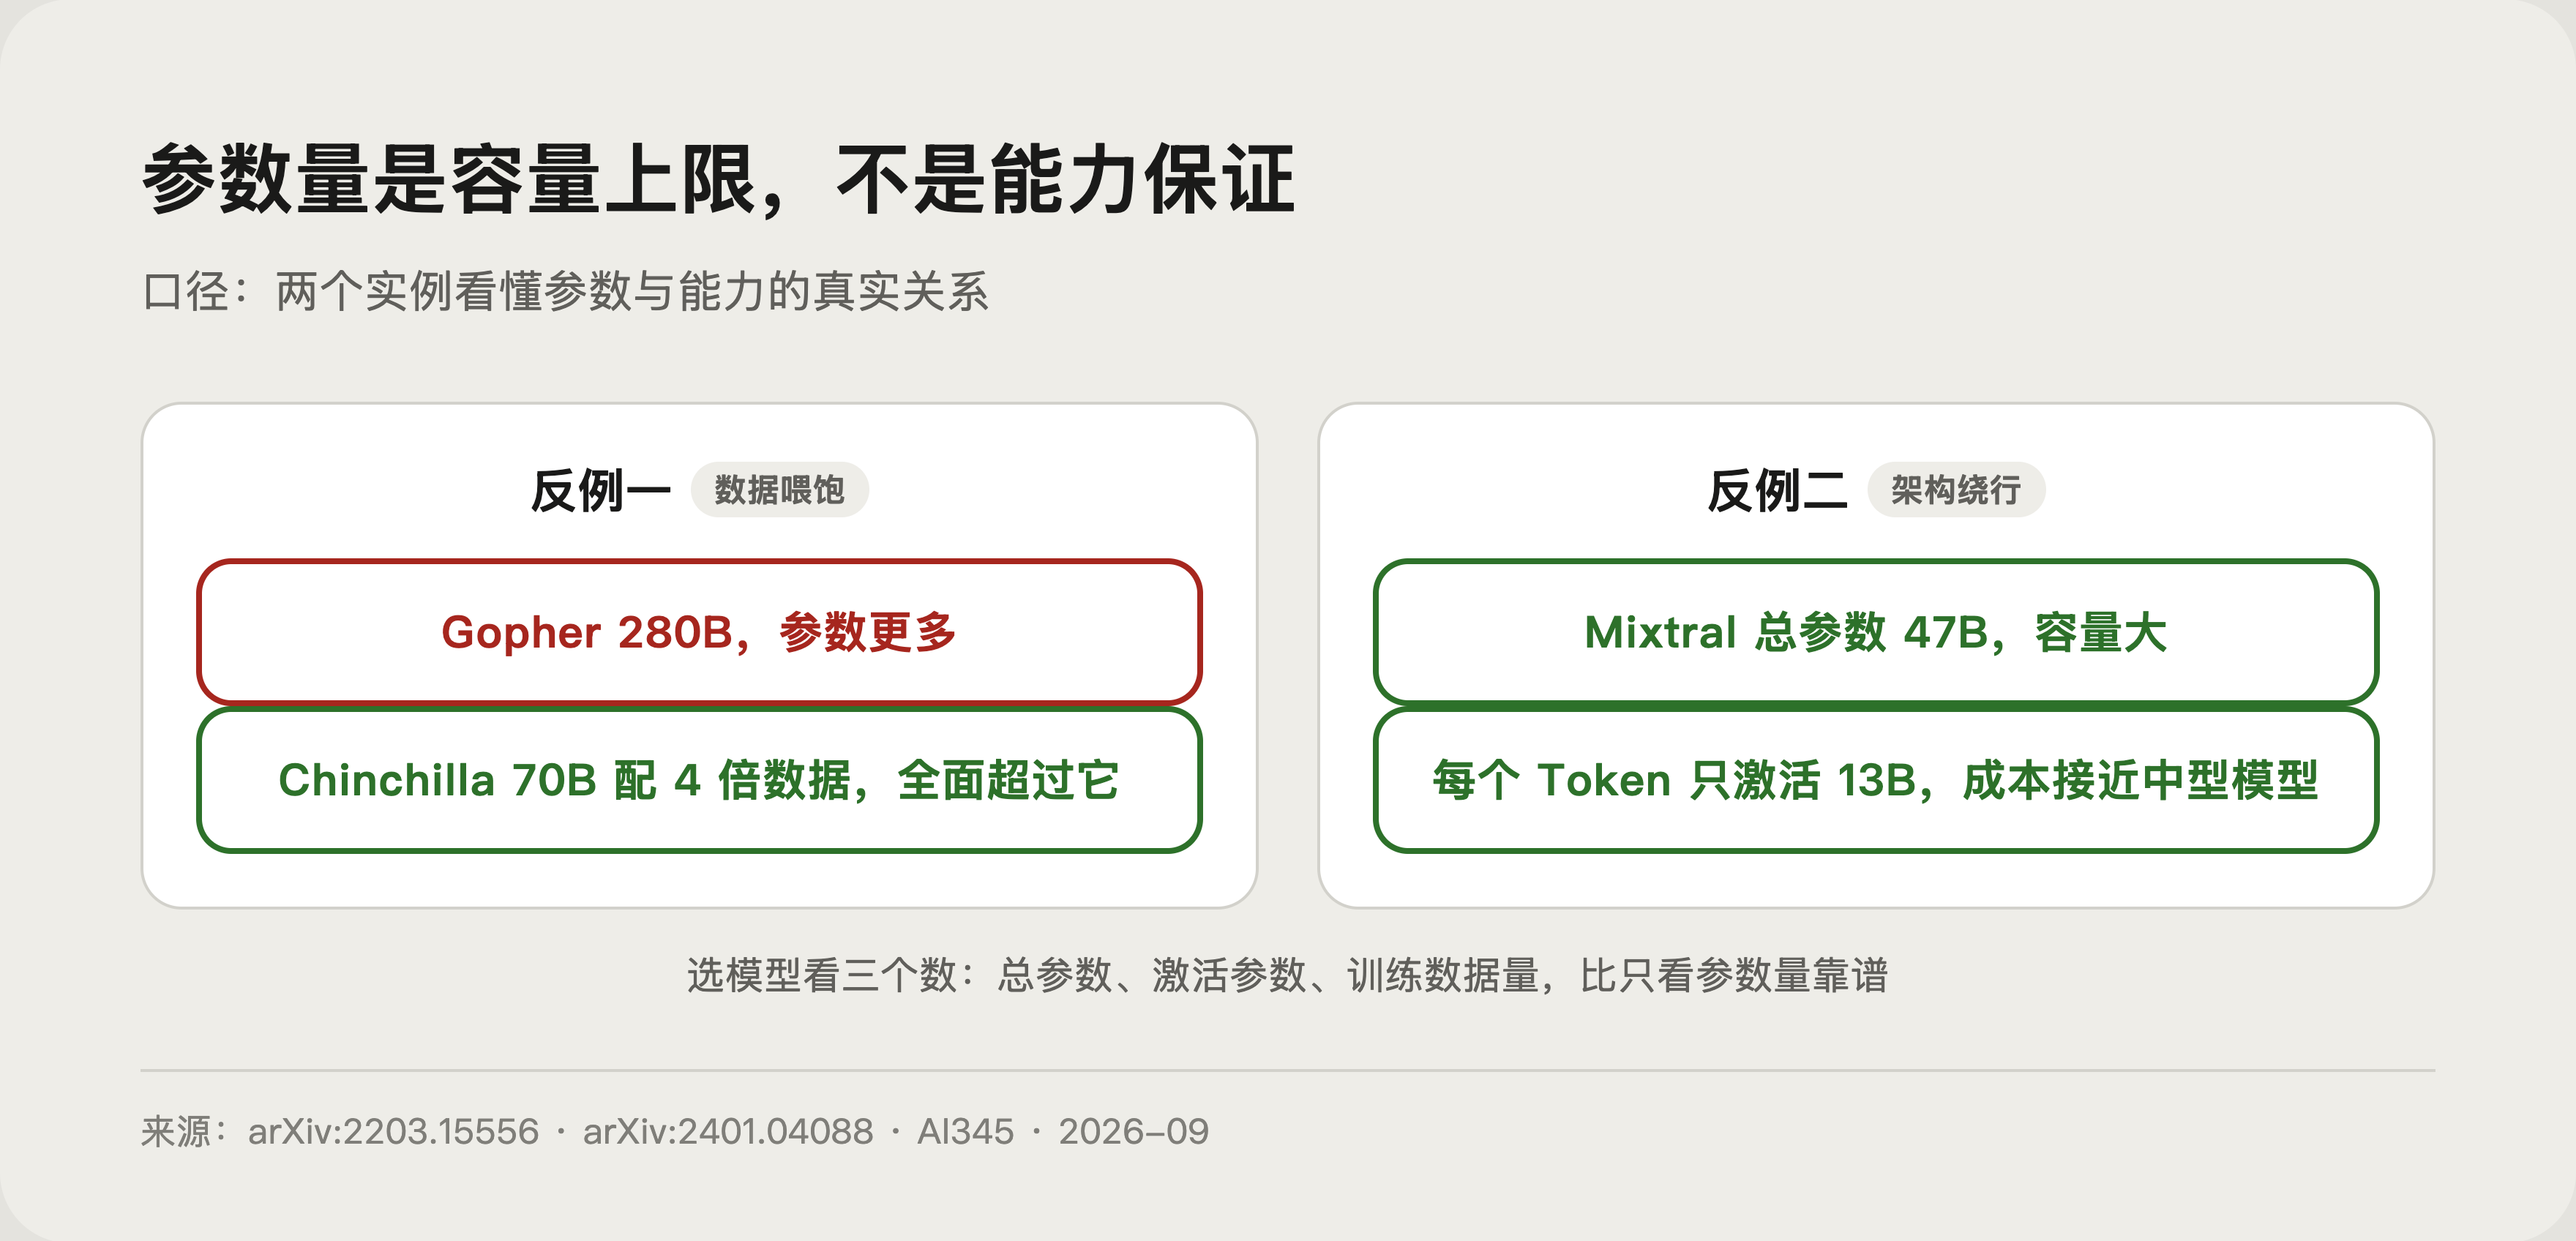
参数量是容量的必要条件,不是能力的充分条件,三个已核实的实例帮你看清:
- 数据喂饱比堆参数更重要:Chinchilla 论文里,70B 参数配 4 倍数据,在基准测试上全面超过 280B 的 Gopher。
- 架构能「绕过」参数量:Mixtral 8x7B 论文里,总参数 47B,但每个 Token 只激活 13B,推理成本接近中型模型。
- 规模本身确实有效:GPT-3 论文里 175B 参数是当时此前最大非稀疏模型的 10 倍,带来了少样本学习能力的跃升。
参数量像公司的人数,能力像公司的产出:人多不必然产出高,但没有一定人手,再好的管理也做不出大项目。选模型时看三个数:总参数、激活参数、训练数据量,比只看一个参数量靠谱得多。想继续深入,可以看我们讲 MoE 专家混合和大语言模型是怎么工作的的两篇。
怎么查一个模型的真实参数量
- 看官方模型卡和技术报告:论文或发布页会写明总参数和激活参数,MoE 模型要两个都看。
- 用文件体积反推:权重文件大小除以每参数字节数(16 位精度约 2 字节),能粗估参数量,量化版要按实际位宽换算,结果属估算。
- 警惕宣传口径:有些发布只说「万亿参数」不提激活多少,参考价值有限,真实对比要看基准成绩和推理成本。
一段话讲清参数量
「参数量是模型里可学习数值的总数,7B 就是 70 亿。这些参数主要是 Transformer 里注意力层和前馈层的权重,训练就是用梯度下降不断调整它们。参数量决定知识容量上限,但能力还取决于数据质量和训练方法:Chinchilla 70B 配 4 倍数据能赢 Gopher 280B,MoE 架构能做到总参数大、激活参数小。所以看模型不能只看参数,要看参数、数据、架构的合奏。」
高频追问是「模型文件大小怎么估算」。可以答:按每个参数 2 字节(16 位精度)粗估,7B 约 14GB,量化后会更小,这是估算值,实际因精度和架构略有出入。
常见问题
参数量为什么用 B 来数?
答:B 是 billion,70B 即 700 亿参数。模型参数是海量浮点数,用十亿作单位方便比较。
参数越多推理越慢吗?
答:基本成立,但要看激活参数。MoE 模型总参数大、每个词激活得少,速度可以接近小模型。
7B 模型需要什么配置才能跑?
答:16 位精度约需 14GB 以上显存,量化到 4 位后约 4GB 级别(估算值),具体看模型架构和推理框架。
为什么有的 7B 模型比更大的模型好用?
答:数据质量、训练配方、对齐水平都影响体验,参数只是容量上限,不保证被填满。
参数量和 Token 数是什么关系?
答:参数是模型的「脑容量」,Token 是喂给它的「教材页数」,两者要匹配,这也是 Chinchilla 最优配比的核心结论。
 京ICP备2024094994号-29