
Muse Glimmer 是什么?Meta 开源的 30B 本地模型
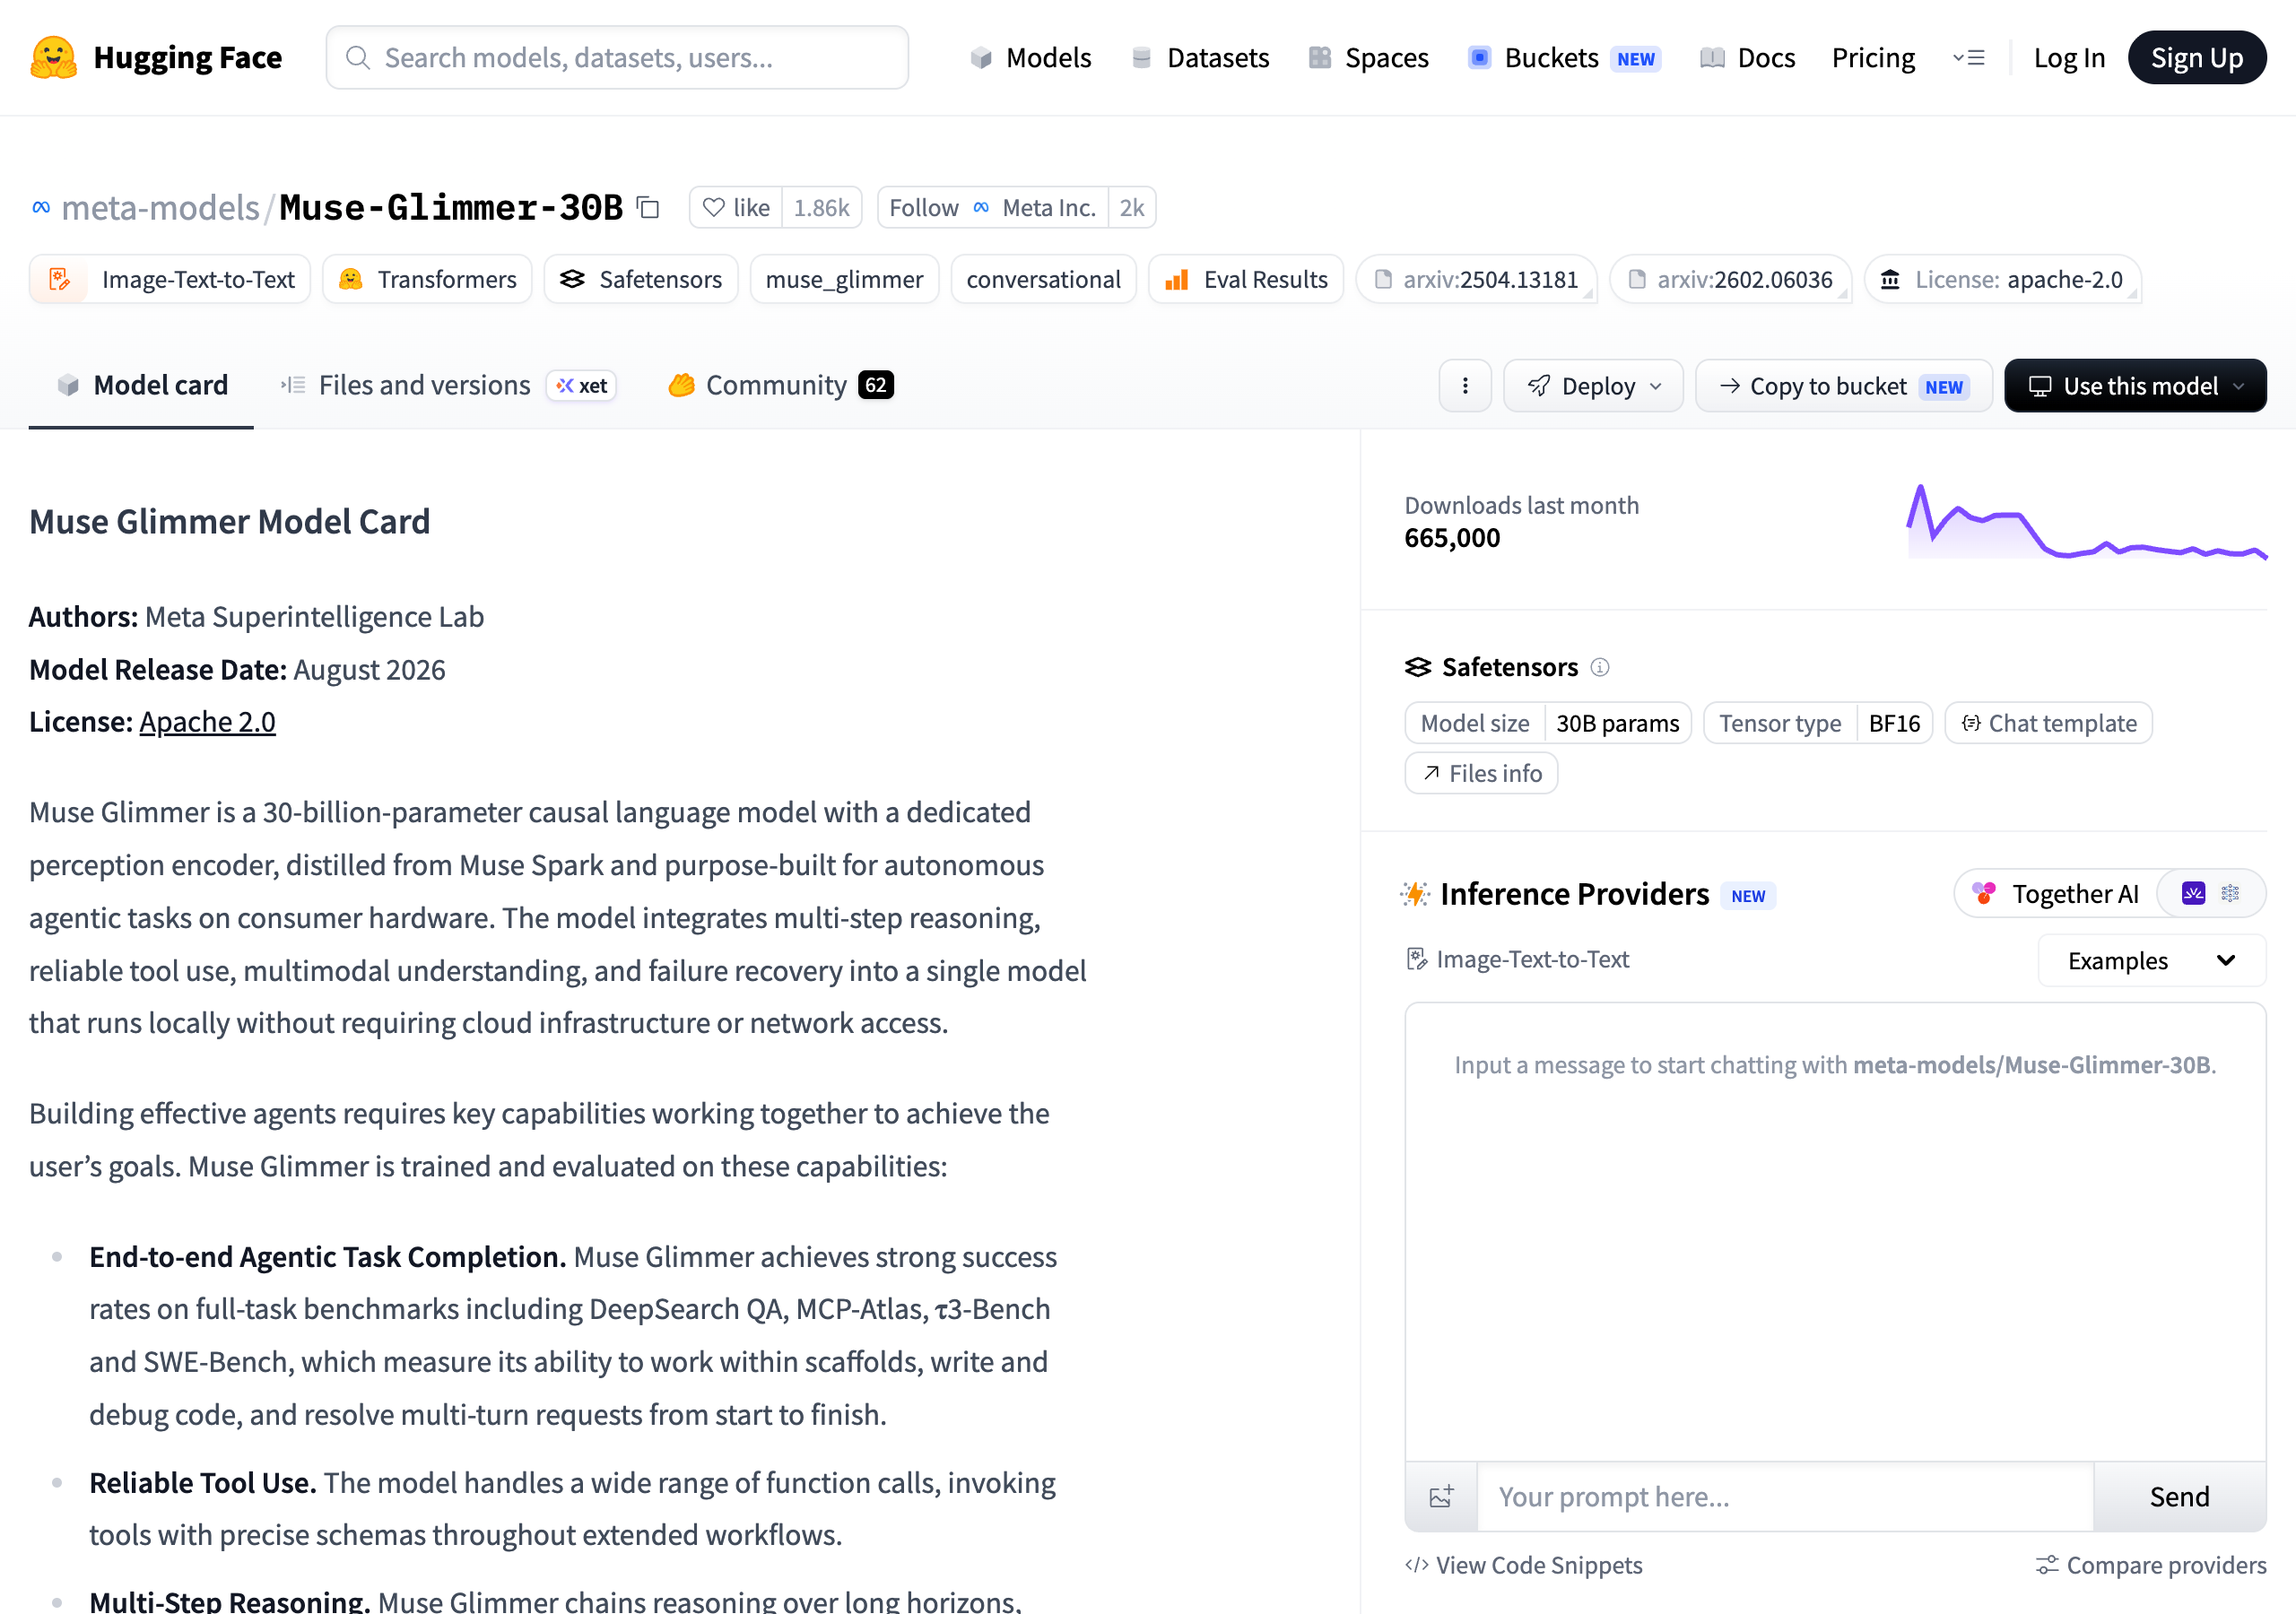
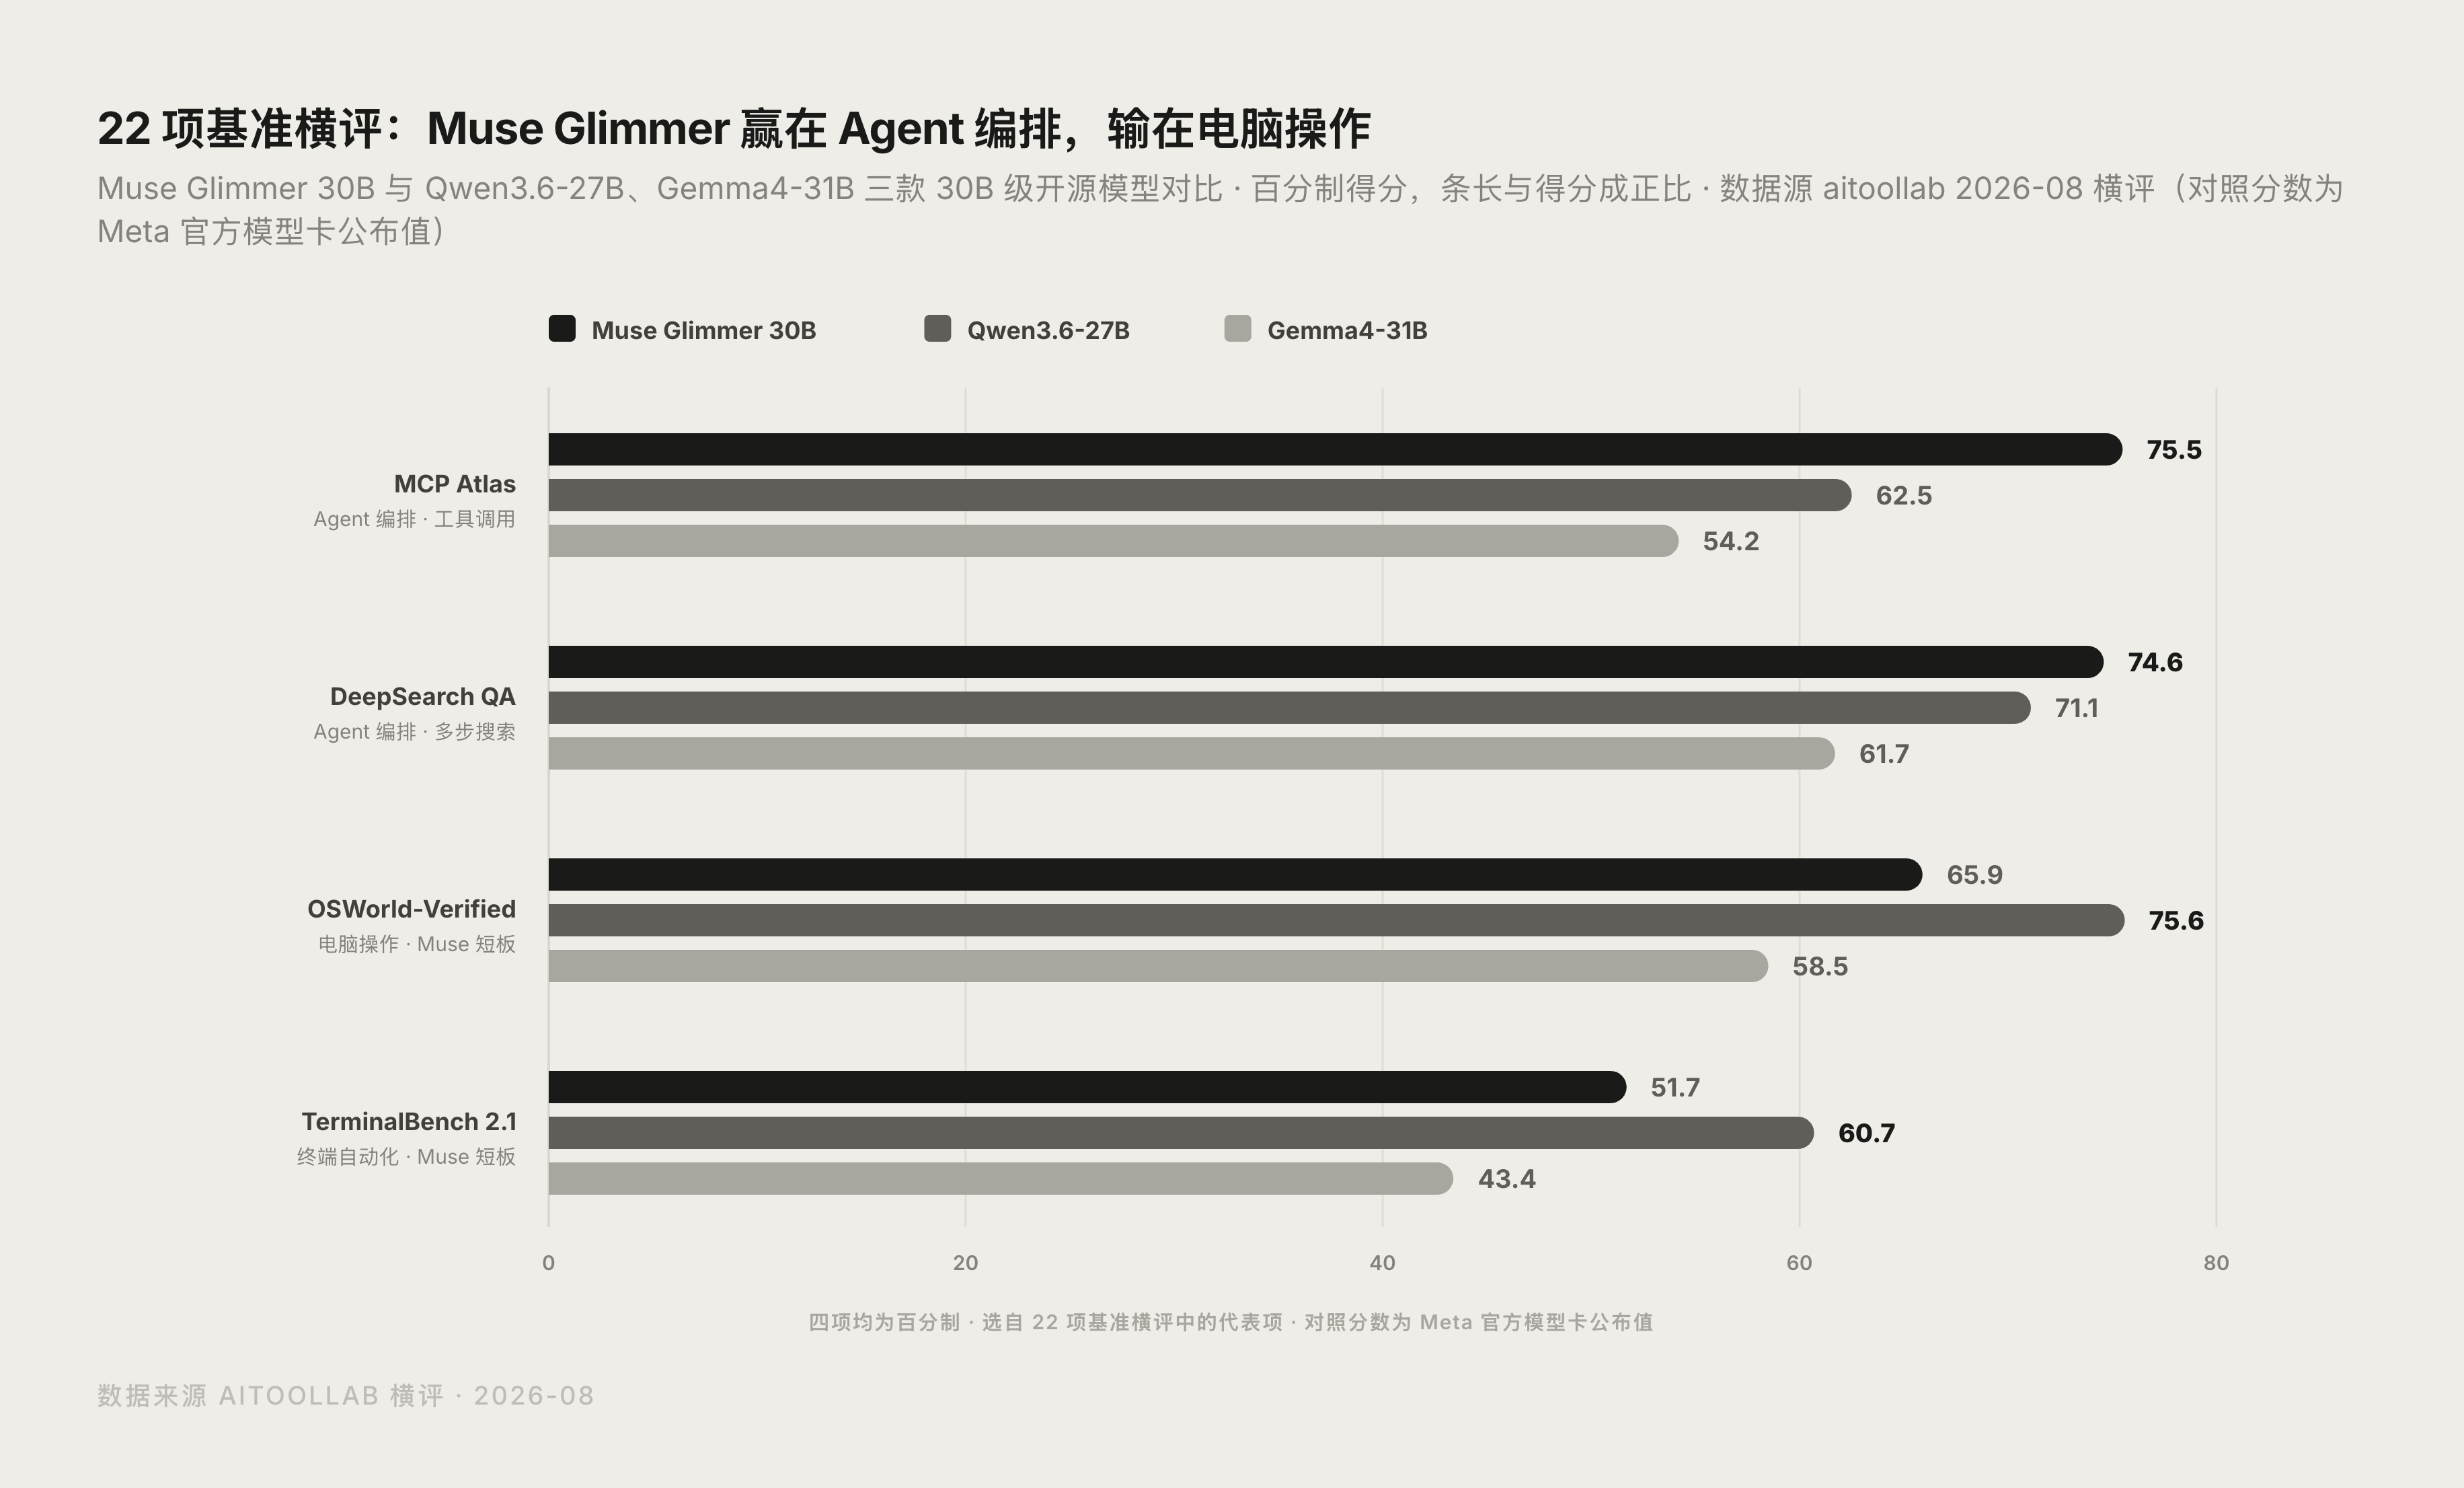
2026 年 8 月 11 日,Meta 把自家旗舰模型 Muse Spark「缩小」成了一个 300 亿参数的开源小模型 Muse Glimmer:权重开放在 Hugging Face,采用 Apache 2.0 协议,官方目标是在单张消费级显卡上跑本地 AI Agent。这是 Meta 超级智能实验室(Meta Superintelligence Labs)旗下 Muse 系列的第一个开放权重模型。
从 Muse Spark 蒸馏出来的 30B:身世与许可
根据模型卡片与第三方整理页,Muse Glimmer 是一个 300 亿参数、开放权重的多模态模型,带独立感知编码器,由旗舰模型 Muse Spark 蒸馏而来。蒸馏的意思是:让小模型去学习大模型的输出行为,用更少的参数尽量保留大模型的能力,代价是部分极端场景下的能力上限会降低。
许可这一档 Meta 这次给得很宽:权重、两个 4-bit 量化版本、投机解码 drafter 和视觉编码器全部以 Apache 2.0 发布,可以免费用、改、商用,也没有按用户规模设门槛。这和 Llama 系列的自定义社区许可差别明显,后者附带了月活用户规模之类的附加条款。中文社区的普遍评价是「Meta 难得给的真开源」。
发布前过程也有波折,多家媒体用「五天反转重回开源」来形容 Meta 从摇摆到最终开放权重的过程。
4-bit 量化是门槛的关键:谁能本地跑
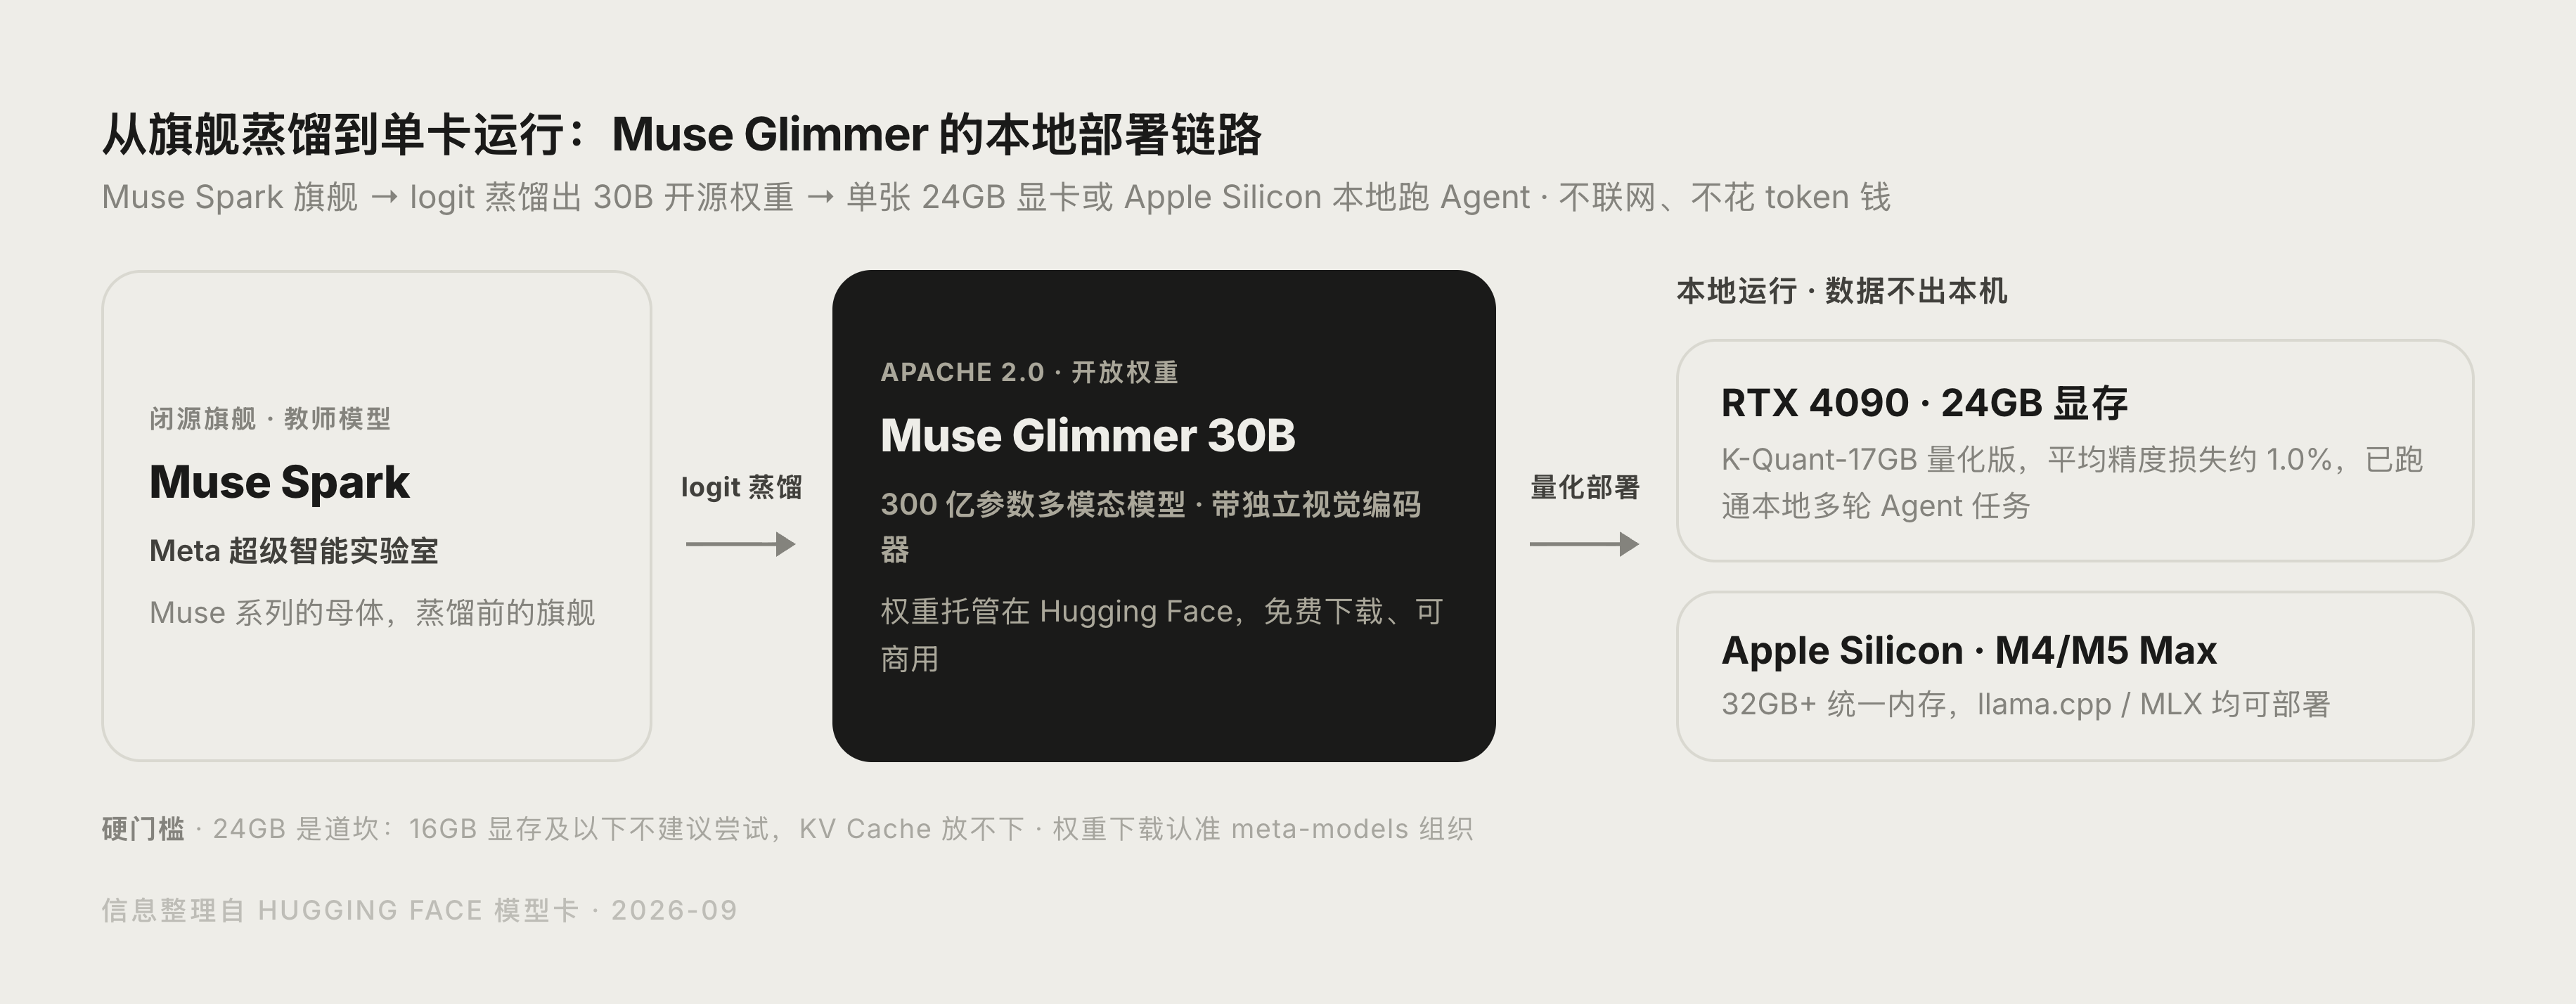
社区已有不少实测:有开发者用单张 RTX 4090(24GB 显存)跑通了本地多轮 Agent 任务。但更准确的门槛要看量化版本,这也是选型时最容易忽略的一步:
| 版本 | 大致显存需求 | 适用场景 |
|---|---|---|
| BF16 全精度 | 55GB 以上(官方另有 64GB 的说法) | 微调与研究 |
| K-Quant-Dynamic 4-bit | 32GB 级显卡 | 质量优先的本地推理 |
| K-Quant-17GB 4-bit | 24GB 级显卡 | 单卡常驻运行 |
官方给的精度损失数据也值得看一眼:K-Quant-Dynamic 版本在 15 项常用基准上的平均准确率衰减约 0.2%,K-Quant-17GB 版本约 1.0%。也就是说,「压到 24GB 能跑」不是靠牺牲大量质量换来的。
权重直接在 Hugging Face 的 meta-models/Muse-Glimmer-30B 页面免费下载,Meta 官方的模型介绍页在 developer.meta.com;第三方整理页 AIHub 的 Muse Glimmer 词条有中文版参数与场景整理。
它瞄准的场景:不是聊天,是本地 Agent
Muse 系列的产品叙事是「个人超智能」:模型跑在你自己的机器上,能看图、能调工具、任务中断后能自主恢复。官方把训练目标写得很明确:工具调用失败或返回异常结果时,模型会被训练成先诊断错误再重试,而不是直接中断任务链,这是长程 Agent 能不能持续跑下去的关键。
其他几项规格也围着这个目标设计:上下文 131,072+ tokens,采用「局部×3 加全局」的循环注意力模式和 2048 滑动窗口;单张图片最多支持 4,096 个视觉 token,可以直接读截图、图表和文档;支持 low、medium、high、xhigh 四档推理强度,复杂编程和 Agent 任务建议用 high 或 xhigh。
对用户意味着两件事:一是数据不出本机,敏感文件可以放心喂;二是不用付 API 按量费用,跑多少次都没有账单。代价是你要自己准备硬件和部署环境,能力上也弱于云端旗舰。
官方自测跑分:赢在 Agent,输在电脑操作
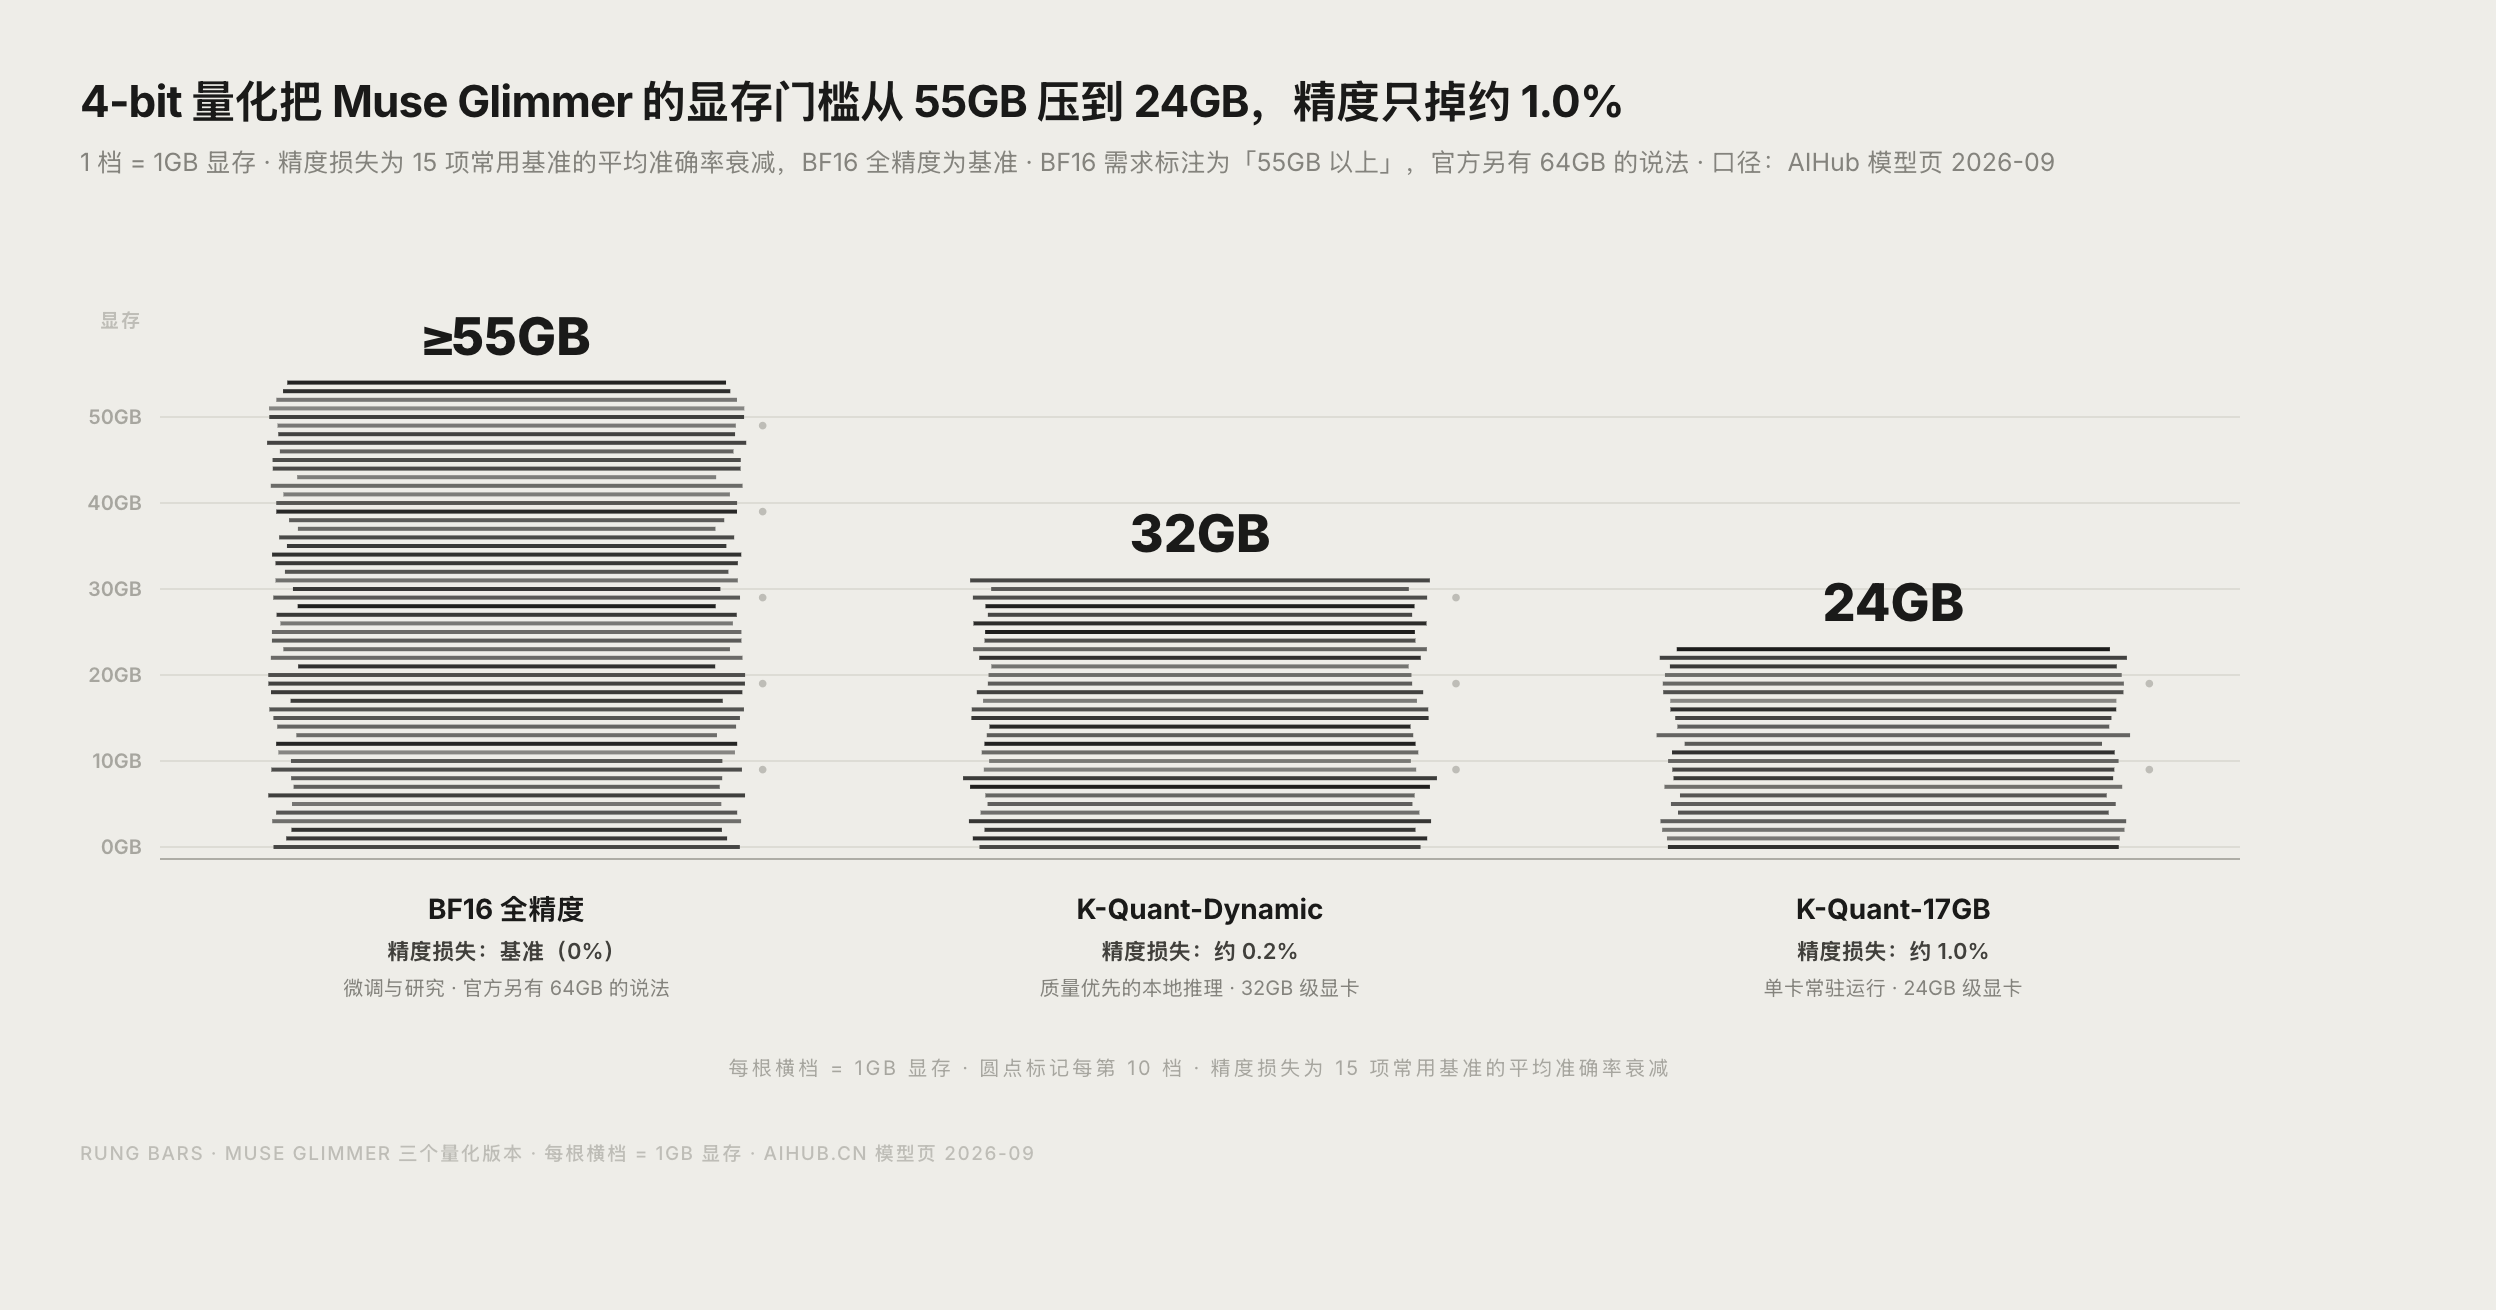
按 Meta 官方评测(对比集为 Gemma4-31B 与 Qwen3.6-27B 的 Thinking Mode),结论并不一边倒:
| 基准 | Muse Glimmer | 对手 | 说明 |
|---|---|---|---|
| MCP Atlas | 75.5 | 54.2 / 62.5 | 工具调用与 Agent 编排领先 |
| DeepSearch QA | 74.6 | 官方未给对手值 | 深度检索问答 |
| AIME 2026 | 94.7 | 官方未给对手值 | 数学推理 |
| AA-LCR | 80.0 | 官方未给对手值 | 长上下文推理 |
| OSWorld-Verified | 65.9 | 75.6 | 电脑操作落后于 Qwen3.6-27B |
| TerminalBench 2.1 | 51.7 | 60.7 | 终端任务落后 |
一句话总结:Agent 和工具调用类任务占优,电脑操作与终端任务落后。以上全部是官方自测数据而不是独立复测,选型时建议按你自己的任务类型找对应基准,不要只看总分。
怎么把它跑起来
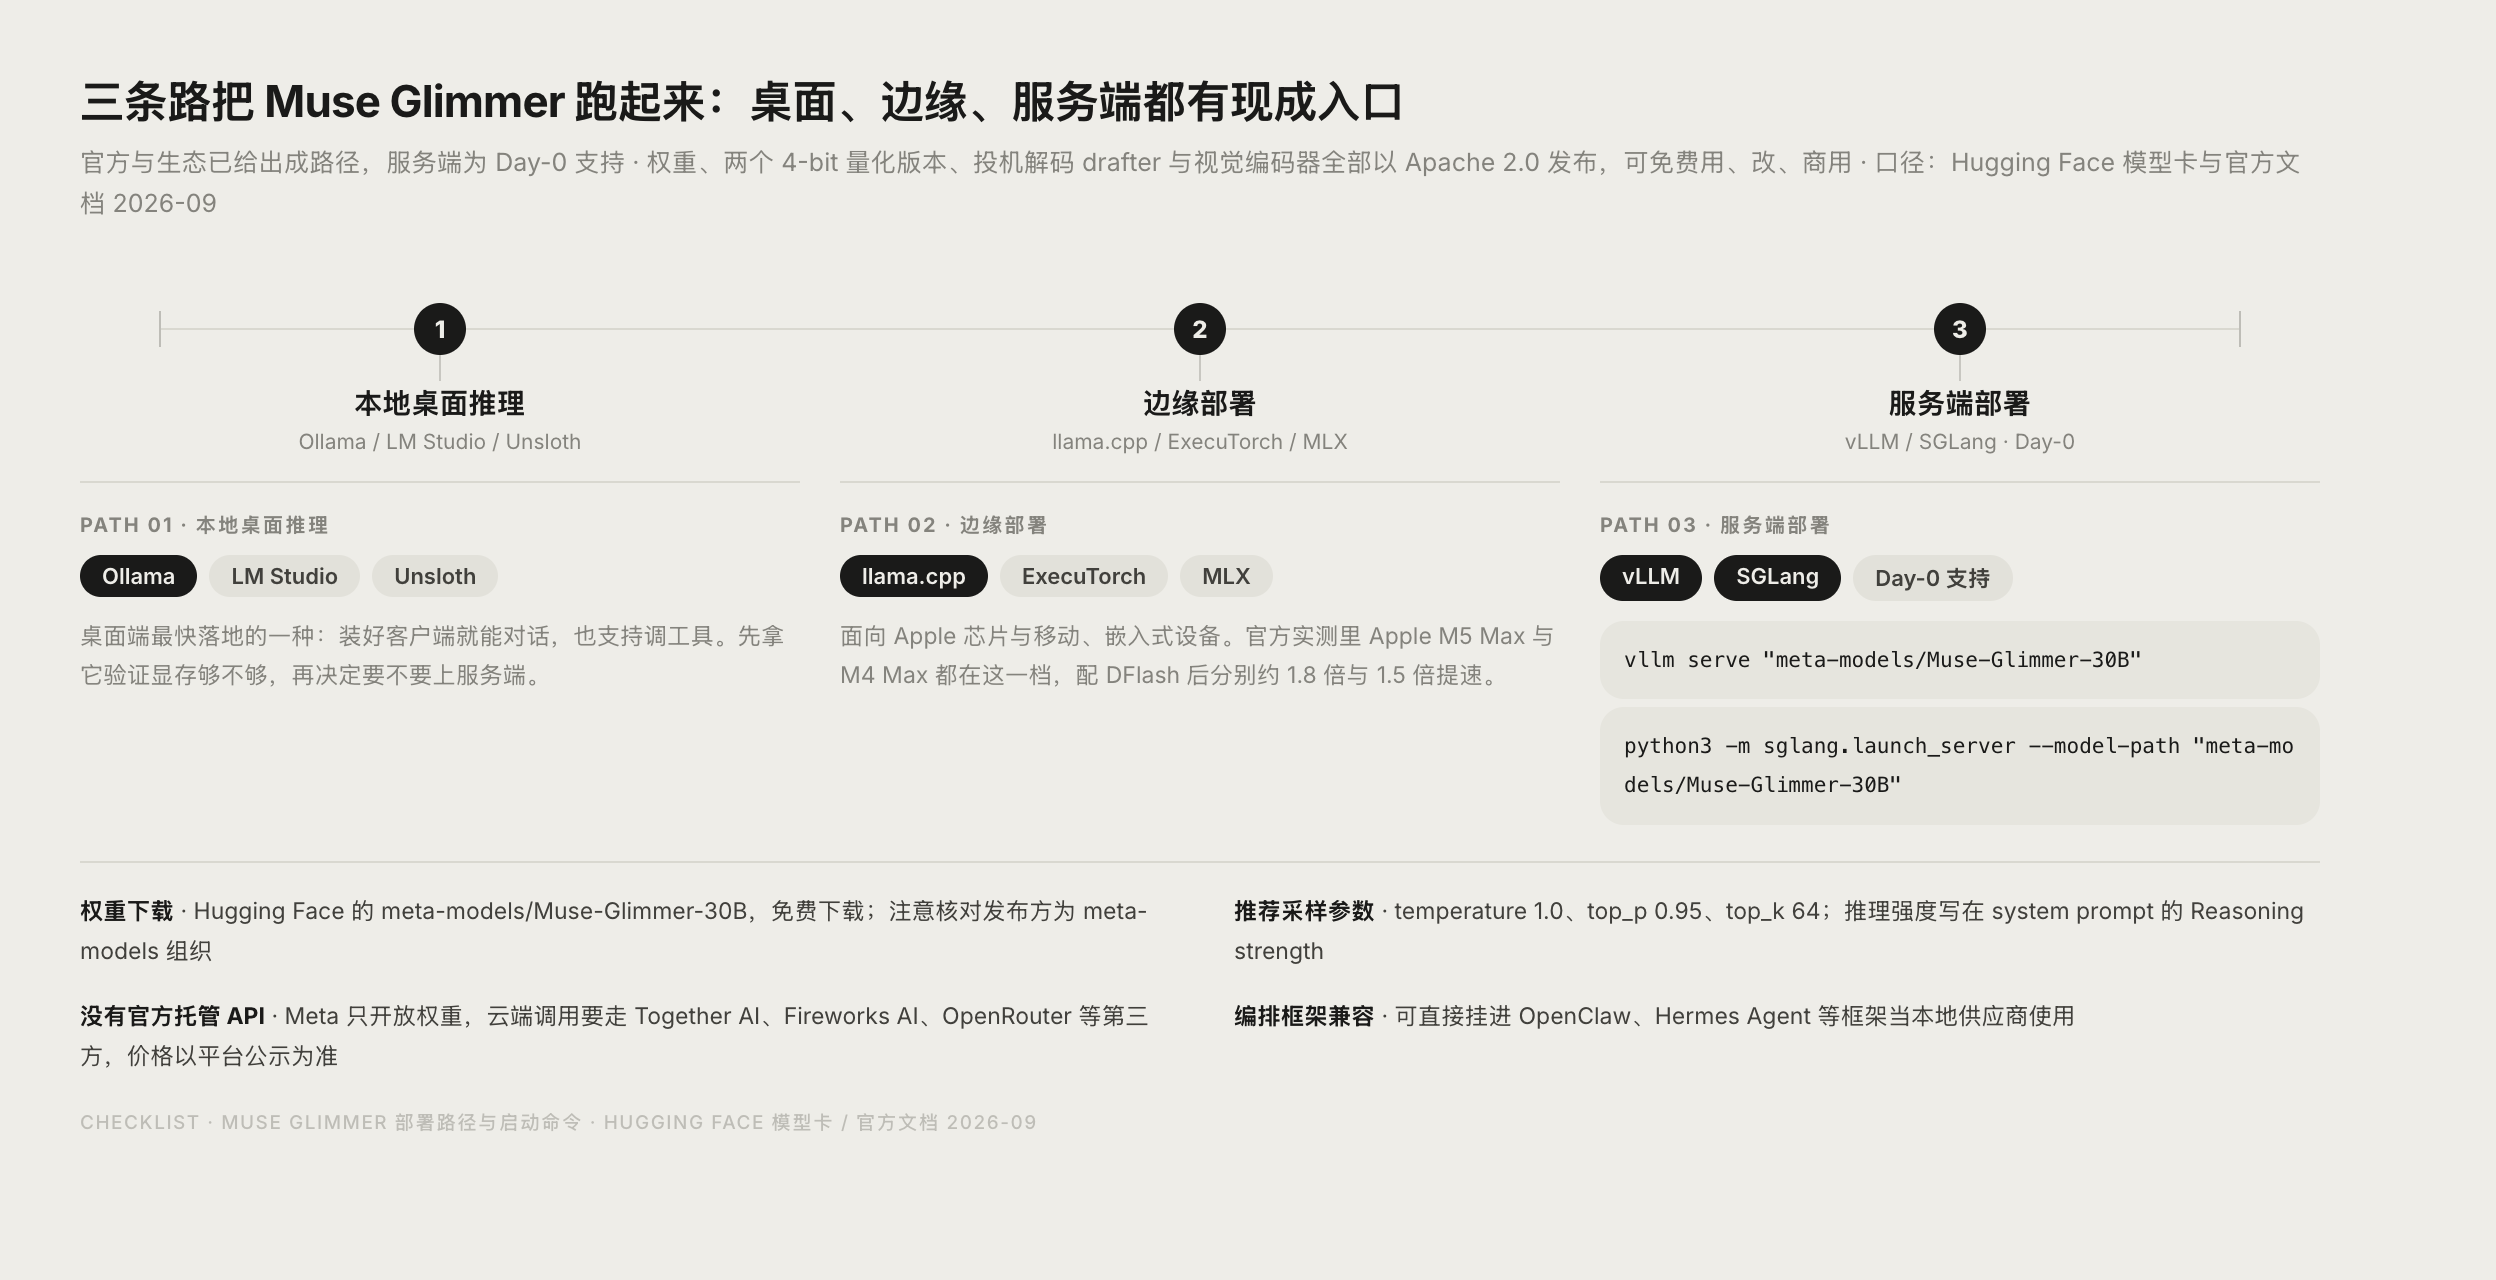
官方和生态已经给了现成路径,按你的场景选:
- 本地桌面推理:Ollama、LM Studio、Unsloth。
- 边缘部署:llama.cpp、ExecuTorch、MLX。
- 服务端部署:vLLM 或 SGLang,均提供 Day-0 支持。
以 vLLM 为例,一行就能起一个 OpenAI 兼容接口:
vllm serve "meta-models/Muse-Glimmer-30B"
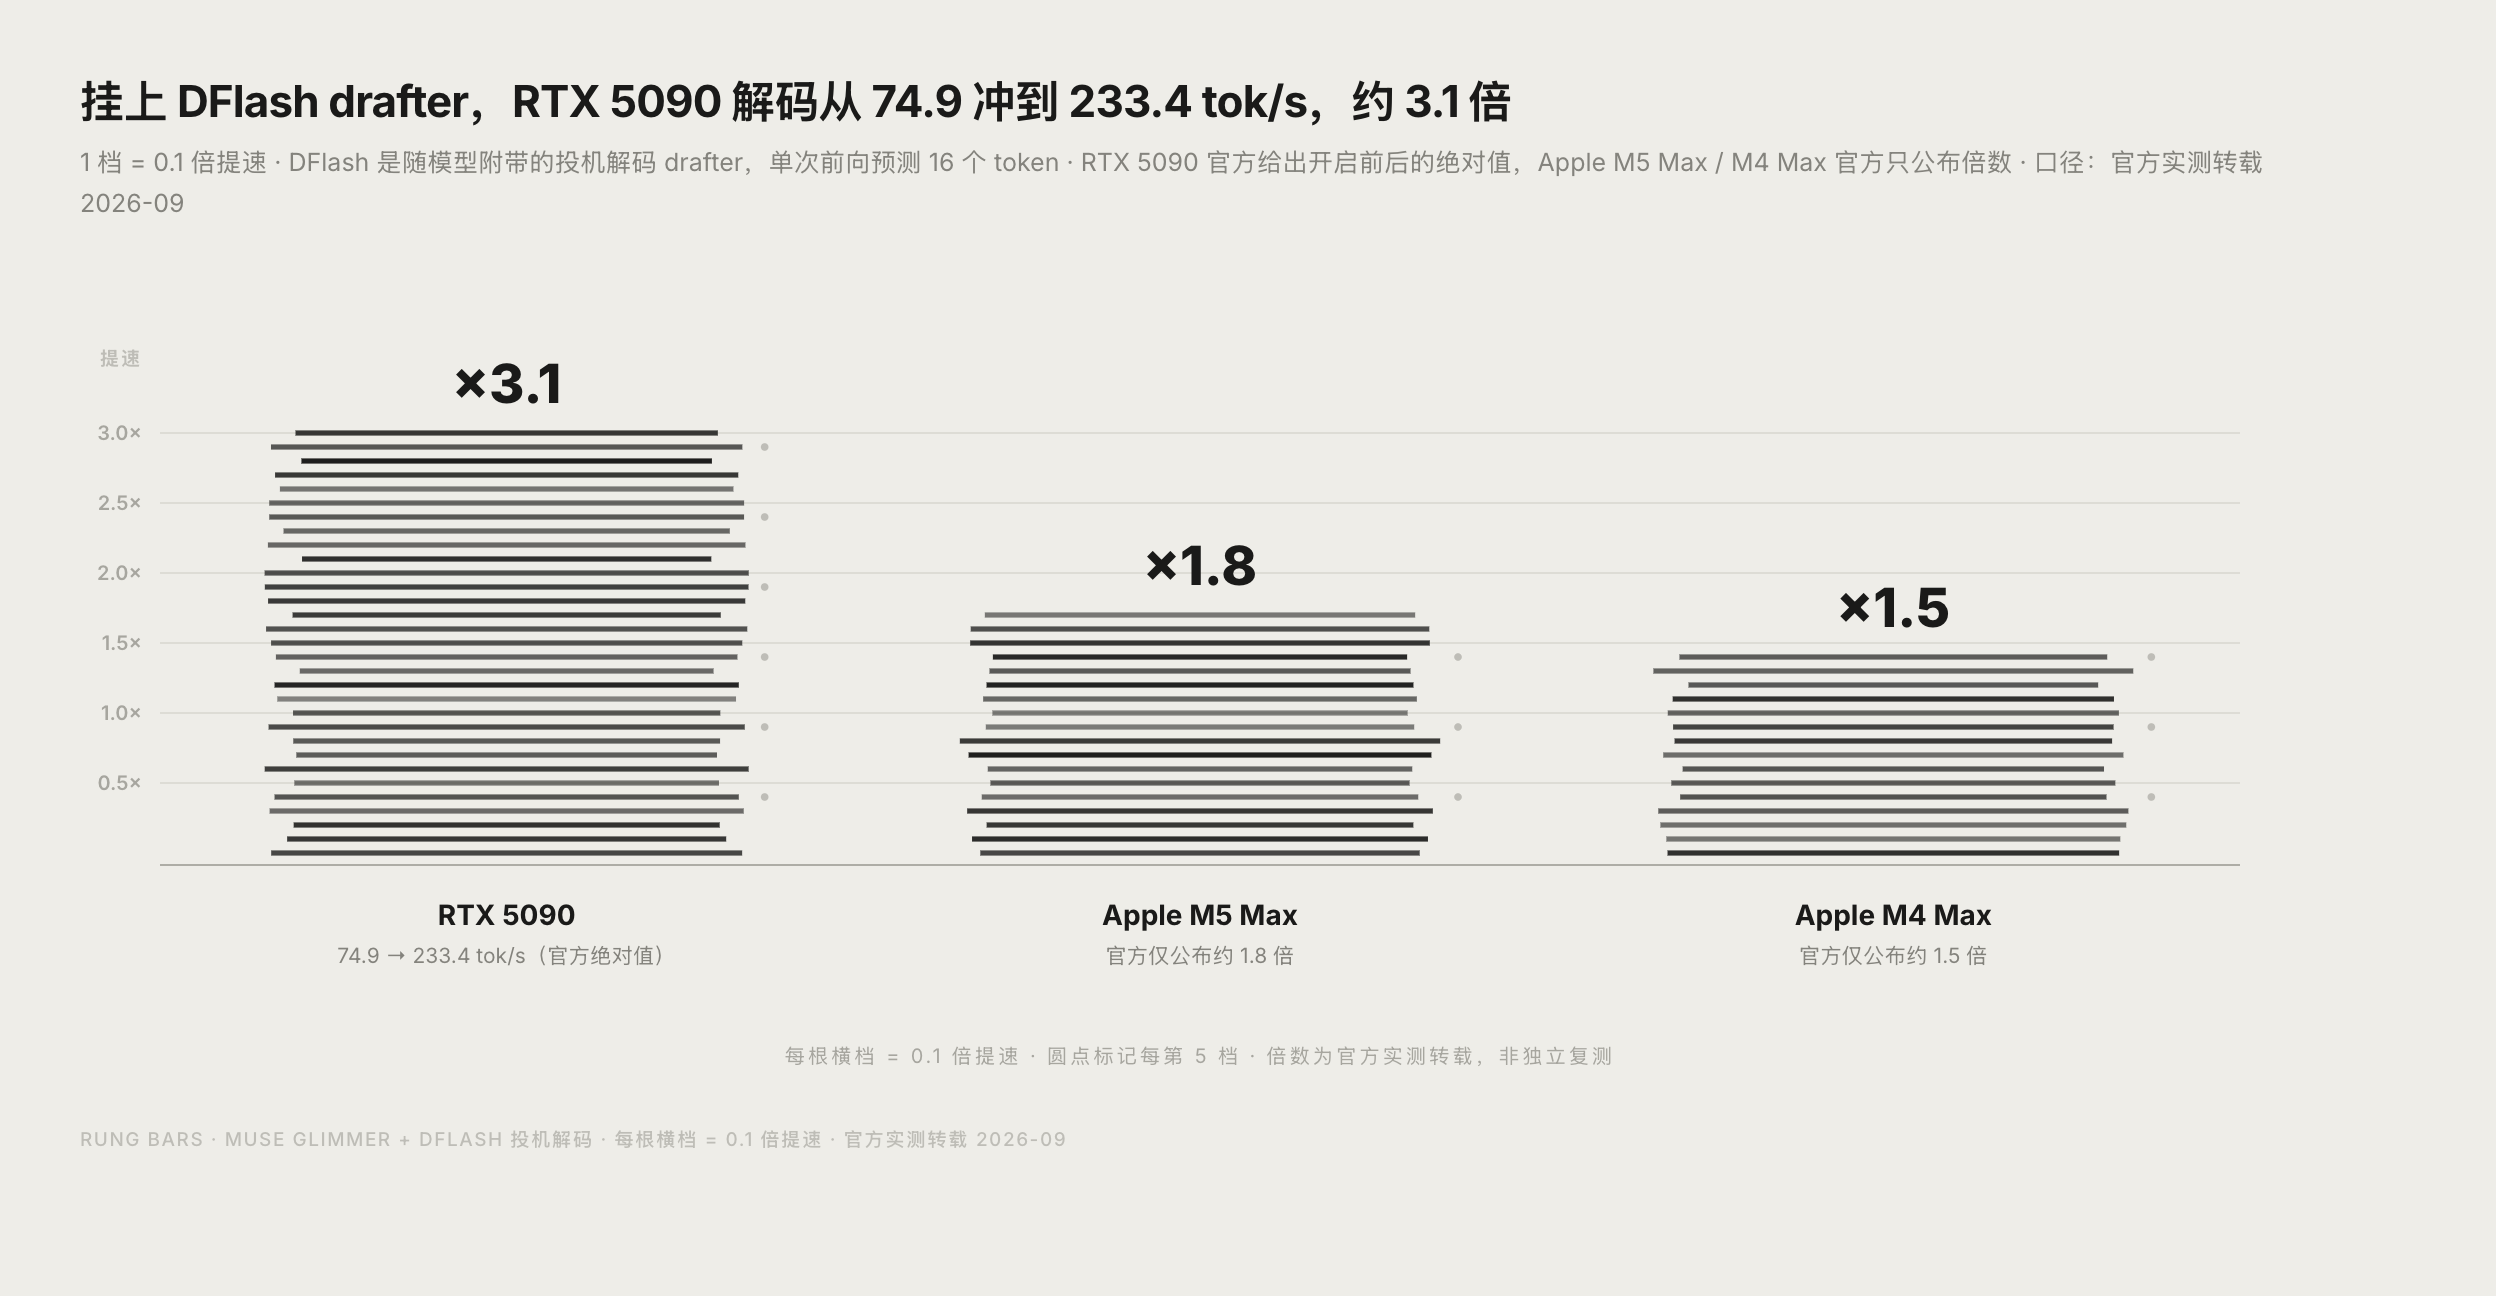
SGLang 的写法是 python3 -m sglang.launch_server --model-path "meta-models/Muse-Glimmer-30B"。想要更好的吞吐,记得把随模型附带的 DFlash drafter 也用上:官方实测在 RTX 5090 上解码速度从 74.9 tok/s 提升到 233.4 tok/s(约 3.1 倍),Apple M5 Max 提升约 1.8 倍、M4 Max 约 1.5 倍。
官方推荐的采样参数是 temperature 1.0、top_p 0.95、top_k 64,推理强度则在 system prompt 里写 Reasoning strength: <值> 来控制。模型兼容 OpenClaw、Hermes Agent 等编排框架,如果你已经在用 OpenClaw,可以把本地模型直接挂进去当供应商。
如果你还不清楚 Agent 和普通聊天的区别,可以先看我们的 AI Agent 入门 补基础;想了解它蒸馏前的母模型,可以看 Muse Spark 1.2 详解;想横向看开源小模型这一档,可以看 MiniCPM5-2B 指南。
边界与前提:三件容易被忽略的事
- 官方没有为它提供 API 定价。Meta 只开放权重,不卖官方托管接口;想在云端调用要走 Together AI、Fireworks AI、OpenRouter 这类第三方推理平台,价格以各平台公示为准。
- 多语言没有全量评测。训练数据覆盖 100 种以上语言,但官方明确未对全部语言做评测,强支持语种之外的表现可能下降,中文长文任务建议先自己压测。
- 视频不是它的强项。输入支持文本与图像交错,输出只有文本,不支持音频;视频未做专门优化,只能按单帧图像处理。
许可证层面唯一的排除项是违反适用法律法规(含贸易合规法规)的用途,以及 Apache 2.0 本身禁止的行为。
同为开源模型的认知参考,还可以看 Stable Audio 3.0 是什么,它代表了开源音频模型这一侧的现状。
常见问题
Muse Glimmer 免费吗?可以商用吗?
答:权重免费下载,采用 Apache 2.0 协议,个人使用和商业使用都允许,没有用户规模门槛,仅需遵守协议的版权与声明要求,以及不把它用于违反法规的用途。
它和 Muse Spark 是什么关系?
答:Muse Spark 是 Meta 超级智能实验室的旗舰模型,Muse Glimmer 是从它蒸馏出的 30B 小模型,能力上限低于 Spark,但硬件门槛低得多,两者定位是旗舰与本地版的关系。
需要什么显卡才能本地跑?
答:看量化版本。K-Quant-17GB 版本目标硬件是 24GB 显存,K-Quant-Dynamic 版本建议 32GB 显存,Apple M4 Max / M5 Max 级别的 Mac 也在官方实测范围内;BF16 全精度需要 55GB 以上显存,只建议用于微调与研究。
在国内能下载吗?
答:权重托管在 Hugging Face,国内访问需要正常网络环境,也可以通过国内镜像站加速下载,下载时注意核对模型发布方为 meta-models 组织,避免第三方改名包。
它是多模态模型吗?能处理视频或音频吗?
答:是多模态,通过独立的 ViT-G/14 感知编码器接受文本与图像交错输入,单图最多 4,096 视觉 token,并能调用工具、在任务中断后自主恢复。但它输出只有文本,不支持音频,视频也只能按单帧图像处理。
官方跑分说它比 Qwen3.6-27B 强,可信吗?
答:那是 Meta 官方自测,不是独立复测。可参考的结论只是分项差异:Agent 编排和工具调用类基准领先,电脑操作(OSWorld-Verified 65.9 对 75.6)和终端任务(TerminalBench 2.1 为 51.7 对 60.7)落后。请按自己的任务类型选型。
 京ICP备2024094994号-29