
Seed-OSS-36B 是什么?字节开源 36B 与思考预算
Seed-OSS-36B 是什么?字节开源 36B 模型的参数、跑分与思考预算
Seed-OSS-36B 是字节跳动 Seed 团队2025年8月20日开源的大语言模型系列,包含 Base 和 Instruct 两类版本,Apache-2.0 协议允许商用。官方给它的标签是:只用12T token训练,却在512K原生上下文、推理、Agent 工具调用这几个方向上做到了同档位开源模型的前列。
发布背景:Seed 团队和它的12T token
Seed 团队成立于2023年,是字节跳动的大模型研究团队,服务豆包、扣子、即梦等50多个应用。Seed-OSS 这个系列的特别之处在于训练数据量:12T token,明显低于很多同代模型,官方称这证明了数据效率路线的可行性。
一个容易忽略的细节:官方明确注明 Seed-OSS 主要针对国际化(i18n)场景优化。中文场景用它之前,建议先用自己的业务语料实测。
关键参数:36B 档位里的长上下文选手
架构是主流配置:RoPE、GQA 注意力、RMSNorm、SwiGLU 激活。逐项参数如下:
| 项目 | Seed-OSS-36B |
|---|---|
| 参数量 | 36B(360亿) |
| 层数 | 64 |
| 注意力 | GQA,80/8/8 头 |
| 词表 | 155K |
| 上下文长度 | 512K 原生 |
| RoPE 基频 | 1e7 |
Base 版发布了两个变体:含合成指令数据训练的版本,和不含合成数据的 woSyn 版本。官方的理由是预训练中混入合成指令数据可能影响后训练研究,woSyn 版本就是给研究社区留的干净底模。
思考预算:让它想多久由你决定
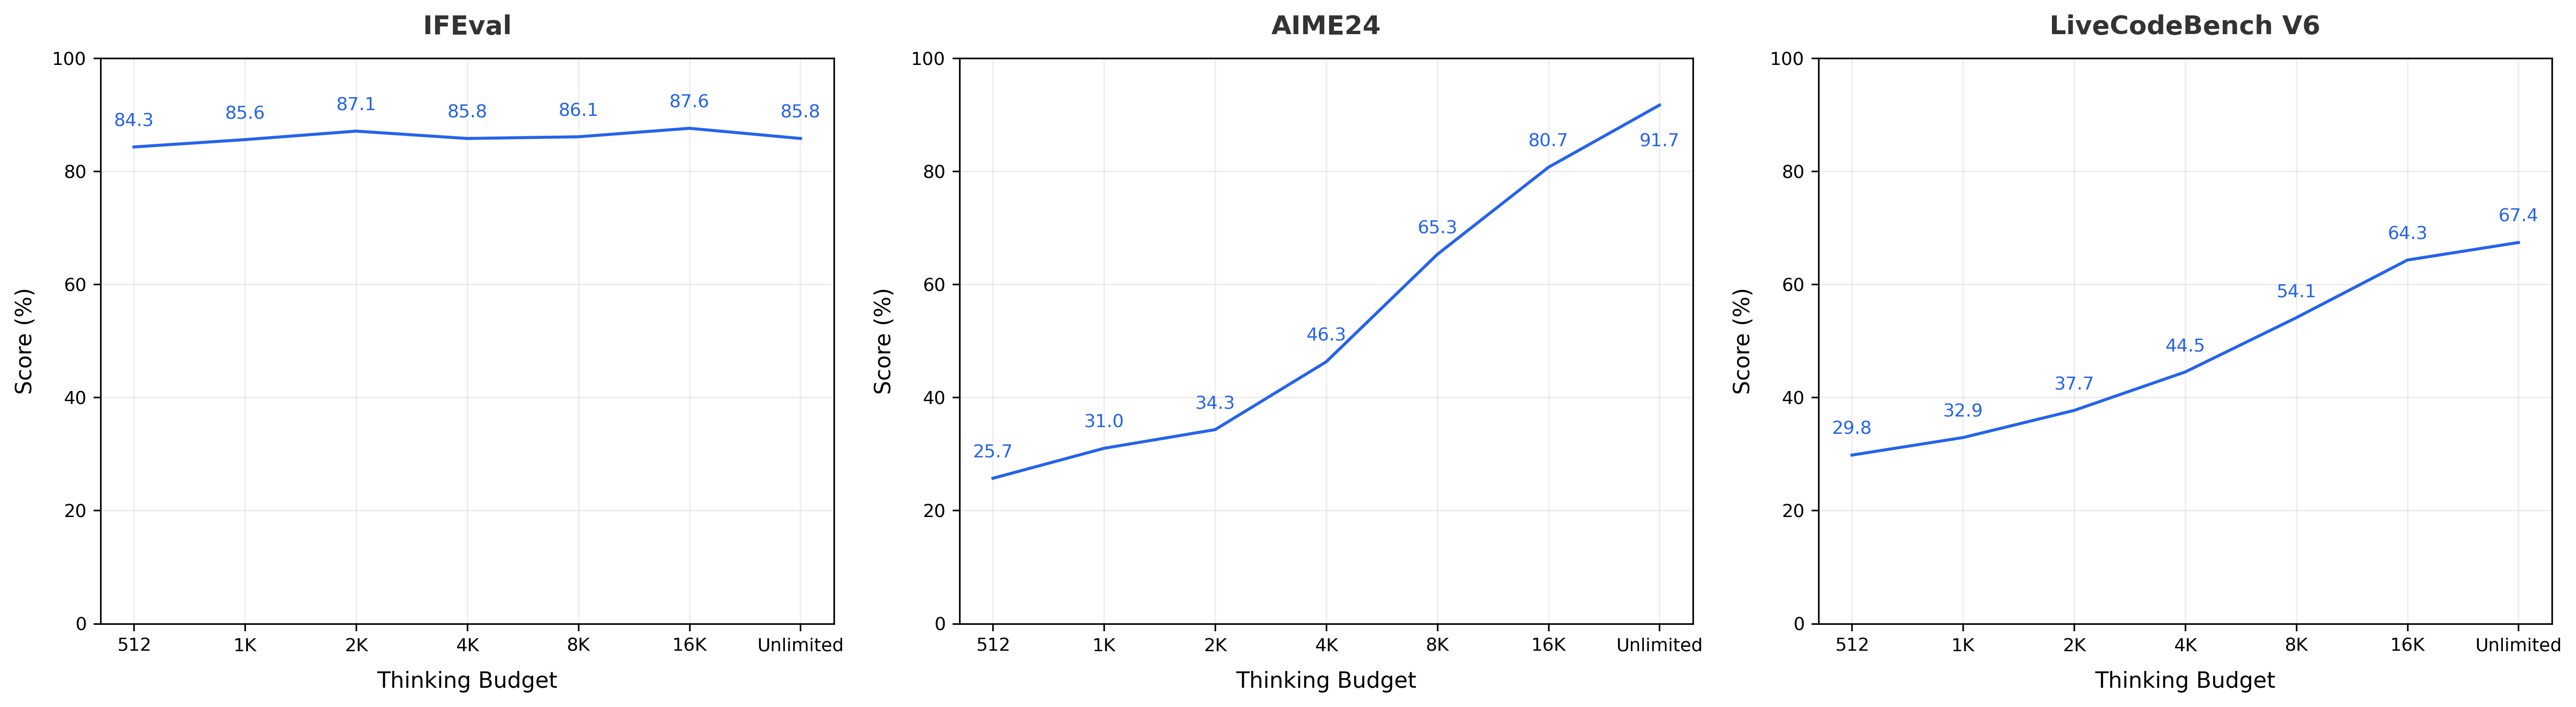
这是 Seed-OSS 最有辨识度的机制。推理时模型会周期性自检已消耗和剩余的思考预算(token数),预算用尽或推理完成才输出最终答案。用起来有几条规则:
- 思考内容包在 seed:think 标签里,过程中的预算自检写在 seed:cot_budget_reflect 标签里。
- 建议把预算设为512的整数倍(512、1K、2K、4K、8K、16K),官方在这些档位上做了大量训练。
- 预算设为0时模型直接回答,不进入思考;不设置则默认无限长度思考。
- 官方推荐采样参数:temperature=1.1,top_p=0.95。
实际意义在成本控制:简单任务缩短思考省 token,难题放大思考换正确率,这个旋钮是显式的、可编程的。
官方跑分:36B 档位什么水平
Instruct 版的亮点成绩(加粗为官方标注的开源第一):
| 基准 | Seed-OSS-36B-Instruct | 位置 |
|---|---|---|
| AIME24(数学) | 91.7 | 开源第二 |
| AIME25(数学) | 84.7 | 开源第二 |
| LiveCodeBench v6(代码) | 67.4 | 开源第一 |
| SWE-Bench Verified(OpenHands) | 56 | 开源第二 |
| TAU1-Retail(Agent) | 70.4 | 开源第一 |
| RULER 128K(长上下文) | 94.6 | 开源第一 |
| MMLU / MMLU-Pro | 87.4 / 82.7 | 开源第一 |
Base 版对应成绩:MMLU 84.9、MMLU-Pro 65.1、BBH 87.7、MATH 81.7、HumanEval 76.8。完整表格见官方仓库 README,注意这些是官方自测数据,横向引用时建议保留口径。
适合谁用、怎么获取
三个典型场景:做 Agent 和工具调用的应用(TAU 和 SWE-Bench 的成绩就是为这类场景背书);需要长文档处理的任务(512K 上下文加 RULER 94.6);做后训练研究的团队(woSyn 版底模是明确的信号)。
权重在 GitHub 仓库(ByteDance-Seed/seed-oss)和 Hugging Face 集合页可下载,推理支持 vLLM 和 Transformers,仓库内附部署脚本。
36B 量化后可以进多卡消费级环境,选型思路可以参考MiniMax H3:8GB 显存本地部署与 API 价格;想对比字节系闭源端到端能力,可读Doubao Seed 2.0 Code 评测;关注其他开源模型动态的话,WeMM-Embedding 多模态嵌入模型解读是另一个近期案例。
常见问题
Seed-OSS-36B 可以商用吗?
答:可以。它采用 Apache-2.0 协议开源,商用无需授权费,仅需遵守协议条款。
Seed-OSS-36B 中文能力怎么样?
答:官方注明模型主要针对国际化场景优化,未单独强调中文。中文业务场景建议先用自有语料实测,不要只看英文基准跑分。
思考预算设多少合适?
答:官方建议512的整数倍。简单任务可以设512或更低(512以下建议直接设0),AIME 这类难题可以放大到8K以上,官方曲线显示难题得分随预算上升而提高。
Base 版和 Instruct 版怎么选?
答:直接使用选 Instruct 版;要做后训练研究、担心合成数据干扰的,选 woSyn 版 Base 底模。
需要什么硬件跑推理?
答:36B 全精度需要多卡环境,仓库支持 vLLM 部署;量化后可压缩到更低的显存需求,具体以仓库 inference 目录的官方脚本为准。
 京ICP备2024094994号-29