
LimiX-2 是什么?清华团队开源数据大模型,3 大国际榜单全第一
LimiX-2 是什么?清华团队开源数据大模型,3 大国际榜单全第一
LimiX-2 是清华大学计算机系崔鹏教授团队联合稳准智能在 2026 年 9 月 16 日开源发布的新一代结构化数据大模型:400M 参数,一个模型同时完成分类、回归和缺失值插补,在 TabArena、TALENT、BCCO 三大国际基准的总体 Elo 全部排名第一。发布当天权重和推理代码就已放出,我们也在 Mac 上用纯 CPU 跑通了官方示例,本文把它的技术原理、跑分成色、许可限制和上手步骤一次讲清。
本文你会看到: LimiX-2 的定位与背景、三大榜单跑分解读、和初代 LimiX 的区别、Mac CPU 实测记录、适合谁用,以及高频问题解答。
LimiX-2 是什么:结构化数据的基础模型
一句话定义:LimiX-2 是一个专门处理"表格数据"的基础模型。你的 Excel 表、数据库里的业务表、实验记录的 CSV,都属于结构化数据,而这类数据恰恰是大多数企业里积累最多、却最难被通用大模型直接消化的数据。
它由清华大学计算机系崔鹏教授团队联合稳准智能(Stable AI)研发,是 LimiX 家族的第二代模型。家族时间线大致是:
| 时间 | 事件 |
|---|---|
| 2025 年 8 月 | 初代 LimiX 开源发布,全球首个通用结构化数据大模型(Apache 2.0 协议) |
| 2025 年 11 月 | 轻量版 LimiX-2M 发布(2M 参数),后续被 ICML 2026 录用 |
| 2026 年 1 月 | "极数"(LimiX)在雄安新区正式发布,清华与稳准智能联合推出 |
| 2026 年 9 月 16 日 | LimiX-2 开源发布,参数规模提升至 400M |
和 ChatGPT 这类语言模型不同,LimiX-2 不处理自由文本,而是把表格数据的分类、回归、缺失值填补统一成"对同一个数据模型的不同查询",一次前向传播就能出结果,不需要针对每个新任务重新训练或微调。模型权重在 HuggingFace(stable-ai/LimiX-2) 上可以直接下载。
官方入口汇总:项目主页 limix.ai、GitHub 仓库、技术报告(arXiv:2609.17488)。
LimiX-2 强在哪:从"预测答案"到"发现结构"
LimiX-2 的核心升级沿着三条技术路线推进:
- 上下文机制网络(CMN):传统表格模型通常围绕"给定特征猜标签"来学习,LimiX-2 转而学习整个数据集里变量之间如何相互关联,也就是论文里说的从
p(y|x)转向p(x,y|D_context)的联合建模。 - 合成数据引擎升级:表格数据没法像网页文本那样海量爬取,LimiX-2 用结构因果模型(SCM)自动生成覆盖多种图结构和函数机制的预训练数据。
- Scaling 到 400M:论文实测了 12.5M 到 406.2M 的参数规模,性能随规模呈清晰的对数线性提升,400M 是当前放出的最大版本。
一个值得关注的副作用是"因果感知":因为学的是变量间的联合结构,LimiX-2 的特征注意力能编码直接因果关系,论文称其可以较精确地恢复因果骨架。如果你做过数据分析,会知道这意味着它不只是"拟合得准",还可能告诉你哪些变量真正影响了哪些变量。对 Scaling Law 概念不熟的读者,可以看我们之前的基础科普《Scaling Law 是什么?3 分钟看懂规模法则与局限》。
跑分怎么样:三大国际基准全部第一
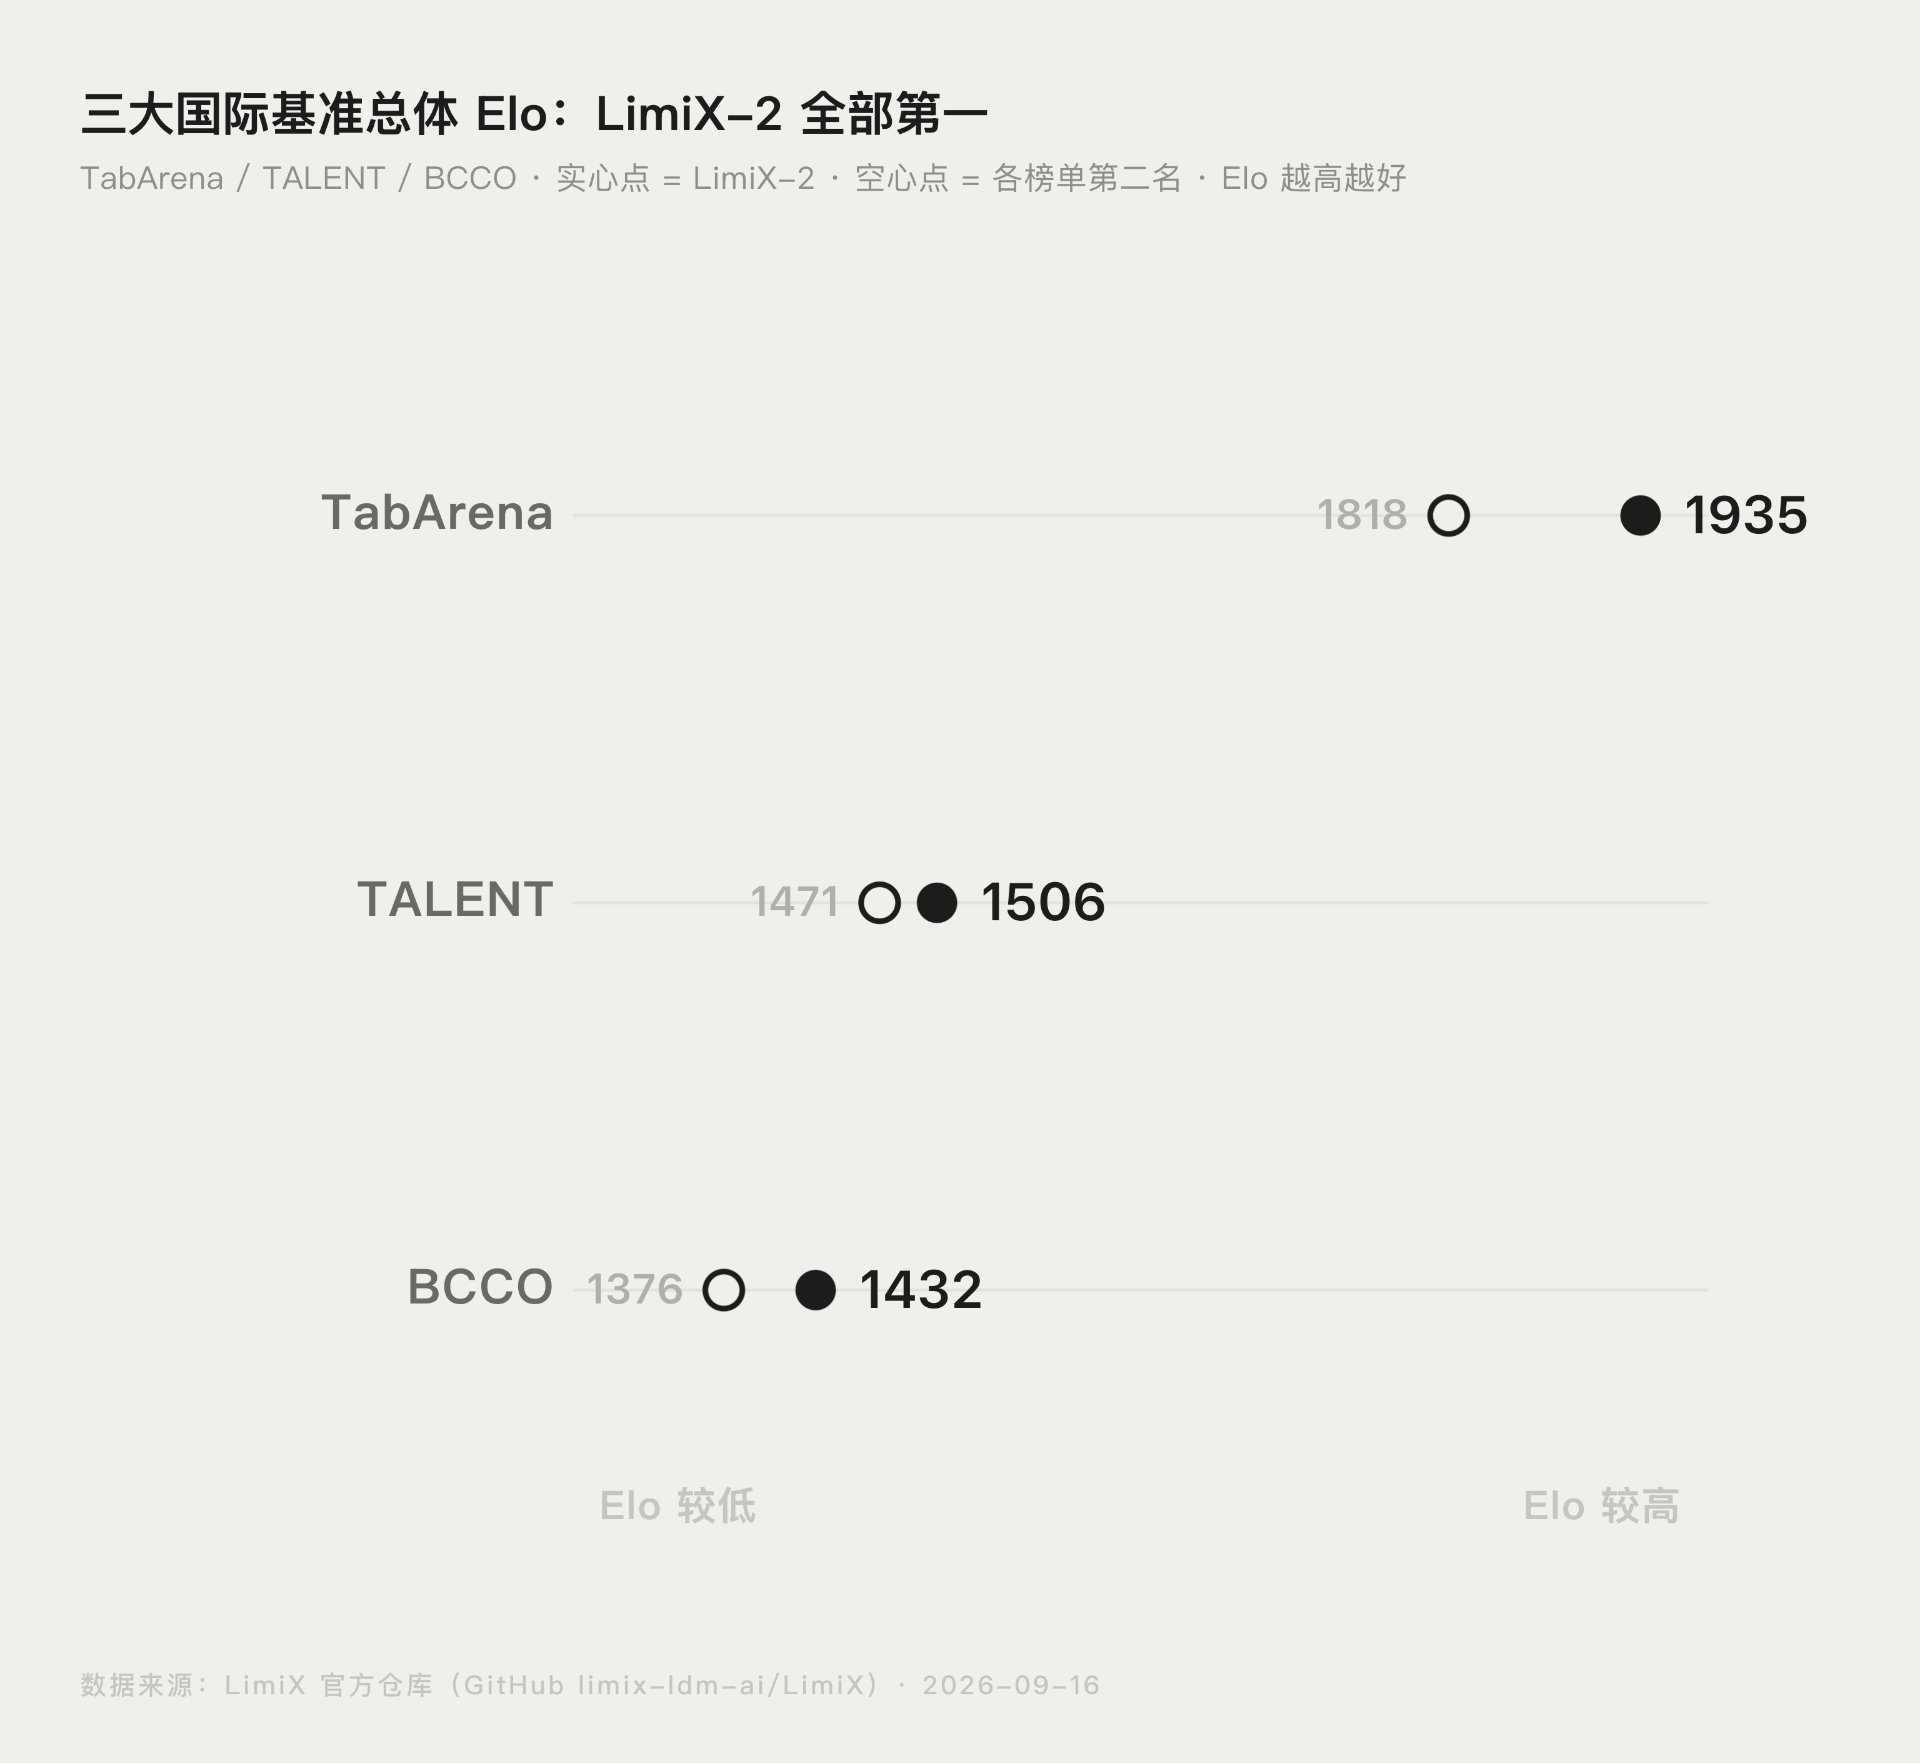
衡量结构化数据模型,目前业内看三个基准:TabArena、TALENT 和 BCCO。Elo 是从围棋、电竞借来的综合排名分,越高越好。LimiX-2 的总体 Elo 分别为 1935、1506、1432,三个榜单全部第一,量子位报道称其"超过 Google、SAP、Amazon 等国际大厂的同类模型"。
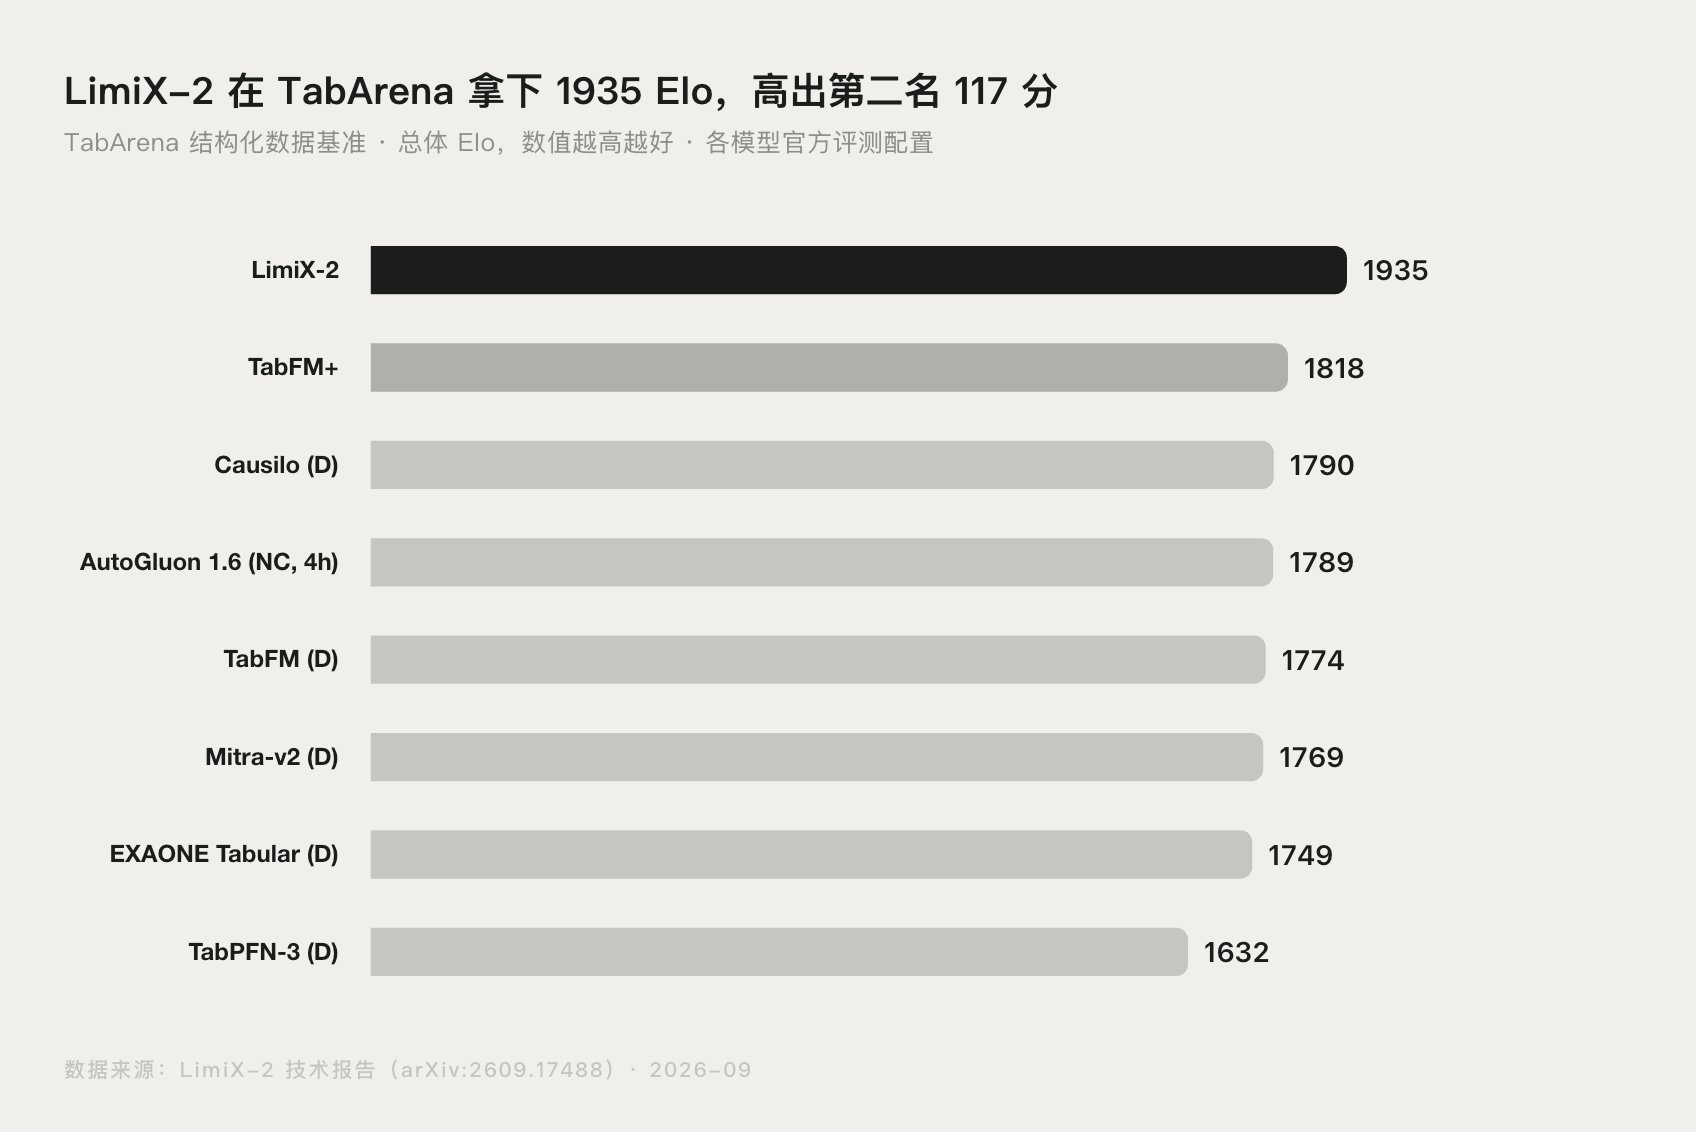
单看最有含金量的 TabArena,LimiX-2 拿下 1935 Elo,比第二名 TabFM+(1818)高出 117 分,聚合胜场约是 TabFM+ 的 3.6 倍,也超过了跑 4 小时的非商业版 AutoGluon 1.6:
| 模型 | TabArena Elo | 备注 |
|---|---|---|
| LimiX-2 (D) | 1935 | 本次发布,400M 参数 |
| TabFM+ | 1818 | 第二名 |
| Causilo (D) | 1790 | |
| AutoGluon 1.6 (NC, 4h) | 1789 | 4 小时训练配置 |
| TabPFN-3 (D) | 1632 | 上代表格基础模型 |
两个阅读提醒:其一,这些数字来自官方技术报告,各家模型的评测配置不完全相同,横向比较时留意口径;其二,Elo 高不等于在你的业务表上也一定赢,选型前建议用自己的数据跑一遍。关于跑分该怎么读,我们写过一篇《Benchmark 跑分怎么读?一次讲透排行榜背后的门道》,建议搭配食用。
和初代 LimiX、LimiX-2M 的区别:一张表看懂
| LimiX-2 | LimiX-2M | LimiX-16M(初代) | |
|---|---|---|---|
| 参数量 | 400M | 2M | 16M |
| 发布时间 | 2026-09-16 | 2025-11-10 | 2025-08-29 |
| 支持任务 | 分类 / 回归 / 缺失值插补 | 同左 | 同左 |
| 开源协议 | 非商用许可(StableAI License v1.0) | 见官方 LICENSE | Apache 2.0 |
| 适用场景 | 精度优先的服务端建模 | 端侧、消费级显卡 | 学习与旧项目兼容 |
最需要注意的一行是开源协议:初代 LimiX-16M 采用 Apache 2.0,商用友好;而 LimiX-2 的权重遵循非商用许可协议,个人学习和研究免费,商用需要向稳准智能获取授权。企业选型时不要看漏这一点。开源与闭源怎么权衡,可以参考《开源模型和闭源模型怎么选?一张对比表讲清 6 个真实成本》。
上手教程:我们在 Mac CPU 上跑通了
LimiX-2 发布当天我们就按官方 README 走了一遍,全程在一台 Apple Silicon Mac 上、只用 CPU(无独立显卡)完成,供没有 GPU 的读者参考。
环境要求:Python ≥ 3.12,依赖通过 pip 安装(含 torch==2.9.1)。官方推荐装 flash-attn,但 Mac 上可以跳过。
git clone https://github.com/limix-ldm-ai/LimiX.git
cd LimiX
python -m pip install -e .
然后从 HuggingFace 下载 LimiX-2.ckpt(约 400MB),参考官方 demo_classification.py 写几行预测代码即可。我们用 sklearn 自带的乳腺癌数据集(30 维特征,284 条训练 / 285 条测试)做了二分类实测:
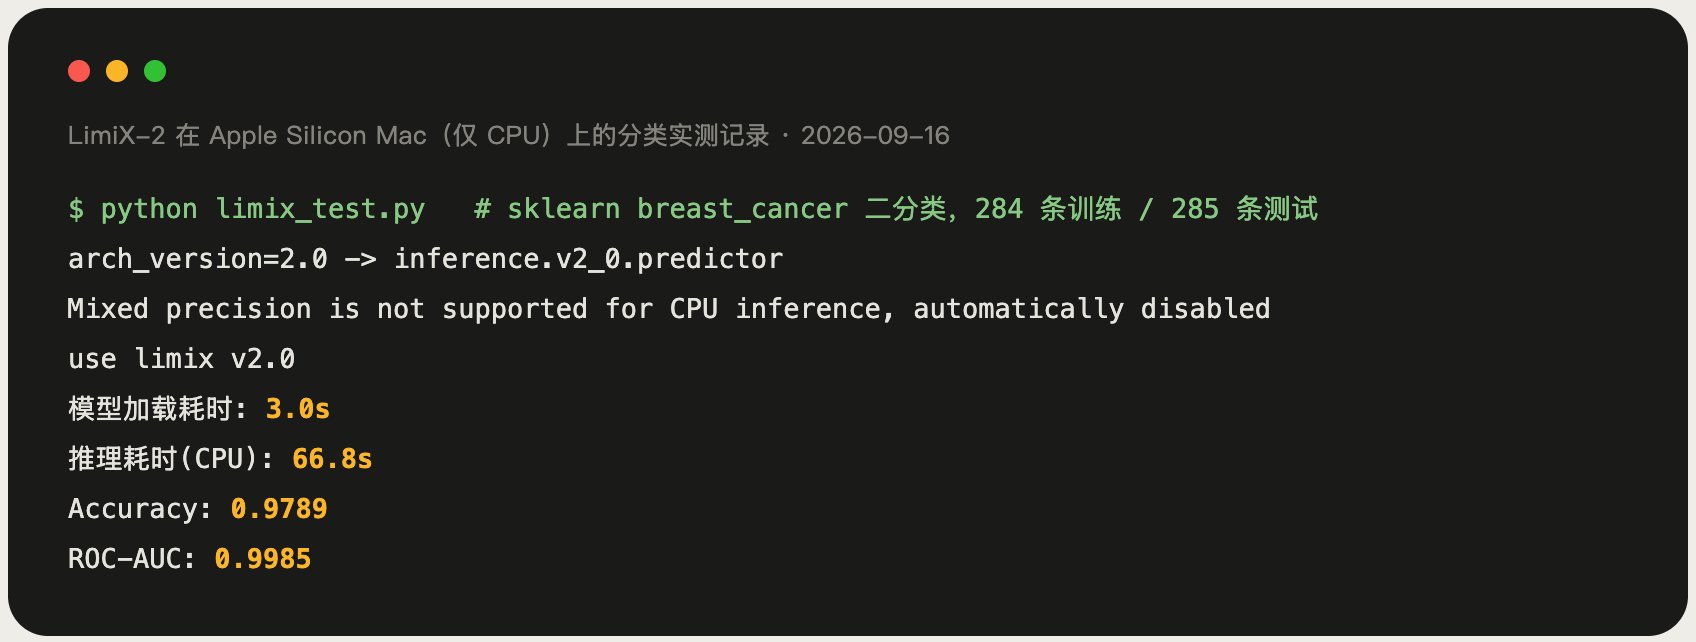
实测结果:模型加载 3.0 秒,CPU 推理 66.8 秒,Accuracy 0.9789,ROC-AUC 0.9985。一个 400M 的基础模型,没做任何微调,直接在小样本表格任务上拿到 97.9% 准确率,这是它"基础模型"定位最直观的体现。
几个我们踩过的坑,官方文档没有明说:
- **macOS 上会报
No module named 'triton'**:LimiX 的部分算子无条件 import triton,而 triton 没有 macOS 版轮子。好在一进场就提示 "Mixed precision is not supported for CPU inference",实际推理走的是 torch 实现,补一个空的 triton 占位模块即可跑通。 - **默认缓存目录写死在
/mnt/public/...**:Linux 服务器没问题,Mac 上是只读文件系统,需要把inference/v2_0/predictor.py里的cache_dir改成本地路径。 - 406M 权重 + torch 环境:建议提前确认磁盘和内存余量;回归任务直接返回原始量纲,不用自己再做反归一化。
如果不想折腾本地环境,也可以等 ModelScope 或 HuggingFace 上的在线体验入口。想在本地跑更多开源模型的读者,可以看我们的《本地部署大模型需要什么配置?一张表看显存门槛》。
LimiX-2 适合谁用
- 数据科学家 / 算法工程师:把 LimiX-2 当作表格任务的新基线。小样本、多任务、不想逐个调参的场景,值得一试。
- 业务分析师:缺失值填补是现成能力,脏数据预处理的效率会明显提升。
- 企业数据团队:因果骨架发现是一个差异化能力,适合做变量关系探索;但商用前务必确认授权。
- 不适合的场景:聊天、写作、代码等文本任务它一概不管,那是 LLM 的地盘。
总结
LimiX-2 把"结构化数据基础模型"的标杆拉到了新高度:三大国际基准 Elo 全部第一、一个模型通吃三类表格任务、发布当天即开源。对我们普通用户来说,最实际的三个信息是:个人使用免费、Mac 无显卡也能跑、商用要谈授权。它是发布仅一天的新模型,跑分与真实业务数据之间的差距还有待更多实践检验,我们会持续跟进更新。
最后更新:2026 年 9 月 16 日 · 作者:AI345 信息来源:LimiX-2 技术报告(arXiv:2609.17488)、LimiX 官方 GitHub 仓库、量子位报道;实测数据来自 AI345 在 Apple Silicon Mac 上的本机运行记录。
常见问题
LimiX-2 免费吗?
个人学习和研究免费,权重在 HuggingFace 开源可下载。但注意 LimiX-2 采用非商用许可协议(StableAI License v1.0),商业使用需要向稳准智能申请授权;需要商用友好的话,初代 LimiX-16M 仍是 Apache 2.0 协议。
LimiX-2 和 ChatGPT 这类大模型有什么区别?
它们处理的数据形态完全不同。ChatGPT 处理文本(提示词、文章、代码),LimiX-2 处理结构化数据(表格里的数值列、类别列)。你的客户流失预测、销量回归、缺失数据修复是 LimiX-2 的主场,但让它写周报就问错了问题。
LimiX-2 需要什么硬件配置?
门槛不高。400M 参数属于小模型量级,我们在 Apple Silicon Mac 上纯 CPU 就跑通了官方示例(实测推理 66.8 秒),有 NVIDIA 显卡会快很多。显存和配置入门可以看我们的本地部署硬件要求一文。
LimiX-2 和 TabPFN、AutoGluon 怎么选?
官方评测里 LimiX-2 的 Elo 领先 TabPFN-3 超过 300 分,也超过 4 小时配置的 AutoGluon 1.6。但 AutoGluon 的工程生态更成熟,LimiX-2 刚发布、社区实践还很少,建议用自己的数据各跑一遍再定。
LimiX-2M 和 LimiX-2 有什么区别?
LimiX-2M 是 2025 年 11 月发布的轻量版,只有 2M 参数,主打消费级显卡和端侧部署,已被 ICML 2026 录用;LimiX-2 是 2026 年 9 月发布的大版本,400M 参数、精度更高。资源充裕选 LimiX-2,端侧场景看 LimiX-2M。
LimiX-2 是哪家公司做的?
由清华大学计算机系崔鹏教授团队联合稳准智能(Stable AI)研发。2025 年 8 月首次开源初代 LimiX,2026 年 1 月"极数"在雄安新区正式发布,9 月 16 日发布本文主角 LimiX-2。
 京ICP备2024094994号-29