
Benchmark 跑分怎么读?一次讲透排行榜背后的门道
Benchmark 跑分就像学生的模拟考成绩:卷子统一、阅卷客观,但模拟考高分不等于工作能力强。看懂排行榜的关键,是搞清楚每张「卷子」在考什么、有没有人提前「背题」。这篇一次讲透。
Benchmark 跑分是怎么产生的?
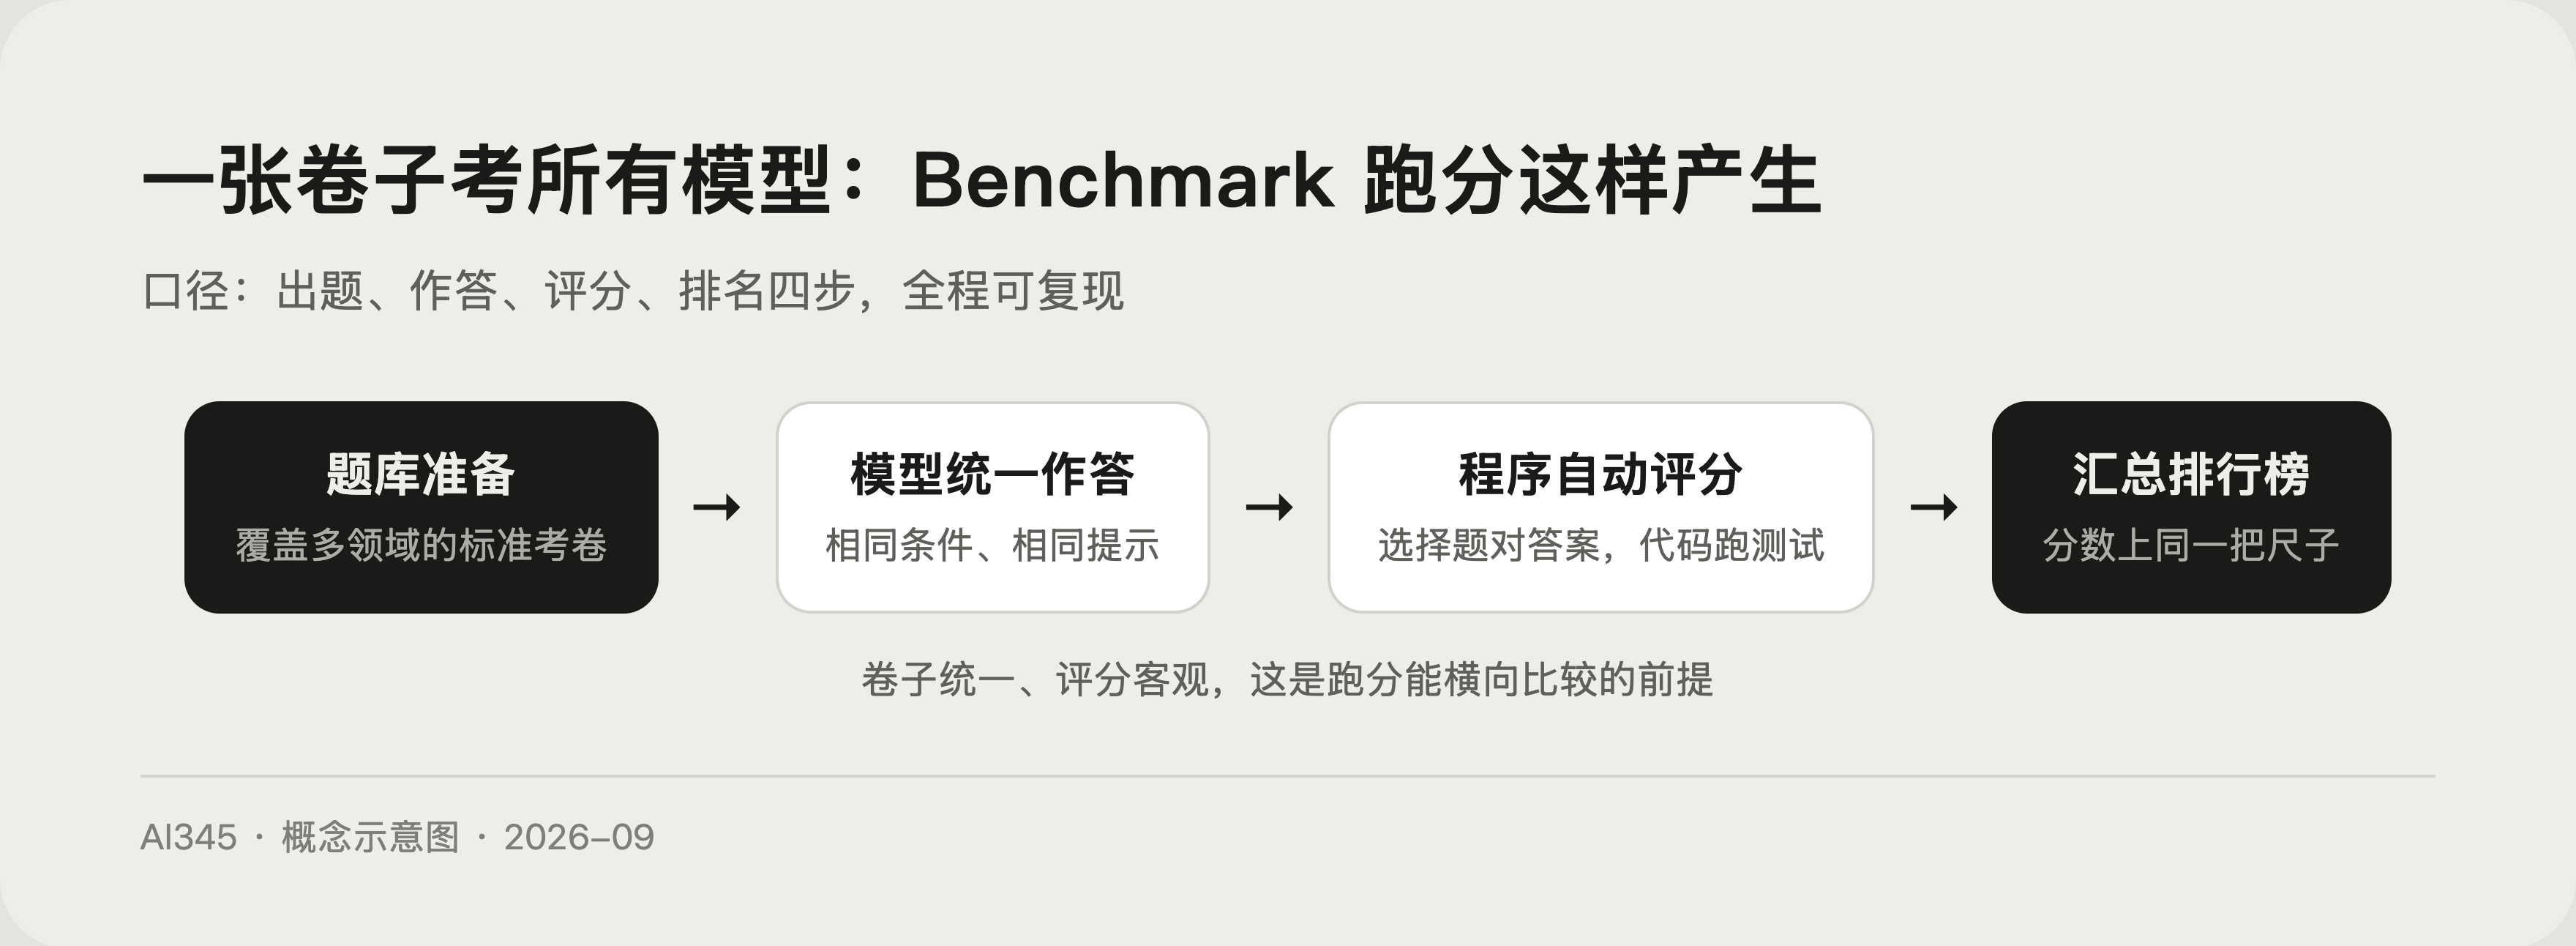
把大模型想象成一个学生,Benchmark(基准测试)就是主办方提前出好的一套标准考卷。流程分四步:先准备覆盖多个领域的题库;再让所有模型在相同条件下作答;然后用程序自动评分,选择题对答案、代码题直接跑测试用例;最后汇总成分数和排行榜。
以知识考试类的 MMLU 为例,它由研究者 Dan Hendrycks 等人于 2020 年提出,覆盖初等数学、美国历史、计算机科学、法律等 57 类任务,考察模型的知识广度和问题解决能力(MMLU 原论文)。代码类的 HumanEval 则出自 OpenAI 2021 年的 Codex 论文,让模型补全函数,再用单元测试判分(HumanEval 论文)。
模型为什么能「答题」?因为预训练阶段它已经读完海量文本,底层机制可以延伸阅读站内的预训练是什么和大语言模型是怎么工作的。
常见榜单都在测什么?
- 知识考试类:MMLU、GPQA 这类选择题卷,测知识储备与学科推理,类似文理综考试。
- 代码类:HumanEval、SWE-bench,让模型写代码并运行测试,类似上机实操。
- 人类盲测类:真人给两个匿名模型的回答投票,测用户更愿意用谁,类似面试官盲选。
- 推理与数学类:专门考多步推理,类似奥数卷。
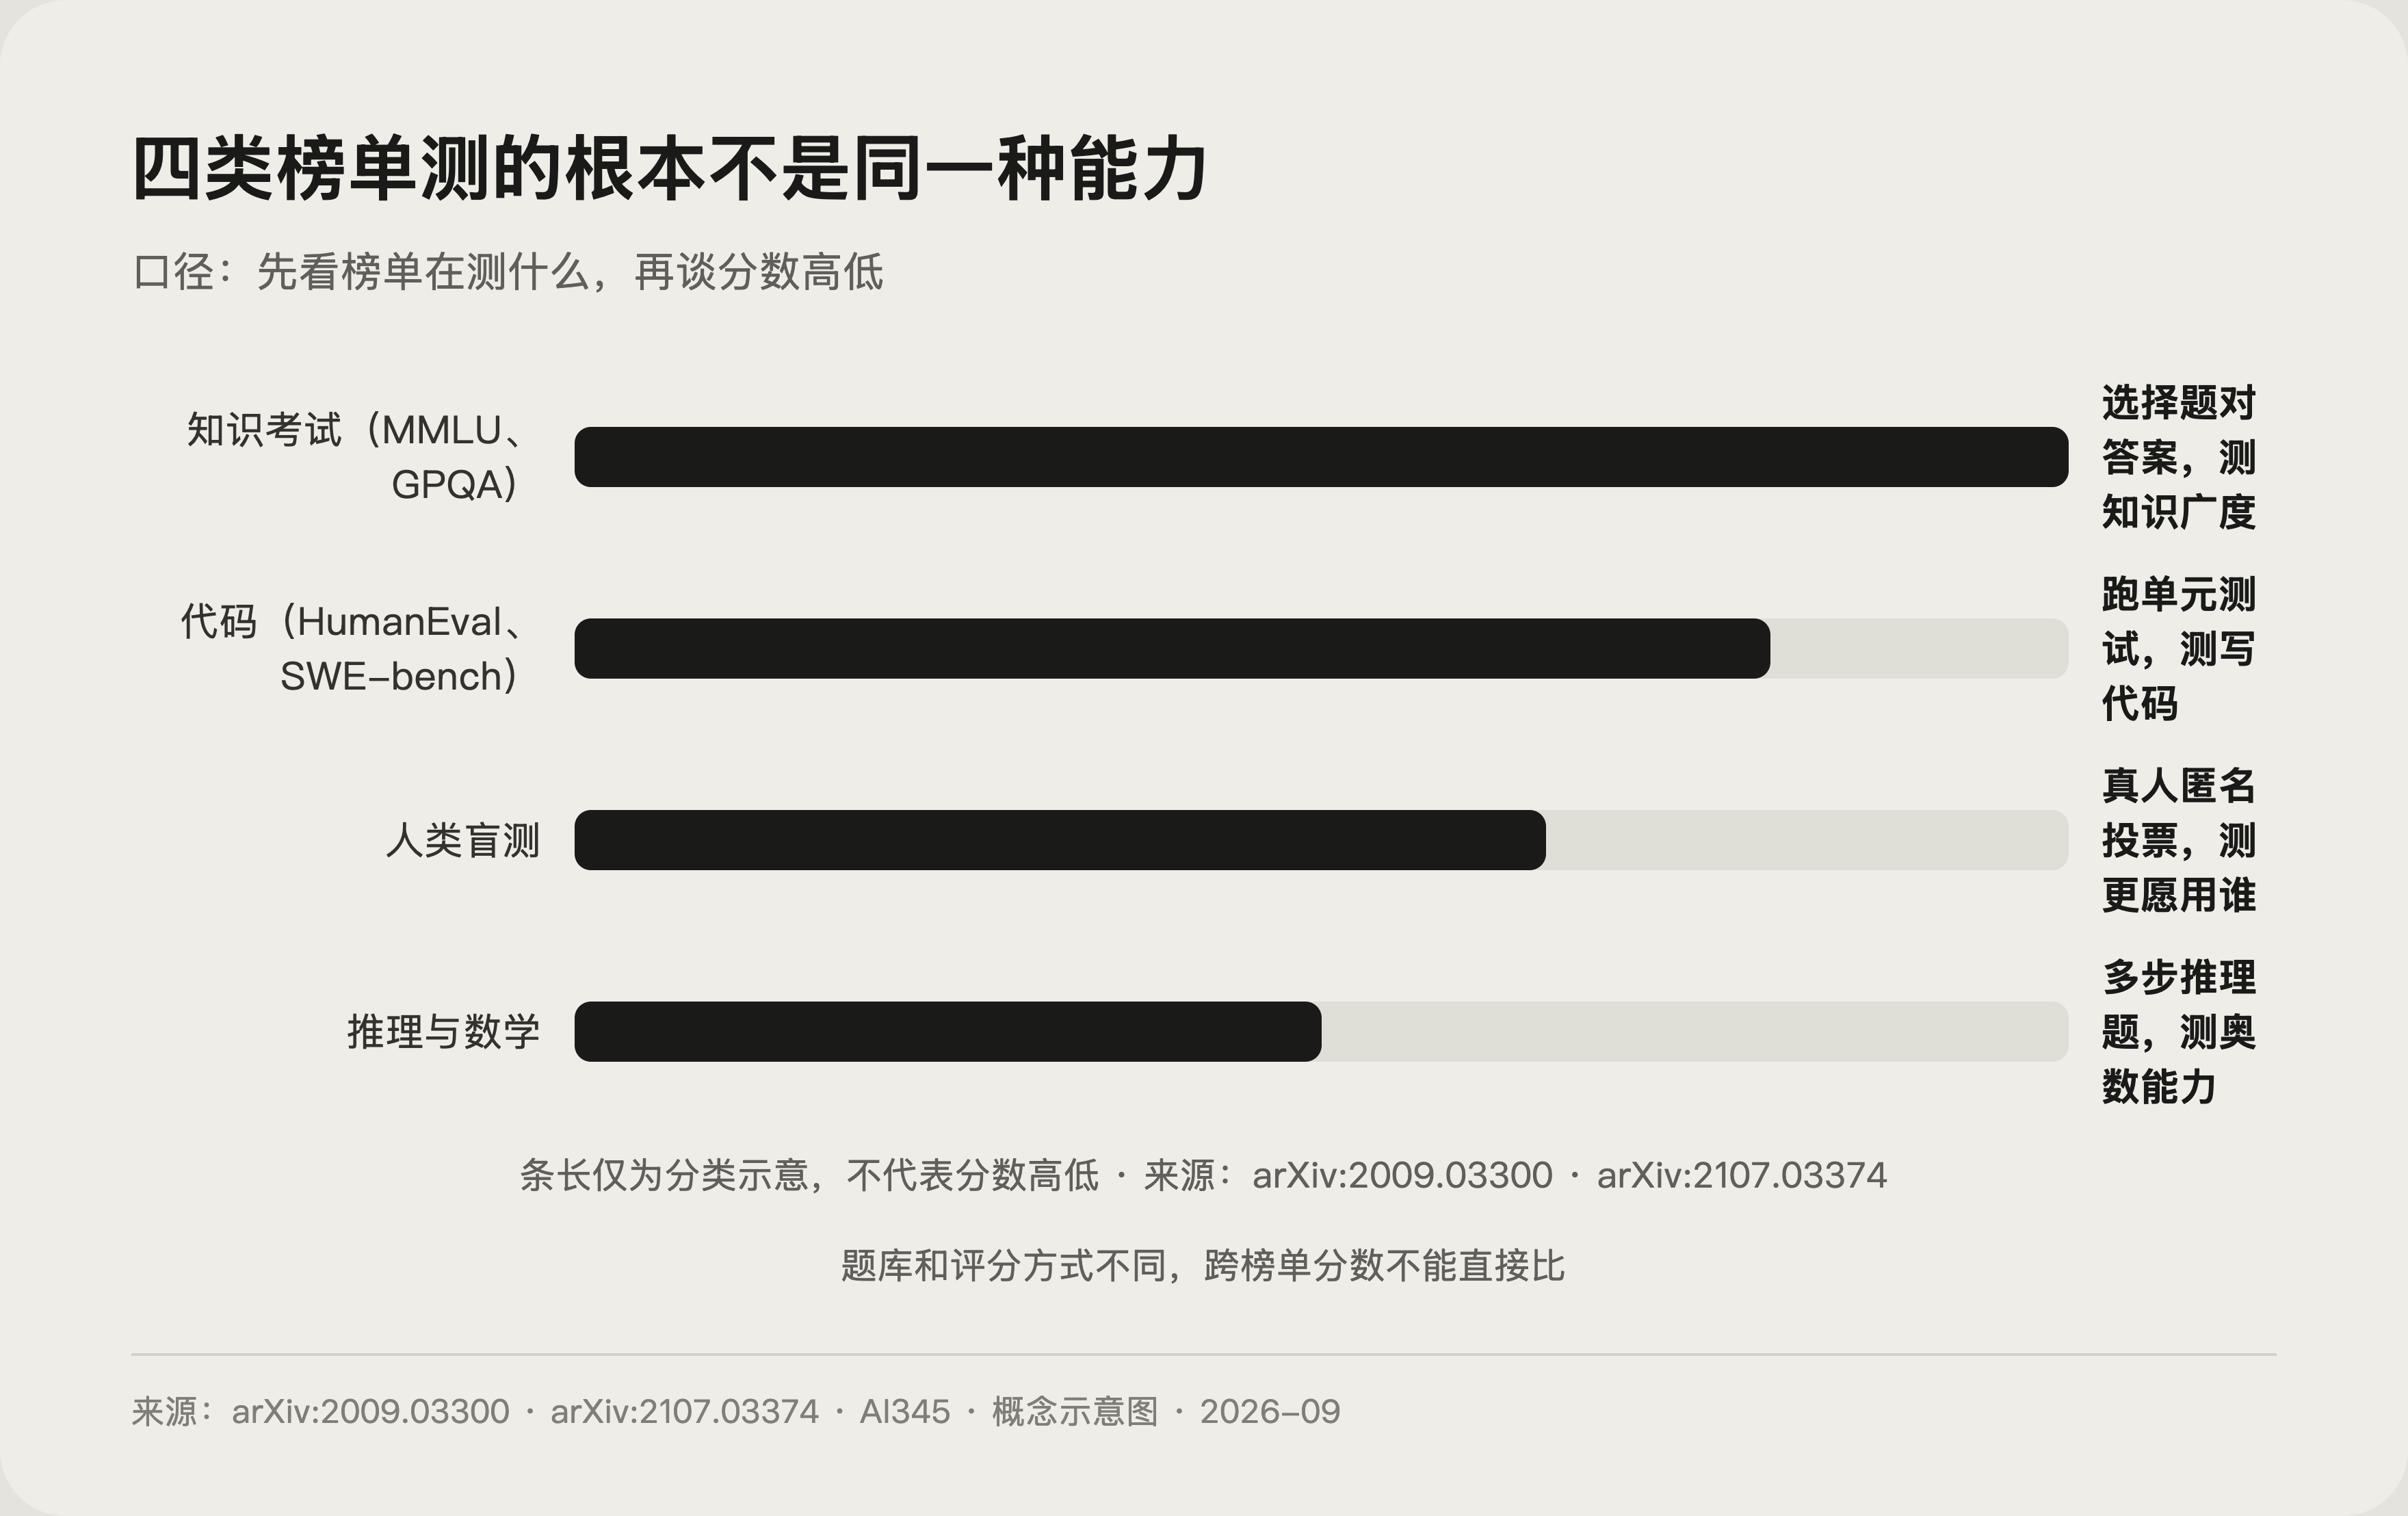
要注意,不同榜单之间的分数不能直接比:题库不同、评分方式不同,就像月考和奥赛的分数没有可比性。看任何一个榜,先看它测的是什么。
排行榜第一,为什么可能不好用?
陷阱一:模型可能提前背题
最常见的刷分方式是数据污染:考题混进了训练数据,模型不是会做,是背过。相当于模拟卷提前泄露,分数再高也说明不了真实水平。这也是为什么严肃的评测机构会定期换题、做私下测试。
陷阱二:模型可能偏科
MMLU 原论文自己就提醒:模型在不同任务上表现很不均衡,而且经常意识不到自己答错了。总分第一的模型,可能恰好在某个你关心的任务上偏弱。看分项成绩,比看总分更有参考价值。
陷阱三:考试能力和好用是两回事
OpenAI 的 InstructGPT 实验是个著名例子:经人工反馈调教后的 1.3B 小模型,在人类偏好评估中反而胜过 175B 的 GPT-3,而它在公开跑分上只有极小的退步。分数接近,体验可能差很远。
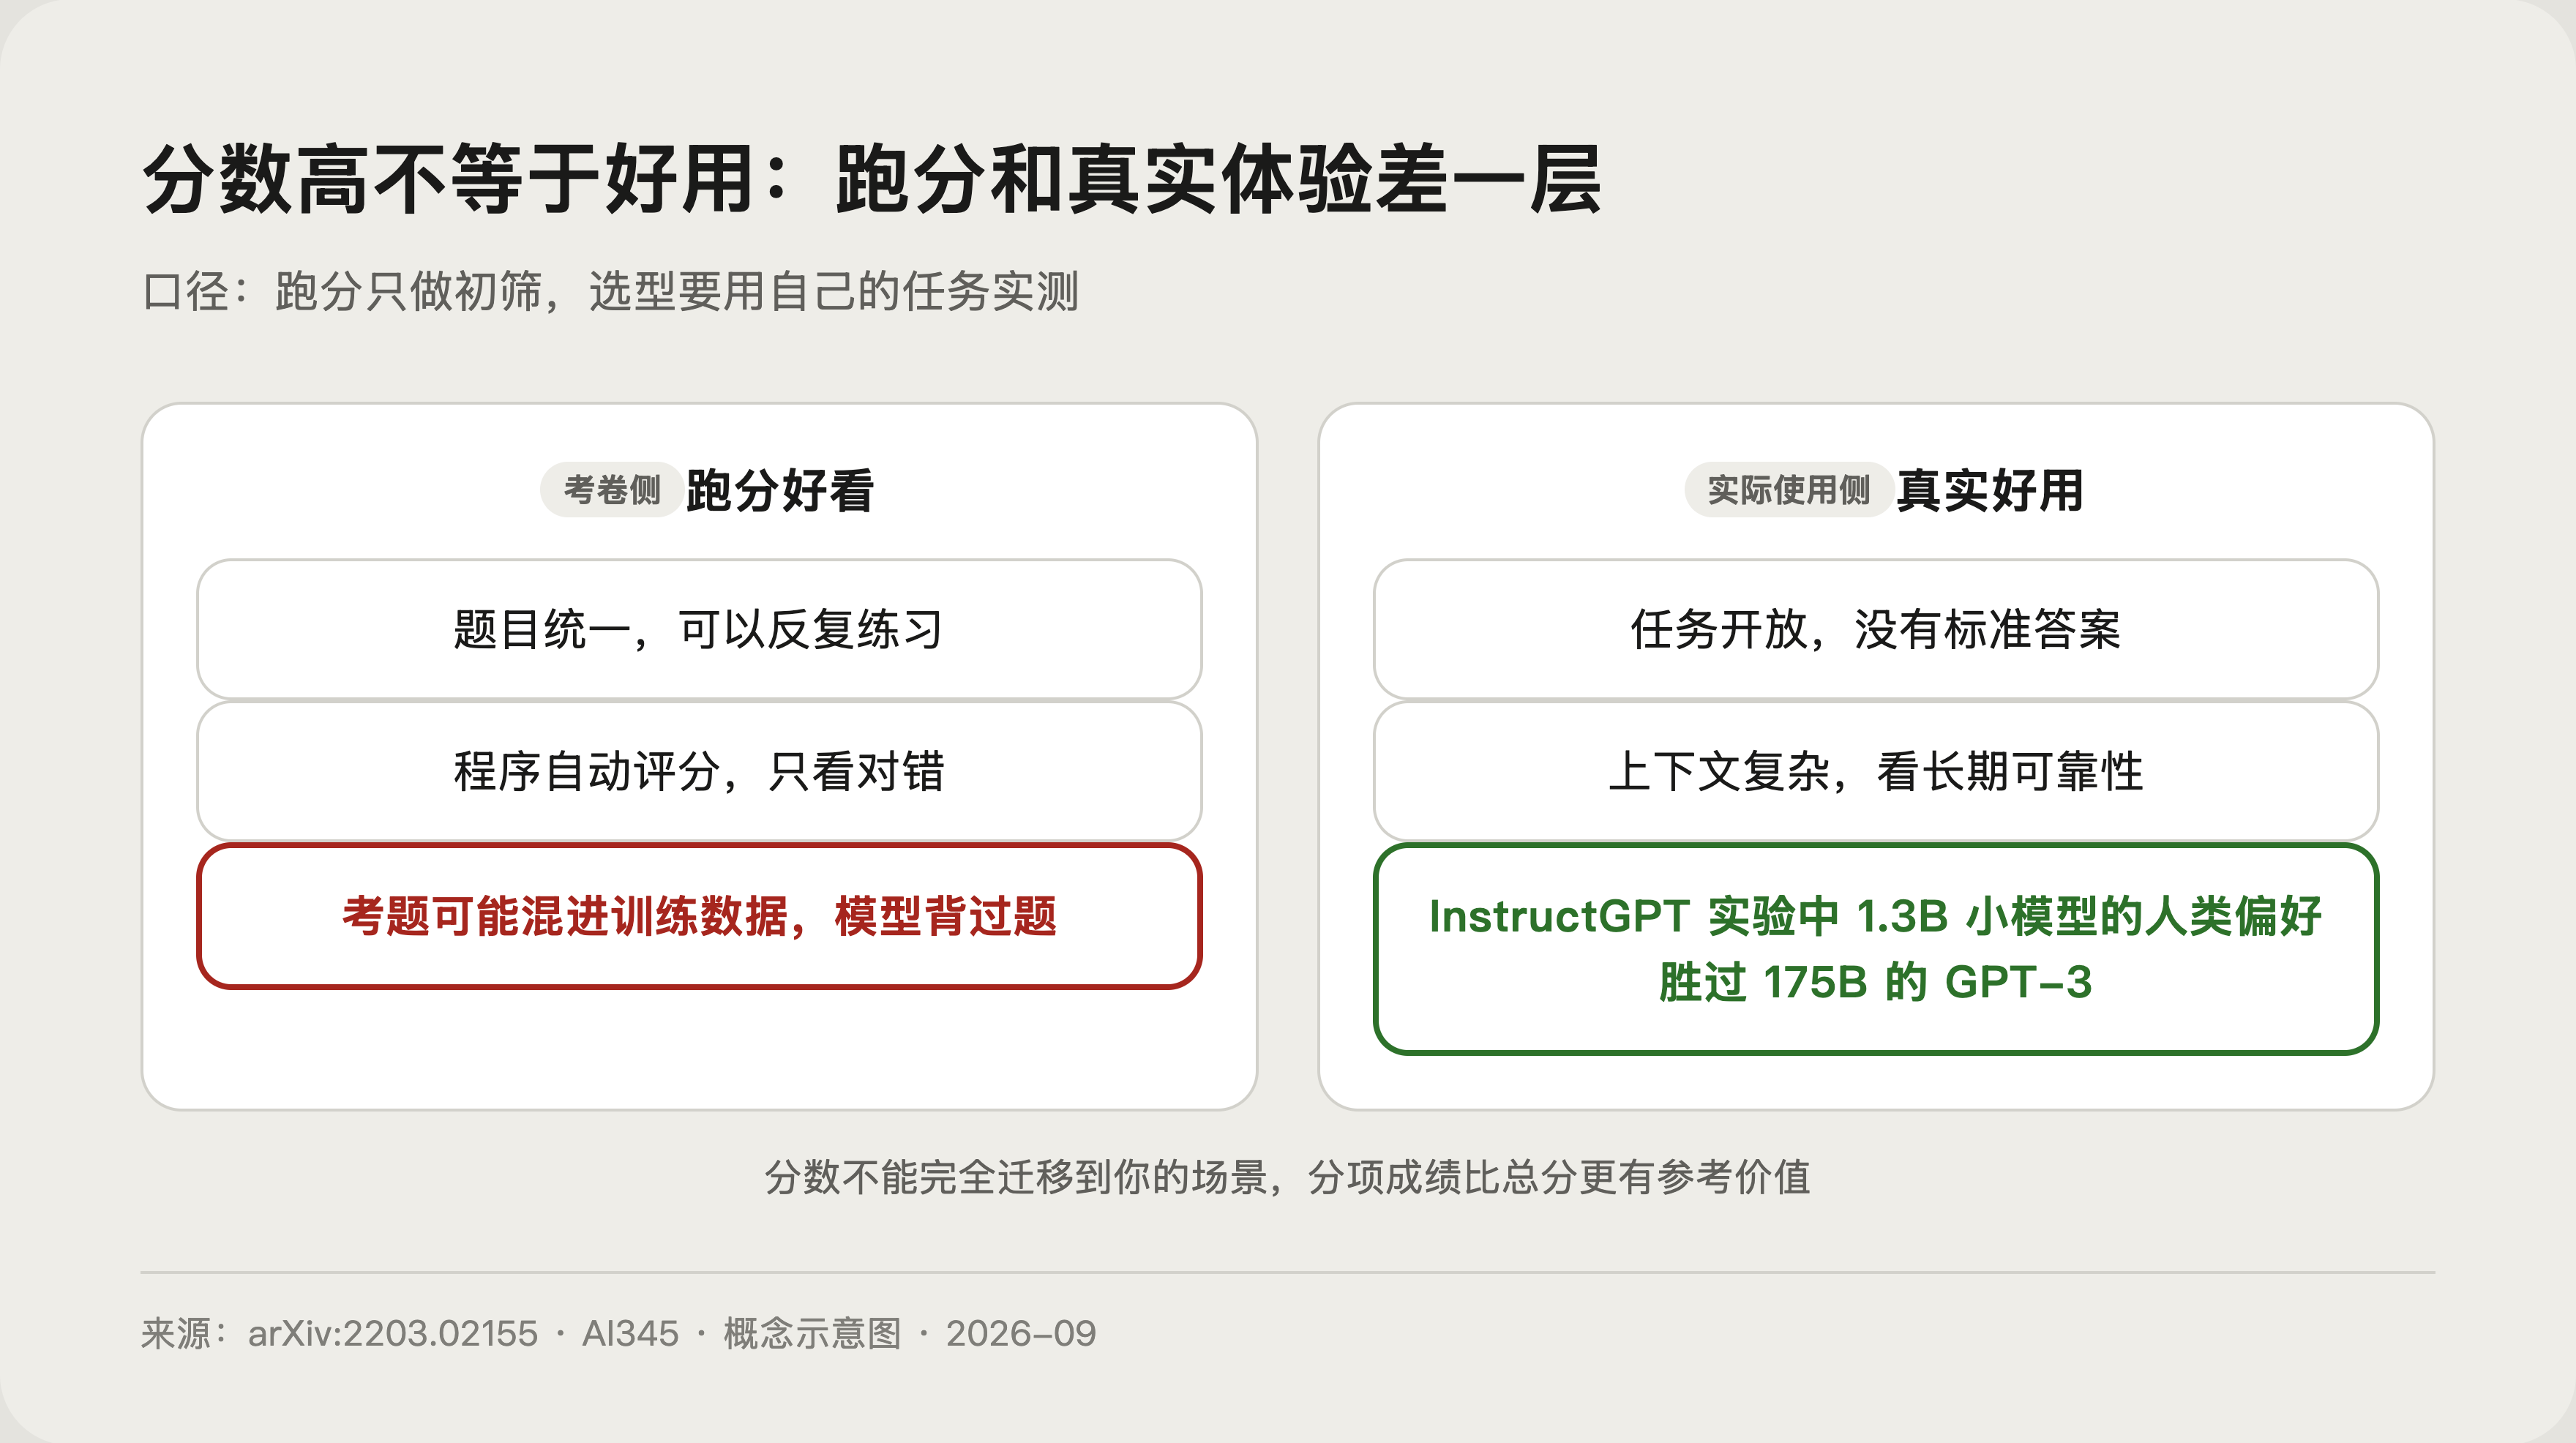
这层差异还有个来源:模型在预训练之外还要经过人类反馈的调教,机制见站内的强化学习是什么。如果你关心 Agent 场景怎么评,可以看这篇AI Agent 评测怎么做。
一段话讲清 Benchmark 跑分?
「Benchmark 是给大模型出的标准考卷,用统一题库和自动评分,把不同模型放到同一把尺子上比较。常见榜单分知识考试、代码、推理和人类盲测几类。看榜要留三个心眼:一是数据可能污染,模型背过题;二是模型会偏科,总分高不代表你关心的场景强;三是考试能力和真实体验不是一回事,跑分只做初筛,选型要结合自己的任务实测。」
三个实用的看榜建议
- 优先看榜单是否定期换题、防污染,老榜单的分数要打折看。
- 别只看总分,找和自己业务场景相关的分项成绩。
- 跑分只做初筛,进入候选后用自己的真实任务小规模实测,体验说话。
一句话带走:跑分是体检报告,不是工作简历。它能提示哪里可能有问题,但不能保证模型在你手里真能干活。
常见问题
跑分高的模型一定适合我的业务吗?
答:不一定。跑分反映的是标准考卷上的表现,你的业务可能偏重榜单没覆盖的场景。正确做法是先按跑分初筛,再用自己的真实任务实测。
什么是数据污染?
答:指评测考题混入了模型训练数据,模型靠「背题」拿高分而不是真会做。GPT-3 论文作者就提到过在网页语料上训练带来的这类方法论问题。
人类盲测的排行榜更可信吗?
答:它更难刷分,能反映真实偏好,但结果受投票人群构成影响,且无法精确到具体技能项。适合看整体口碑,不适合做精细选型依据。
MMLU 是什么?
答:一个覆盖 57 类任务的知识考试基准,2020 年由 Hendrycks 等研究者提出,是衡量模型知识广度最常用的榜单之一。
怎么快速验证一个模型好不好用?
答:准备 10 到 20 条你业务里的真实任务,固定提示词,把候选模型跑一遍,对比成功率和输出质量。这比任何排行榜都直接。
 京ICP备2024094994号-29