
强化学习是什么?从 AlphaGo 到 ChatGPT,AI 怎么学会
强化学习是让 AI 用“试错加奖惩”自己学会做决策的方法:没有人给它标准答案,它先随机尝试,试对了给奖励,试错了给惩罚,在一次次反馈中慢慢逼近最优策略。从下围棋的 AlphaGo 到会聊天的 ChatGPT,都靠它完成关键一跃。
一个游戏玩家的比喻
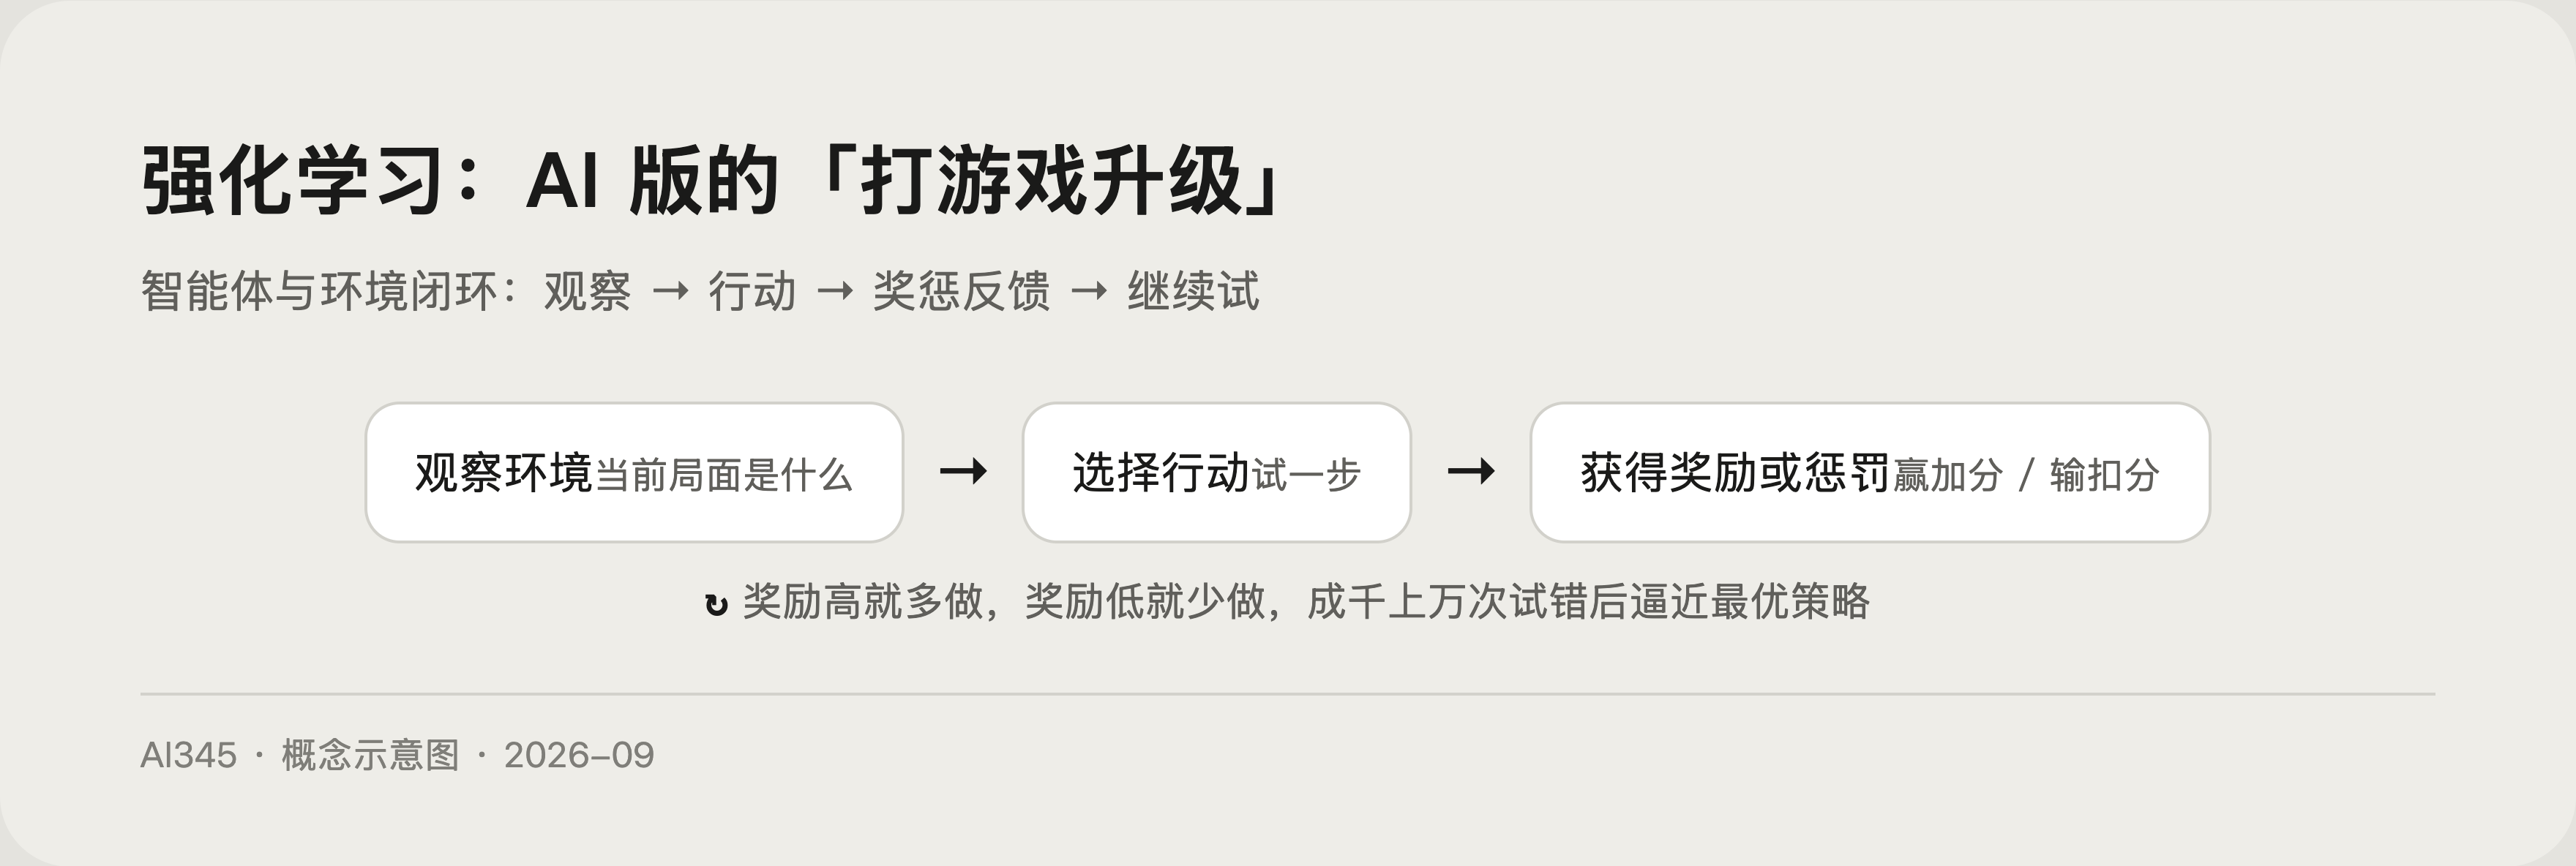
强化学习的工作方式,和打游戏升级几乎一模一样:
- 观察局面:读取当前状态,比如棋盘上的落子、游戏里的血条。
- 采取行动:按现有经验出招。
- 获得反馈:赢棋加分、输棋扣分,对应游戏里的经验值和金币。
- 更新策略:把刚才那步的出招概率调高或调低,下次打得更好。
重复几百万次之后,角色就从见招乱打的新手,长成算路深远的段位玩家。整个过程没有人教它“第 37 手该下在哪”,所有策略都是自己试出来的。
和监督学习差在哪:照答案学 vs 自己试
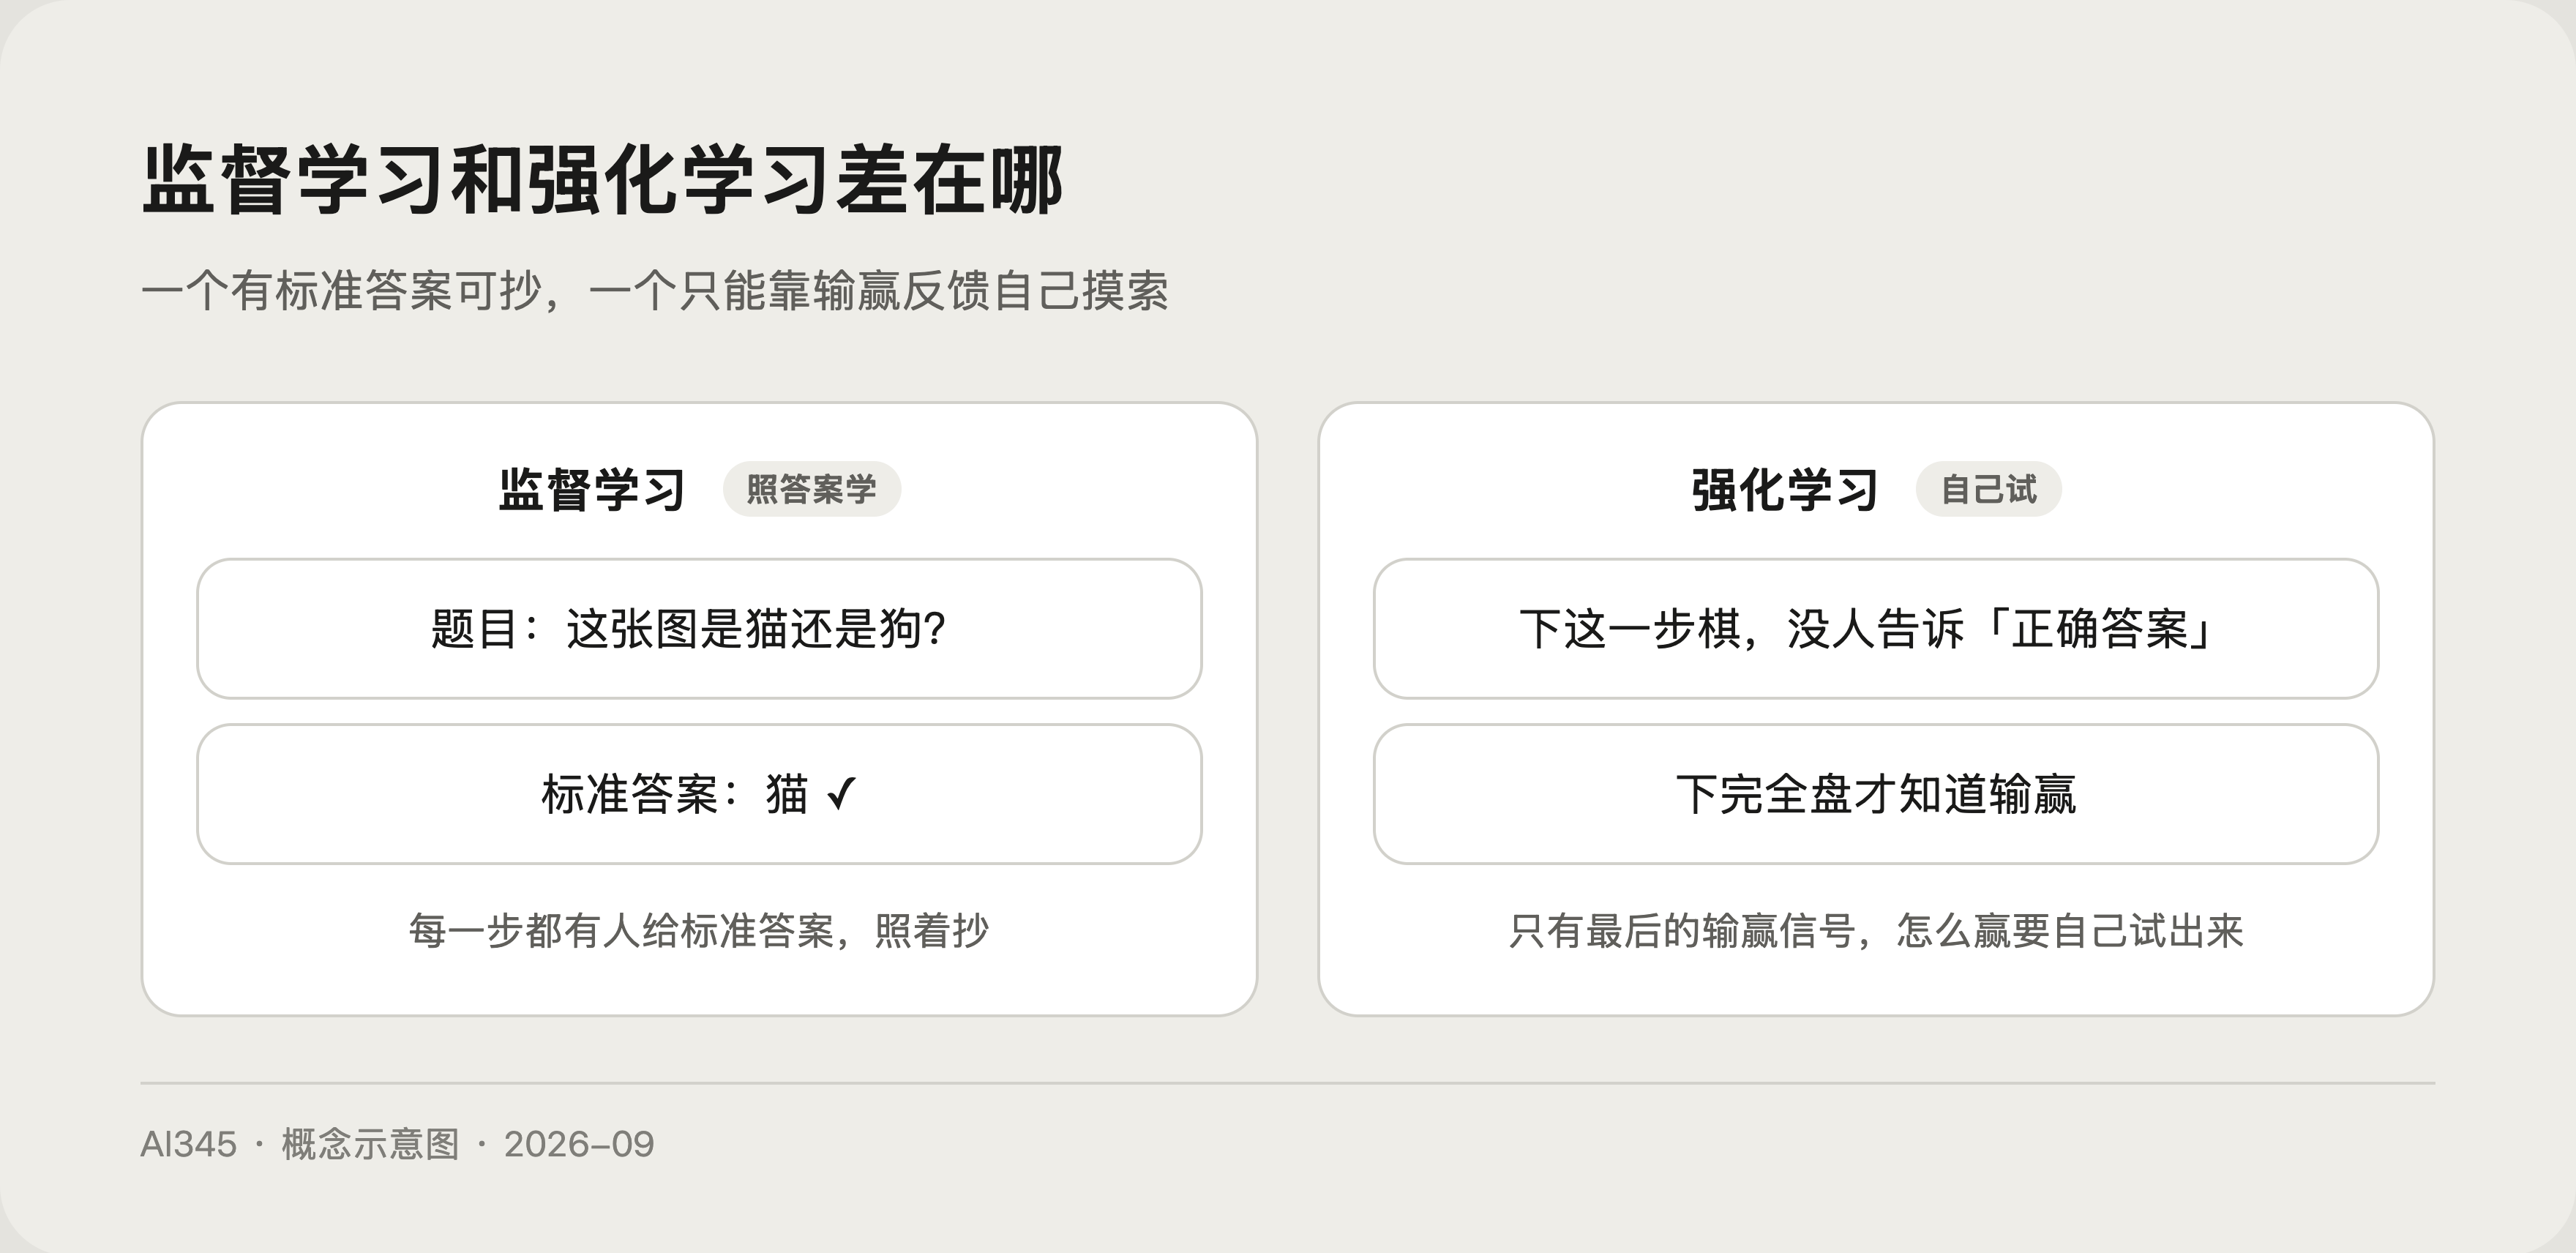
这是最常被对比的一组概念。监督学习像对着标准答案刷题库:每道题都附正确答案,模型照着模仿就行,学认图、学翻译都是这类。强化学习没有标准答案,只有一个延迟到来的输赢:下完一整盘棋才知道结果,而中间哪一步是败着,需要模型自己归因。
一句话区分:监督学习是“照答案学”,强化学习是“自己试出答案”。
AlphaGo:强化学习第一次出圈
2016 年 3 月,DeepMind 的围棋程序 AlphaGo 以 4 比 1 击败世界顶级棋手李世石,成为第一个在完整 19 路棋盘上无让子击败职业九段的电脑程序(2015 年 10 月它已先行击败欧洲冠军樊麾)。围棋的变化数远超可穷举范围,靠背棋谱走不远,AlphaGo 正是通过神经网络加自我对弈的强化学习,在胜负反馈中不断打磨策略。2017 年它又 3 比 0 战胜当时世界排名第一的柯洁;后续的 AlphaGo Zero 更彻底,完全不看人类棋谱、从零自我对弈,反手以 100 比 0 打赢早期版本。
RLHF:让大模型变听话
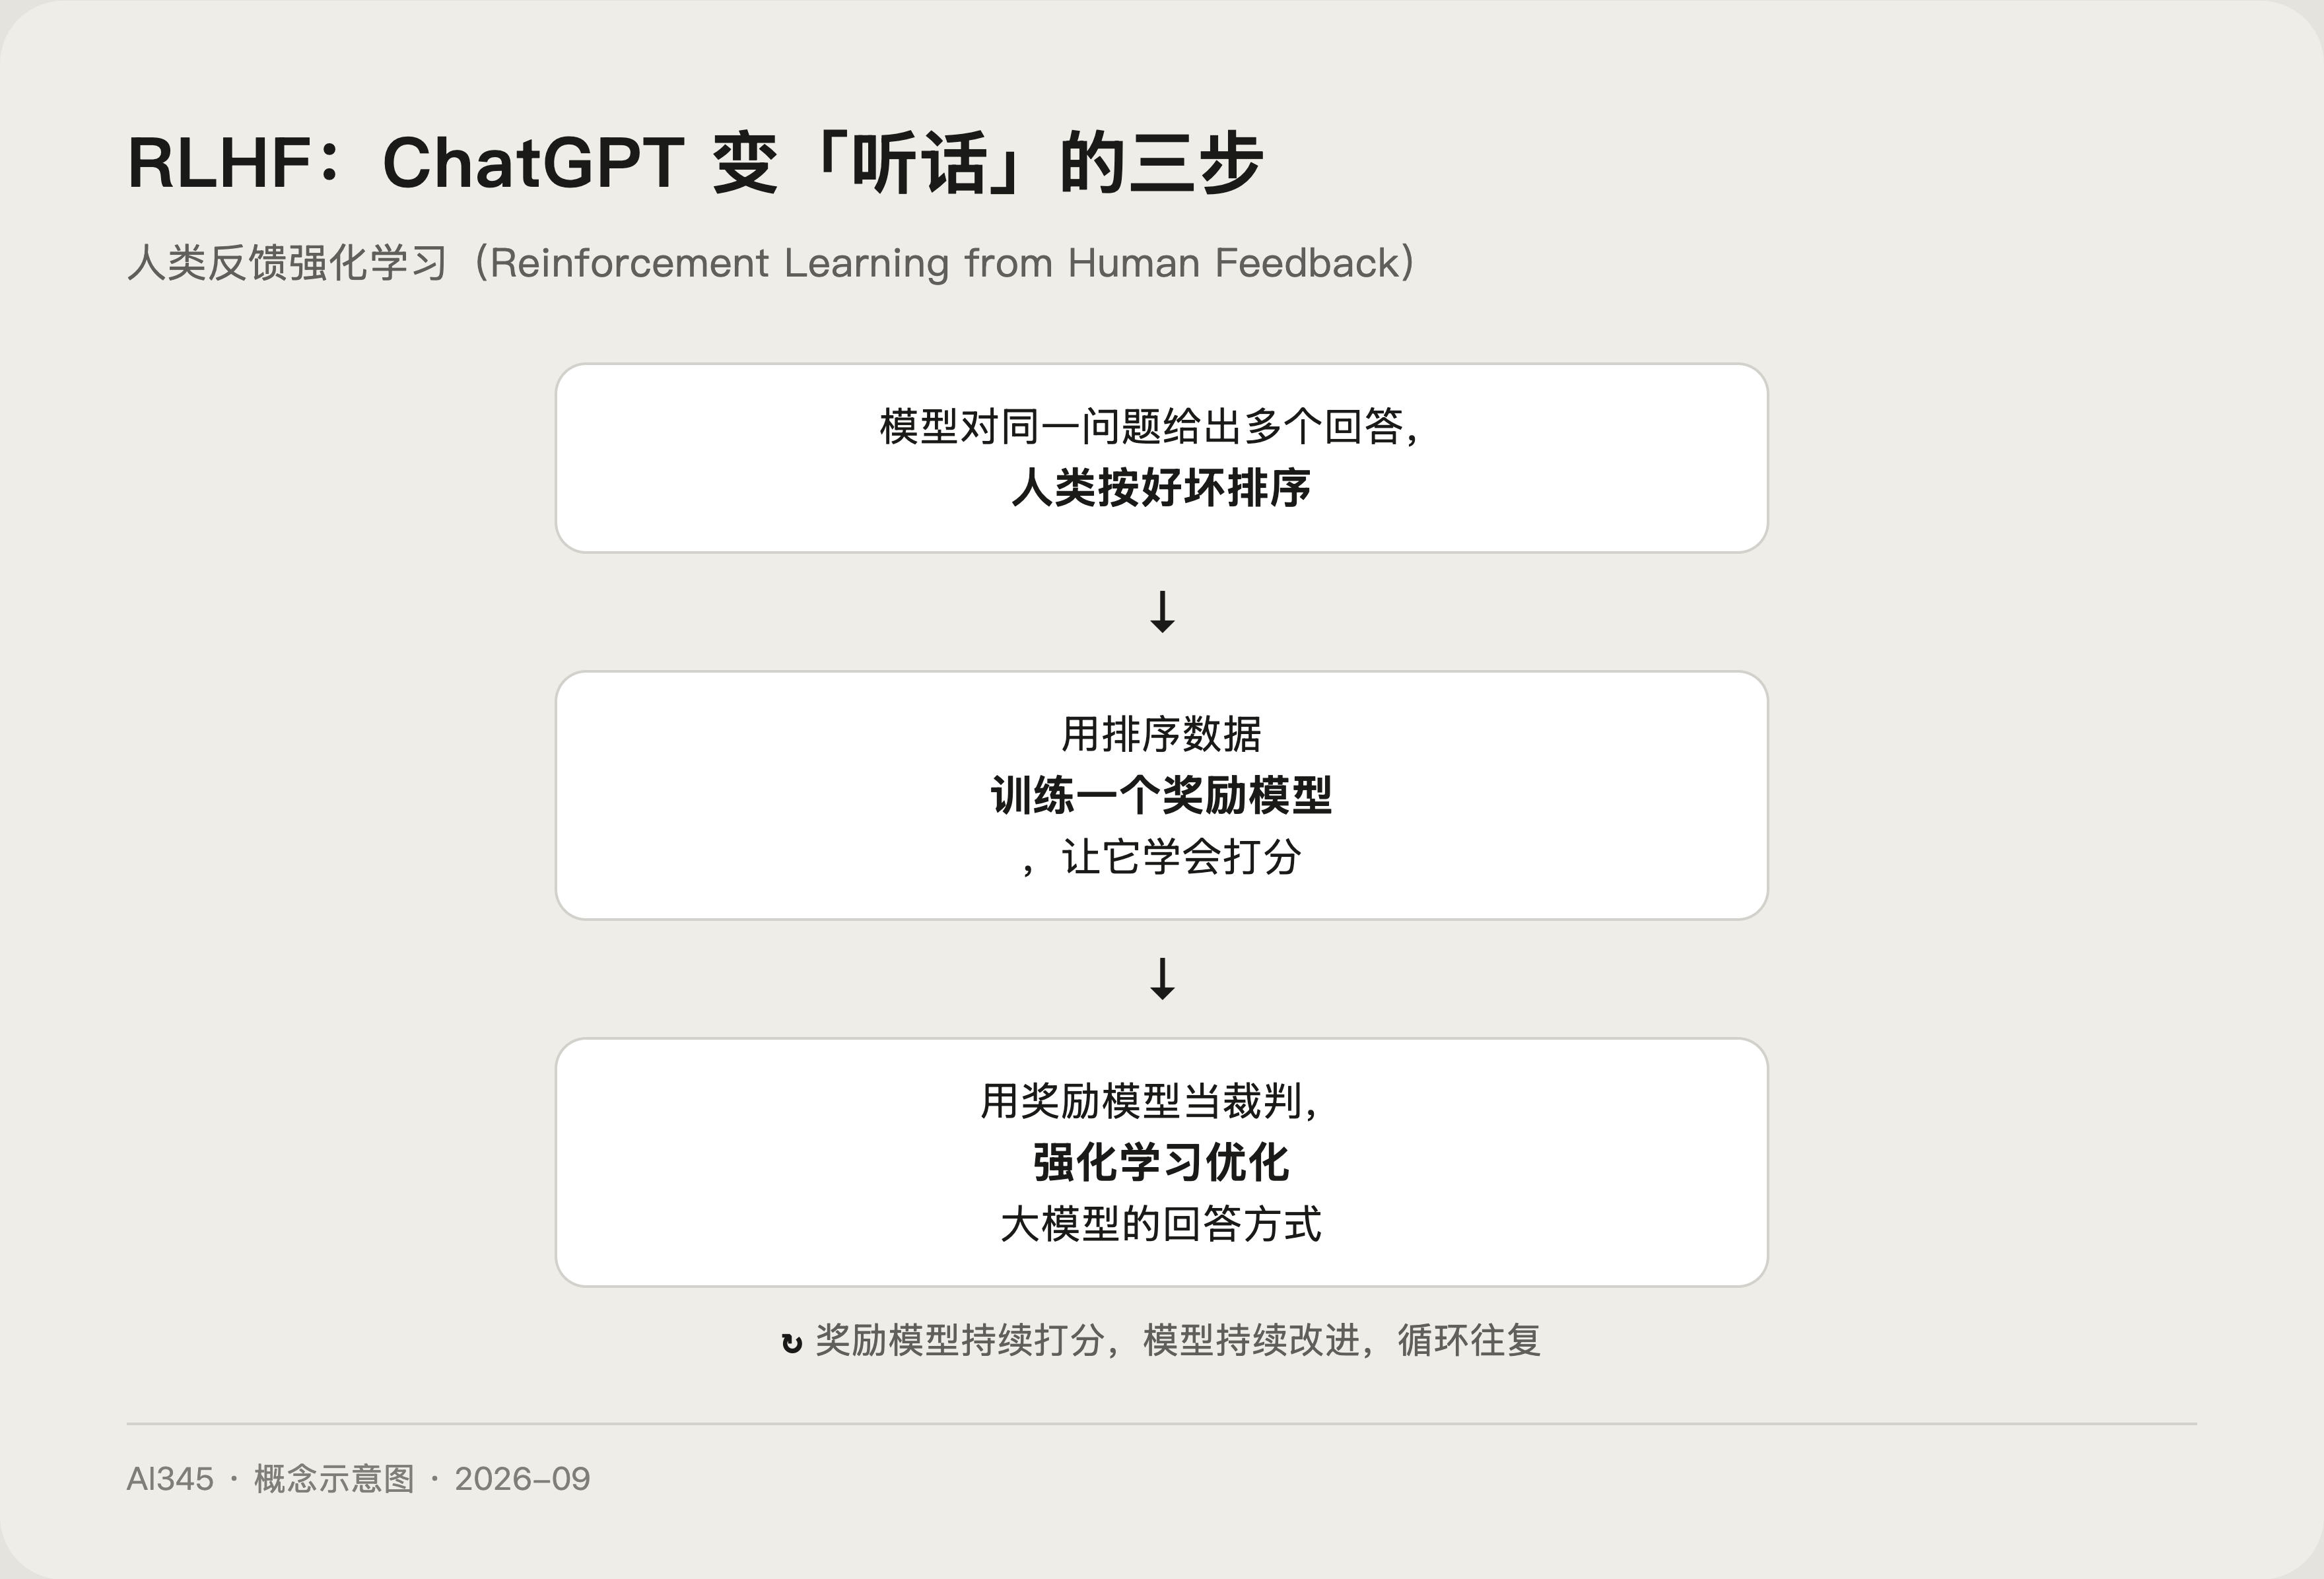
大模型刚预训练完只会“接话”,不一定符合人的意图。RLHF(基于人类反馈的强化学习)补上了这一课。Hugging Face 官方博客把它的流程拆成三步:
- 人类对模型的多个回答做排序,用这些偏好数据训练一个“奖励模型”,让它学会打分。
- 让大模型生成回答,奖励模型在旁边打分,好回答得分高、坏回答得分低。
- 用强化学习让大模型朝高分方向优化,反复迭代。
OpenAI 论文显示,经过这套流程的 InstructGPT,13 亿参数的版本反而比 1750 亿参数的原始 GPT-3 更受人类评审偏好,真实性也更高。这就是 ChatGPT 比早期 GPT-3 “听话”这么多的秘密:参数量不是全部,对齐训练很关键(见 RLHF 图解博客与 InstructGPT 论文)。
想亲手体验强化学习,可以看站内这篇不买真机也能训练机器鸭的 RL 教程;研究侧可以读微软开源 Agent Lightning 训练框架解读。理解了模型会“学”,下一步可以看AI Agent 是什么,看模型怎么把学到的能力变成行动。
常见问题
强化学习和监督学习的核心区别是什么?
答:看有没有标准答案。监督学习的每个样本都带正确标签,照着模仿即可;强化学习只有延迟的奖惩反馈,要自己探索出策略。
ChatGPT 真的用了强化学习吗?
答:用了。RLHF 是它从“会接话的 GPT-3”变成“听话的助手”的关键一步,InstructGPT 论文验证了 13 亿参数版本可以胜过 1750 亿参数的原始模型。
AlphaGo Zero 比 AlphaGo 强在哪?
答:它完全不看人类棋谱,从随机落子开始自我对弈学习,最终 100 比 0 击败了早期版本,证明强化学习可以超越人类经验本身。
经常听到的“深度强化学习”又是什么?
答:深度学习加强化学习的组合:用深度神经网络来近似策略和价值,处理棋盘、游戏画面这类复杂输入。AlphaGo 就是典型代表。
 京ICP备2024094994号-29