
Microduck RL 完整教程:不买真机,也能亲手训练你的机器鸭
Microduck RL 是机器鸭 Microduck 官方开源的强化学习训练仓库:基于 MuJoCo Warp 仿真引擎和 PPO 算法,在一块 CUDA 显卡上用 4096 个并行环境训练,约 1–2 小时就能练出一只会走路的机器鸭,训练好的策略导出为 ONNX 后可直接部署到 399 美元的真机上。没有显卡也没关系——本文给出三种零成本上手方案。
Microduck RL 是什么:一条命令就能开练的开源仓库
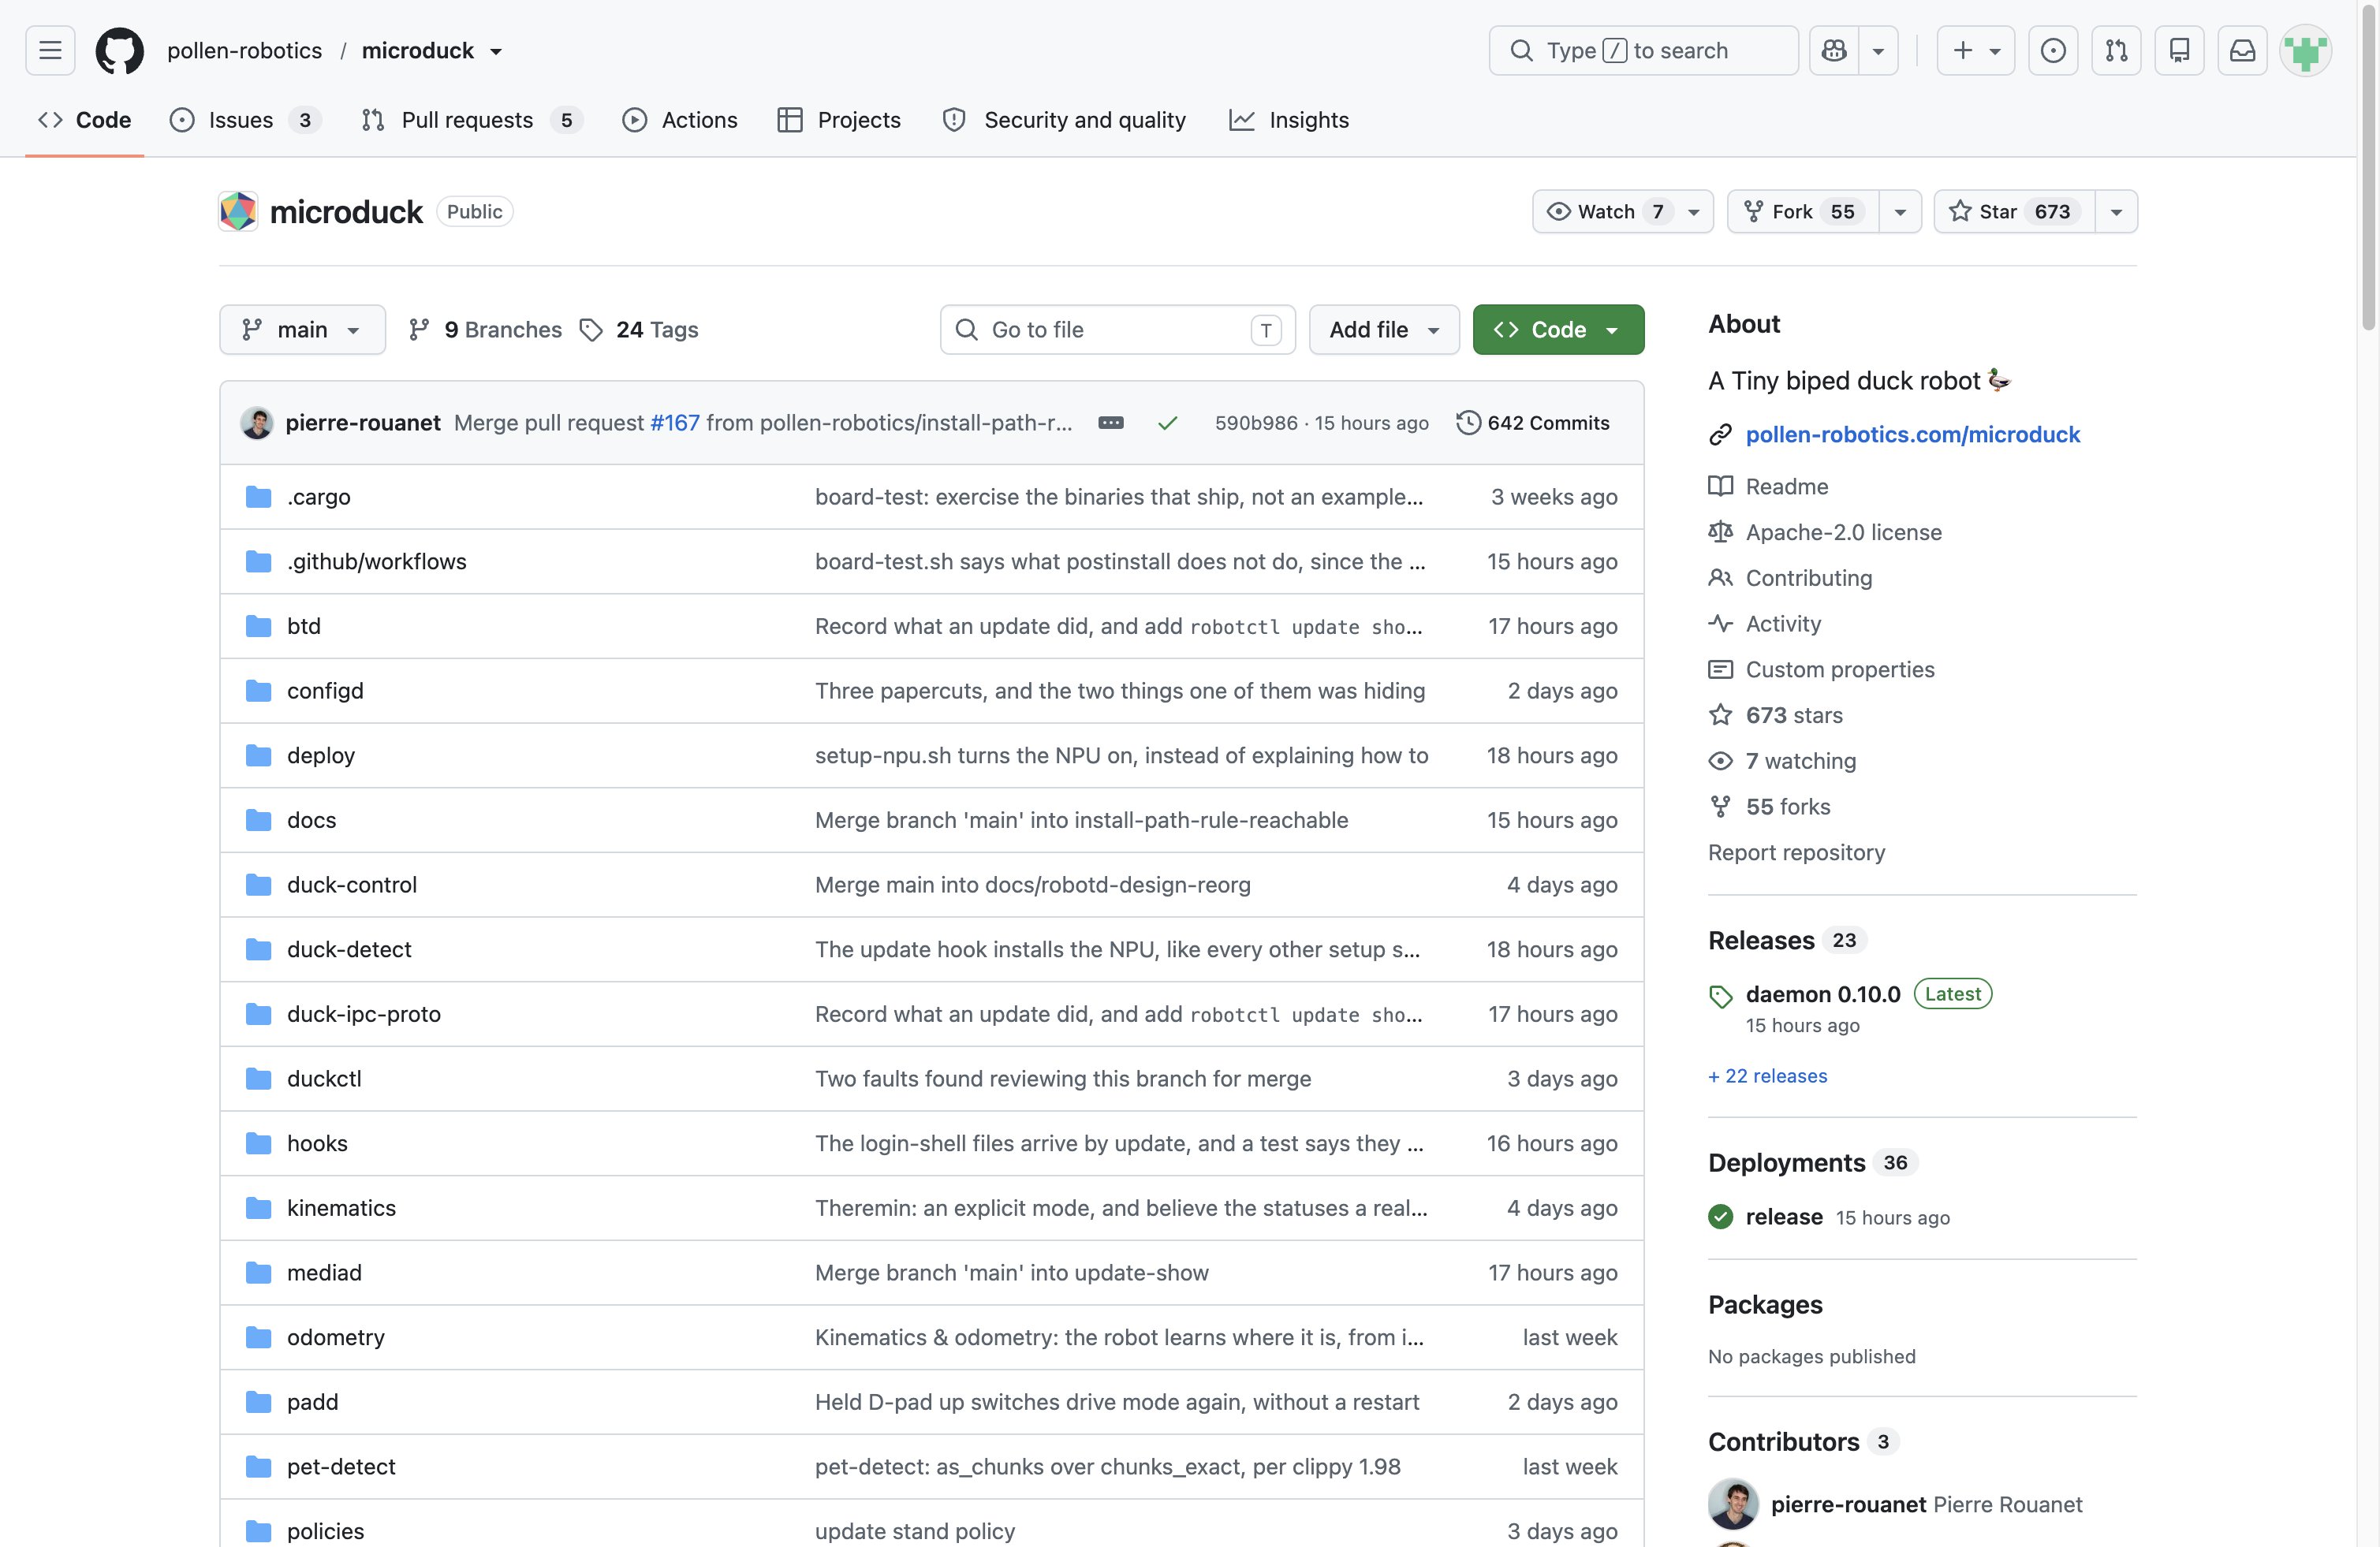
先厘清关系:Hugging Face 旗下 Pollen Robotics 在 2026 年 8 月 27 日发布双足机器鸭 Microduck 时,同时开源了两个仓库——主仓库 pollen-robotics/microduck 是机器人运行时和 SDK,负责让真机"会动";pollen-robotics/microduck_rl 则是训练环境,负责让机器鸭"学会动"。
我们之前在 Microduck 完整解读里讲过这只机器鸭的硬件、价格和社区口碑,那篇回答"它是什么、值不值得买";这一篇专注回答另一个问题:它那些走路、起身、轮滑的动作,到底是怎么练出来的,你自己能不能练?
几个关键事实:
| 项目 | 说明 |
|---|---|
| 仓库地址 | github.com/pollen-robotics/microduck_rl |
| 技术栈 | mjlab(MuJoCo Warp)+ PPO 强化学习 |
| 热度(2026-09-01) | 1.2k Star,196 Fork |
| 训练频率 | 50 Hz(与真机运行频率一致) |
| 输出格式 | ONNX,由主仓库的运行时在真机上执行 |
| 硬件要求 | 本地训练需 CUDA 显卡;也支持提交到 Hugging Face Jobs 云端训练 |
| 许可证 | 软件栈 Apache 2.0(硬件设计文件为 CC BY-SA-NC,未完全开放) |
机器鸭的动作是怎么练出来的:Sim-to-Real 三步走
Microduck RL 的核心是一条典型的 Sim-to-Real(仿真到真机)流水线:
- 仿真训练:在 MuJoCo 物理仿真里,成千上万个虚拟机器鸭并行尝试同一个动作,PPO 算法根据"走得好不好"不断调整策略,相当于让鸭子在虚拟世界里摔几百万次;
- 导出部署:训练好的策略导出为 ONNX 文件,真机上的运行时以 50 Hz 的频率加载执行——机器人不需要联网,本地 RK3566 芯片就能跑;
- 热切换:所有策略共享一套 61 维观测接口,真机运行时可以随时在"走路 / 起身 / 特技"等策略间切换,摔倒了恢复策略立刻接管。
这套流水线最有含金量的地方不是"用了强化学习",而是它把仿真和真机之间的鸿沟处理得很细——这也是自己动手训练最容易翻车的环节。
能训练哪些动作:13 个任务全表
官方目前开源了 13 类训练任务,每个任务都有平坦/崎岖地形(Flat/Rough)变体,真机上看到的花式动作全部来自这里:
| 任务 | 练的是什么 |
|---|---|
| Velocity | 主力任务:按速度指令行走 + 头部姿态控制 |
| VelStand | 行走 + 摔倒恢复,一个策略全包 |
| StandUp | 从俯卧、仰卧、坐姿三种状态爬起来站好 |
| SitStand | 站 ↔ 坐平滑切换 |
| GroundPick | 蹲下用鸭嘴碰地,再站起来 |
| BallKick | 把 70mm 小球踢出去(策略"看不见球",纯靠本体感知) |
| Roulade | 前滚翻,头着地滚一圈再站稳 |
| Rollers 系列(5 个任务) | 轮滑:速度跟踪、对称滑行、下坡、蹲滑、轮滑起身、原地旋转 |
部署时,主仓库的运行时把这些策略"热插拔"在同一个观测契约后面,键盘上按 G 是鸭嘴触地、Y 是坐立、R 是前滚翻、K/L 是踢球——你在电脑上就能像打游戏一样指挥仿真里的机器鸭。
训练教程:四条命令走完全流程
以下命令整理自官方 README,环境要求:一块 CUDA 显卡(训练通过 MuJoCo Warp 走 GPU)、装好 uv 包管理器。
第一步,克隆仓库并启动训练(4096 个并行环境,官方估计约 1–2 小时练出可用步态):
git clone https://github.com/pollen-robotics/microduck_rl
cd microduck_rl
uv run train Mjlab-Velocity-Flat-MicroDuck --env.scene.num-envs 4096
第二步,在查看器里看训练成果:
uv run play Mjlab-Velocity-Flat-MicroDuck --wandb-run-path <entity/project/run_id>
第三步,导出 ONNX(注意:必须用官方导出脚本,不要手动转换 checkpoint——观测归一化器会被烘焙进 ONNX 图里,手动转换会导致策略在运行时读到未归一化的观测,这是官方 README 里特意强调的坑):
uv run scripts/export.py Mjlab-Velocity-Flat-MicroDuck --wandb-run-path <...>
第四步,纯 CPU 上用键盘指挥导出的策略(不需要真机,也不需要显卡):
uv run scripts/infer_policy.py --walking output.onnx
想一次挂多个策略模拟真机切换,加参数即可:infer_policy.py --walking walk.onnx --standing stand.onnx --sitstand sitstand.onnx --roulade roulade.onnx。
没有显卡的三种免费替代方案
这是很多人搜索"机器鸭 强化学习"时真正关心的问题,按门槛从低到高:
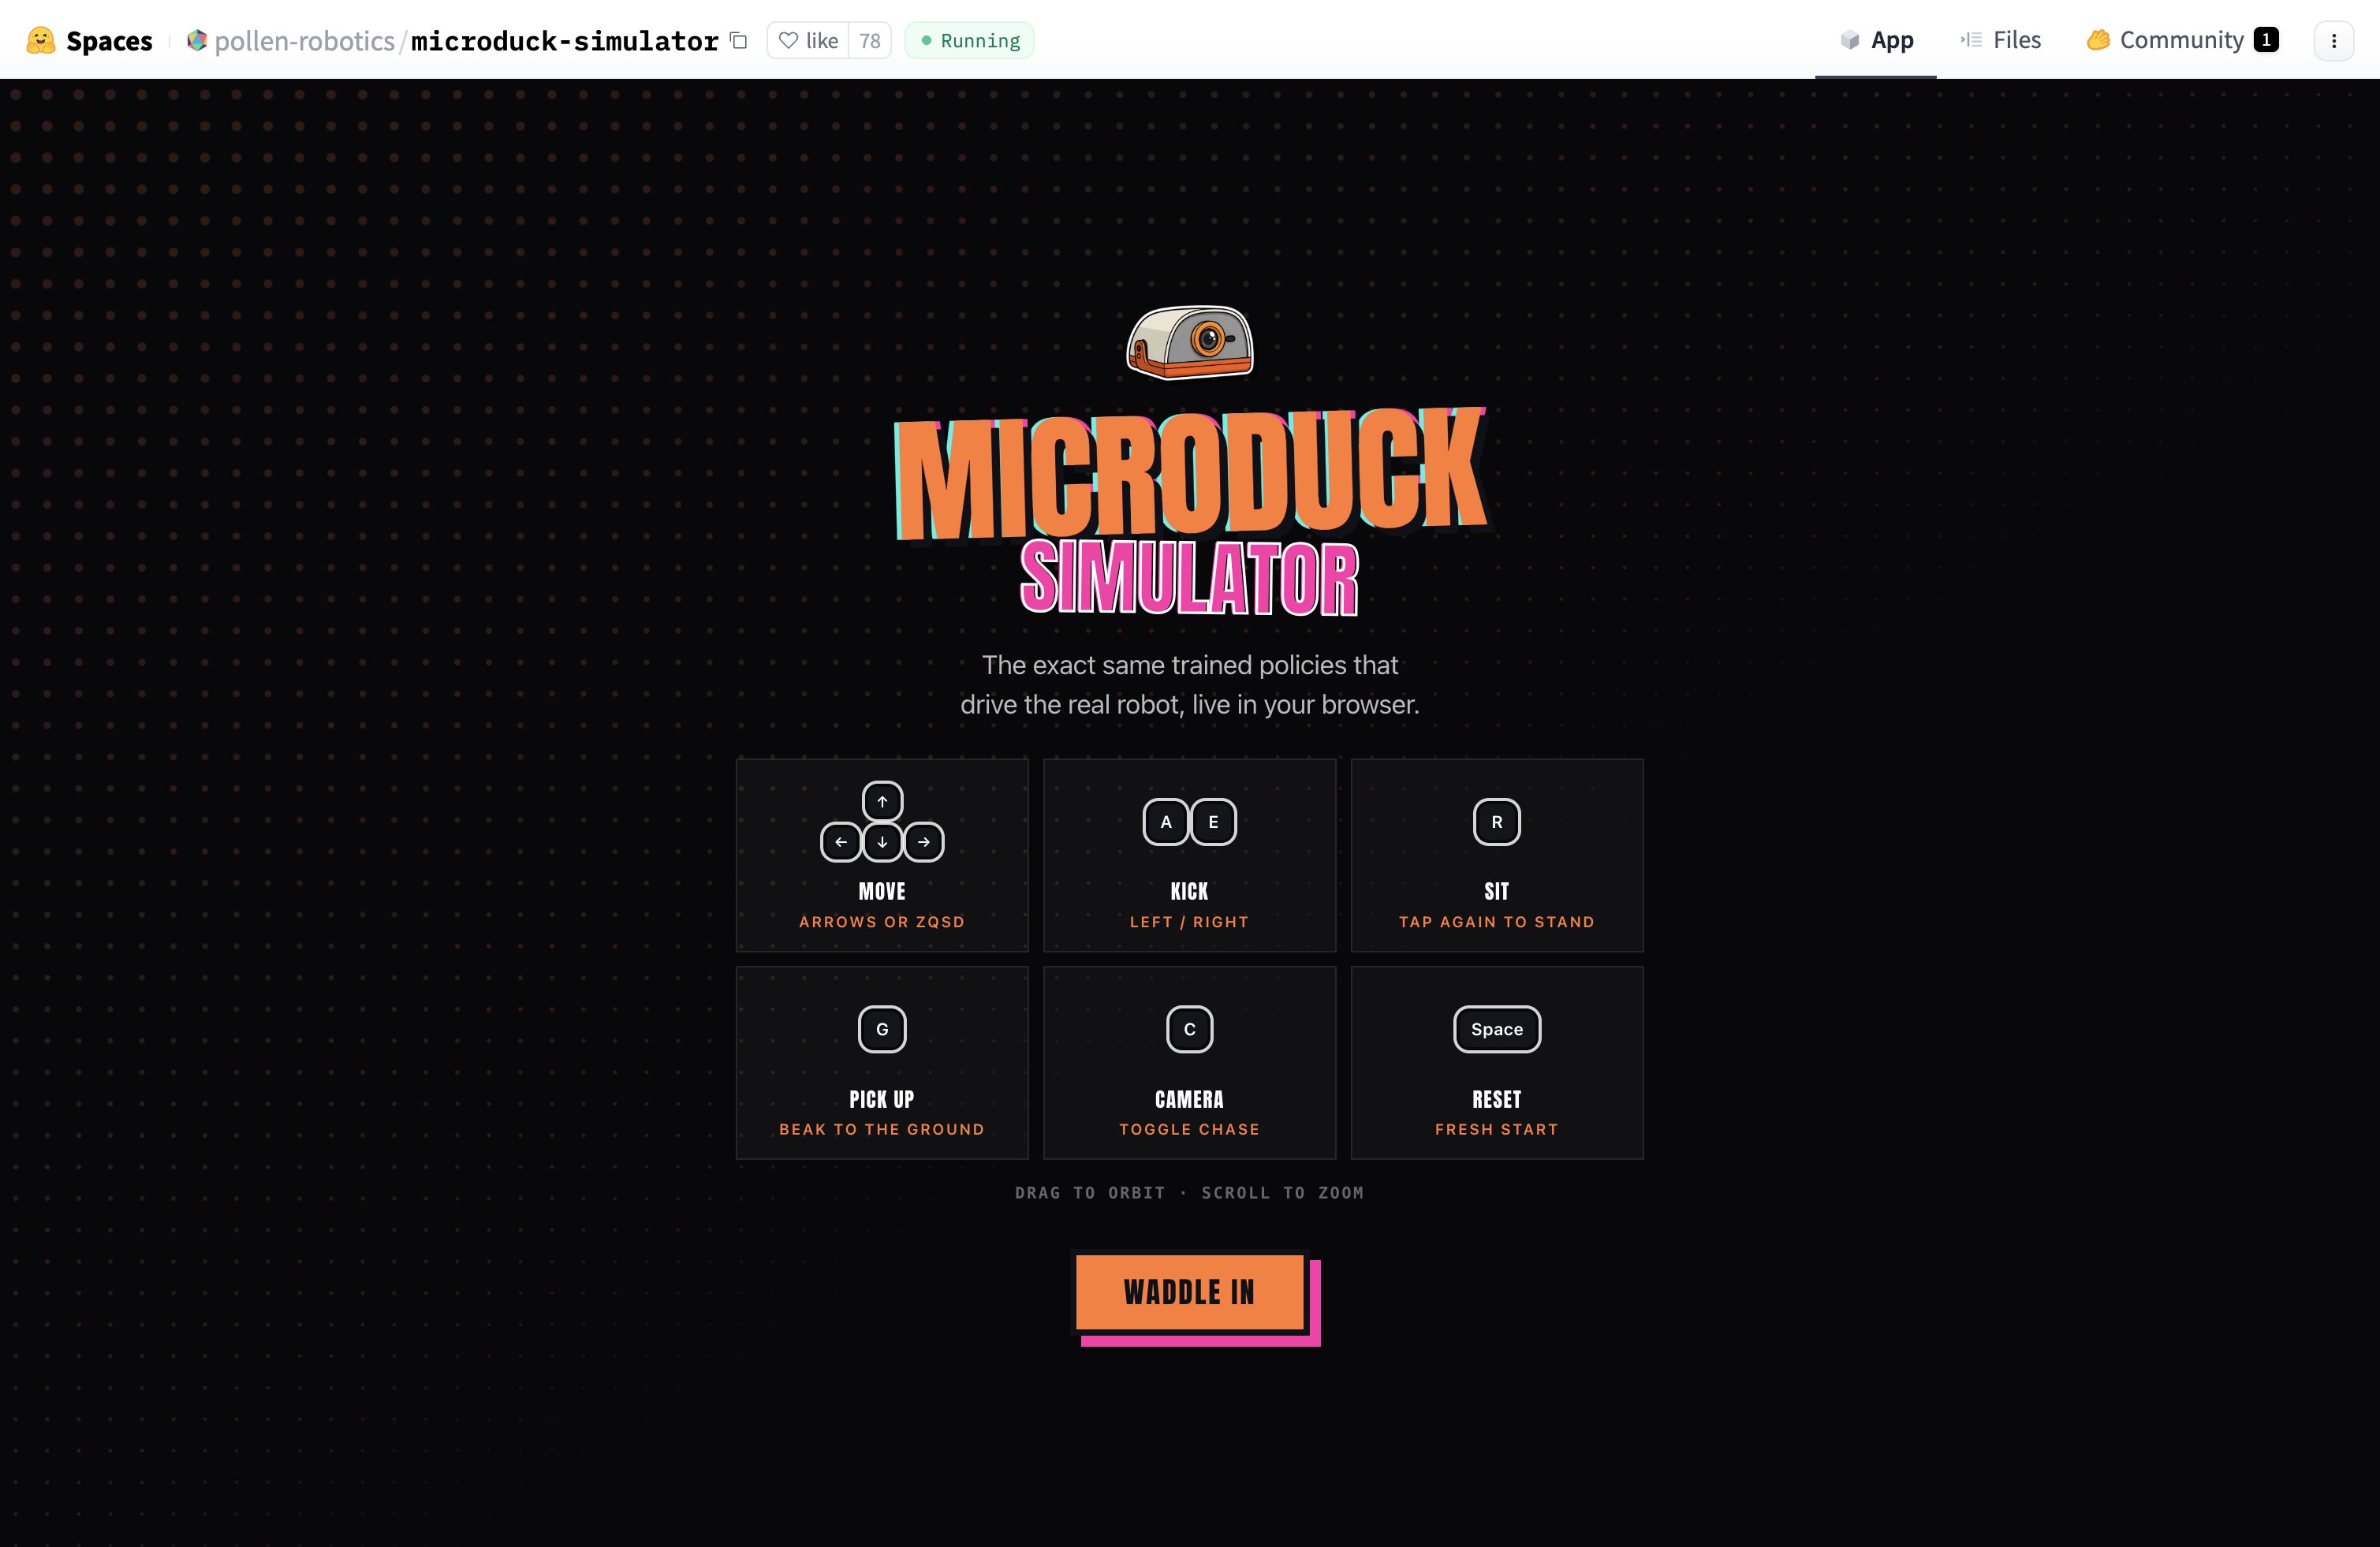
- 网页仿真器(零门槛,推荐先玩):官方在 Hugging Face 上提供了免费的 Microduck Sandbox 网页仿真器,浏览器里直接控制虚拟机器鸭,无需注册。我们实测过:打开页面等约半分钟加载完成即可用键盘控制。一个有意思的细节——它的移动键位是 ZQSD 而不是 WASD,这是法国 AZERTY 键盘布局(Pollen 是巴黎团队),键位"失灵"时先检查这个。
- Hugging Face Jobs(云端训练):在任何训练命令后加
--hf-jobs,训练任务就会提交到 Hugging Face 的云端 GPU 上跑,本地只需要一台普通电脑。这是官方给无卡用户准备的正经训练通道。 - CPU 推理脚本:训练好的 ONNX 策略可以在 CPU MuJoCo 里运行调试(上面第四步的命令),适合验证和修改别人分享的现成策略。
Sim-to-Real 的三个关键细节(官方文档里最值钱的部分)
如果你想认真改造步态、训练新动作,这三个设计决定了"仿真里练得好、真机上摔不摔":
- BAM 执行器模型:Microduck 用的 Dynamixel XL330 舵机被建模到了电压控制律层面(含反电动势、摩擦模型),而不是理想 PD 控制器。官方的解释很直白:在这个尺度上——几百克的机器人配小舵机——执行器保真度就是 Sim2Real 差距的大头。
- 域随机化:电池电压、负载下的电压跌落、指令延迟、摩擦大小都在训练时随机化,让策略在真机的"不完美世界"里依然稳健。
- Backlash 齿隙变体:每个主任务都有一个 Backlash 孪生任务,在 14 个舵机关节上各建模 ±1° 的齿轮间隙,编码器读数也是穿过齿隙读取的——细节做到这个程度,少见。
另外两点工程约定值得知道:所有策略共享 61 维观测(48 维本体感知 + 指令),这是热切换的基础;无驱动的关节统一命名为 passive_*(轮子、齿隙铰链)。仓库的 CLAUDE.md 还沉淀了整个项目的奖励函数设计经验,对想自己设计奖励的开发者是现成的避坑指南。
社区怎么看:热度之外的两个提醒
Microduck 发布后冲上 Hacker News 首页,microduck_rl 仓库发布几天内拿到 1.2k Star。结合社区讨论,练之前有两个预期要摆正:
- 硬件设计未开源:软件栈是完整的 Apache 2.0,但机械 CAD 和电子制造文件没有公开,"开源机器人"目前指的是软件和学习技术栈;
- 训练时长是官方估计:1–2 小时练出步态是官方在给定配置下的估计,换了显卡或改了任务,时长和效果都会变,不要当成交付承诺。
总结
Microduck RL 把"机器人强化学习"从实验室专属变成了一个下午就能跑通的开源项目:命令清晰、任务齐全、仿真器免费,甚至没显卡也能上云端练。对想入门具身智能的开发者,建议的上手顺序是:网页仿真器找感觉 → CPU 推理脚本读懂策略 → Hugging Face Jobs 或本地 GPU 完整训练一次。想了解机器鸭的硬件、价格和购买建议,请看我们的 Microduck 完整解读;想了解具身智能背后的 Agent 概念,可以读什么是 AI Agent;想自己搭一台能跑 AI 的本地开发机,可以参考本地大模型部署指南。
最后更新于 2026 年 9 月 1 日。本文基于 Pollen Robotics 官方 GitHub 仓库(microduck 与 microduck_rl)、官方商店页面及 Hacker News 社区一手讨论整理,网页仿真器实测于 2026 年 8 月完成;训练时长等为官方估计值,可能随版本更新变化,请以官方 README 为准。
常见问题
Microduck RL 是免费的吗?
是。仓库以 Apache 2.0 协议开源,个人和商用都可以免费使用,网页仿真器和 Hugging Face Jobs 的入门额度也不花钱,只有真机本体需要 399 美元。
训练机器鸭一定要有显卡吗?
本地训练需要 CUDA 显卡(训练跑在 MuJoCo Warp 上)。没有显卡可以在训练命令后加 `--hf-jobs` 提交到 Hugging Face Jobs 云端训练;只想体验动作,用网页仿真器或 CPU 推理脚本即可。
Microduck RL 训练一次要多久?
官方 README 估计:4096 个并行环境下,约 1–2 小时练出可用的行走步态。注意这是官方给定配置下的估计,具体取决于显卡和任务设置。
不用买真机能学到东西吗?
能。完整流程(训练 → 查看器回放 → ONNX 导出 → CPU 键盘推理)都可以在没有真机的情况下跑通,真机只是最后的部署载体。这也是它和玩具机器人的本质区别:软件链路全部公开可练。
Microduck RL 和主仓库 microduck 有什么区别?
microduck 是真机的运行时和 SDK,负责执行策略、控制电机;microduck_rl 是训练环境,负责在仿真里用强化学习练出策略。前者是"部署",后者是"训练",两者通过 ONNX 文件衔接。
改奖励函数能让机器鸭学会新动作吗?
理论上是这套平台的核心玩法——官方开源了 13 类任务的奖励设计,仓库 CLAUDE.md 里还沉淀了奖励函数设计经验。但奖励设计是 Sim2Real 里最难的部分,新手建议先从复现官方任务开始。
 京ICP备2024094994号-29