
Agent Lightning 教程:微软开源智能体训练框架是什么,怎么用(2026 v1.0 实操)
最后更新于 2026 年 8 月 31 日 | 作者:AI345 AI 指南编辑部(长期跟踪海内外 AI Agent 开源项目,本文基于官方仓库、两篇论文与社区一手资料整理)
Agent Lightning 是微软研究院开源的智能体强化学习(Agentic RL)训练框架,它能让你现有的 AI 智能体——不管用 LangChain、AutoGen 还是 OpenAI Agents SDK 搭的——几乎零代码改动,就接入强化学习训练流程,让模型在真实任务中越用越强。 项目采用 MIT 协议完全免费,在 GitHub 已收获 1.8 万+ Star。2026 年 8 月 19 日发布的 v1.0 做了彻底重构:核心只有约 3500 行代码,官方用 6000 条训练样本就把一个编码智能体在 SWE-bench Verified 上的成绩从 41.8% 拉到 56.4%。
本文目录
- Agent Lightning 是什么?解决什么问题
- 为什么值得用:4 个核心卖点
- v1.0 架构:训练闭环怎么跑起来
- Agent Lightning 安装教程(附依赖清单)
- 快速开始:跑通第一个训练任务
- v1.0 和旧版(v0.x)有什么区别
- 和 verl、LangChain 是什么关系(对比表)
- 什么团队适合用它
- 常见问题 FAQ
Agent Lightning 是什么?
一句话定义:Agent Lightning 是一个把"智能体执行"和"强化学习训练"彻底解耦的开源框架,训练任何 AI Agent 几乎不需要改业务代码。
传统做法里,想让智能体变强,要么换更强的模型(贵),要么自己写 RL 训练管线(难):需要把智能体的多轮交互轨迹转成训练数据、处理信用分配(哪一步操作该记功)、再对接 verl 这类训练后端,工程量巨大。
Agent Lightning 把这套管线做成了通用基础设施。你的智能体照常调用模型 API,框架在旁边"旁路"采集交互数据、转成训练样本、更新模型权重,再把更好的模型发回来。官方说法是"Train ANY AI Agents with Reinforcement Learning"——训练任何智能体。
项目信息速览:
| 项目 | 信息 |
|---|---|
| 开发方 | 微软研究院(Microsoft Research) |
| 开源协议 | MIT(个人和商用都免费) |
| GitHub | microsoft/agent-lightning(18k+ Star) |
| 官方文档 | microsoft.github.io/agent-lightning |
| 技术报告 | v1.0:arXiv 2608.17528(2026.8);原始论文:arXiv 2508.03680(2025.8) |
| 当前版本 | v1.0(2026 年 8 月 19 日发布,完全重构) |
为什么值得用:4 个核心卖点
1. 零改动接入现有智能体。 框架通过一个兼容 OpenAI 协议的 API 代理拦截模型请求,你的 Agent 保持原来的工具调用、上下文管理、控制流不变,训练在旁边悄悄进行。
2. 极简实现。 v1.0 核心只有约 3500 行代码,团队把"简单"当第一原则——出了问题你真的读得动源码。
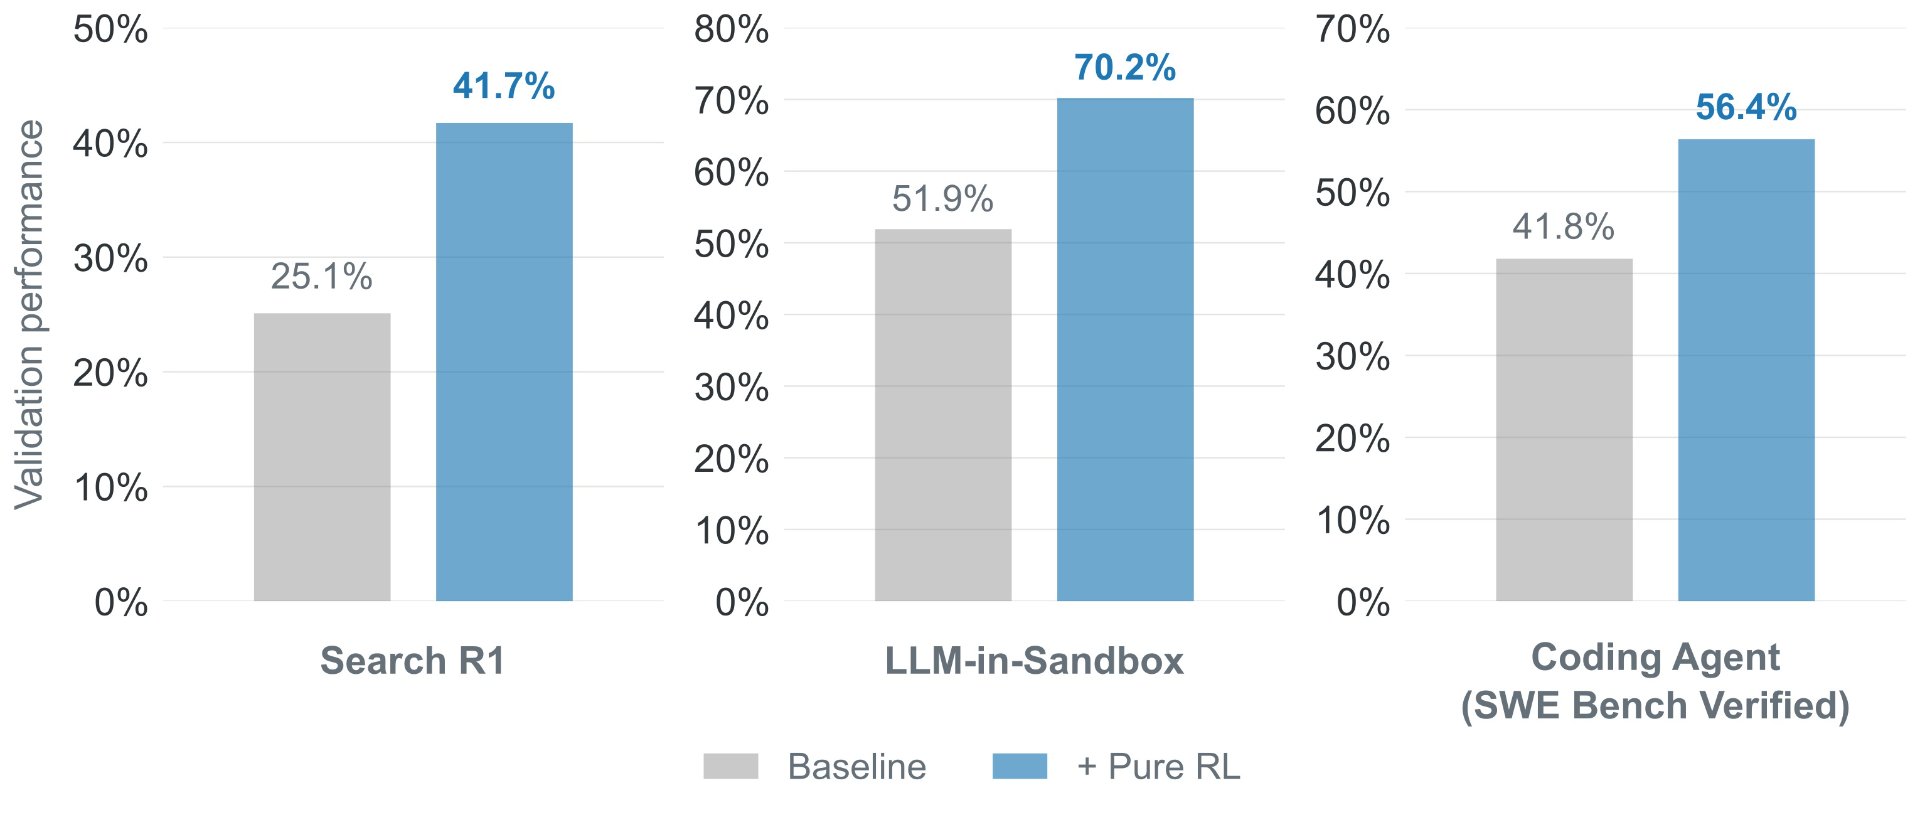
3. 效果经过验证。 官方用 6000 条训练样本做端到端编码智能体训练,Qwen3.5-9B 在 SWE-bench Verified 从 41.8% 提升到 56.4%,提升 14.6 个百分点,完整管线(数据清洗、防 reward hacking、训练脚本)全部开源。
4. 原生支持 Kubernetes。 智能体可以直接作为 K8s Job 运行,不依赖外部沙箱服务,适合企业级扩展。
官方三域评测对比(Search R1 / LLM-in-Sandbox / Coding Agent,来源:官方仓库):
v1.0 架构:训练闭环怎么跑起来
v1.0 用三个轻量组件搭出训练闭环:
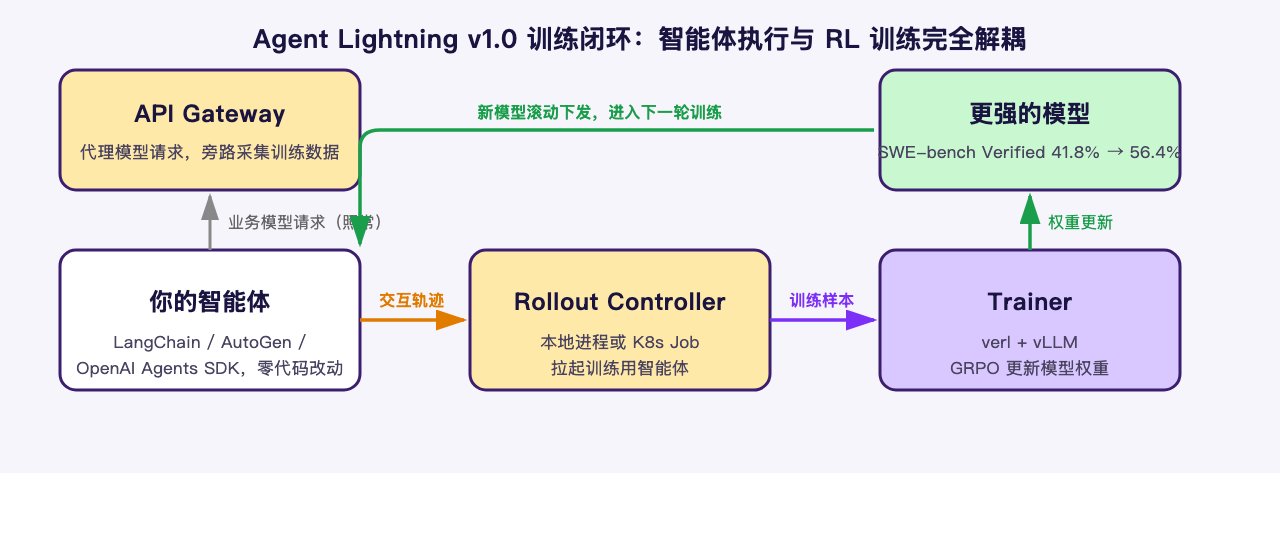
- Trainer(训练器):跑 verl 和 vLLM,把交互轨迹构建成训练样本,更新模型权重。
- API Gateway(网关):代理模型请求,在转发的同时旁路捕获训练数据——这就是"零改动"的机关所在。
- Rollout Controller(滚动控制器):在本地或 Kubernetes Jobs 里拉起智能体,执行真实任务产生轨迹。
流程是:Trainer 创建 rollout → Controller 启动智能体执行任务 → Gateway 把交互转成训练数据 → Trainer 更新权重 → 更强的模型进入下一轮。官方架构图如下(来源:官方仓库):
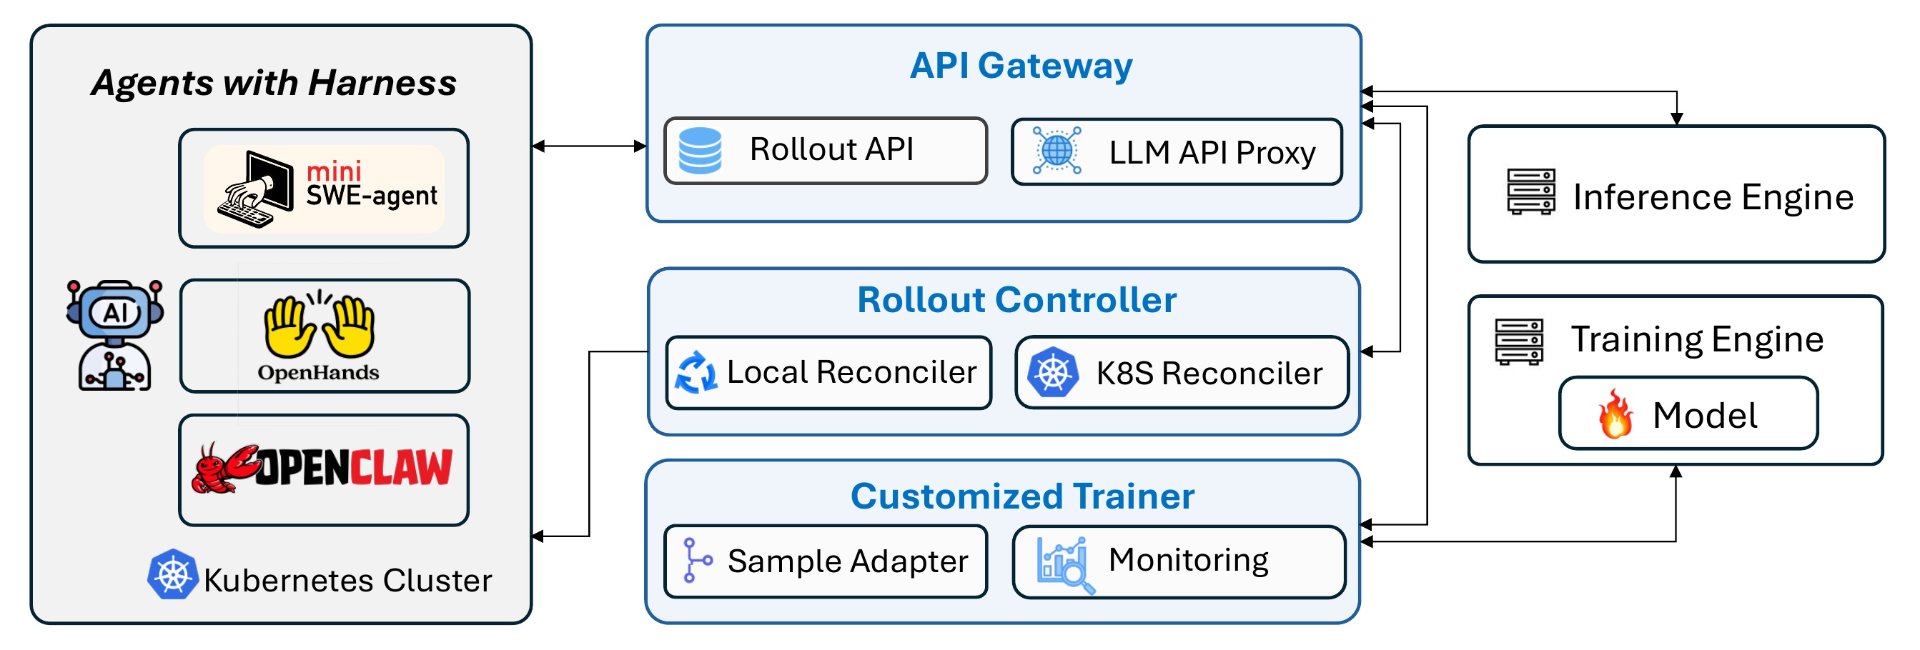
这一设计延续了原始论文(arXiv 2508.03680)提出的"训练-智能体解耦"(Training-Agent Disaggregation)思想和 LightningRL 分层强化学习算法,v1.0 则把工程实现收敛到了极简形态。
Agent Lightning 安装教程
前置要求:一台 NVIDIA GPU 机器(快速开始用单张 A100 即可),已安装 uv 和 CUDA 12.9 或 13.0。
第一步:拉代码并初始化 Python 环境
git clone https://github.com/microsoft/agent-lightning.git
cd agent-lightning
uv sync
第二步:安装 verl GPU 训练栈
框架用 verl 做训练后端,verl、vLLM、torch 版本强耦合,flash-attn 源码编译也容易出错,官方提供了固定版本的安装脚本:
source .venv/bin/activate
bash scripts/setup_verl.sh 0.8.0 cu130
版本组合支持 verl==0.7.1 + cu129 和 verl==0.8.0 + cu130(推荐后者),脚本会安装 vLLM(0.8.0 组合对应 vllm==0.20.2)并本地编译 flash-attn==2.8.3。注意:这一步依赖 CPU 核数,通常要 10-30 分钟,别以为卡住了。
第三步:登录 Weights & Biases
默认所有任务会把日志和轨迹上传到 W&B:
uv run wandb login
快速开始:跑通第一个训练任务
官方 Quick Start 只需单机单张 A100,跑 Calc-X 数学推理示例(用 AutoGen + MCP 计算器工具):
- 下载 Calc-X 数据集(官方文档提供 Google Drive 链接),把
train.parquet、test.parquet等文件放到examples/calc_x/data/; - 激活环境并安装示例依赖:
uv pip install openai httpx sympy \
  "autogen-agentchat" "autogen-ext[openai]" \
  "mcp>=1.11.0,<2" mcp-server-calculator
- 一条命令启动:
examples/calc_x/run_local.sh
启动器会依次拉起 Ray 和 verl/vLLM 模型后端、8181 端口的 agl-server、本地 controller 和训练入口,服务日志写在 /tmp/,训练曲线在 W&B 里看。想停就按一次 Ctrl+C 然后等它清理完——别连按几次,进程清理需要时间。
入门推荐顺序:跑通 Calc-X → 读官方 Basics 文档 理解 rollout、事件、轨迹三个核心概念 → 对照 Coding Agent 示例 研究完整训练管线。
v1.0 和旧版(v0.x)有什么区别
如果你在 2025 年就关注过这个项目,注意:v1.0 是完全重构,API 不兼容旧版,旧代码在仓库的 v0.x 分支维护。核心变化:
| 维度 | v0.x(2025.8 论文版) | v1.0(2026.8 重构版) |
|---|---|---|
| 接入方式 | 框架内嵌 tracer/客户端 SDK | 兼容 OpenAI 协议的 API 代理,真正零改动 |
| 核心代码量 | 较大 | 约 3500 行 |
| 训练编排 | 自研 | verl + vLLM 原生集成 |
| 运行环境 | 依赖外部沙箱 | 原生 Kubernetes Jobs |
| 招牌结果 | text-to-SQL、RAG、数学工具调用 | SWE-bench Verified 41.8% → 56.4% |
老项目想迁移,直接按 v1.0 文档重写接入层,别试图兼容。
和 verl、LangChain 是什么关系(对比表)
很多读者分不清它和现有工具的边界,一张表说清:
| 工具 | 定位 | 关系 |
|---|---|---|
| Agent Lightning | 智能体 RL 训练框架(解耦层) | 本体 |
| verl | 通用 RL 训练后端 | v1.0 把它作为 Trainer 内核 |
| vLLM | 高性能推理引擎 | 被 Trainer 用于策略推理 |
| LangChain / AutoGen / OpenAI Agents SDK | 智能体开发框架 | 被训练的对象,通过网关接入,互不替代 |
也就是说:你用 LangChain 写业务智能体,用 Agent Lightning 训练它背后的模型,两者互补而非竞争。这不是"又一个 Agent 框架",而是给所有 Agent 框架补上"训练"这块拼图。
什么团队适合用它
- 有自研智能体、想提升任务成功率的团队:最典型场景。智能体已经在跑,但模型能力到瓶颈,用真实业务轨迹做 RL 微调。
- 做大模型后训练的研究者:verl 用户可以直接参考它的智能体训练范式和防 reward hacking 实践。
- 想复现 Coding Agent 的工程团队:SWE-bench 训练管线完整开源,含数据清洗脚本。
- 暂时不适合:没有 GPU 资源、只想调 prompt 的轻量用户——训练环节需要 A100 级别的卡,这一步省不掉。
社区已有落地参考:腾讯优图 Youtu-Agent 基于魔改分支做到了 128 GPU 稳定扩展训练;Tinker 团队发布了与 Agent Lightning 联调的两篇教程;vLLM 官方博客也写过它解决 retokenization 漂移问题的技术细节。
总结
Agent Lightning 解决的是"智能体会用但不会变强"的问题:把 RL 训练做成智能体旁边的旁路基础设施,业务代码零改动,训练栈 3500 行代码读得懂、改得动,还有微软背书和 SWE-bench 14.6 个百分点的实测提升。v1.0(2026 年 8 月)刚刚重构完毕,现在是入场的好时机——从官方 Quick Start 的单卡 Calc-X 示例跑起,一小时内就能看到完整的训练闭环。
延伸阅读(站内)
- 还不了解智能体基础概念?先看 什么是 AI Agent
- 想系统入门智能体开发?看 AI Agent 工作流入门指南
- 训练完怎么评估效果?看 AI Agent 评测方法指南
- 对比阅读同类方案:谷歌 EnvHarness 智能体学习框架指南
参考来源(外部)
- GitHub:microsoft/agent-lightning(官方仓库与 README,2026.8 更新)
- 官方文档站(安装与 Quick Start 均以此为准)
- Agent Lightning v1.0: Towards Harnessed Agentic RL(arXiv 2608.17528)
- Agent Lightning: Train ANY AI Agents with Reinforcement Learning(arXiv 2508.03680)
- 微软研究院项目主页
- vLLM 官方博客:No More Retokenization Drift(2025.10)
- 腾讯优图 Youtu-Agent 128 GPU 训练实践
本文基于官方仓库与论文一手资料整理,架构示意图为原创绘制,官方架构图与评测图引自微软开源项目(MIT 协议)。
常见问题
Agent Lightning 是免费的吗?
是。项目采用 MIT 协议开源,个人和商用都免费,只需保留版权声明。但训练本身需要 GPU 资源,模型 API 费用另计。
没有 GPU 能用 Agent Lightning 吗?
训练不行——策略推理和 GRPO 更新依赖 verl + vLLM 的 GPU 栈(快速开始建议单张 A100)。但可以先在业务侧把智能体接上网关采集轨迹,训练资源到位后再启动。
Agent Lightning 和 verl 有什么区别?
verl 是通用 RL 训练后端,面向传统 RLHF 场景;Agent Lightning 是面向智能体的上层框架,解决多轮交互轨迹转换、信用分配、训练与执行解耦等问题,v1.0 直接用 verl 做训练内核。做智能体训练选后者,做纯文本对齐选前者。
支持哪些智能体框架?
LangChain、OpenAI Agents SDK、AutoGen、AgentScope 等主流框架以及从零自研的智能体都能接,因为接入点是 OpenAI 兼容的模型 API 而不是某个框架的钩子。
v1.0 训练效果怎么样?
官方数据显示,仅用 6000 条训练样本,Qwen3.5-9B 编码智能体在 SWE-bench Verified 上从 41.8% 提到 56.4%(+14.6 个百分点),在 Search R1、LLM-in-Sandbox 等场景也有稳定提升。
旧版(v0.x)代码还能用吗?
能用,在仓库 v0.x 分支维护,但 v1.0 完全重构、API 不兼容。新项目建议直接用 v1.0,老项目按 v1.0 文档迁移。
 京ICP备2024094994号-29