
Nemotron 3.5 Lightning 是什么?英伟达开源新模型
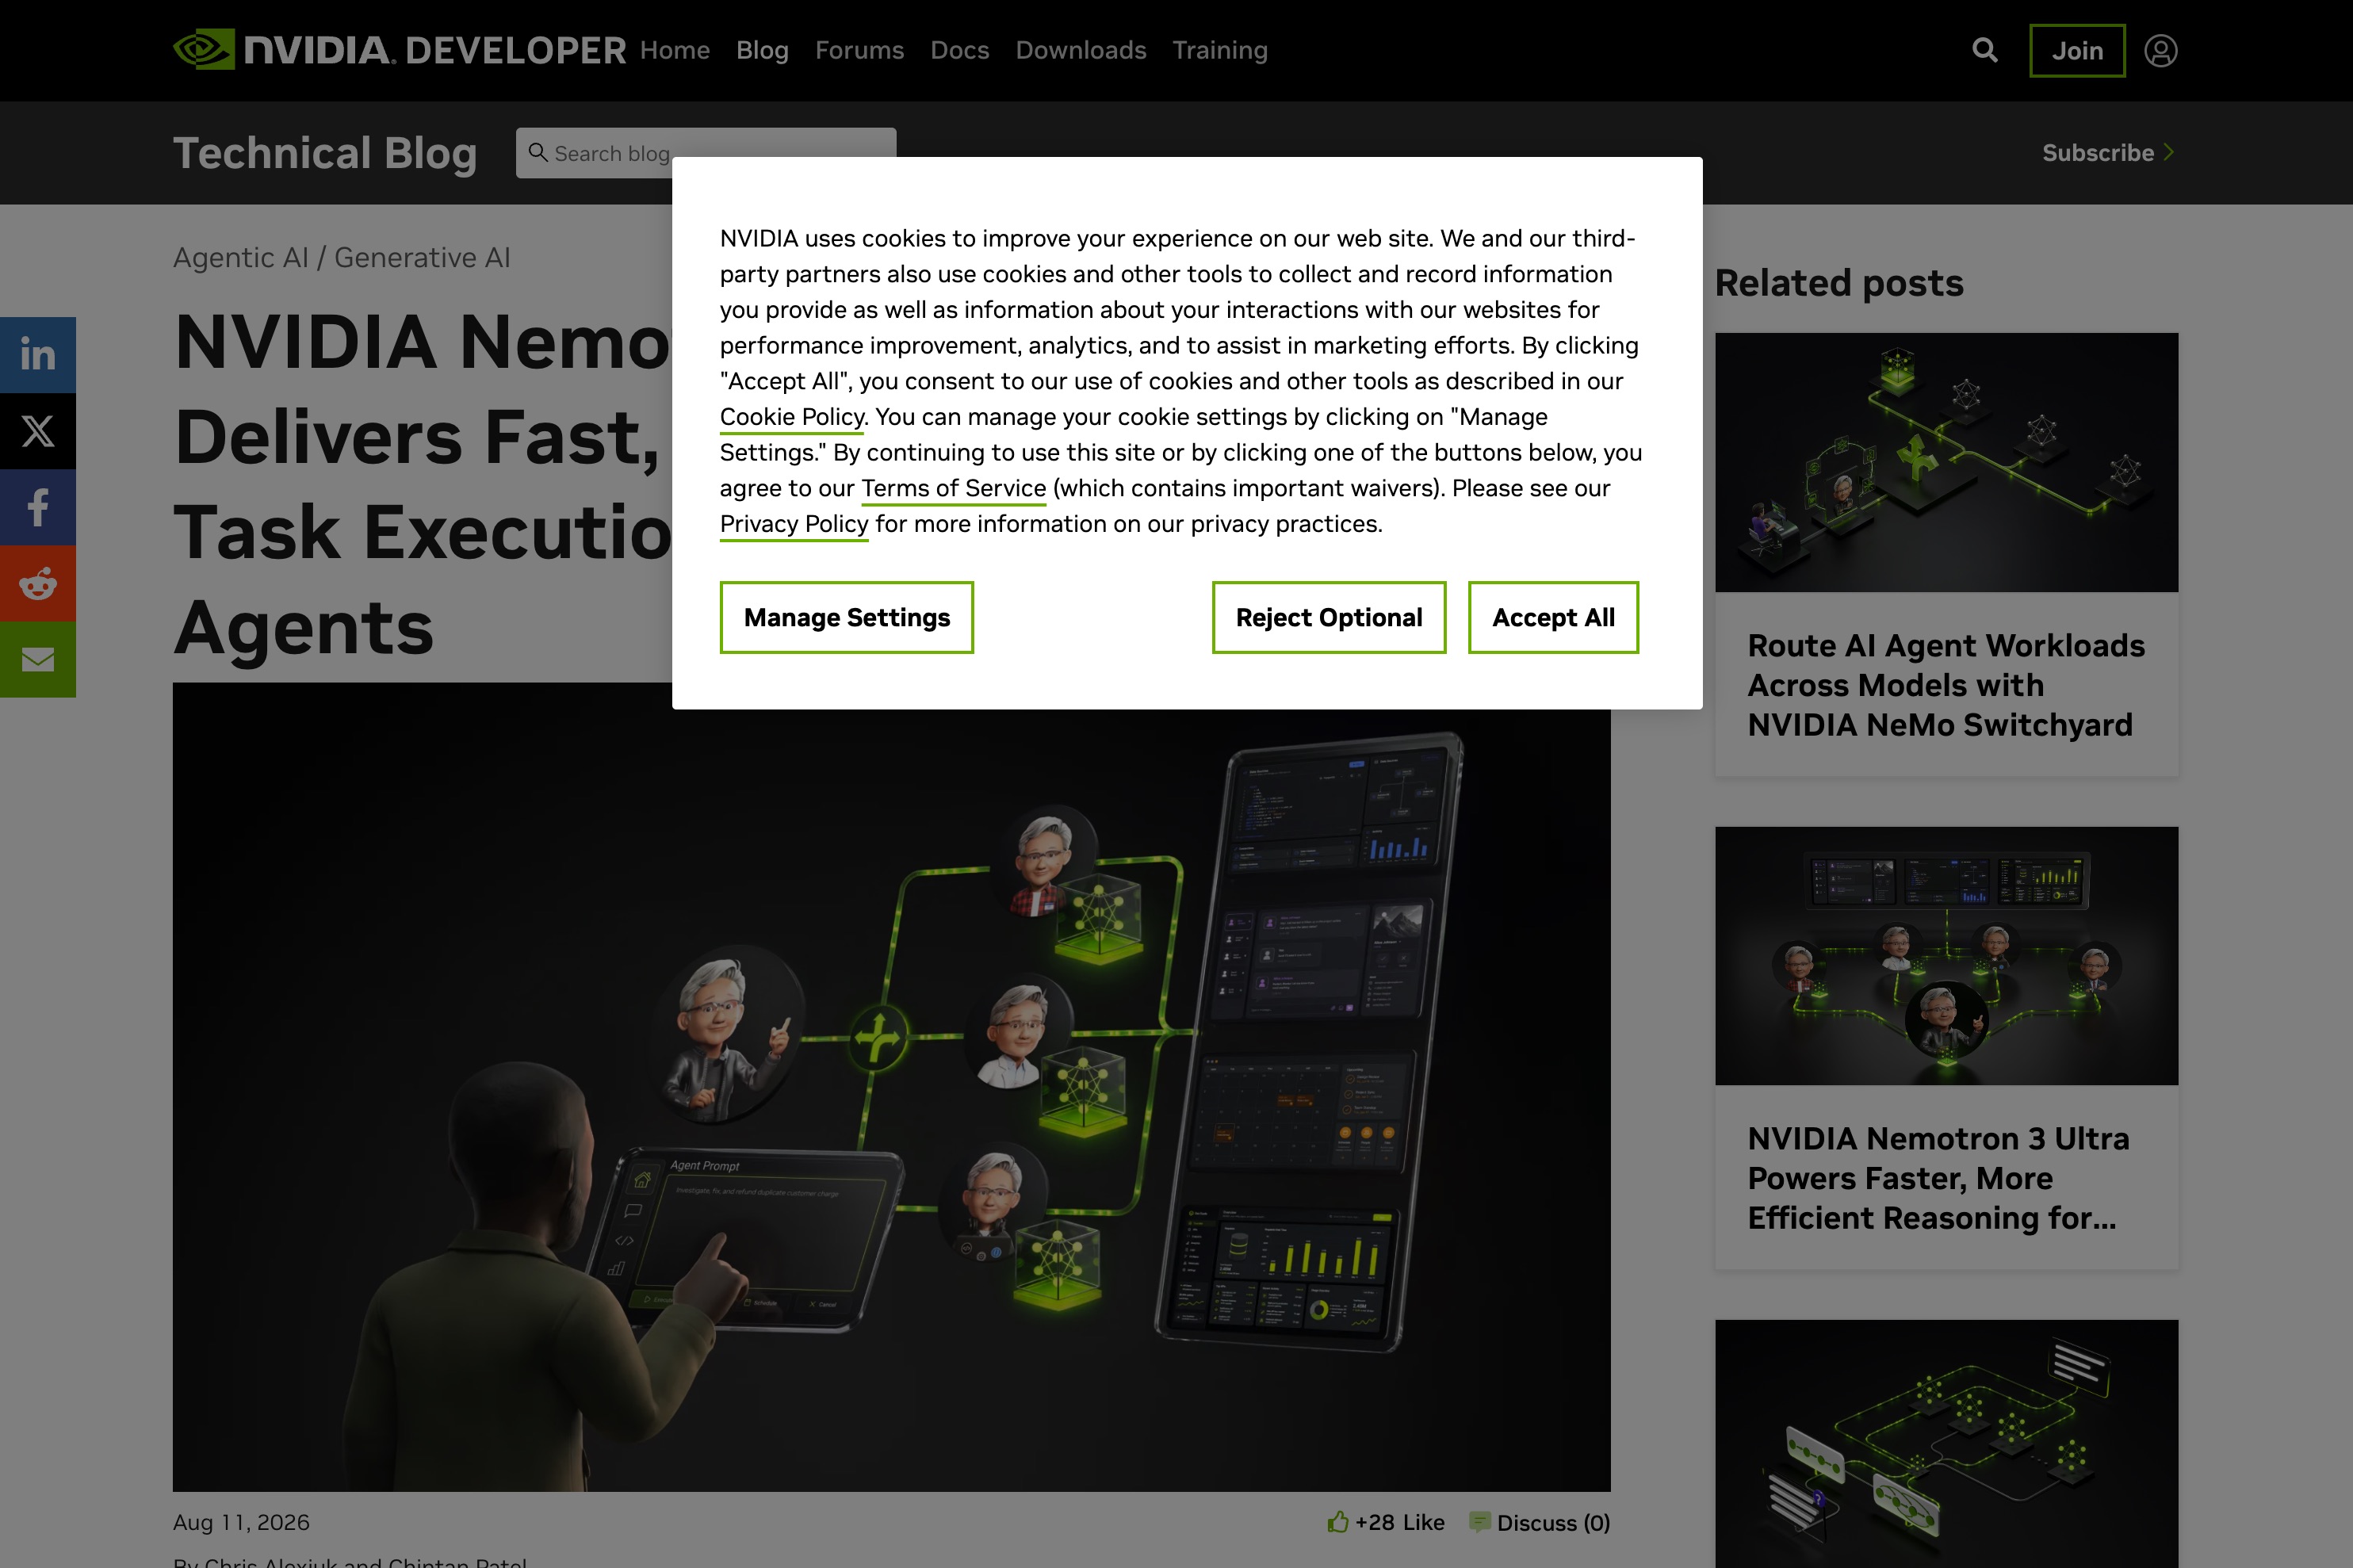
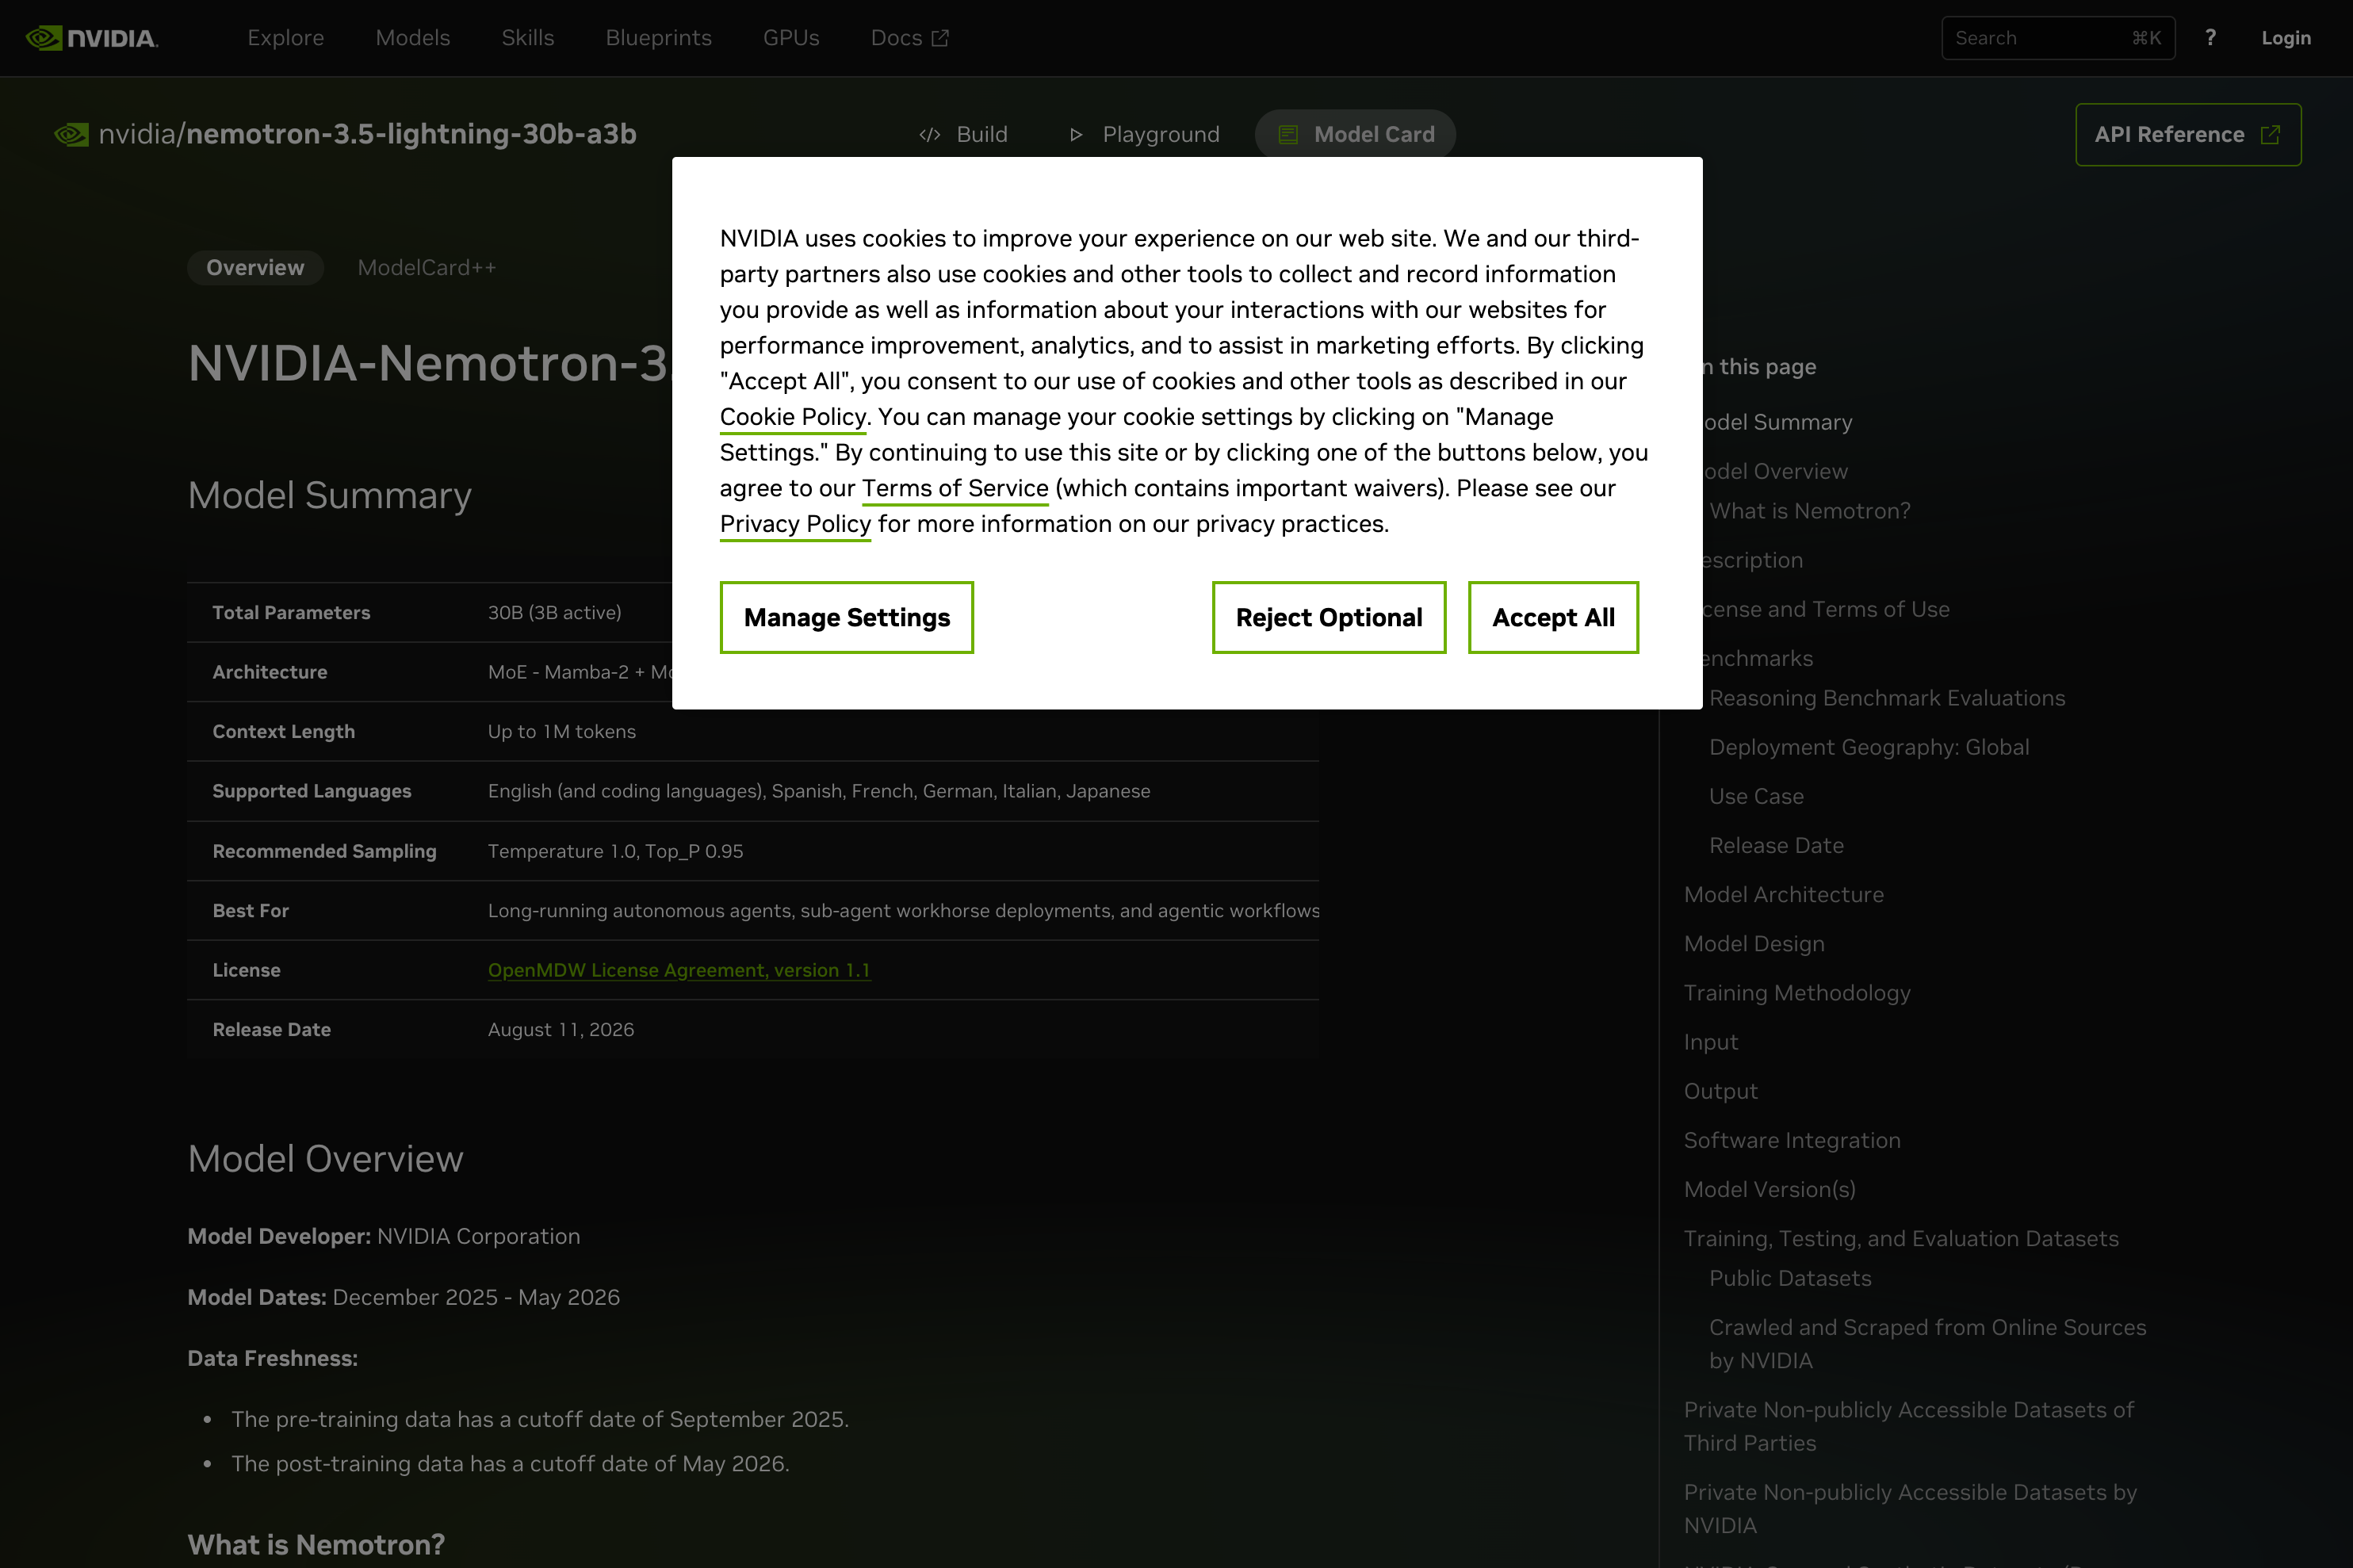
Nemotron 3.5 Lightning 是英伟达 2026 年 8 月 11 日发布的开源模型:总量 300 亿参数的 MoE(混合专家)架构,每次推理只激活 30 亿参数,官方把它定位成长期运行智能体的「执行层」引擎,也就是 Agent 系统里负责把具体任务快速做完的那一环。开源权重在 NVIDIA 官方渠道可以直接获取。
为什么英伟达要做这个模型:给 Agent 当常驻引擎
传统做法里,Agent 系统的每一步工具调用都走同一个大模型,成本高、延迟也高。Nemotron 3.5 Lightning 的思路是把「规划」和「执行」分开:主模型负责想清楚,Lightning 负责干得快。官方开发者博客对它的描述是「为始终开启的智能体执行层构建」,强调高吞吐与长任务下的稳定性(NVIDIA 开发者博客)。
英伟达还配套开源了路由库 NeMo Switchyard,用来在多个模型之间做智能分发。
30B-A3B 架构:只激活 3B 意味着什么
模型全名里的 30B-A3B 是关键:总参数 30B,激活 3B。好处很直接:
- 推理成本低:显存占用按 30B 算,但算力消耗接近 3B 模型,吞吐量可以做得很高。
- 能力保留:专家网络让它在专业任务上不输同量级稠密模型太多。
- 适合多实例:跑多个 Agent 实例时,单位成本优势会被放大。
代价是它不是全能选手,官方口径也把它定义为「通用推理与对话模型,面向特定任务执行」,复杂规划仍建议交给更大的主模型。
四个权重版本怎么选
开源时官方同步放出了四个权重版本,按部署条件挑:
- BF16:全精度原版,训练或精度敏感场景用。
- NVFP4:英伟达 4bit 量化格式,显存减半,消费级部署首选。
- NVFP4-DFlash / NVFP4-DSpark:在 NVFP4 基础上针对不同推理栈的变体,配合英伟达推理工具链使用。
国内用户在魔搭社区也能找到同步上传的权重,下载比 Hugging Face 顺畅。
消费级显卡能跑吗:RTX 5090 起步
官方模型卡把 GeForce RTX 5090 列入支持的部署配置(模型卡原文),社区评测也验证了单卡可用。这意味着个人开发者不用租 A100/H100 就能本地跑通。
如果你已经在折腾本地部署,可以对照这篇星火 X2.5 的 Ollama 一条命令部署教程(/ai-guide/spark-x2-5-local-deploy-ollama)理解量化权重的显存账,或者看 Qwen3.8-Flash-Next 的四条部署路线对比(/ai-guide/qwen-3-8-flash-next-local-deploy-guide),思路完全通用。
只想先试用不想装环境的话,OpenRouter 这类聚合平台的免费额度(/ai-guide/openrouter-complete-guide)是更省事的选择。
和同体量开源模型的定位差异
同样主打小激活的 MoE 模型不少,Lightning 的差异点有两个:一是原生配套英伟达的量化与路由工具链(NVFP4 加 NeMo Switchyard),在英伟达硬件上是全家桶体验;二是明确为 Agent 执行层调优,而不是通用聊天。给 Agent 系统选执行引擎时值得优先试,纯聊天场景则未必比通用模型更有优势。
延伸阅读
作者:AI345
最后更新:2026 年 9 月
常见问题
Nemotron 3.5 Lightning 是免费的吗?
答:模型权重开源,可在 NVIDIA 官方渠道和魔搭社区下载,本地使用不产生模型费用;走云端 API 则按平台计费。
本地部署需要什么配置?
答:官方模型卡将 RTX 5090 列为支持配置,选择 NVFP4 量化权重可显著降低显存占用;BF16 版本建议使用数据中心级显卡。
NeMo Switchyard 是什么?
答:英伟达随模型一起开源的路由库,负责在多个模型之间智能分发请求,让主模型与执行层模型按任务类型协作,是 Lightning 官方推荐的使用姿势。
它能替代 Claude Code 这类编码 Agent 吗?
答:不能直接替代。它是一个模型,不是完整产品,定位是给 Agent 系统当执行引擎;想用它做编码助手,仍需搭配 Agent 框架和工具链。
 京ICP备2024094994号-29