
EnvHarness 是什么:Google Research 开源 AI Agent 环境包装框架全面解读
EnvHarness 是什么
EnvHarness 是 Google Cloud AI Research 于 2026 年 8 月 20 日发布的开源框架,论文标题为 EnvHarness: Awakening Static Worlds for Agent Learning。它提供了一种全新的思路:不重新造环境,而是给现有环境加一个可编程的包装层。
项目的核心比喻很简单——就像 Agent 可以通过工具(Tool)、记忆(Memory)、技能(Skill)等外部层来扩展能力一样,EnvHarness 用同样的思路,通过一个可编程包装层来改造静态环境,而不修改环境本身的代码。
"Agents got a harness. Now the environment gets one." —— EnvHarness 官网
为什么需要 EnvHarness?
当前 AI Agent 的训练面临一个根本性问题:评测基准是静态的。
- 同一个基准测试,同一个任务,每一次训练看到的是完全相同的初始状态、规则和反馈
- 一旦 Agent 学会了应对这些固定模式,继续训练就变成了刷题,不再有学习价值
- 构建新环境成本极高,且每次构建都是从零开始,很难保证质量
EnvHarness 解决的就是这个问题:让静态环境动起来。通过给现有环境加一层可编程包装,可以在不改变原任务和验证器的情况下,动态调整训练难度和方向。
三大核心组件
EnvHarness 定义了三种组件类型,都可以通过 reset() 和 step() 接口叠加到任意基准测试上:
1. Stage(阶段)
定制每个 episode 的起始状态 s₀。比如在 SWE-bench 中,可以让 Agent 从一个已经修改了部分代码的仓库开始,而不是每次都是从头开始。
2. Contract(契约)
拦截并修改 Agent 的动作和环境反馈,相当于给训练过程加规则约束。比如:
- 强制 Agent 在提交代码前必须先运行测试
- 如果 Agent 跳过了某些关键步骤,给出惩罚性反馈
- 在某个条件下触发额外的提示信息
3. Termination(终止)
改变 episode 结束条件。比如:
- 要求 Agent 在更少的步骤内完成任务
- 增加额外的失败条件
- 引入随机性,让 Agent 必须适应不同的成功标准
这三种组件可以任意组合叠加:E″ = w₂(w₁(E)),就像函数组合一样,每个组件只改造一部分行为,但叠加起来可以产生非常丰富的训练环境。
EnvRigger:自动化设计引擎
EnvHarness 配套了一个名为 EnvRigger 的自动化设计工具,它是一个 LLM 驱动的设计 Agent,自动执行四步循环:
- Observe(观察):收集策略在基线环境上的执行轨迹
- Diagnose(诊断):分析轨迹,找出系统性缺陷
- 比如:Agent 提交代码前不运行测试,靠运气通过——这就是一个可以针对性改进的弱点
- Write(编写):生成可执行的 Python 脚本(Contract 子类),施加约束
- 写一个 Contract:如果 Agent 在提交前没运行
pytest,就拦截并提示请先运行测试套件
- 写一个 Contract:如果 Agent 在提交前没运行
- Validate(验证):在新的 rollout 上验证,确保环境可学但不过难
这个循环可以反复进行,每次迭代都针对当前策略的弱点定制环境。
实测效果
EnvHarness 在三个主流 Agent 基准测试上进行了验证:
| 基准测试 | 领域 | 基础性能 | 真实环境训练 | EnvHarness 环境 | 提升 |
|---|---|---|---|---|---|
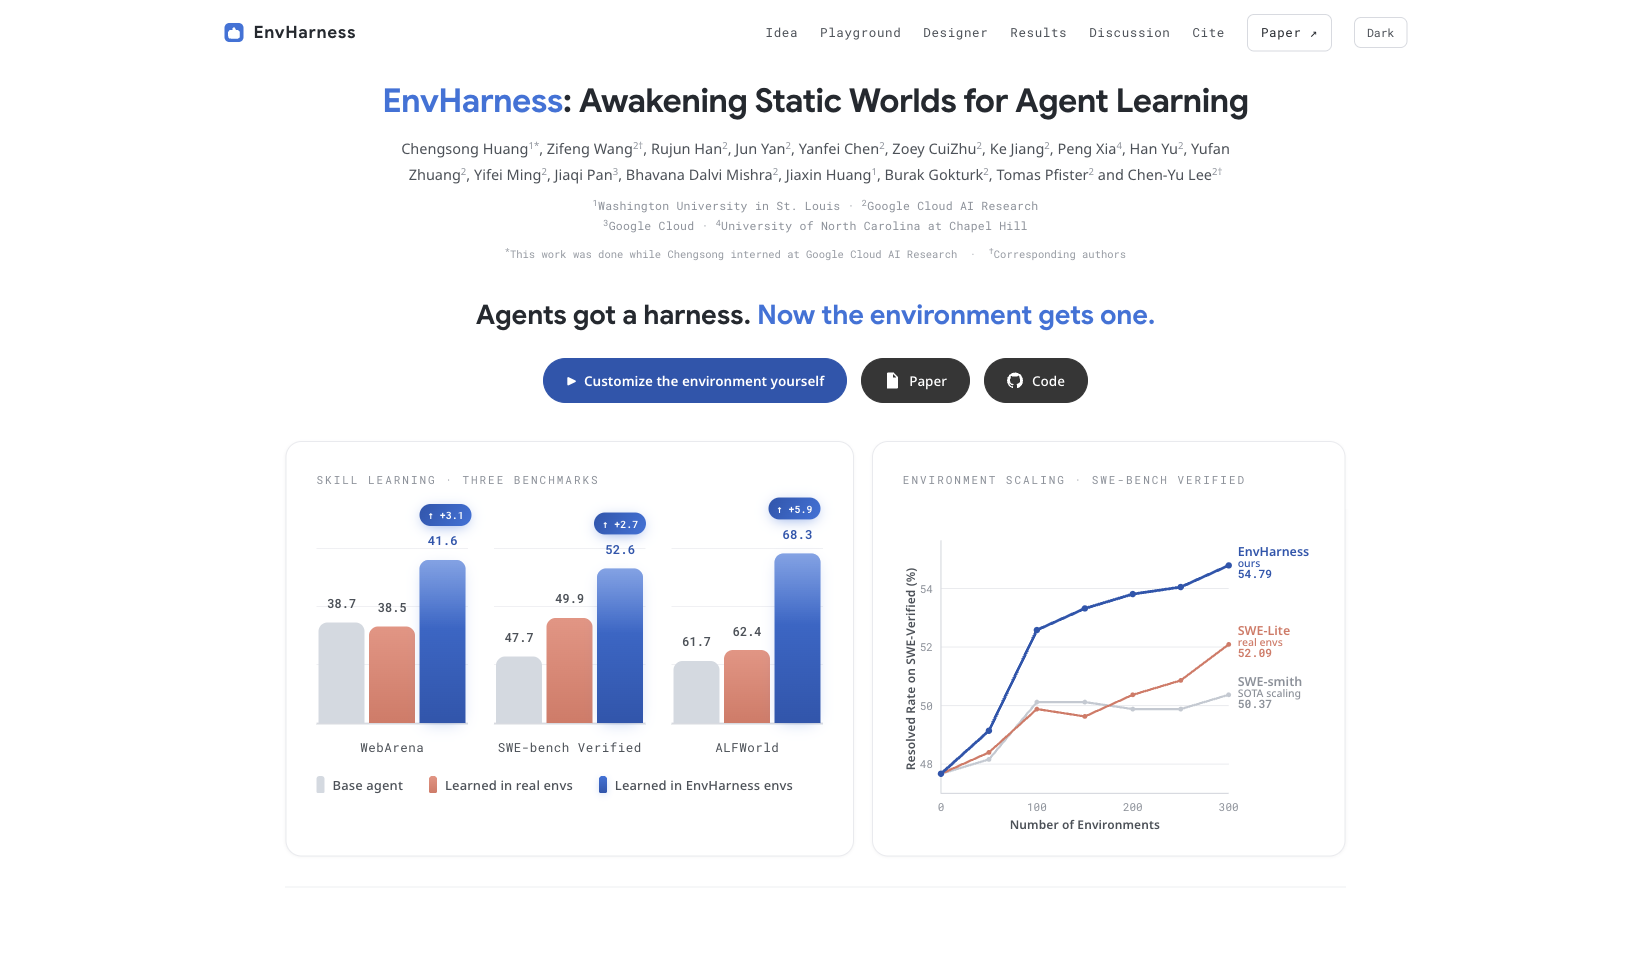
| WebArena | 网页导航 | 38.5% | 38.7% | 41.6% | +3.1 |
| SWE-bench Verified | 软件工程 | 49.9% | 47.7% | 52.6% | +2.7 |
| ALFWorld | 具身 AI | 62.4% | 61.7% | 68.3% | +5.9 |
更重要的是,EnvHarness 的增益在不同策略模型上保持一致:
| 模型 | 基础 | 真实环境训练 | EnvHarness 环境 | 提升 |
|---|---|---|---|---|
| Gemini 3.1 Flash-Lite | 30.7% | 36.8% | 40.0% | +3.2 |
| Qwen3.6 27B | 41.0% | 48.4% | 52.1% | +3.7 |
| Gemini 3.5 Flash | 47.8% | 49.8% | 52.7% | +2.9 |
| Claude Sonnet 4.6 | 67.2% | 69.2% | 72.4% | +3.2 |
增益稳定在 2.9 到 3.7 个点之间,而且计算效率也有提升——执行步骤平均减少 9.8%。
论文中的其他亮点
- 按需调控难度:可以将基准测试的成功率精确调控到目标区间(如 [0.4, 0.6]),从原有的 6% 成功率提升到 80% 可控
- RL 训练更高效:在 EnvHarness 环境上做强化学习,效果(88.3%)优于在原始环境上训练(85.4%)
- 策略-环境共同进化:三轮迭代后,SWE-bench Verified 从 47.7% 提升到 54.8%,超越了 SOTA 缩放方法
- 论文中包含了 9 个跨三个基准测试的针对性弱点案例研究
如何上手 EnvHarness
EnvHarness 是开源项目,采用 Apache-2.0 许可:
- GitHub 仓库:https://github.com/google-research/envharness
- 论文地址:https://arxiv.org/abs/2608.19880
- 官网:https://envharness.com(含浏览器内可运行的交互式 Playground)
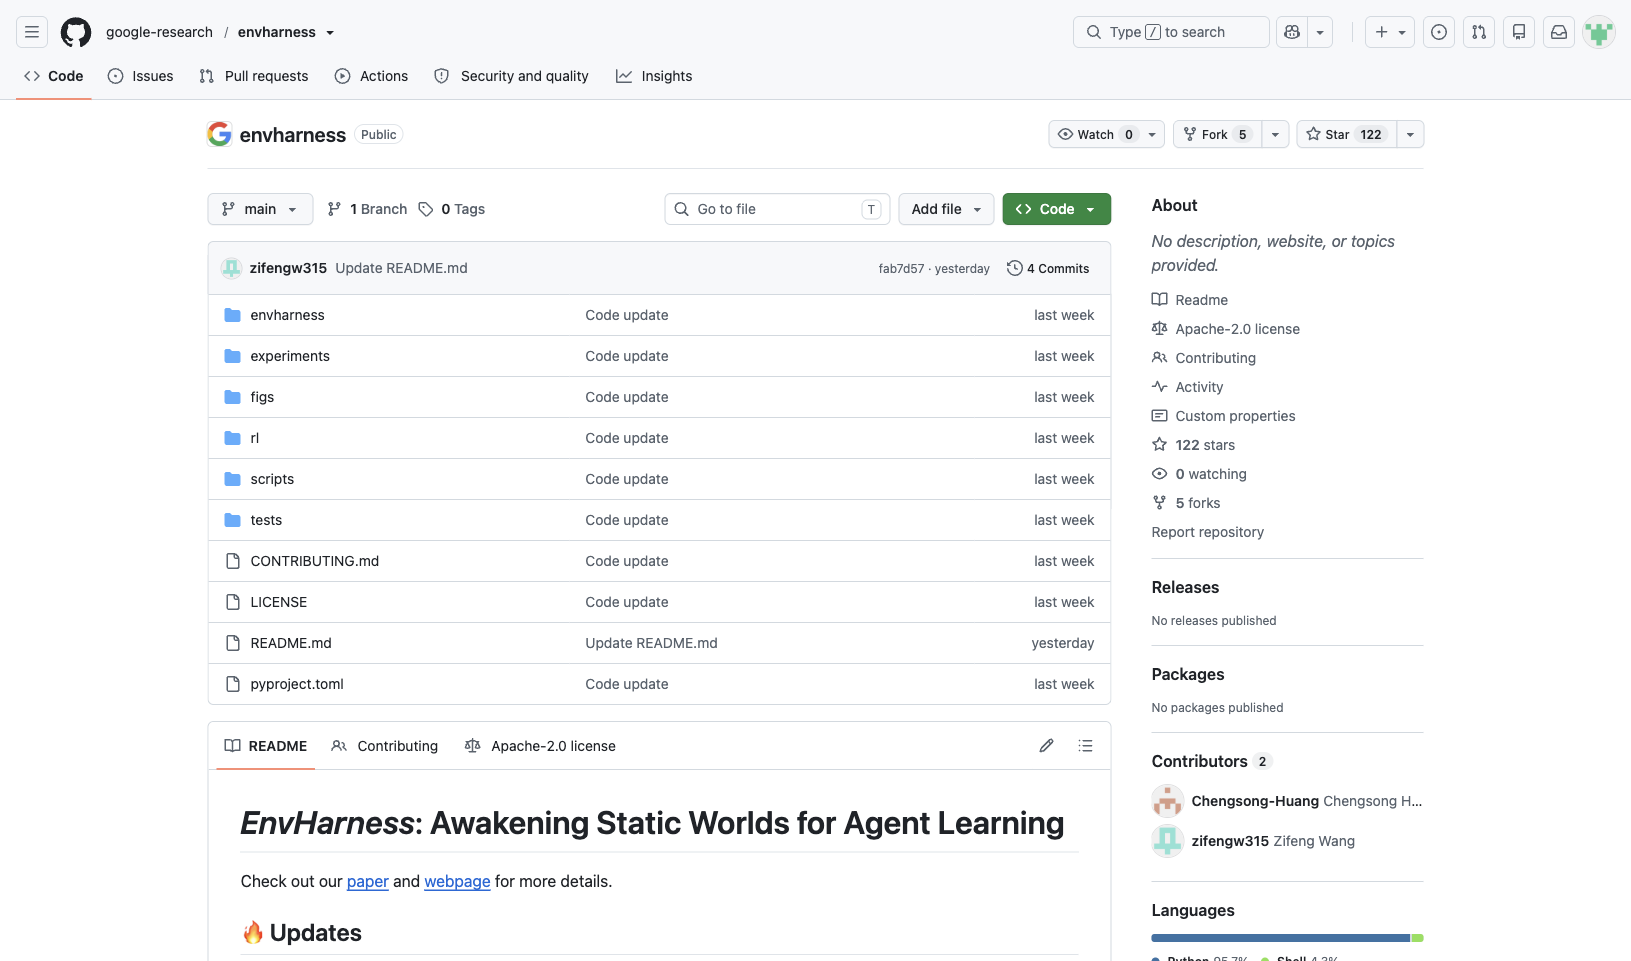
仓库中包含:
ActionableEnv核心接口- 每个基准测试的 Bridge 适配层
- 三种组件类型的完整实现
- EnvRigger 设计 Agent 的实现
- 预设配置,可直接复现论文中的每个实验结果
社区反响
EnvHarness 发布后获得了 AI 研究社区的广泛关注:
- DAIR.AI 评价:终于有一篇论文认真测试了基于记忆的自我改进 Agent 是否真的在进步
- Pascal Biese(LinkedIn):EnvHarness 巧妙翻转了对称性——如果你能通过外部层包装一个冻结的 LLM 来提升能力,那同样的思路也可以用来包装冻结的环境
- WindFlash 日报 以 The Harness Wars 为题报道了这项工作
- 论文作者之一 Zifeng Wang 在 LinkedIn 上发布了视频演示
相关链接
常见问题
EnvHarness 和传统环境生成方法有什么区别?
传统方法(如 SWE-smith、SWE-Lite)需要重新生成新的环境实例,成本高且难以保证质量。EnvHarness 不生成新环境,而是通过包装层改造现有环境,继承原始基准测试的验证器,保证质量的同时大幅降低成本。
EnvHarness 需要修改原始基准测试代码吗?
不需要。EnvHarness 的所有组件都通过标准 `reset()/step()` 接口与原始环境交互,不修改原始任务和验证器。
EnvHarness 支持哪些类型的基准测试?
目前官方支持 WebArena(网页导航)、SWE-bench Verified(软件工程)和 ALFWorld(具身 AI)。但由于架构设计是通用的,理论上可以扩展到任何通过 `reset()/step()` 接口交互的基准测试。
EnvHarness 是免费的吗?
是的,EnvHarness 是完全开源的,采用 Apache-2.0 许可协议,代码和模型权重均可免费使用。
 京ICP备2024094994号-29