
VibeVoice ASR 是什么?微软开源流式语音识别 10 语种
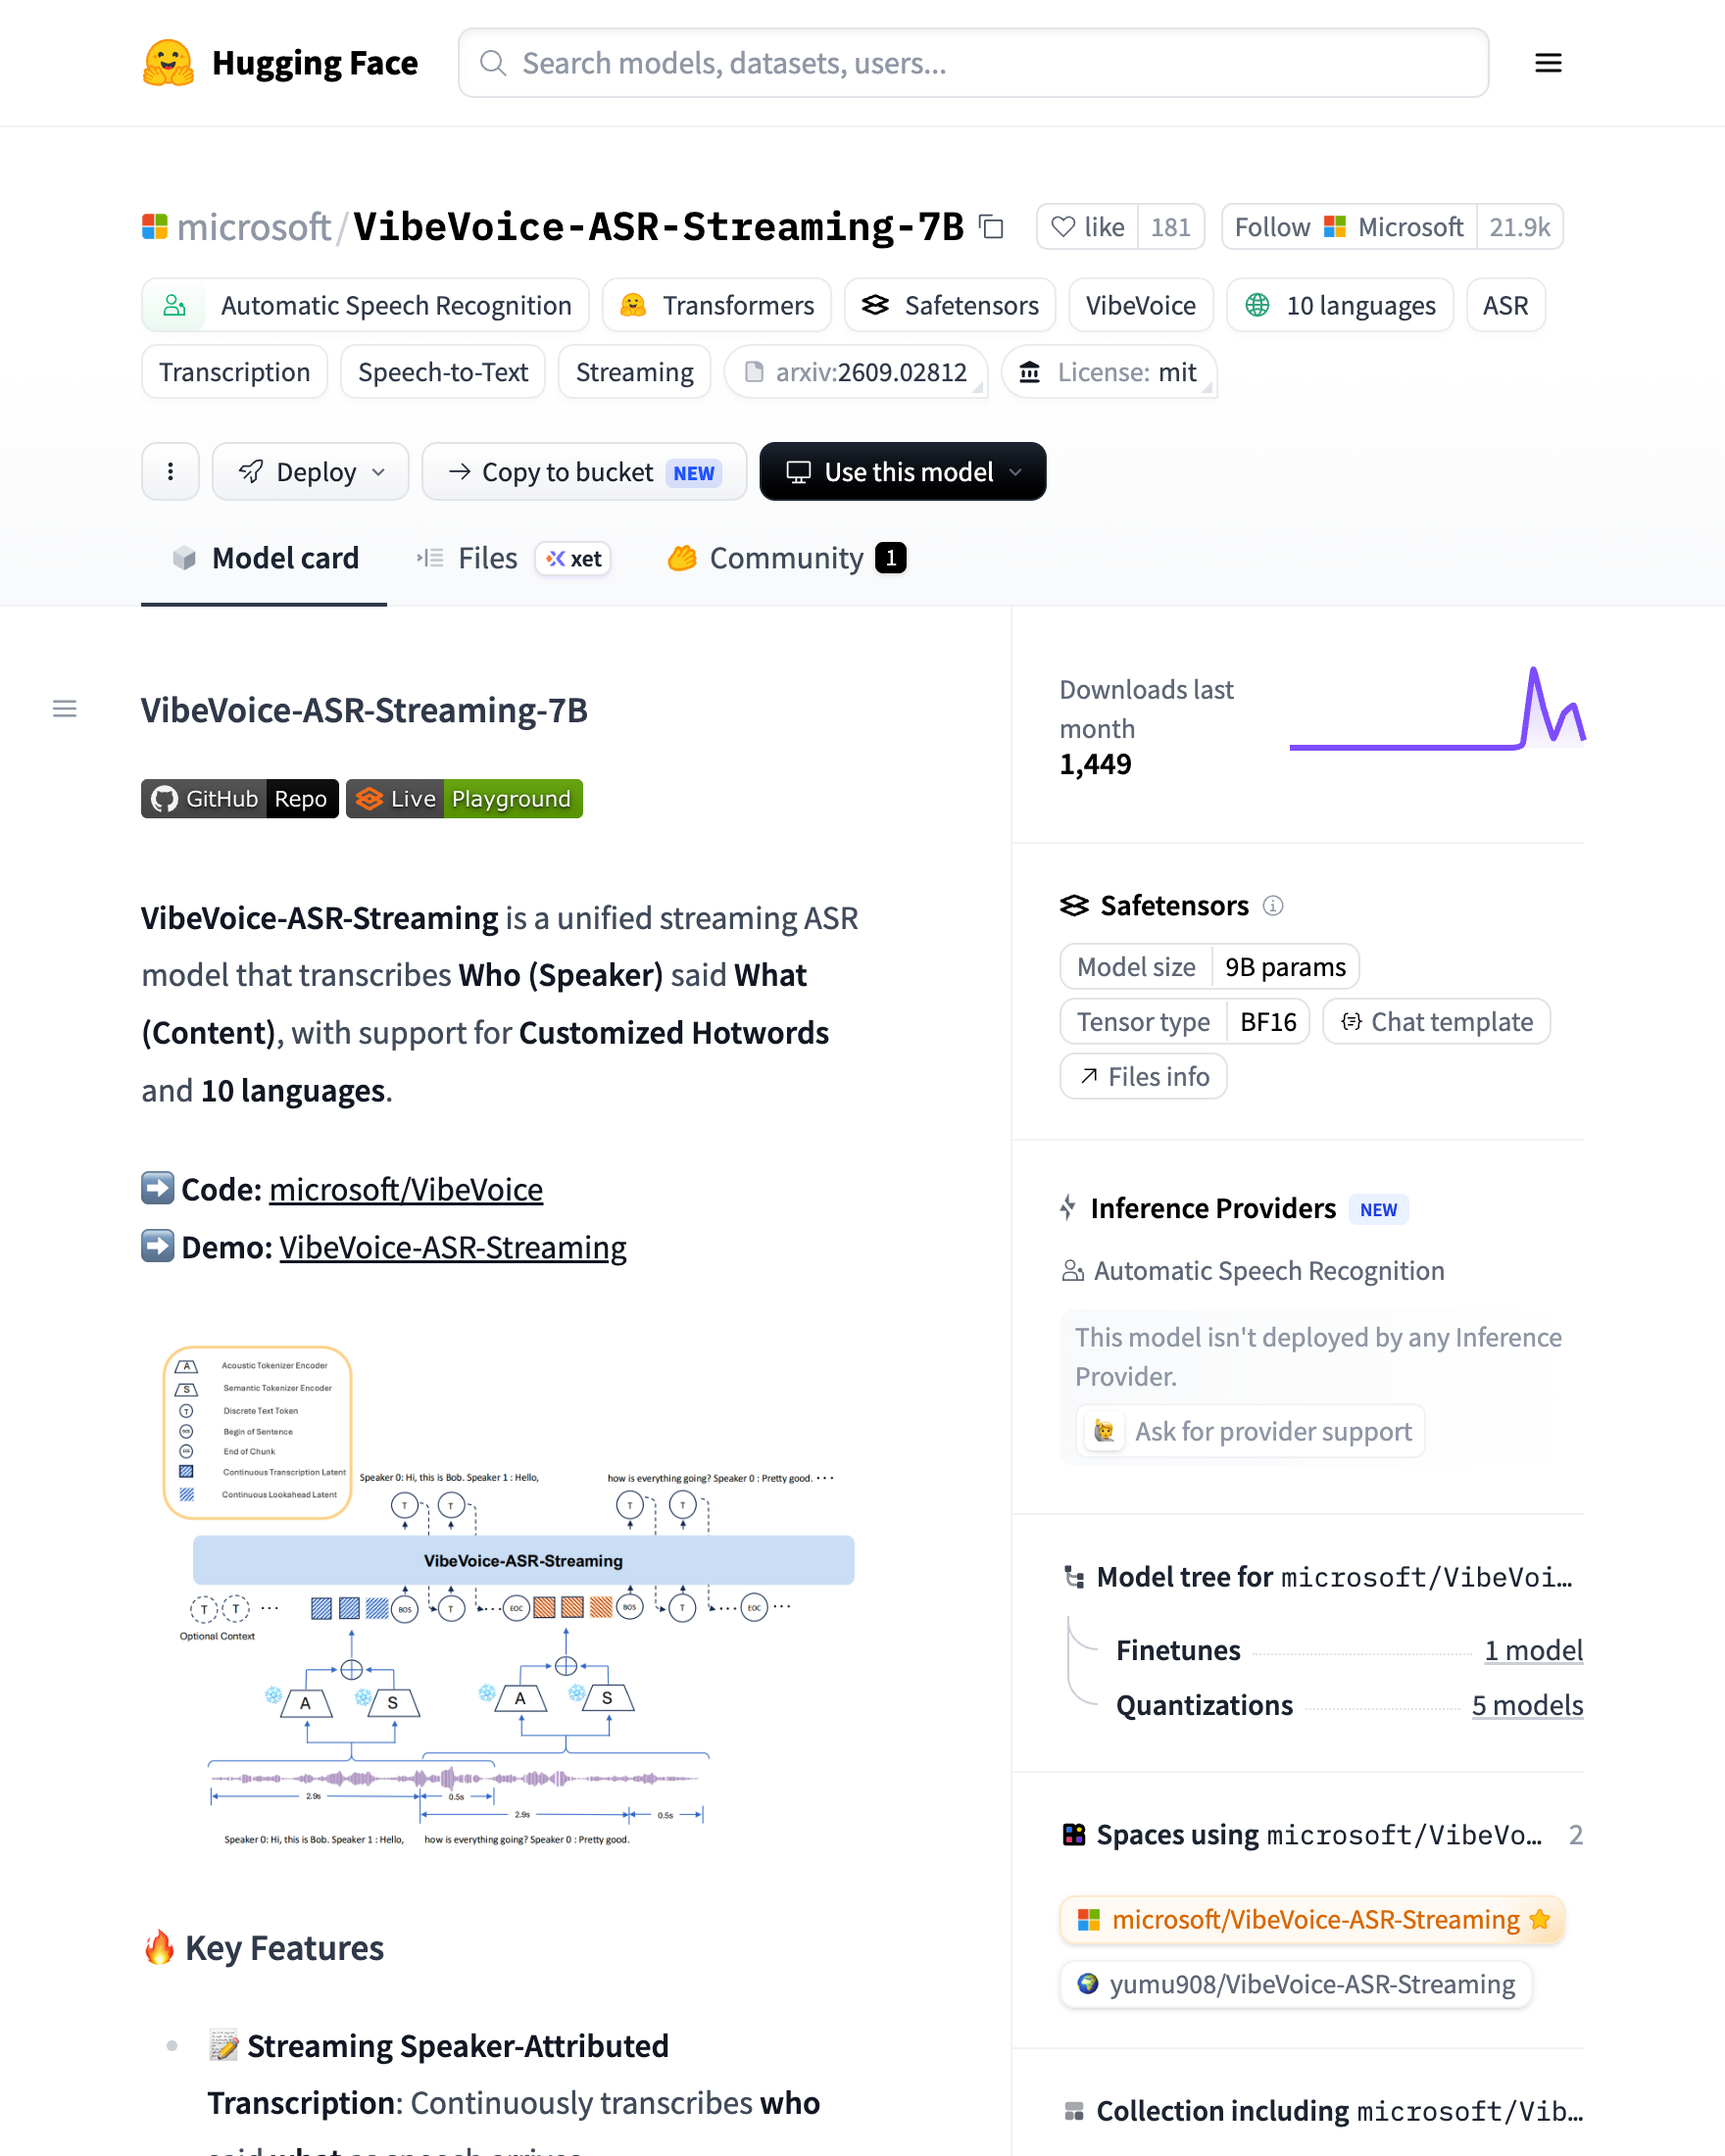
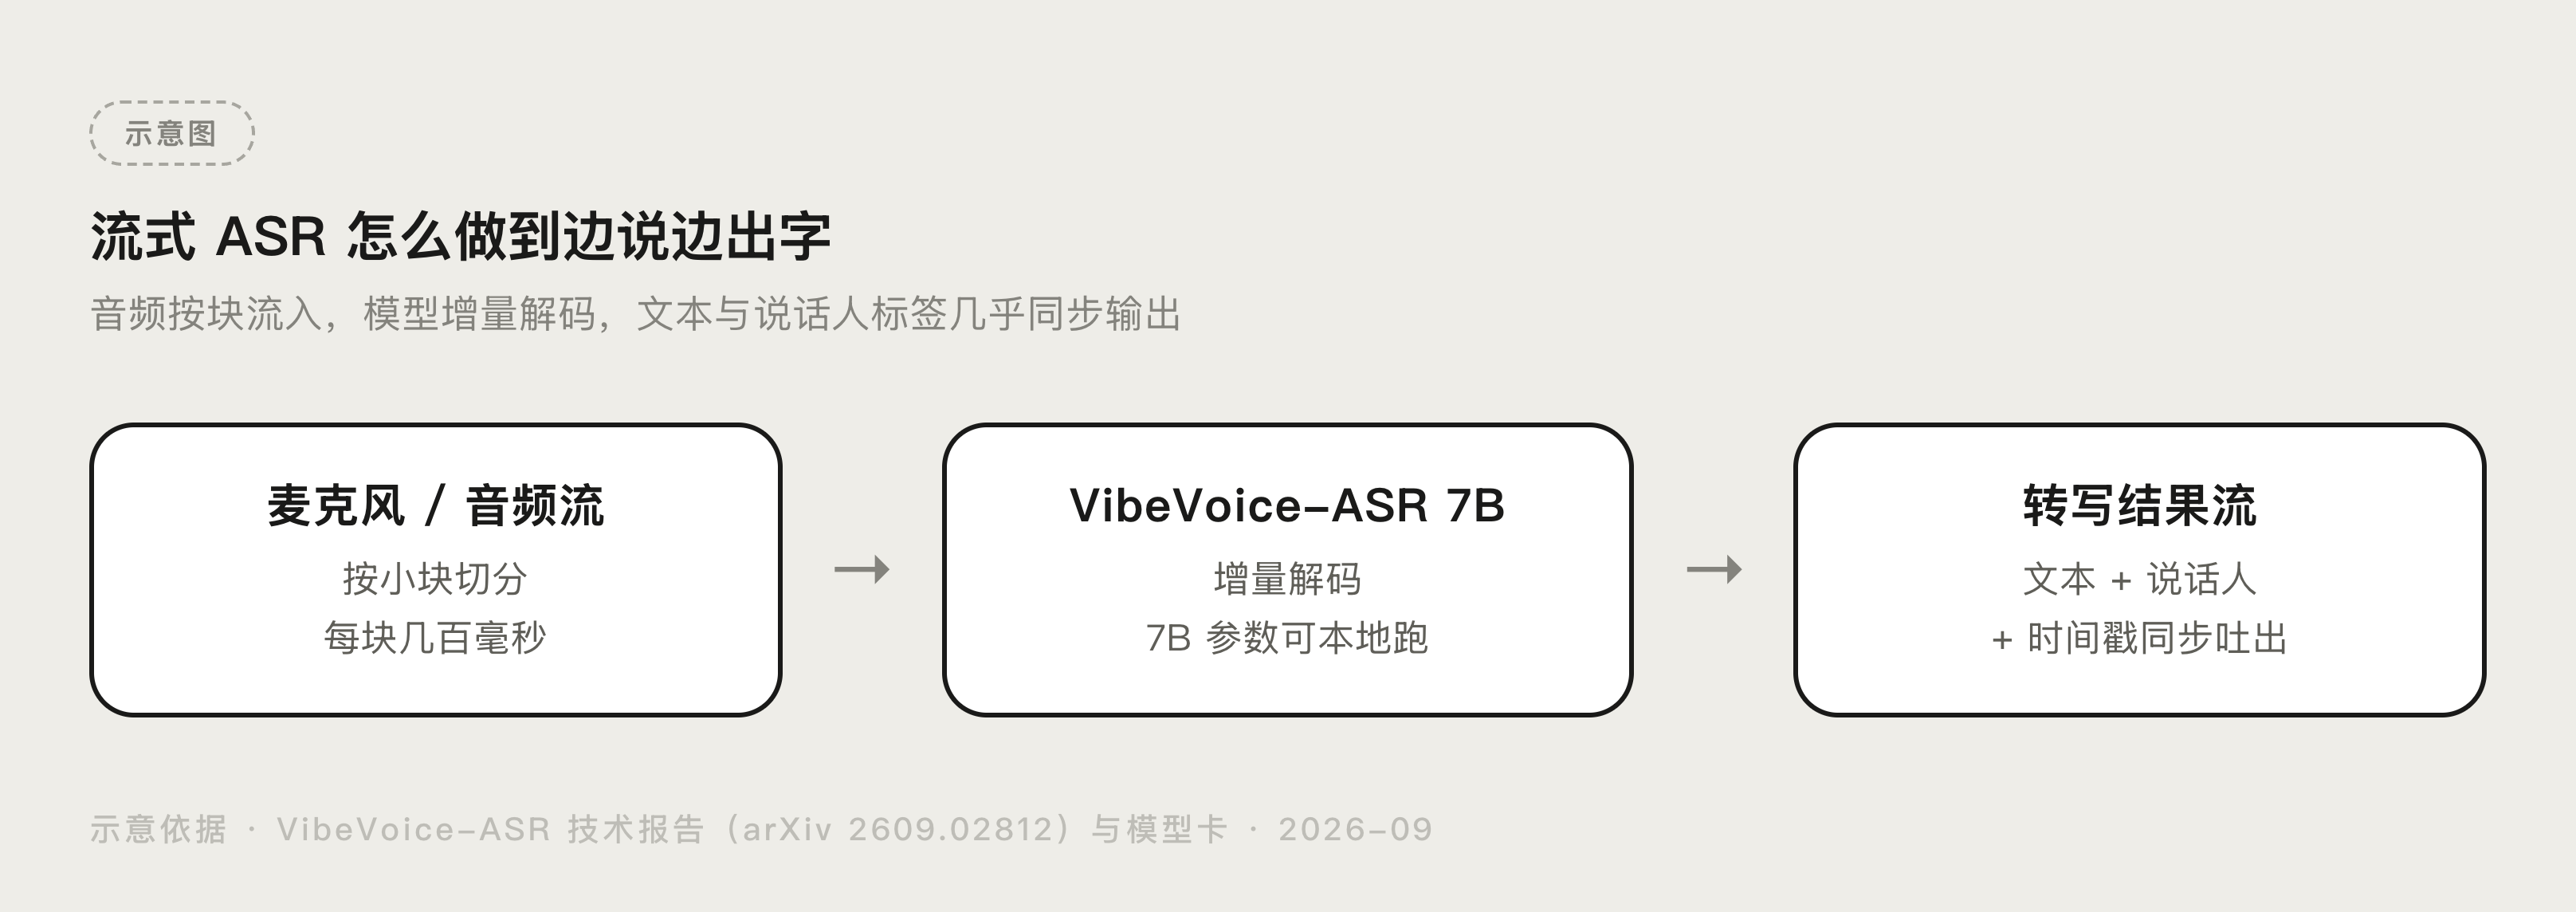
VibeVoice ASR 是微软研究院 2026 年 9 月 2 日上架 Hugging Face 的开源流式语音识别模型,7B 参数、MIT 协议可商用(模型卡)。它解决的问题是:语音一边进来一边出文字,还顺手告诉你每句话是谁说的,支持中文等 10 种语言,上线一周 HF 页面点赞已超过 180。
它是什么来头
模型全名 VibeVoice-ASR-Streaming-7B,出自微软研究院,代码开源在 GitHub 的 microsoft/VibeVoice 仓库(官方仓库),模型权重托管在 Hugging Face,同页附在线 Demo(aka.ms/vibeasr)和技术报告(arXiv 2609.02812)。定位很清楚:不是又一个整段转写工具,而是给实时场景用的「边听边写」模型。
三个核心能力,各自意味着什么
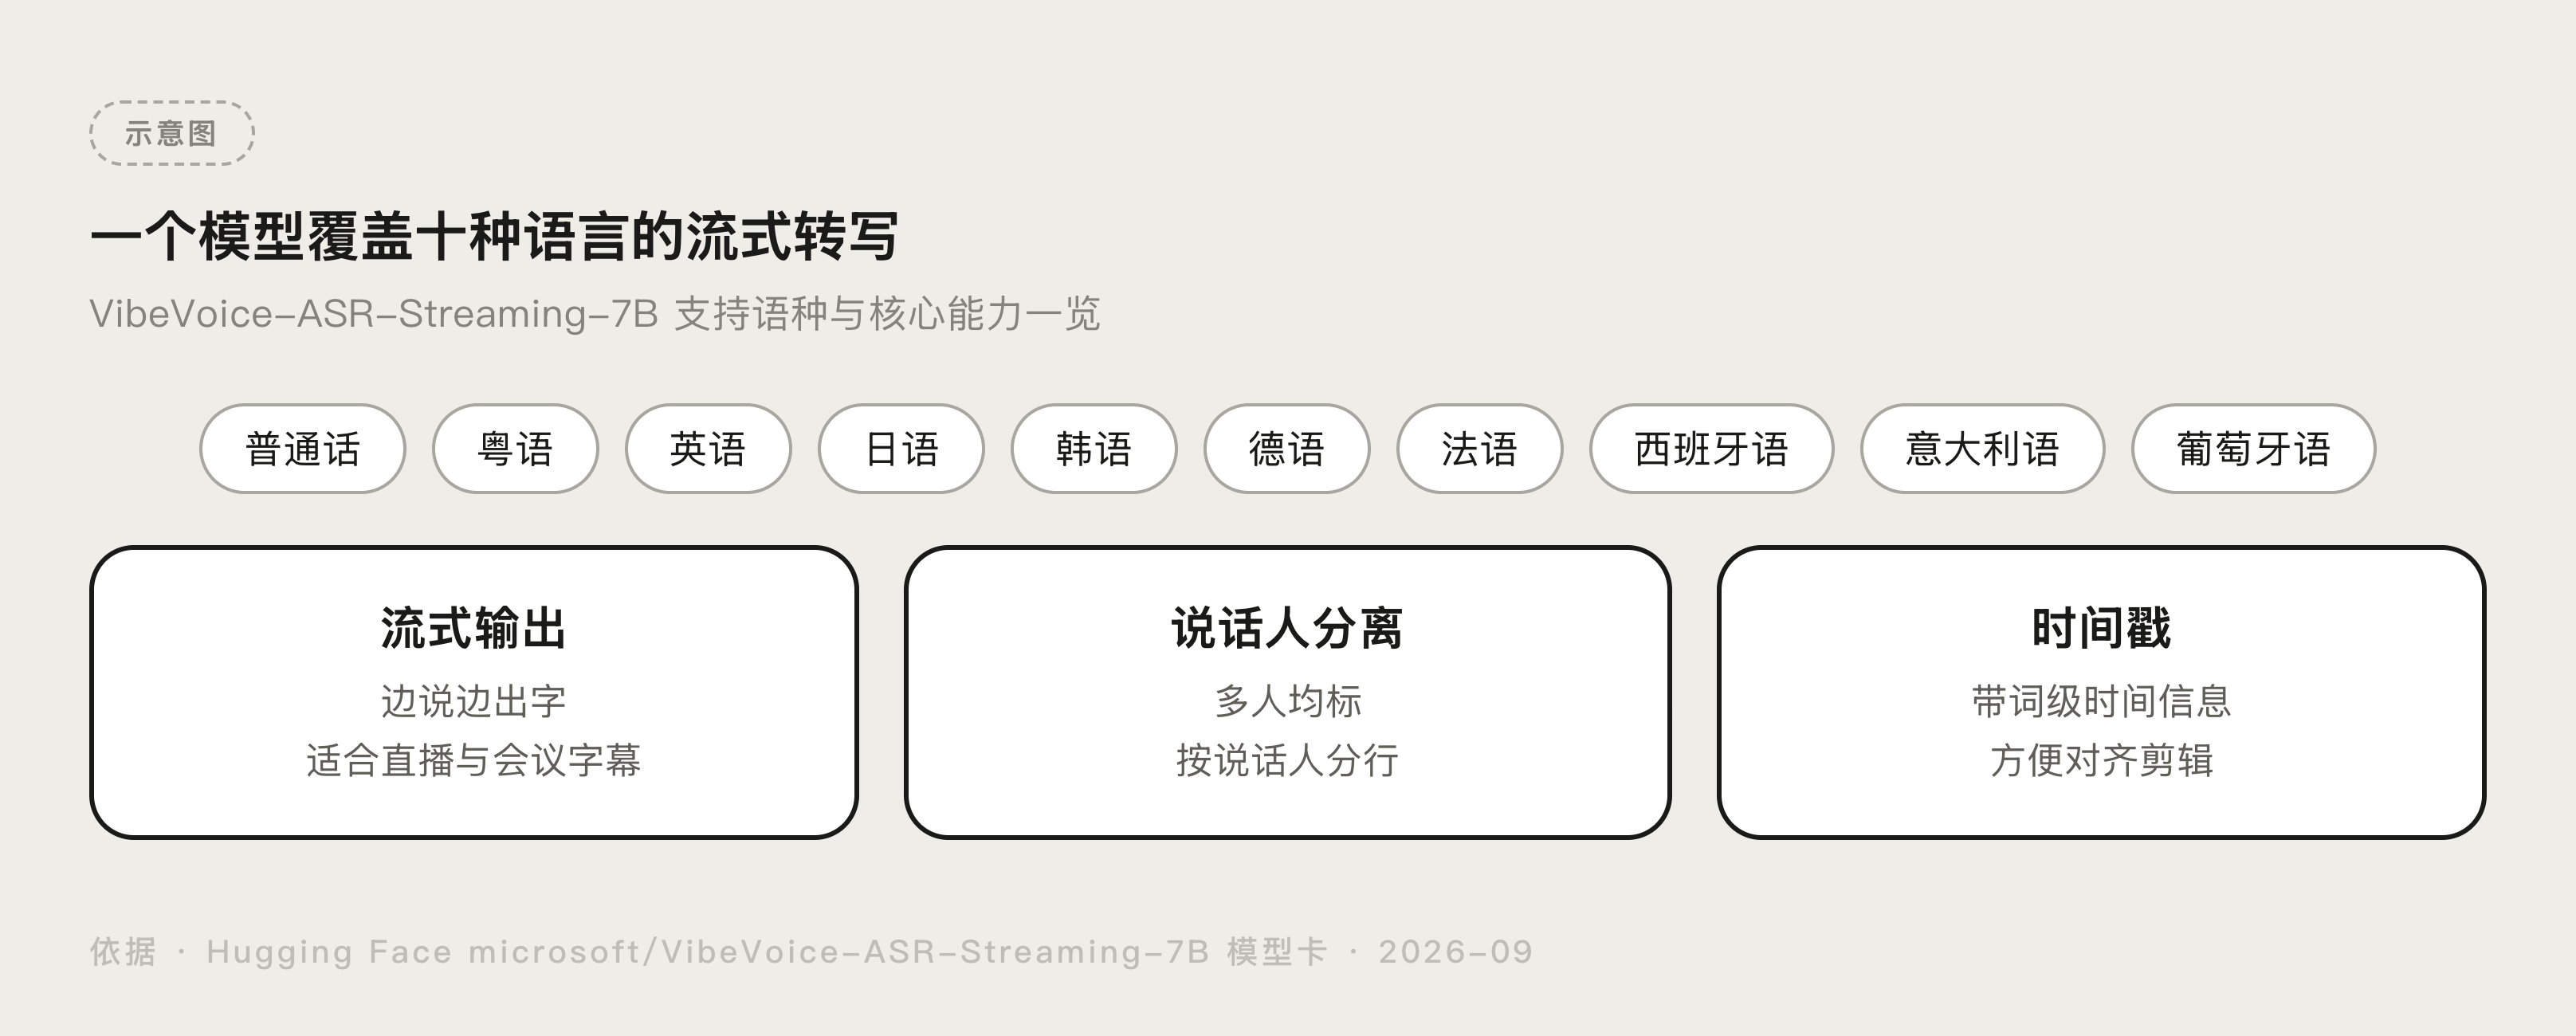
- 流式说话人转写:语音边进边转写,每句话标注说话人。对会议、播客、客服录音来说,省掉了「先转写再分离说话人」的两步工序
- 自定义热词:把人名、产品名、术语预先喂给模型,专有名词识别率明显提升。做垂直领域内容(医疗、法律、游戏)的团队最需要这个
- 10 种语言:中、英、日、韩、法、德、意、葡、俄、西,中文在官方支持列表里,国内用户可以直接测
和 Whisper 这类老牌 ASR 的边界
Whisper 系工具以整段转写为主,想要说话人区分通常要另接声纹分离工具再对齐时间轴。VibeVoice ASR 把流式、说话人归属、热词三件事做进同一个模型,对做实时字幕、会议纪要的开发者来说少写一整段胶水代码。注意边界:它只管听写,不负责翻译,也不负责语音合成,后两者不是这个模型的活。
适合谁用 / 不适合谁
适合:要给会议、播客、直播做实时字幕或纪要的开发者和团队;需要开源商用授权(MIT)的产品;被专有名词识别折磨的内容团队。
不适合:想在手机端离线跑的轻量场景,7B 参数量对端侧设备不算友好;只偶尔转写一两段音频的轻度用户,直接用现成转写 App 更省事。
3 步上手
- 在线体验最快:打开官方在线 Demo(aka.ms/vibeasr),上传音频直接看转写和说话人标注效果
- 本地部署:到 GitHub 的 microsoft/VibeVoice 仓库,按 README 安装依赖并加载模型
- 拿权重:在 Hugging Face 的 microsoft/VibeVoice-ASR-Streaming-7B 页面下载,国内访问 HF 需要自行解决网络问题,镜像站可用时优先走镜像
开源语音模型最近的动作不少,站内持续跟进的动态汇总见 GLM6 最新消息与发布进展。
想动手做点东西的话,搭原型可配合 Google AI Studio 使用指南快速起服务;做学生认证薅算力羊毛的路线见 Gemini 学生认证教程。
常见问题
VibeVoice ASR 免费吗?可以商用吗?
答:模型以 MIT 协议开源,个人和商用都免费,代码与权重均可自行下载部署。
它支持中文吗?
答:支持。官方列出 10 种语言,中文、英文在列,并支持自定义热词提升中文专有名词识别率。
本地跑需要什么配置?
答:模型是 7B 参数,消费级显卡可以尝试部署,具体显存要求以 GitHub 仓库 README 为准;不想部署可直接用官方在线 Demo。
它能替代人工字幕吗?
答:能明显加速转写初稿,尤其是多说话人录音的说话人区分环节,但专业交付仍建议人工校对。
它和 VibeVoice 语音合成是什么关系?
答:同属微软 VibeVoice 项目,ASR 负责听写,系列里另有语音合成方向的工作,本篇只聚焦这个流式识别模型。
 京ICP备2024094994号-29