
mica-voice 1.0.2 发布:Java 声音 AI 全家桶,一行代码接入 ASR/TTS/声纹
mica-voice 1.0.2 是「如梦技术(dreamlu)」开源的 Java 声音 AI 库,2026 年 9 月 3 日更新的版本:把 ASR(语音识别)、TTS(语音合成)、声纹识别、VAD(语音活动检测)、说话人分离、关键词唤醒 KWS、音频降噪 7 大能力统一封装,底层用 sherpa-onnx 做纯本地推理,一行代码就能在 Java / Spring Boot / Solon 项目里接入,Apache 2.0 协议可商用。1.0.2 是一次偏「修稳定性 + 补示例」的小版本更新,重点是修复 JNI 兼容性问题并新增流式 TTS WebSocket 示例。
最后更新于 2026 年 9 月|本文由 AI345 编辑部基于 mica-voice 官方 README 与 CHANGELOG(GitHub、Gitee 两个仓库)、Maven Central 元数据逐条核实整理;版本日期与功能描述以官方仓库为准。
目录
- mica-voice 1.0.2 是什么?
- mica-voice 1.0.2 更新了什么?
- 7 大能力:mica-voice 到底能做什么
- mica-voice 怎么用?30 秒上手
- 模型怎么准备?下载脚本与目录约定
- mica-voice 适合谁用?5 个典型场景
- 和云端语音 API、Python 方案怎么选
- 常见问题 FAQ
mica-voice 1.0.2 是什么?
一句话:它是 Java 生态里少见的「声音 AI 全家桶」。 把过去要东拼西凑一堆 Python 服务和云 API 才能凑齐的能力(识别、合成、声纹、降噪等),收进一个 Maven 依赖里,模型放本地、音频不出机、没有按量调用费。
对 Java 开发者来说,这件事的价值在于:语音能力长期以来是 Java 后端的短板。想加个「录音转文字」,常规做法是再起一个 Python 服务跑 FunASR/Whisper,或者直接调用云厂商的语音 API。前者要多维护一套运行时,后者意味着音频要传到第三方、且按量计费。mica-voice 走的是第三条路:用 sherpa-onnx 的全平台 native 包,在 JVM 进程内做离线推理。
| 项目 | 说明 |
|---|---|
| 项目名称 | mica-voice(当前版本 1.0.2) |
| 开发方 | 如梦技术(dreamlu,mica 系列开源作者) |
| 版本节奏 | v1.0.0 2026-08-15 首发 → v1.0.1 2026-08-21 → v1.0.2 2026-09-03 |
| Maven 坐标 | net.dreamlu:mica-voice-core / -spring-boot-starter / -solon-plugin |
| 开源协议 | Apache License 2.0,可商用、可二次开发 |
| 推理方式 | 纯本地离线推理,基于 mica-sherpa-onnx 1.13.7(全平台 native fat jar) |
| 运行环境 | JDK 8 / 17 / 21 / 25(Solon 插件标注 JDK 8 ~ 26);Windows / Linux / macOS |
| 代码仓库 | lets-mica/mica-voice(GitHub) 与 dreamlu/mica-voice(Gitee) |
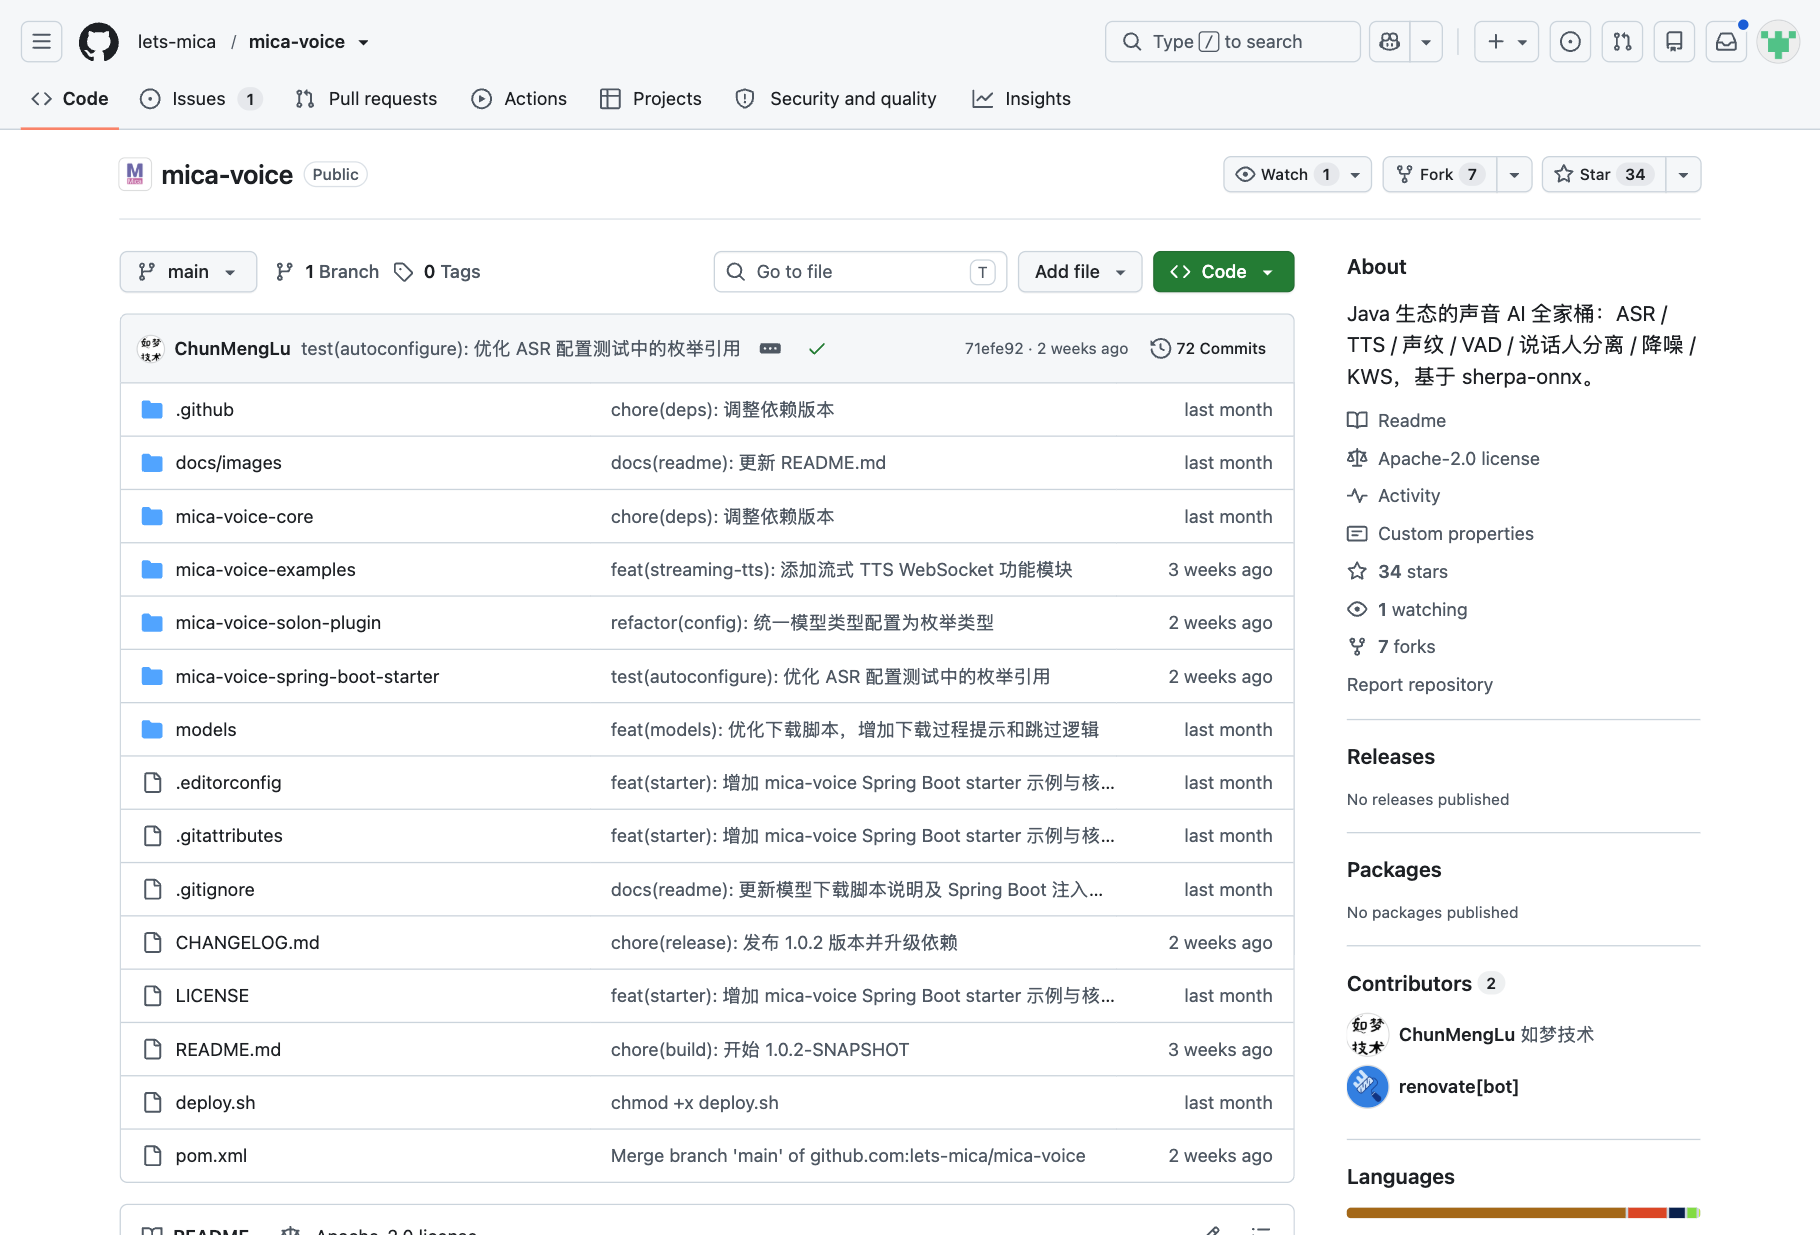
需要说清楚一个前提:mica-voice 是「封装层」,不是从零写的推理引擎。 它的推理能力来自上游的 sherpa-onnx(k2-fsa 团队的开源项目),mica-voice 做的事是:把 sherpa-onnx 的 native 包打成 Java 可用的全平台 jar,再在上面套一层统一的 Java 门面、Spring Boot 自动装配和 Solon 插件,并把语音模型的组织方式、生命周期管理(AutoCloseable 释放 native 句柄)这些工程细节处理好。
mica-voice 1.0.2 更新了什么?
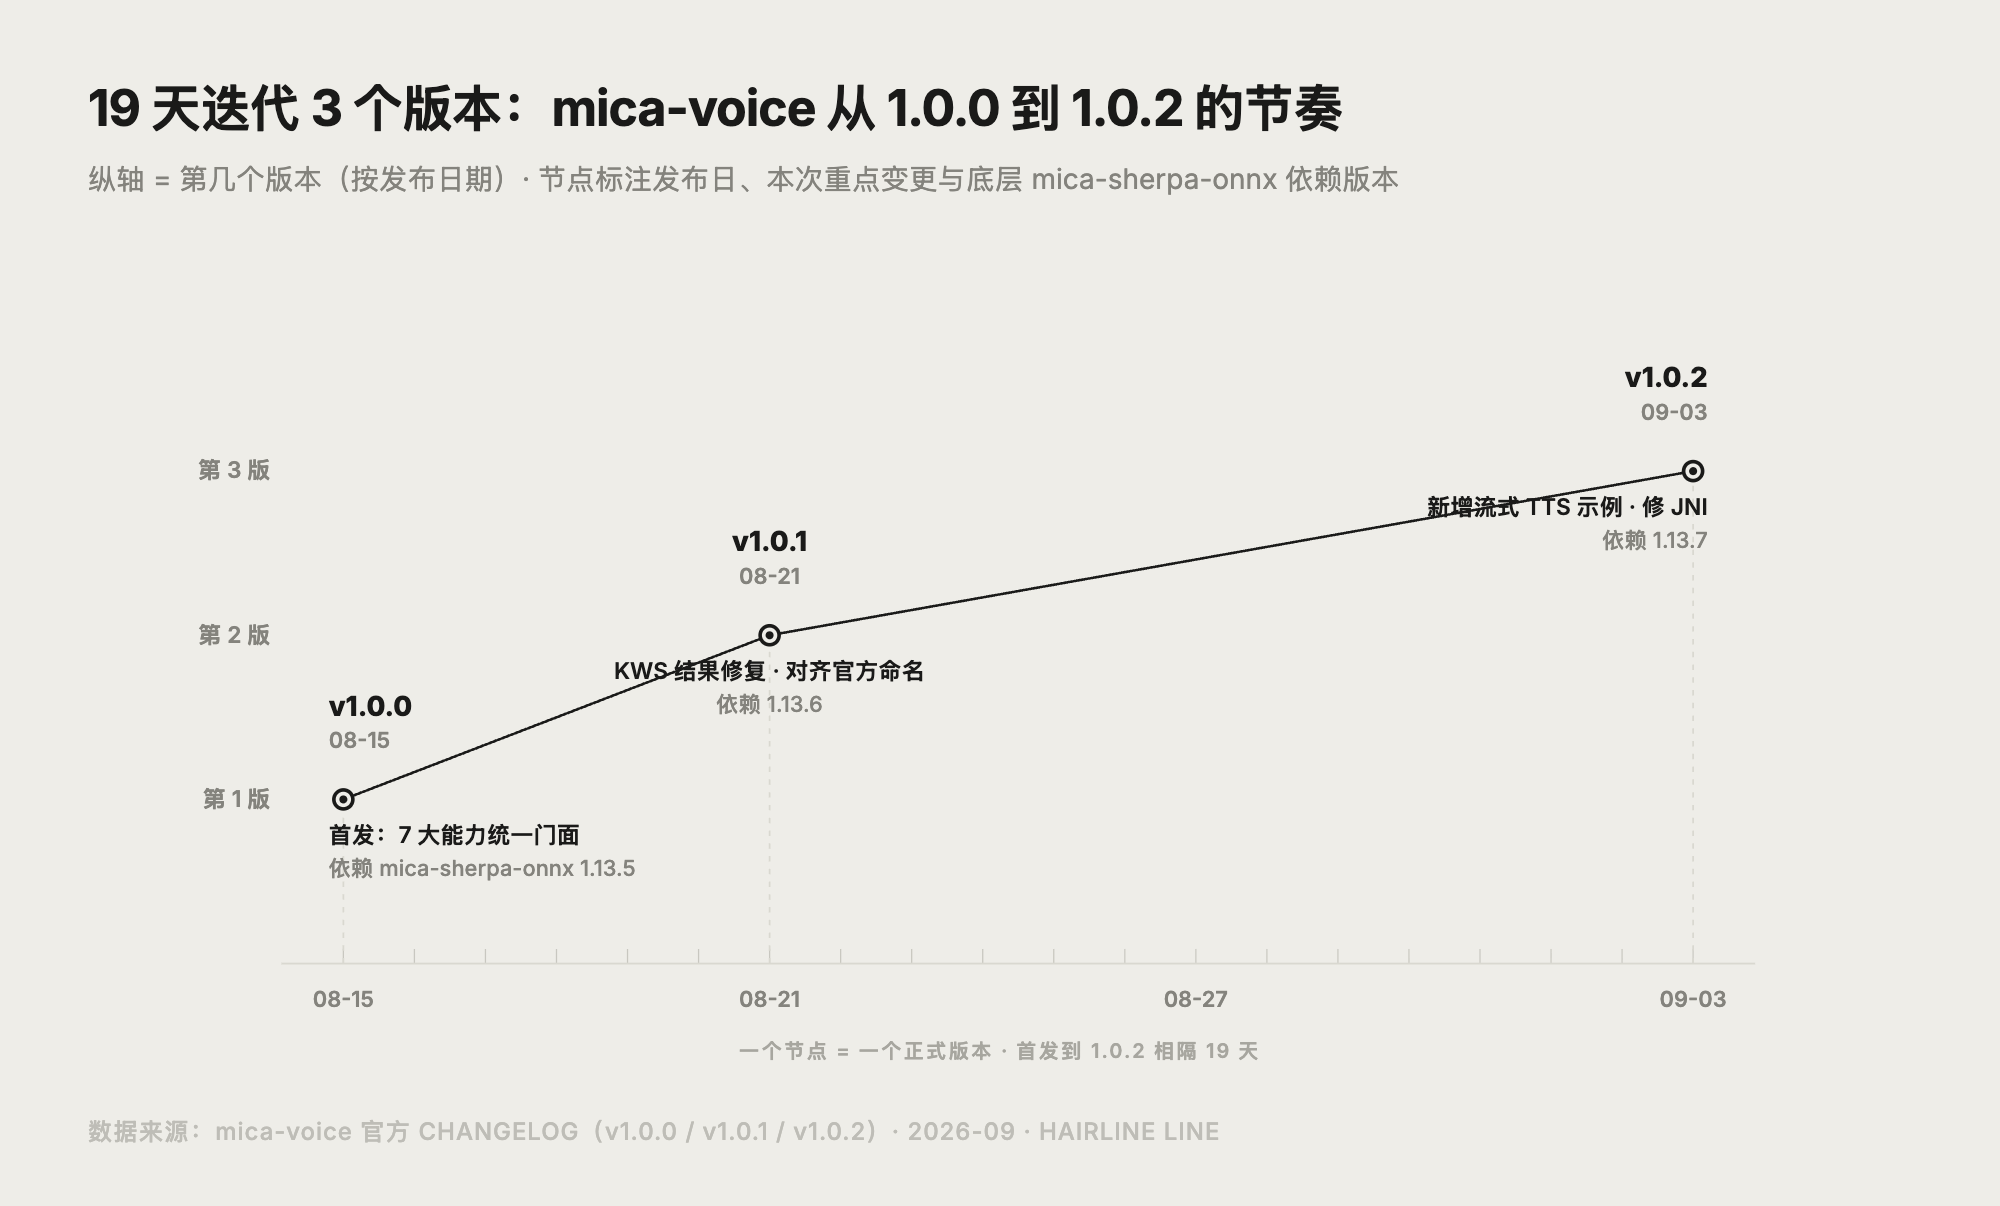
先说时间口径,因为这一点容易看混:官方 CHANGELOG 记录的 1.0.2 发布日期是 2026 年 9 月 3 日,Maven Central 上 1.0.2 的构件在 9 月 4 日可下载,而开源中国(OSCHINA)是在 9 月 20 日才发布 1.0.2 的正式新闻稿。也就是说,这次「发布」是补的官方公告,代码本身在 9 月初就已经可用了。
1.0.2 本身是一次小版本更新,具体就两件事:
- 新增流式 TTS(Streaming TTS)示例:在
mica-voice-example-spring-web里加了 WebSocket 示例,前端订阅/mica/voice/ws/streaming-tts,服务端按约 100ms 切片推送 PCM 音频,配合callback-sample-step实现「边合成边播放」,目的是降低首字延迟。 - 底层依赖升级到 mica-sherpa-onnx 1.13.7,并同步修复了若干 JNI 兼容性问题。
所以如果你的关注点是「1.0.2 带来了什么新能力」,答案是:没有新增大能力,主力能力在 1.0.0 就齐了,1.0.2 主要解决的是 native 层的稳定性,以及让流式语音合成的用法更直观。
三个版本横向对比更直观:
| 版本 | 发布日期 | 重点变更 | 底层依赖 |
|---|---|---|---|
| v1.0.0 | 2026-08-15 | 首发:统一门面 MicaVoice、7 大能力、Spring Boot starter / Solon 插件、三套示例工程、模型下载脚本 | mica-sherpa-onnx 1.13.5 |
| v1.0.1 | 2026-08-21 | 核心 SDK 新增窗口移动比例(window-shift-ratio)配置;修复 KWS 结果处理与模型目录命名(对齐 sherpa-onnx 官方) |
1.13.6 |
| v1.0.2 | 2026-09-03 | 新增流式 TTS WebSocket 示例;修复若干 JNI 兼容性问题 | 1.13.7 |
一个顺带信息:官方仓库的提交记录显示,1.0.3-SNAPSHOT 的开发已经在 2026 年 9 月 7 日启动。以它前三版平均约一周一版的节奏看,下一版应该不会太远。
7 大能力:mica-voice 到底能做什么
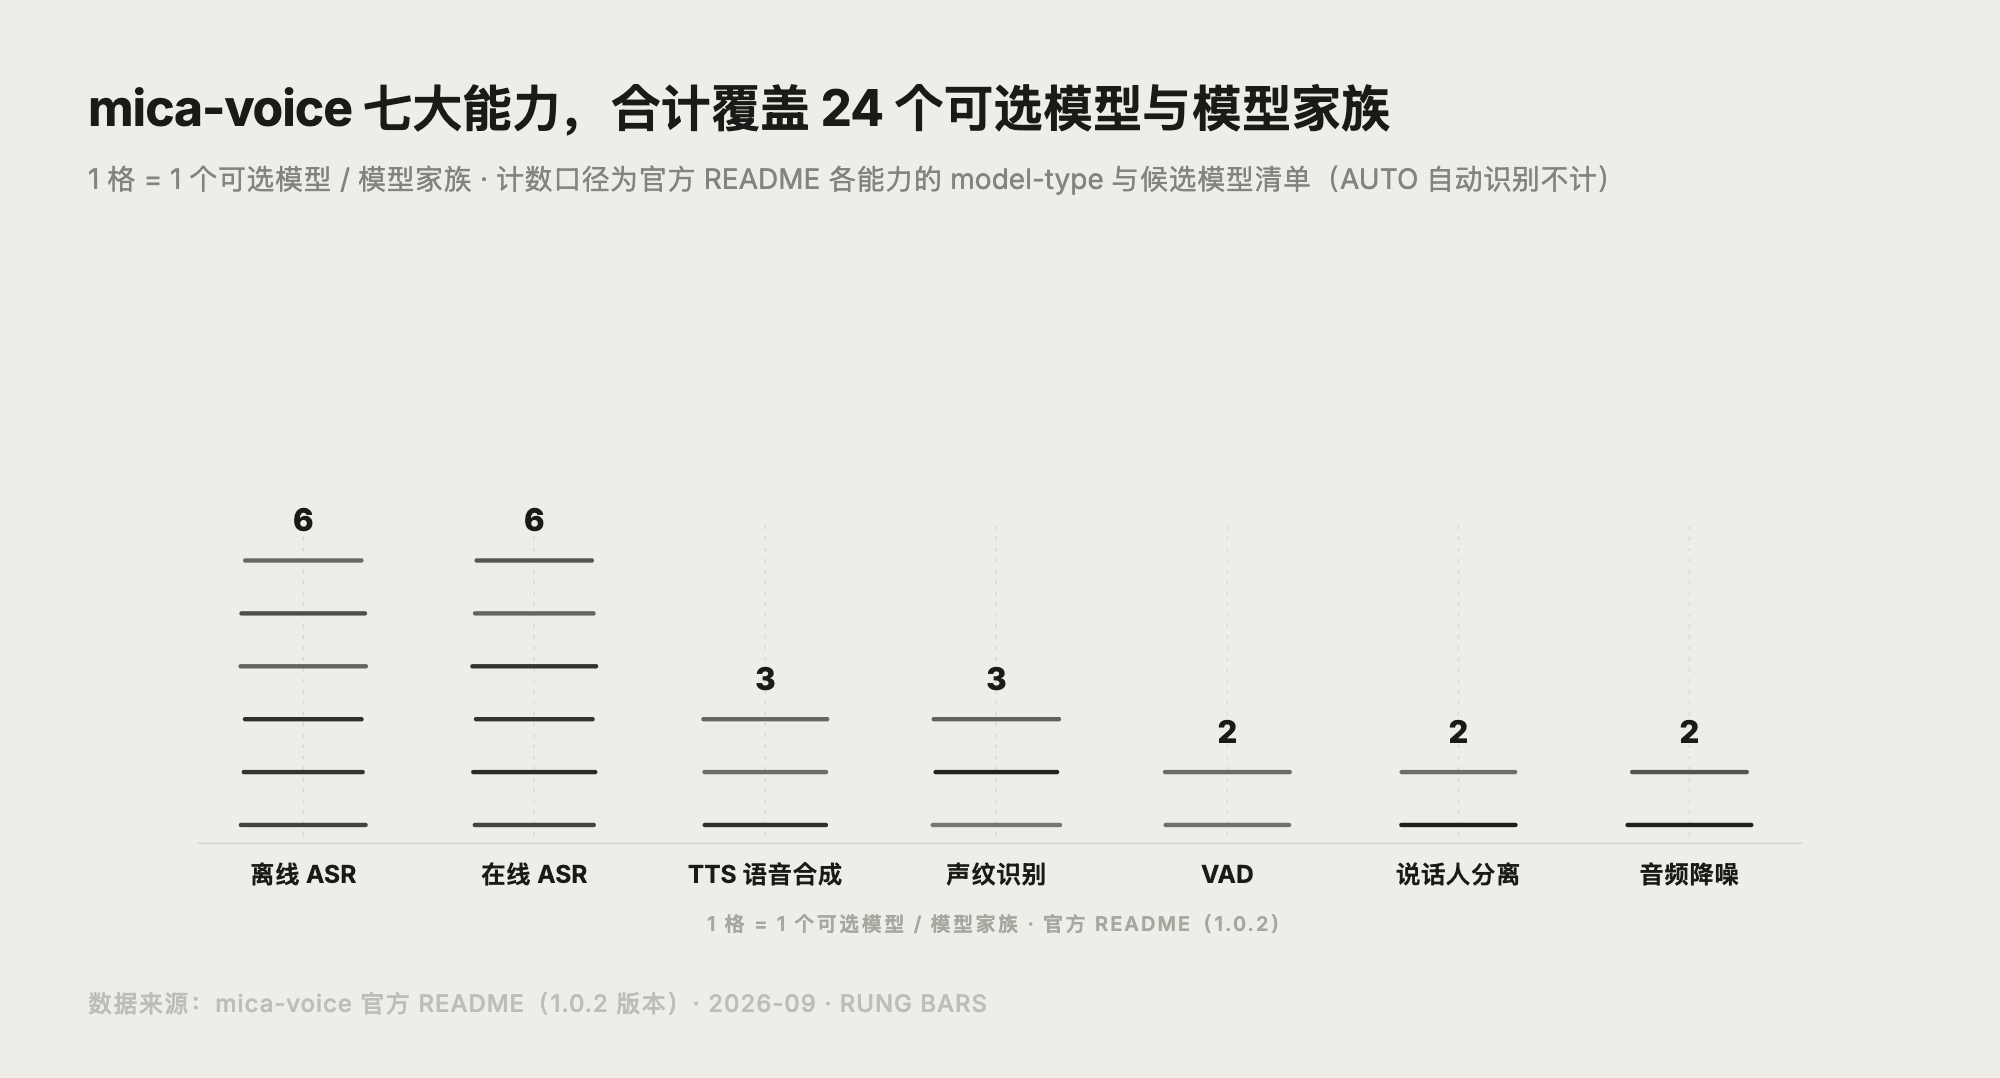
mica-voice 的入口是一个叫 MicaVoice 的门面类,所有能力都通过它「一行拿到服务」。能力清单和对应的配置类如下(离线 ASR 与在线流式 ASR 合计算一种能力,实际对应 8 个服务):
| 能力 | 门面方法 | 关键点 |
|---|---|---|
| 离线 ASR 语音识别 | MicaVoice.asr(props, config) |
支持 Paraformer / SenseVoice / Whisper / Moonshine / Zipformer / NeMo CTC 六个模型家族;SenseVoice 支持中英日韩粤与逆文本规范化 |
| 在线流式 ASR | MicaVoice.onlineAsr(...) |
支持 Streaming Paraformer 与 X-ASR(960ms 分块),可配置端点检测规则,句尾静音自动断句 |
| TTS 语音合成 | MicaVoice.tts(props, config) |
基于 VITS,另支持 Matcha / Kokoro;多说话人模型与中英混合模型(vits-melo-tts-zh_en) |
| 声纹识别 | MicaVoice.speaker(...) |
注册 / 验证 / 搜索,默认相似度阈值 0.5(cosine),可用于声纹登录 |
| VAD 语音活动检测 | MicaVoice.vad(...) |
静音切除、长音频自动切片;支持 Silero / TEN 两种模型 |
| 说话人分离 | MicaVoice.diarization(...) |
输出「谁在什么时间说了什么」,需 segmentation + embedding 两个模型 |
| 关键词唤醒 KWS | MicaVoice.kws(...) |
本地「小爱同学」式唤醒词检测 |
| (组合)分离 + 转写 | MicaVoice.transcribe(diarization, asr) |
把分离与识别串起来,直接产出带说话人标记的转写稿 |
| 音频降噪 | MicaVoice.denoise(...) |
支持 GTCRN(轻量流式)与 DPDFNet(高质量离线) |
几个工程细节值得单独提一下,这些是同类库不太会写进文档、但用起来很快会遇到的事:
- 所有服务都实现了
AutoCloseable。 native 推理会占用 JNI 句柄和内存,官方示例统一用 try-with-resources 写法,用完即释放。这点对长期运行的服务尤其重要。 - 能力级开关,按需装配。 Spring Boot starter 里每个能力都有独立的
enabled开关(VAD / 分离 / KWS / 降噪默认关闭),不用的能力就不装配、不占内存。 - ASR 的两个 Bean 按具体类型暴露。
OfflineAsrService与OnlineAsrService没有统一注册成AsrService接口类型,就是为了避免 Spring 容器出现「同接口多 Bean」时的注入歧义。如果你从旧文档抄@Autowired AsrService,会注入失败。 - 模型可以打进 Fat Jar。 模型路径支持
classpath:前缀,容器化部署时不必再挂外部目录。
mica-voice 怎么用?30 秒上手
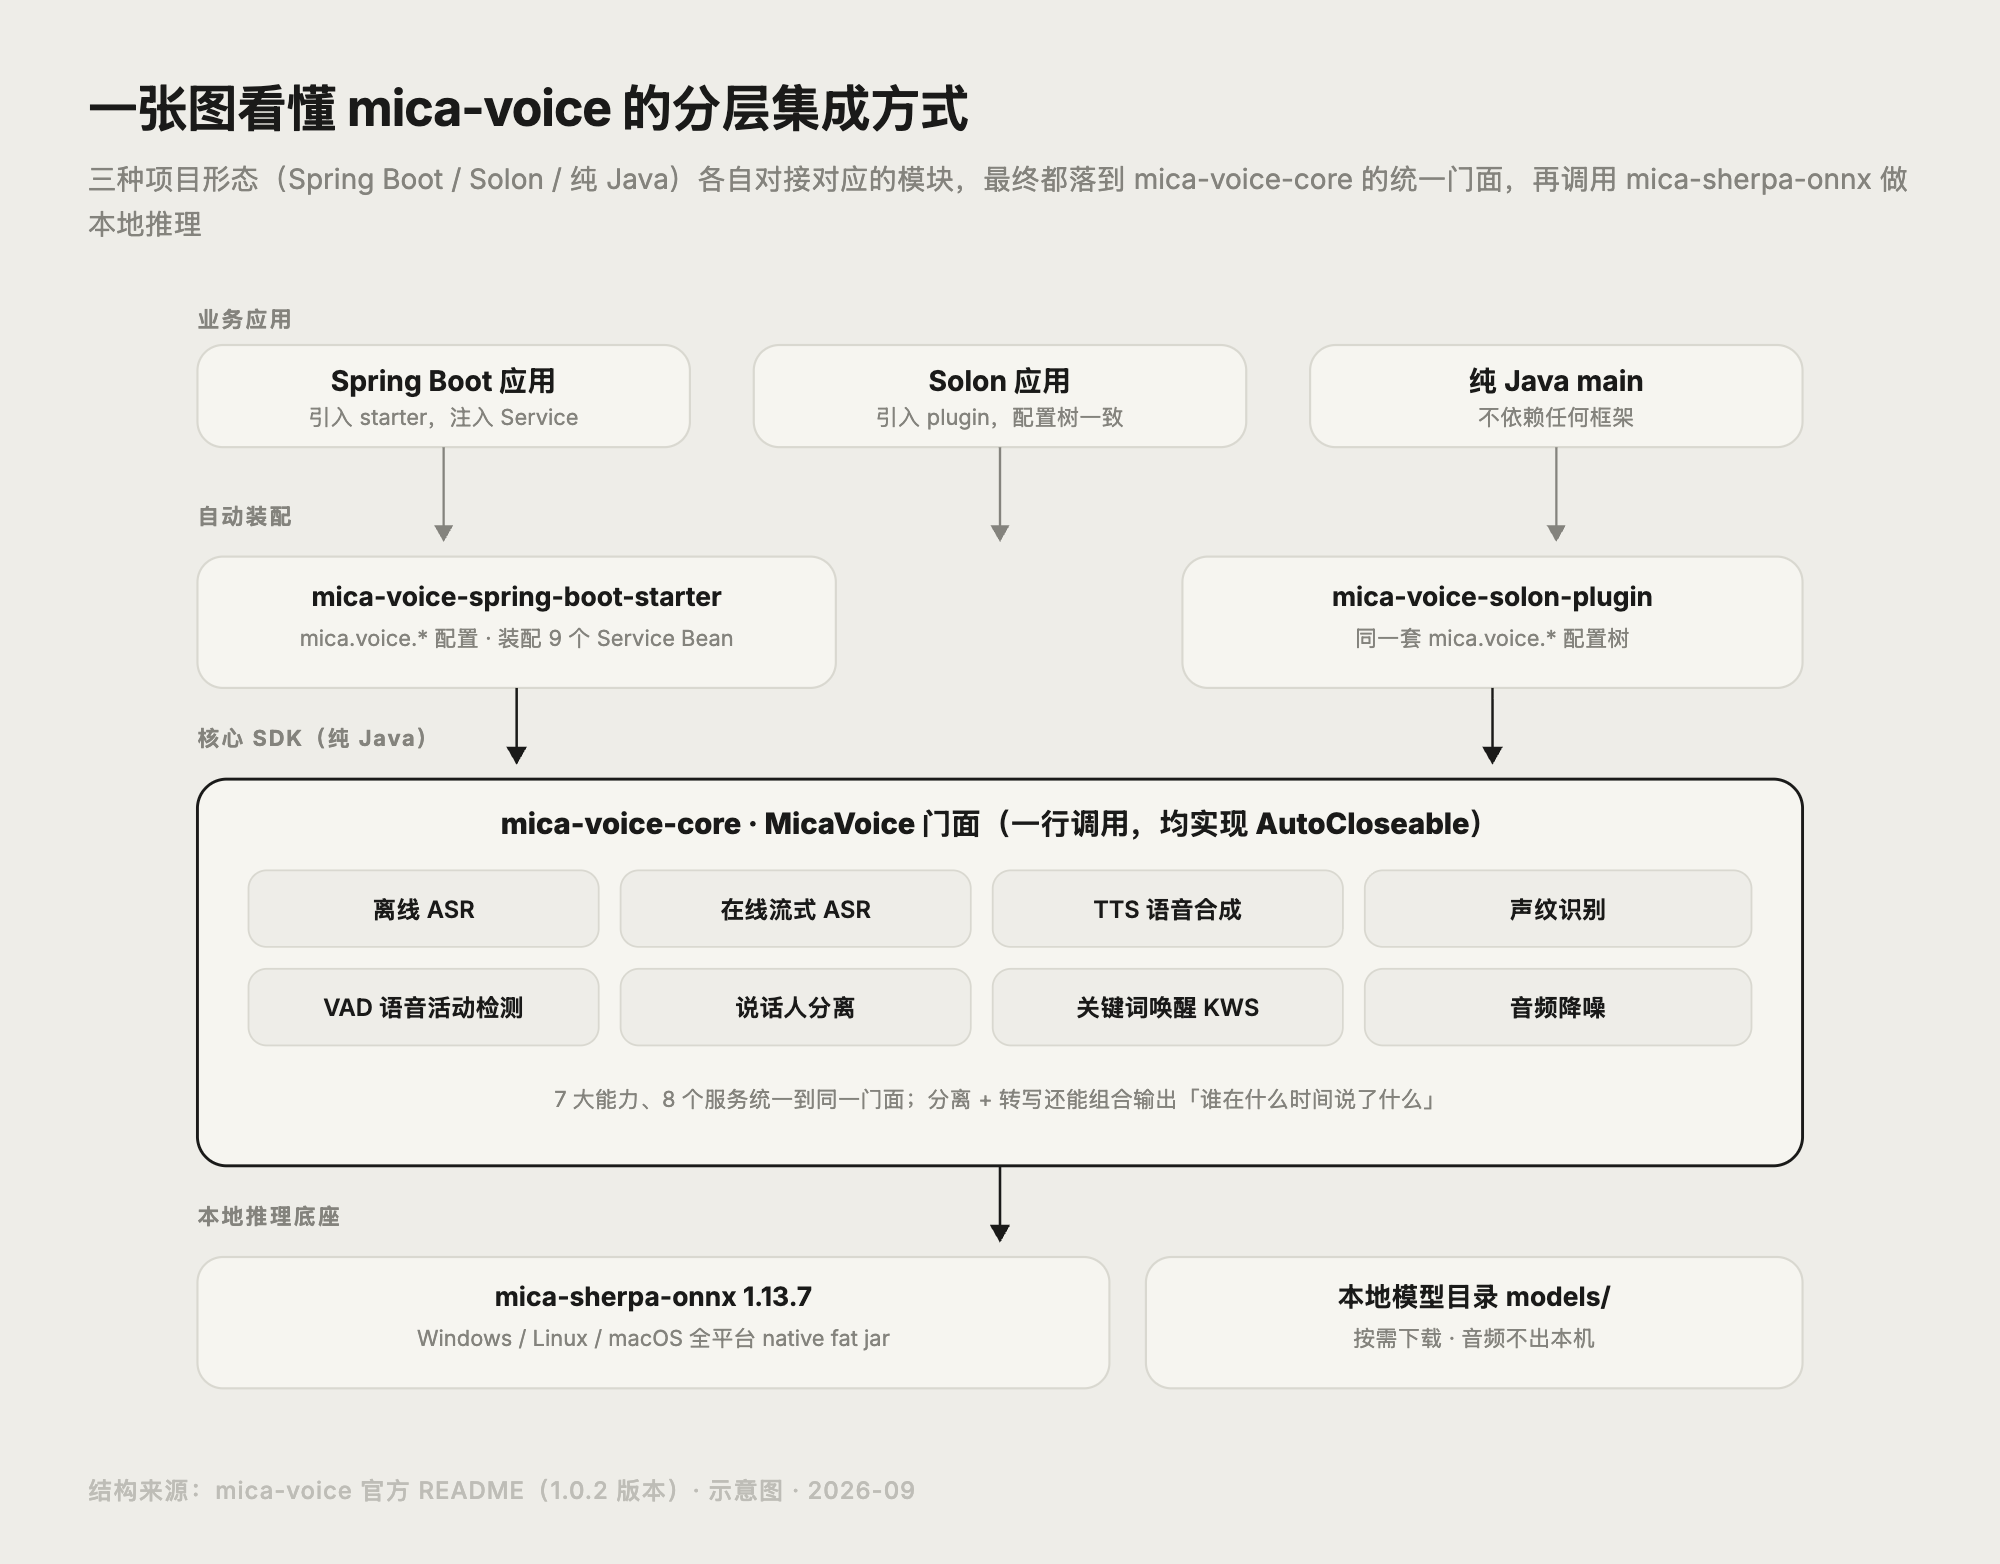
整个流程就三步:加依赖 → 下模型 → 一行调用。
第 1 步:添加 Maven 依赖
按项目形态三选一(版本号一致):
<!-- 纯 Java 项目:核心 SDK -->
<dependency>
    <groupId>net.dreamlu</groupId>
    <artifactId>mica-voice-core</artifactId>
    <version>1.0.2</version>
</dependency>

<!-- Spring Boot 项目:自动装配,开箱即用 -->
<dependency>
    <groupId>net.dreamlu</groupId>
    <artifactId>mica-voice-spring-boot-starter</artifactId>
    <version>1.0.2</version>
</dependency>

<!-- Solon 项目:同一套配置树 -->
<dependency>
    <groupId>net.dreamlu</groupId>
    <artifactId>mica-voice-solon-plugin</artifactId>
    <version>1.0.2</version>
</dependency>
第 2 步:纯 Java,门面一行调用
MicaVoiceConfig props = MicaVoiceConfig.builder()
    .modelsDir("models")   // 也可用 -Dmica.voice.models-dir 指定绝对路径
    .threads(2)
    .build();
AsrConfig config = AsrConfig.builder()
    .modelDirName("sherpa-onnx-paraformer-zh-small-2024-03-09")
    .modelType(AsrConfig.ModelType.PARAFORMER)
    .build();

try (AsrService svc = MicaVoice.asr(props, config)) {
    System.out.println(svc.recognize(new File("test.wav")).getText());
}
第 3 步:Spring Boot,配置即用
application.yml 里写配置,代码里直接注入:
mica:
  voice:
    models-dir: ./models
    asr:
      offline:
        model-dir-name: sherpa-onnx-paraformer-zh-small-2024-03-09
        model-type: PARAFORMER
@RestController
public class AsrController {
    private final OfflineAsrService offlineAsrService;

    public AsrController(OfflineAsrService offlineAsrService) {
        this.offlineAsrService = offlineAsrService;
    }

    @PostMapping("/asr")
    public String asr(@RequestParam("file") MultipartFile file) throws IOException {
        File tmp = File.createTempFile("asr", ".wav");
        file.transferTo(tmp);
        try {
            return offlineAsrService.recognize(tmp).getText();
        } finally {
            tmp.delete();
        }
    }
}
Solon 项目的写法和 Spring Boot 完全一致,只是注解换成 @Controller / @Inject,配置放在 app.yml。
如果你是第一次接触语音识别,可以先看我们整理的基础概念:ASR 语音识别是什么?语音转文字原理与准确率一次讲透;做语音合成方向的话,TTS 语音合成是什么 讲清了声学模型与声码器的分工。
模型怎么准备?下载脚本与目录约定
模型不随 jar 分发(体积大),需要按需下载到 models/ 目录。仓库自带下载脚本,覆盖三大平台:
# Linux / macOS
bash models/scripts/download-models.sh asr          # 按需换成 tts / speaker / asr-online / x-asr / all
bash models/scripts/parallel-download.sh all        # 并行下载,全量时更快

# Windows(任选其一)
models\scripts\download-models.bat asr              # CMD
powershell -ExecutionPolicy Bypass -File models\scripts\download-models.ps1 asr   # PowerShell
几个容易踩的点:
- 模型默认从当前工作目录的
models/加载。 打包运行(jar 与目录分离)时最容易出问题,用-Dmica.voice.models-dir=/绝对路径/models指定更稳妥。 - 下载脚本只覆盖 ASR / TTS / 声纹 / 在线 ASR 这几类 target。 VAD、说话人分离、KWS、降噪这四类模型脚本里暂时没有,需要自己从 sherpa-onnx 的 release 页面下载后放进
models/根目录。这也解释了为什么这几个能力默认是关闭的。 - 国内网络下载慢可以考虑网盘。 官方在 README 与发布稿里给了夸克网盘备份链接(提取码
kc5e)。 - 模型选型有 trade-off。 以中文离线 ASR 为例,
sherpa-onnx-paraformer-zh-small-2024-03-09是官方默认示例,偏「小而快」;要更准就换更大的模型或 SenseVoice 家族,代价是内存和首字延迟上升。
如果你同时在做本地大模型部署,硬件规划思路可以参考 本地部署大模型需要什么配置?一张表看显存门槛;语音模型的资源曲线和 LLM 不太一样,但「内存优先、算力其次」这一点是共通的。
mica-voice 适合谁用?5 个典型场景
- 需要「音频不出内网」的场景。 金融、政企、医疗这类对数据出境敏感的行业,把 ASR/TTS 放在自己进程里跑,比调云 API 好过合规。
- 录音转写与会议纪要。 说话人分离 + 转写组合服务,可以直接产出「谁在什么时间说了什么」,适合会议记录、访谈整理。
- 实时字幕与语音输入。 在线流式 ASR(WebSocket)适合浏览器麦克风 → 后端 → 实时上字幕这条链路,官方 spring-web 示例就是这么写的。
- 有声内容与播报。 TTS 生成通知播报、有声书朗读;中英混合场景用
vits-melo-tts-zh_en。 - 声纹登录与反欺诈。 声纹注册 / 验证 / 搜索,配合默认 0.5 的相似度阈值可以做身份二次校验。
反过来说,如果你要的是「开箱即上线、不能自己运维模型」,那这类本地推理方案不一定是最优选,往下看对比。
和云端语音 API、Python 方案怎么选
| 维度 | mica-voice(本地 Java) | 云端语音 API | Python 方案(FunASR / Whisper 等) |
|---|---|---|---|
| 一次接入成本 | 加 Maven 依赖 + 下模型 | 申请 Key、走 SDK,最快 | 需要额外部署 Python 服务与依赖 |
| 长期费用 | 无按量费用,成本固定在机器上 | 按调用量计费 | 无按量费用,但要有 Python 运行时 |
| 数据隐私 | 音频不出本机 | 音频上传第三方 | 可本地,取决于部署方式 |
| 离线可用 | 支持 | 必须联网 | 支持 |
| 模型选择广度 | 中等(受 sherpa-onnx 支持列表约束) | 少(用厂商的) | 最广(新模型跟进最快) |
| 与 Java 后端集成 | 原生,无跨语言调用 | SDK 调用,简单 | 需要进程/HTTP 桥接 |
| 适合谁 | 已有 Java 技术栈、在意隐私与长期成本的团队 | 追求快速上线、用量小的团队 | 算法团队、需要最新模型的研究场景 |
一句话结论:Java 技术栈 + 隐私/成本敏感 + 要长期跑 → 选 mica-voice;只想快速验证、量小 → 云 API 更省事;要追最新模型 → 还是 Python 生态最快。 想看更全的语音产品横向对比,可以看 智能语音产品怎么选?2026 八款主流工具横评,以及我们拆过的开源语音识别方案 VibeVoice ASR 是什么。
总结
mica-voice 1.0.2 本身是补丁级更新:修 JNI 兼容性、加流式 TTS 示例、把底层依赖升到 mica-sherpa-onnx 1.13.7。真正值得关注的是它代表的方向,把语音 AI 做成 Java 后端的一个普通依赖:Maven 引进来,mica.voice.* 配置一下,模型下到本地,然后就能在同一个 JVM 里做识别、合成、声纹、降噪,数据不出机、没有按量账单。对长期缺语音能力、又不想引入 Python 运行时的 Java 团队来说,这是目前少见的完整解法。
如果你准备试,建议的最短路径是:先只开离线 ASR(下 paraformer-zh-small 模型),跑通「上传 wav → 返回文字」这条链路,再按需逐个打开 TTS、声纹等能力。
参考资料
- mica-voice 官方仓库(GitHub)
- mica-voice 官方仓库(Gitee)
- mica-voice 在 Maven Central 的构件信息
- mica-sherpa-onnx(native 依赖来源)
- sherpa-onnx 上游项目(k2-fsa)
作者:AI345 编辑部|我们持续实测各类 AI 工具与开源项目,关注 AI 指南栏目 获取更多务实教程。
常见问题
mica-voice 1.0.2 是免费的吗?
答:是。项目采用 Apache License 2.0 开源,个人使用、商用、二次开发都免费,只需保留版权与许可声明。它本身没有按量计费,成本只体现在你运行模型所需的机器资源上。
mica-voice 支持哪些 Java 版本和框架?
答:核心 SDK 与两个自动装配模块都兼容 Java 8,官方标注兼容 JDK 8 / 17 / 21 / 25,Solon 插件注明支持 JDK 8 ~ 26。框架侧提供 Spring Boot starter 与 Solon 插件,两者用的是完全相同的 `mica.voice.*` 配置树;不依赖框架的纯 Java 项目可以直接用 `mica-voice-core` 的门面。
mica-voice 和 sherpa-onnx 是什么关系?
答:mica-voice 是封装层,sherpa-onnx 是它底下的推理引擎。具体来说,mica-voice 依赖作者维护的 `mica-sherpa-onnx`(把 sherpa-onnx 打成 Java 可用的全平台 native fat jar,1.0.2 对应 1.13.7),在其上提供统一门面、自动装配与模型生命周期管理。
mica-voice 需要联网吗?数据会上传吗?
答:推理过程完全本地,不需要联网,音频不会上传到任何第三方。唯一需要联网的环节是第一次下载模型文件;模型放本地 `models/` 目录后即可离线运行。
mica-voice 的模型要下多大?
答:取决于你启用哪些能力。模型不随 jar 分发,仓库的下载脚本支持按 target(asr / tts / speaker / asr-online / x-asr / all)单独下载,可以先只下离线 ASR 或 TTS 跑通再扩展。注意 VAD、说话人分离、KWS、降噪四类模型脚本暂不提供,需要自行从 sherpa-onnx 官方 release 获取。
mica-voice 现在能上生产吗?
答:可以评估,但要自己把握两个前提。一是版本仍处早期(首发到 1.0.2 只有约三周,1.0.3 正在开发中),API 仍有调整可能;二是 JNI/native 层的问题主要靠版本迭代修复,建议锁版本、做好压测与资源监控,并关注上游 sherpa-onnx 的稳定性。社区侧的数据量级可以先参考:截至 2026 年 9 月 20 日,Gitee 仓库约 55 Star / 22 Fork,GitHub 约 34 Star / 7 Fork。
 京ICP备2024094994号-29