
预训练是什么?大模型是怎么练出来的,3 分钟看懂全过程
预训练是大模型出厂前的第一道工序:让模型在近乎整个互联网的文本上,反复做“猜下一个词”的练习,把语言规律压进几千亿个参数里。你今天用到的每一个大模型,上线前都绕不开这一步。
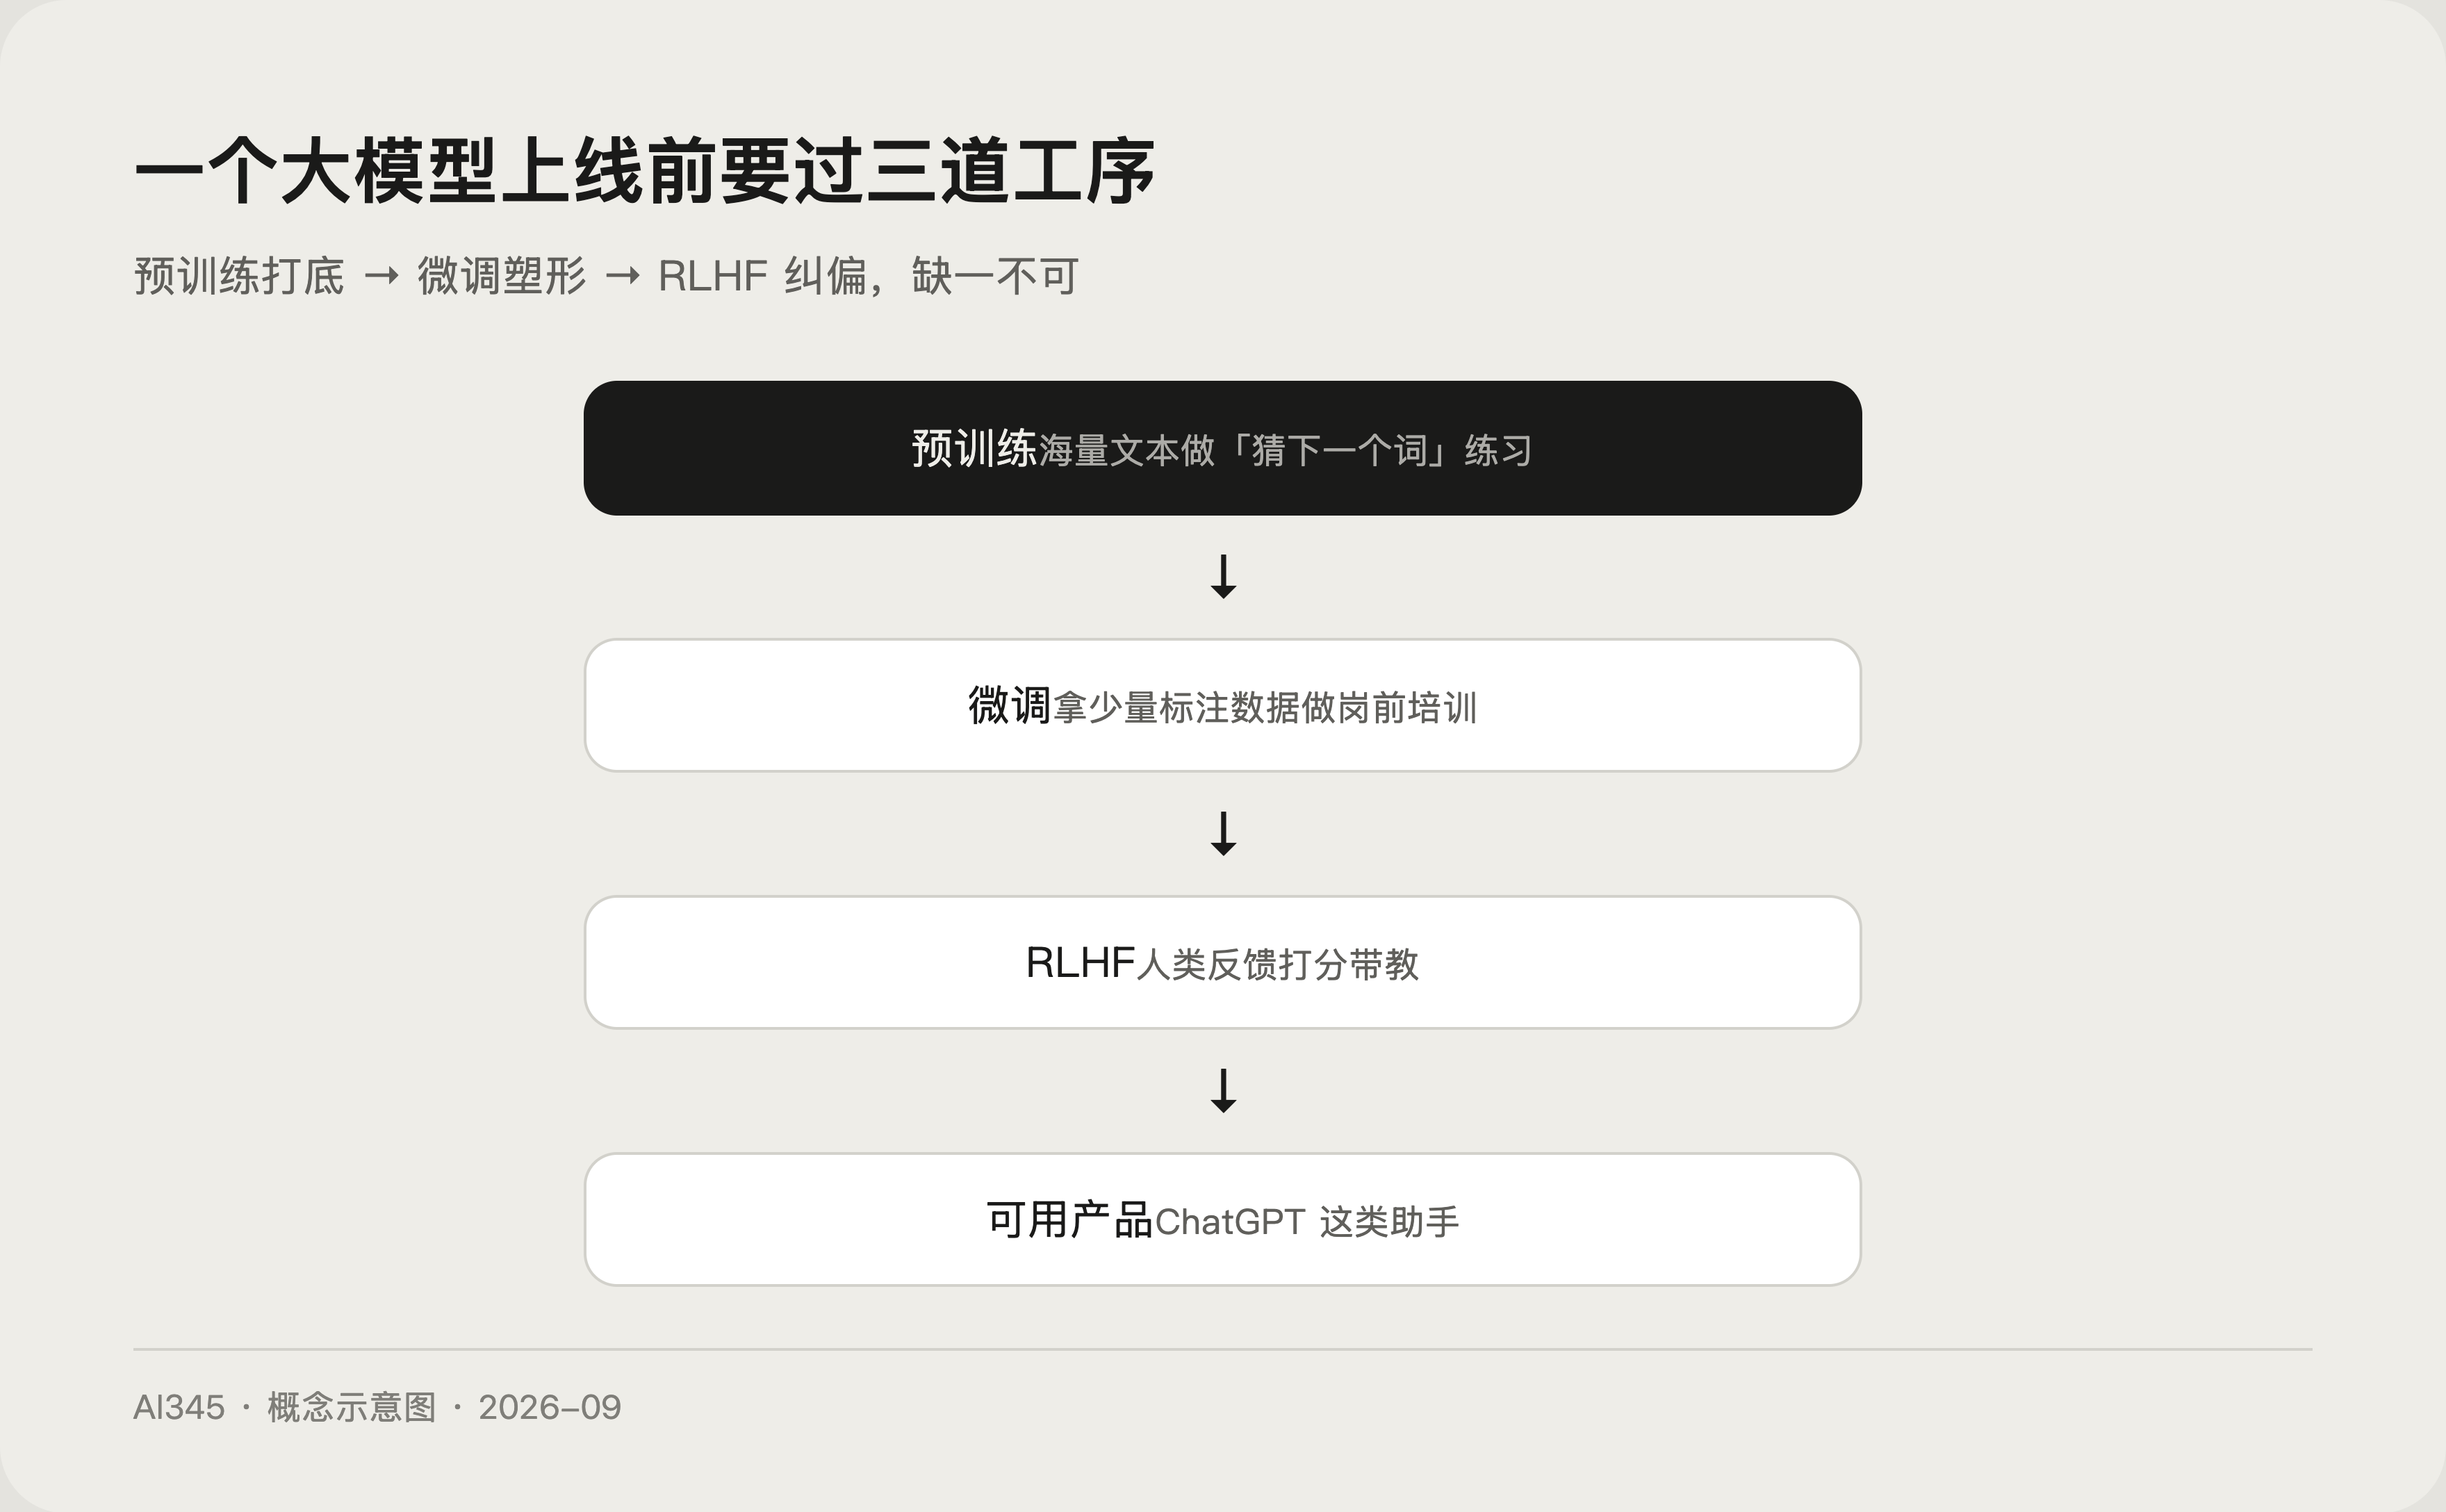
可以把它想成人的成长路径:预训练是“读万卷书”,微调是“岗前培训”,再后面的 RLHF 是“师傅带教”。三道工序走完,一个会聊天的 AI 才算出师。
预训练到底在练什么:猜下一个词
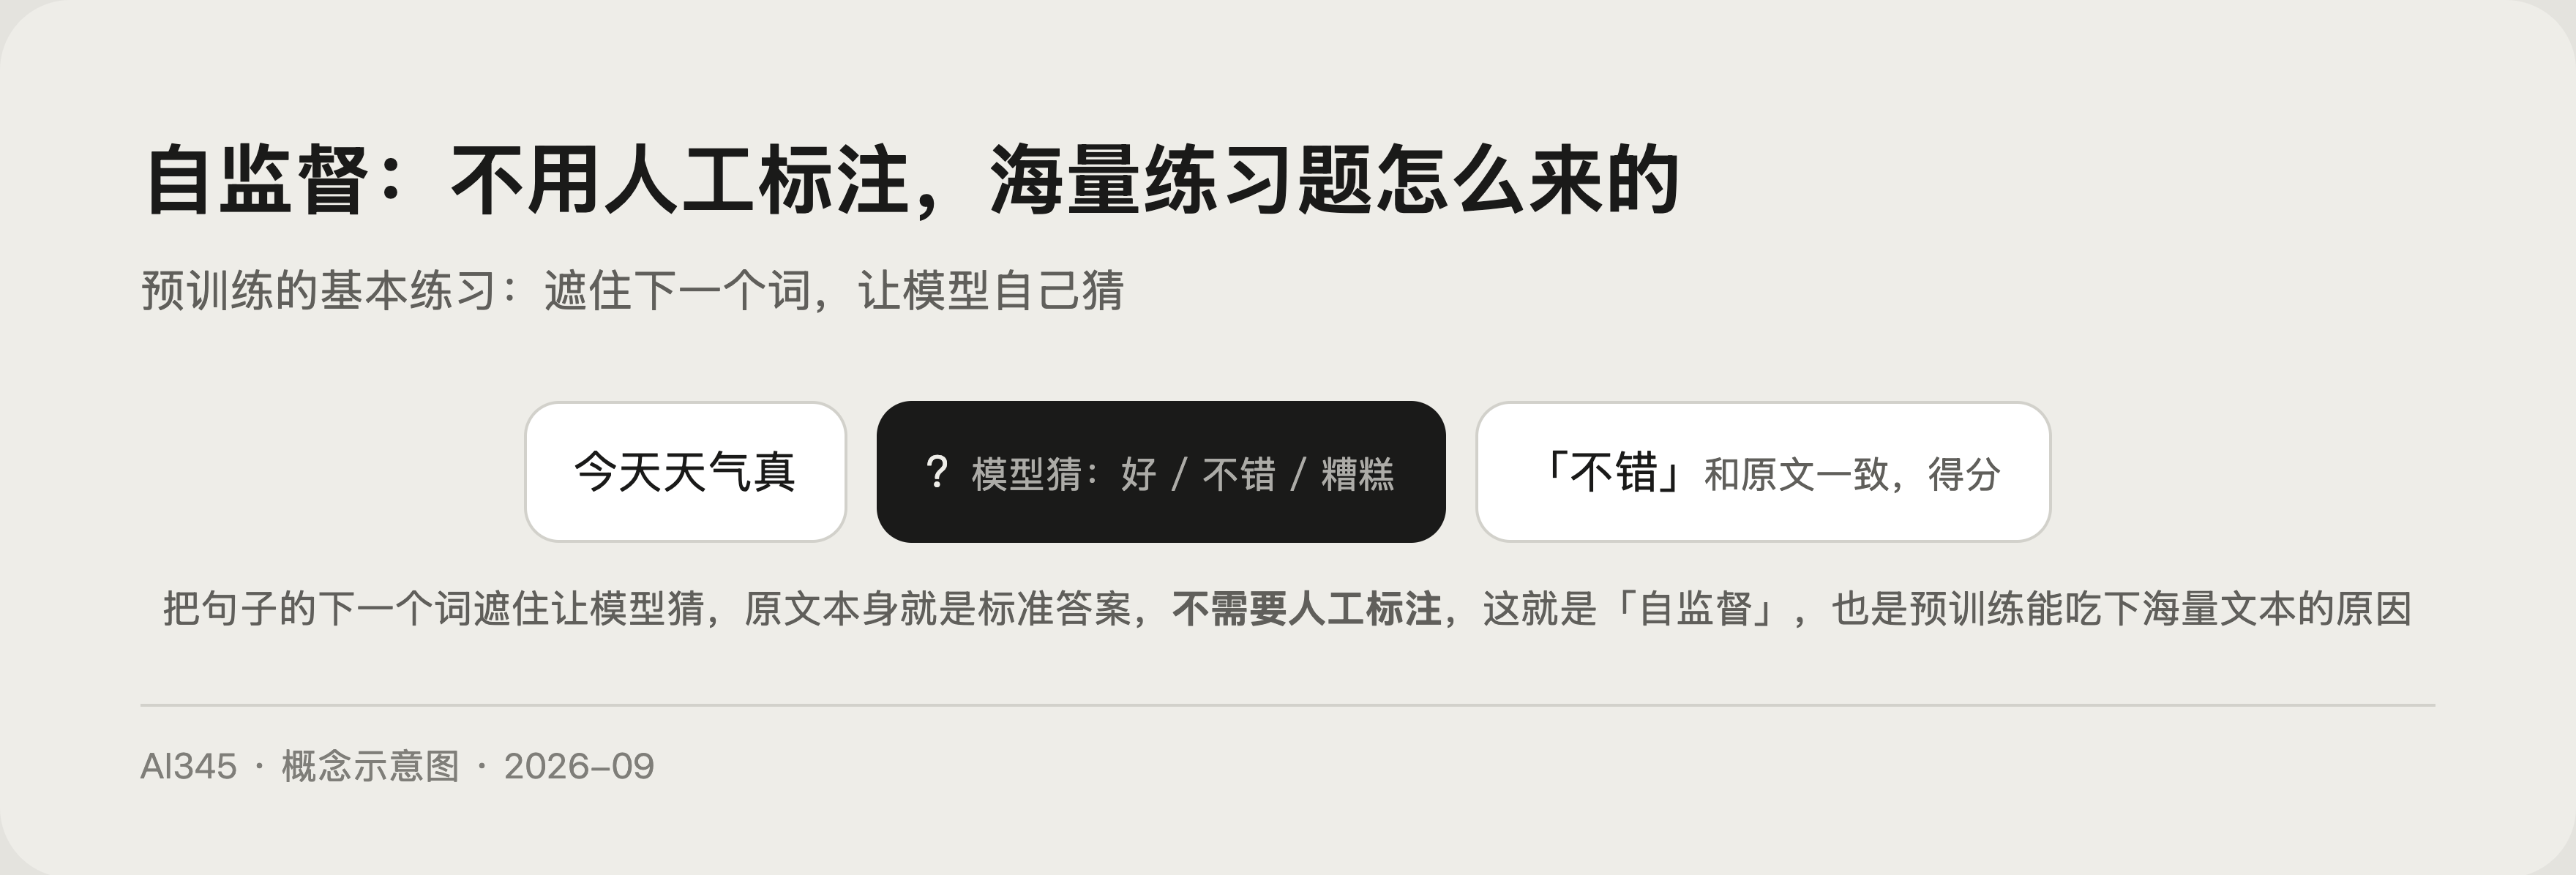
预训练的任务朴素得惊人:遮住句子里的下一个词,让模型猜。
比如给它看“今天天气真”,答案千千万,但“好”的概率明显高于“菠萝”。猜错了,模型内部几千亿个参数就微调一点。用海量文本反复做这个游戏,模型被迫学会语法、常识、事实甚至一部分推理,因为不掌握这些,就猜不准下一个词。
这个训练方式叫“自监督”:不需要人类一条条标注答案,正确答案(下一个词)天然就在文本里。这也是预训练能吃下海量数据的原因,互联网有多大,教材就有多大。
训练数据从哪来
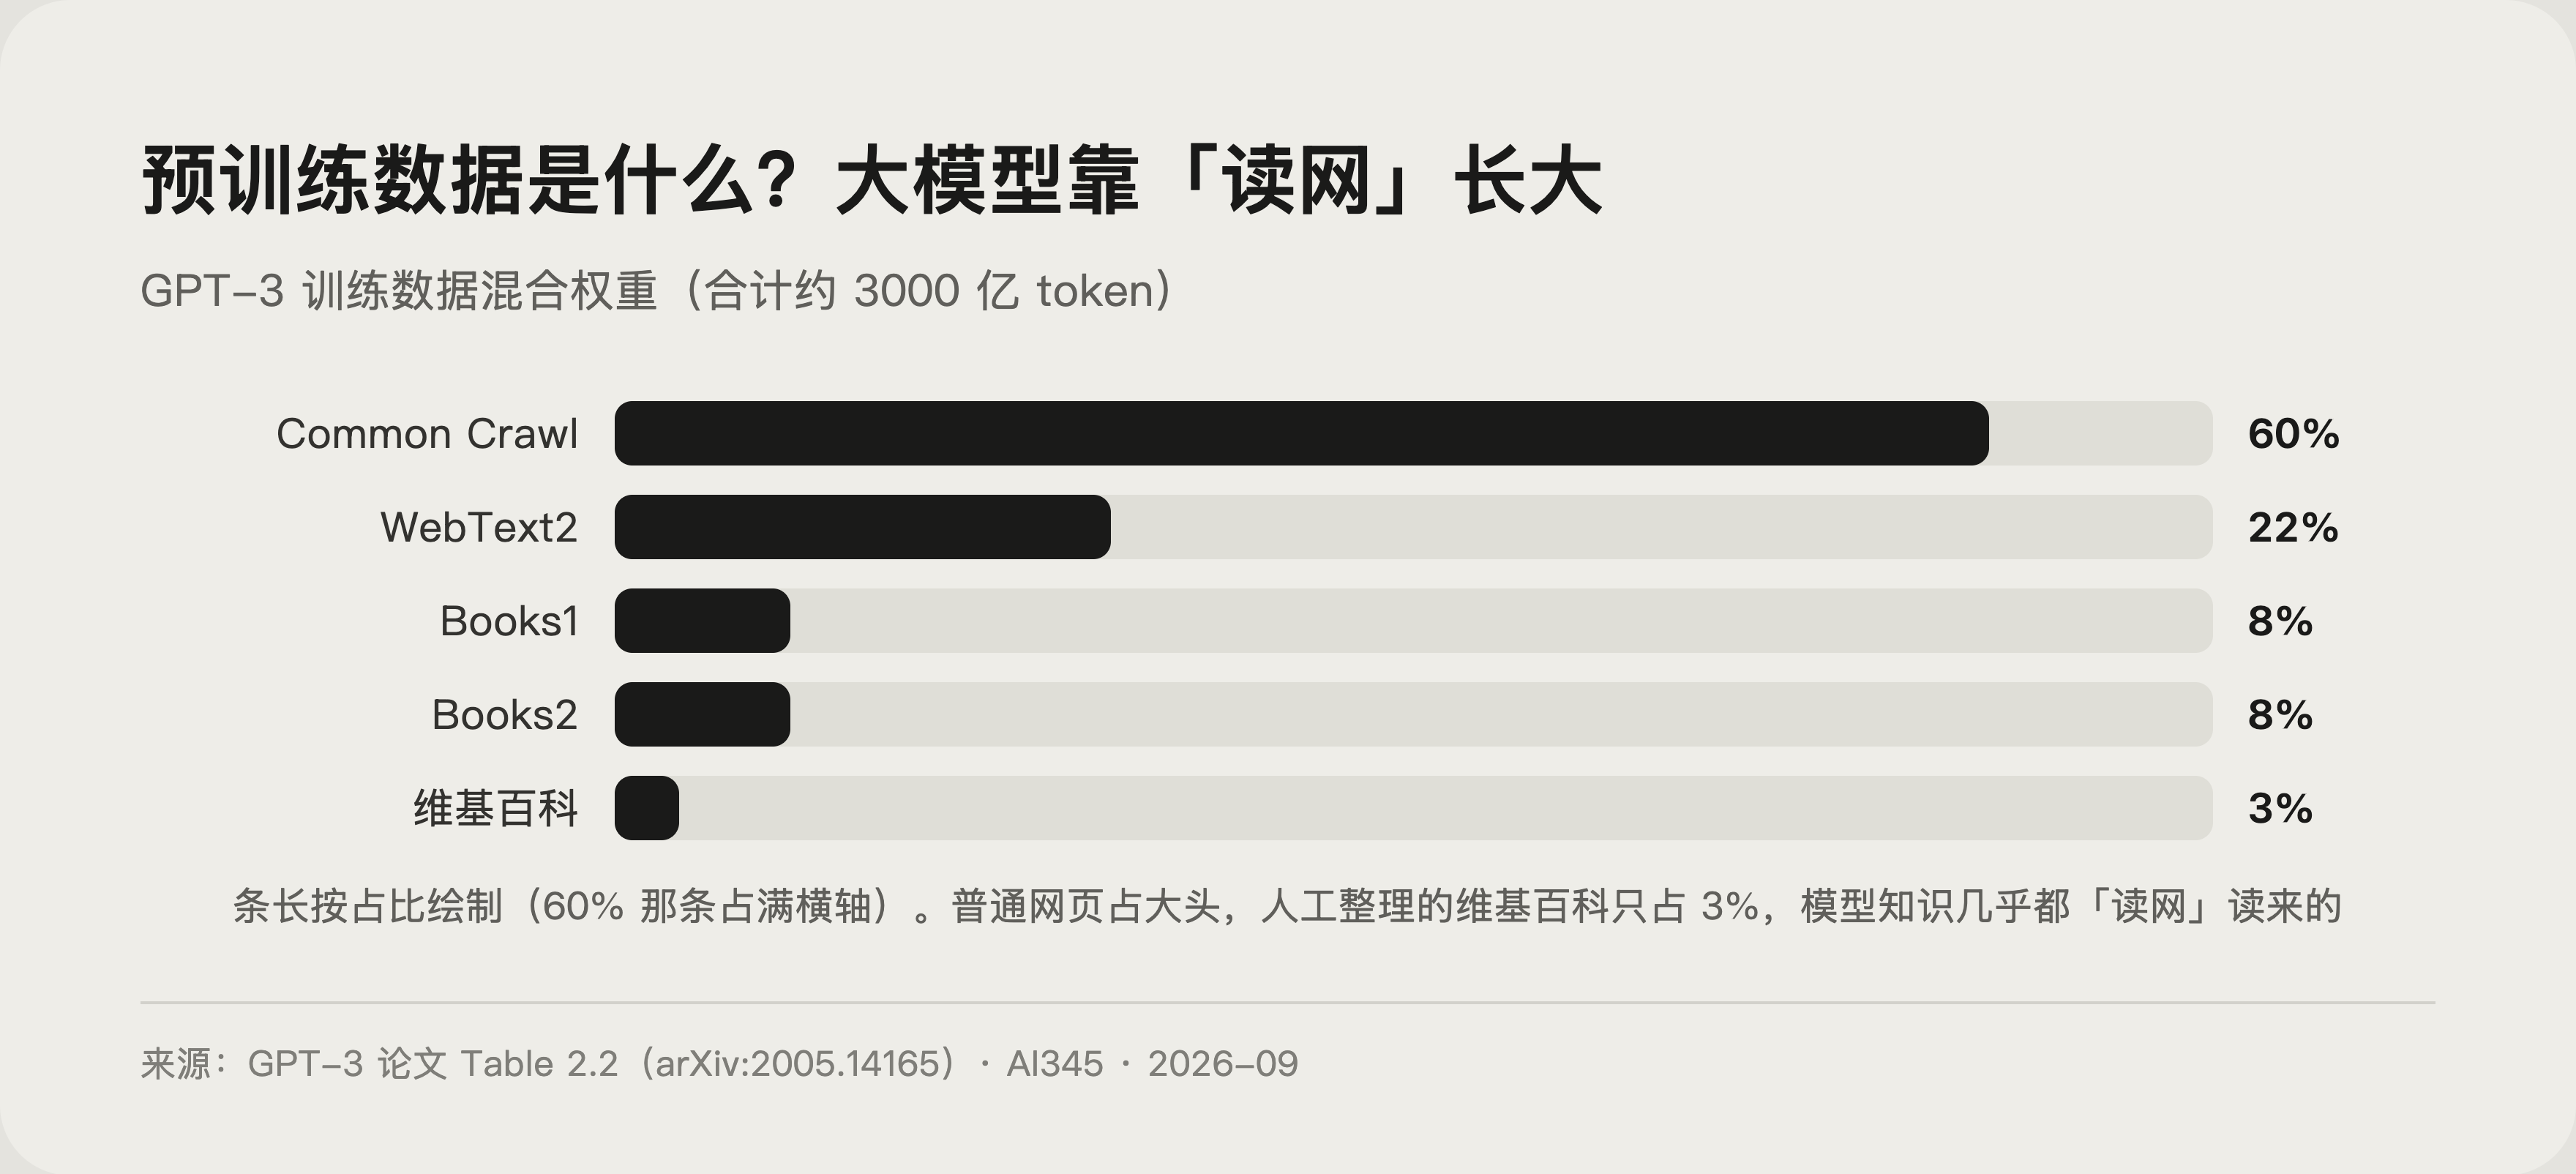
这是最常被追问的问题。以 GPT-3 论文公开的清单为例,训练语料包括过滤后的 Common Crawl 网页数据(约 4100 亿 token,训练混合中占 60%)、WebText2 网页精选、两批书籍数据,以及约 30 亿 token 的维基百科,合计训练 3000 亿 token。
有两个值得复述的细节:
- 网页数据不是全喂:Common Crawl 原始数据 45TB,层层过滤后只剩 570GB,数据清洗占了大量工作。
- 质量优先于数量:书籍和维基百科的训练权重远高于其体积占比,高质量数据会被反复多看几遍。
从预训练到上线:三道工序
刚预训练完的模型,像个博览群书但不懂规矩的人:它知道一万种接话方式,但不一定按你的意图来。所以还有两道工序:
- 微调:用少量人工标注的高质量对话,教它“别人提问时应该怎么答”,相当于岗前培训。
- 对齐训练(如 RLHF):让人类对模型的多个回答打分,模型根据分数继续改进,把讨人厌的回答淘汰掉,相当于师傅带教。
Hugging Face 官方课程对这条路径的表述是:模型先在大量原始文本上自监督地预训练,再通过迁移学习或微调去适配具体任务;GPT 正是 2018 年 6 月第一个走通这条路的预训练 Transformer 模型(见官方课程与 GPT-3 论文)。
为什么“预”字这么重要
“预训练”的“预”,意思是“在你用之前、在具体任务之前”,先把通用底子练好。这带来一个重要后果:预训练一次成本极高,但练好后可以被无数人复用。所以大厂开源模型对行业意义重大,等于把“读万卷书”的学费一次付清,后来者只需做便宜的微调。这条路线上的例子,我们写过openPangu 2.0 开源解读和GLM-6.0 最新消息。
零基础读者建议先看站内的AI 新手入门建立全局感,再回头看这篇,理解会更顺。
常见问题
预训练和微调的区别是什么?
答:预训练学通用语言能力,数据是海量文本,成本极高;微调学具体任务或说话风格,数据少量,成本低。前者管上限,后者管风格。
为什么大模型会一本正经地胡说?
答:预训练学的是“下一个词的统计规律”,不是真假判断。一句话只要统计上通顺,模型就敢输出,这就是幻觉的来源,属于训练机制的固有局限。
预训练一个模型要练多久?
答:以 GPT-3 为例,训练量是 3000 亿 token;今天的旗舰模型数据量更大,训练周期以周到月计,投入的 GPU 数量以千计。
微调是不是门槛很高,普通人做不了?
答:开源模型出现后门槛已经大幅降低,小参数模型一张消费级显卡就能微调,很多工具把流程做成了填空题,非工程师也能上手。
 京ICP备2024094994号-29