
Scaling Law 是什么?3 分钟看懂规模法则与局限
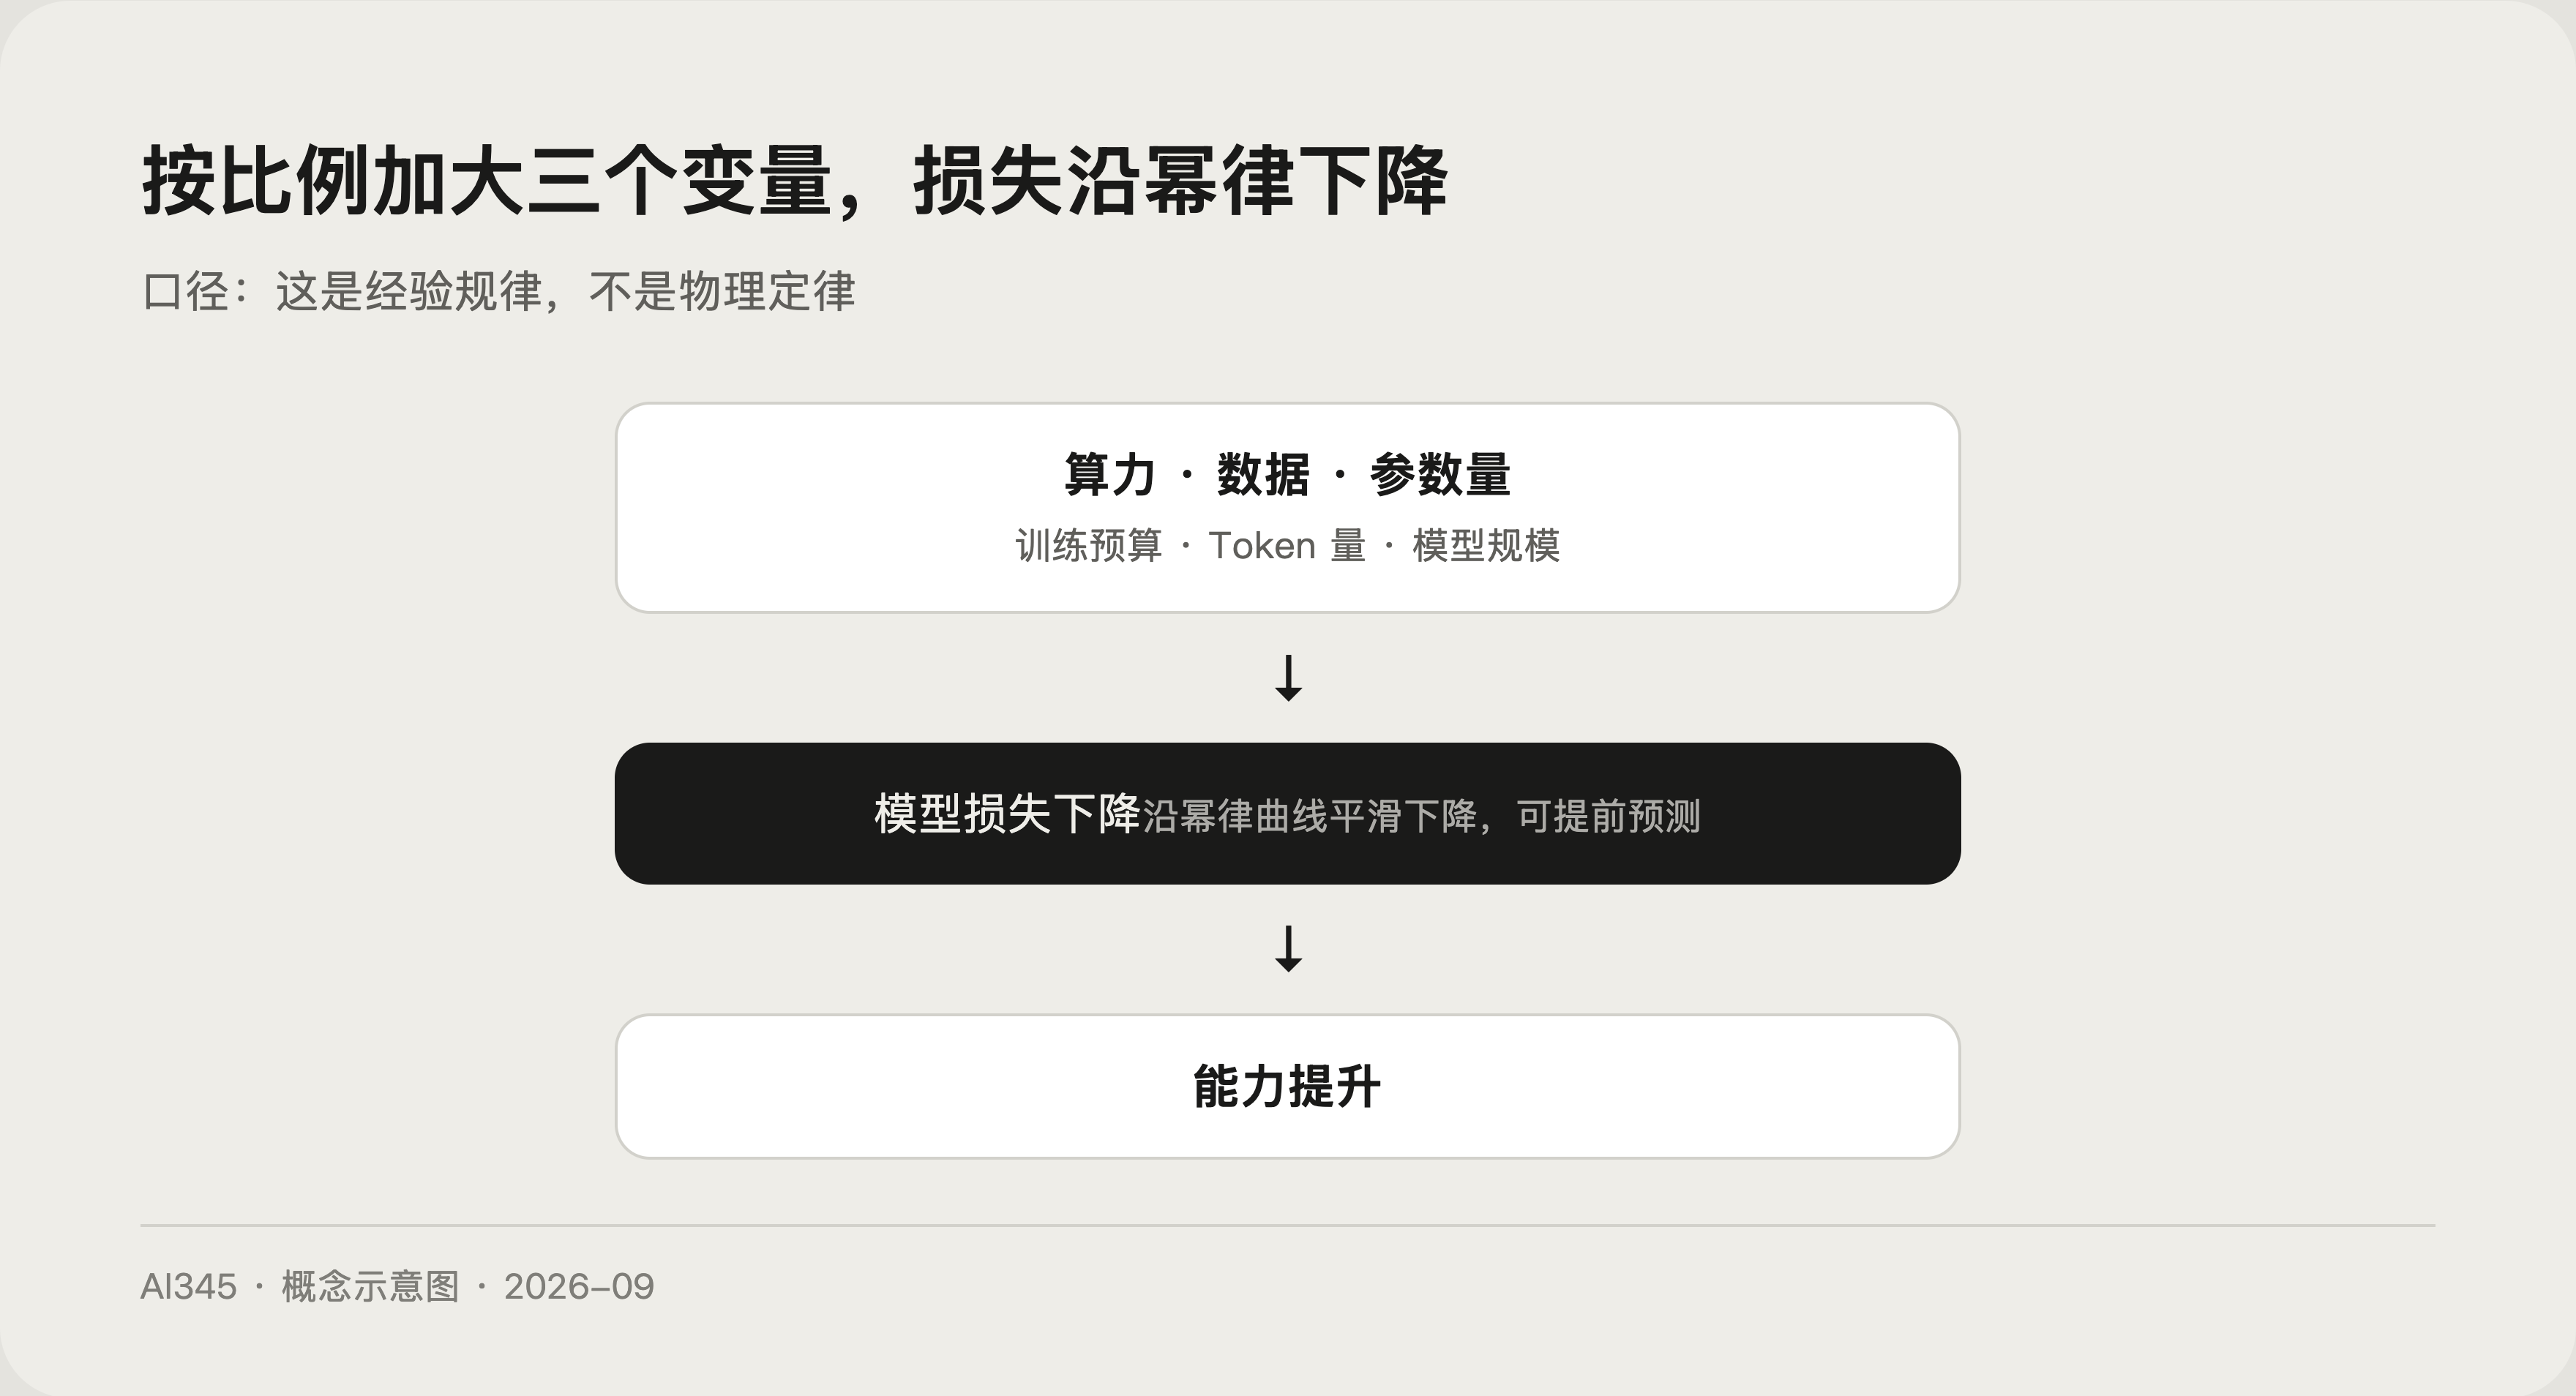
Scaling Law(规模法则)是大模型时代最重要的经验规律:按比例同时加大算力、数据和参数,模型损失就能沿一条可预测的曲线下降。但它不是永动机说明书,局限同样写在论文里,这篇把它讲透。
比喻主线:大模型练级是件可预测的事
把训练模型想象成打游戏升级:等级(能力)不靠玄学,靠经验值(数据)、装备(算力)和角色底子(参数)。Scaling Law 的贡献,是把「升一级要刷多少怪」写成了公式,动手前就能预算这笔算力花下去,损失大概能降到多少。
游戏里还有个残酷设定:等级越高,升一级所需的经验值越多,这正是幂律的直白翻译,收益永远赶不上投入的增长速度。
Kaplan 论文:损失下降服从幂律
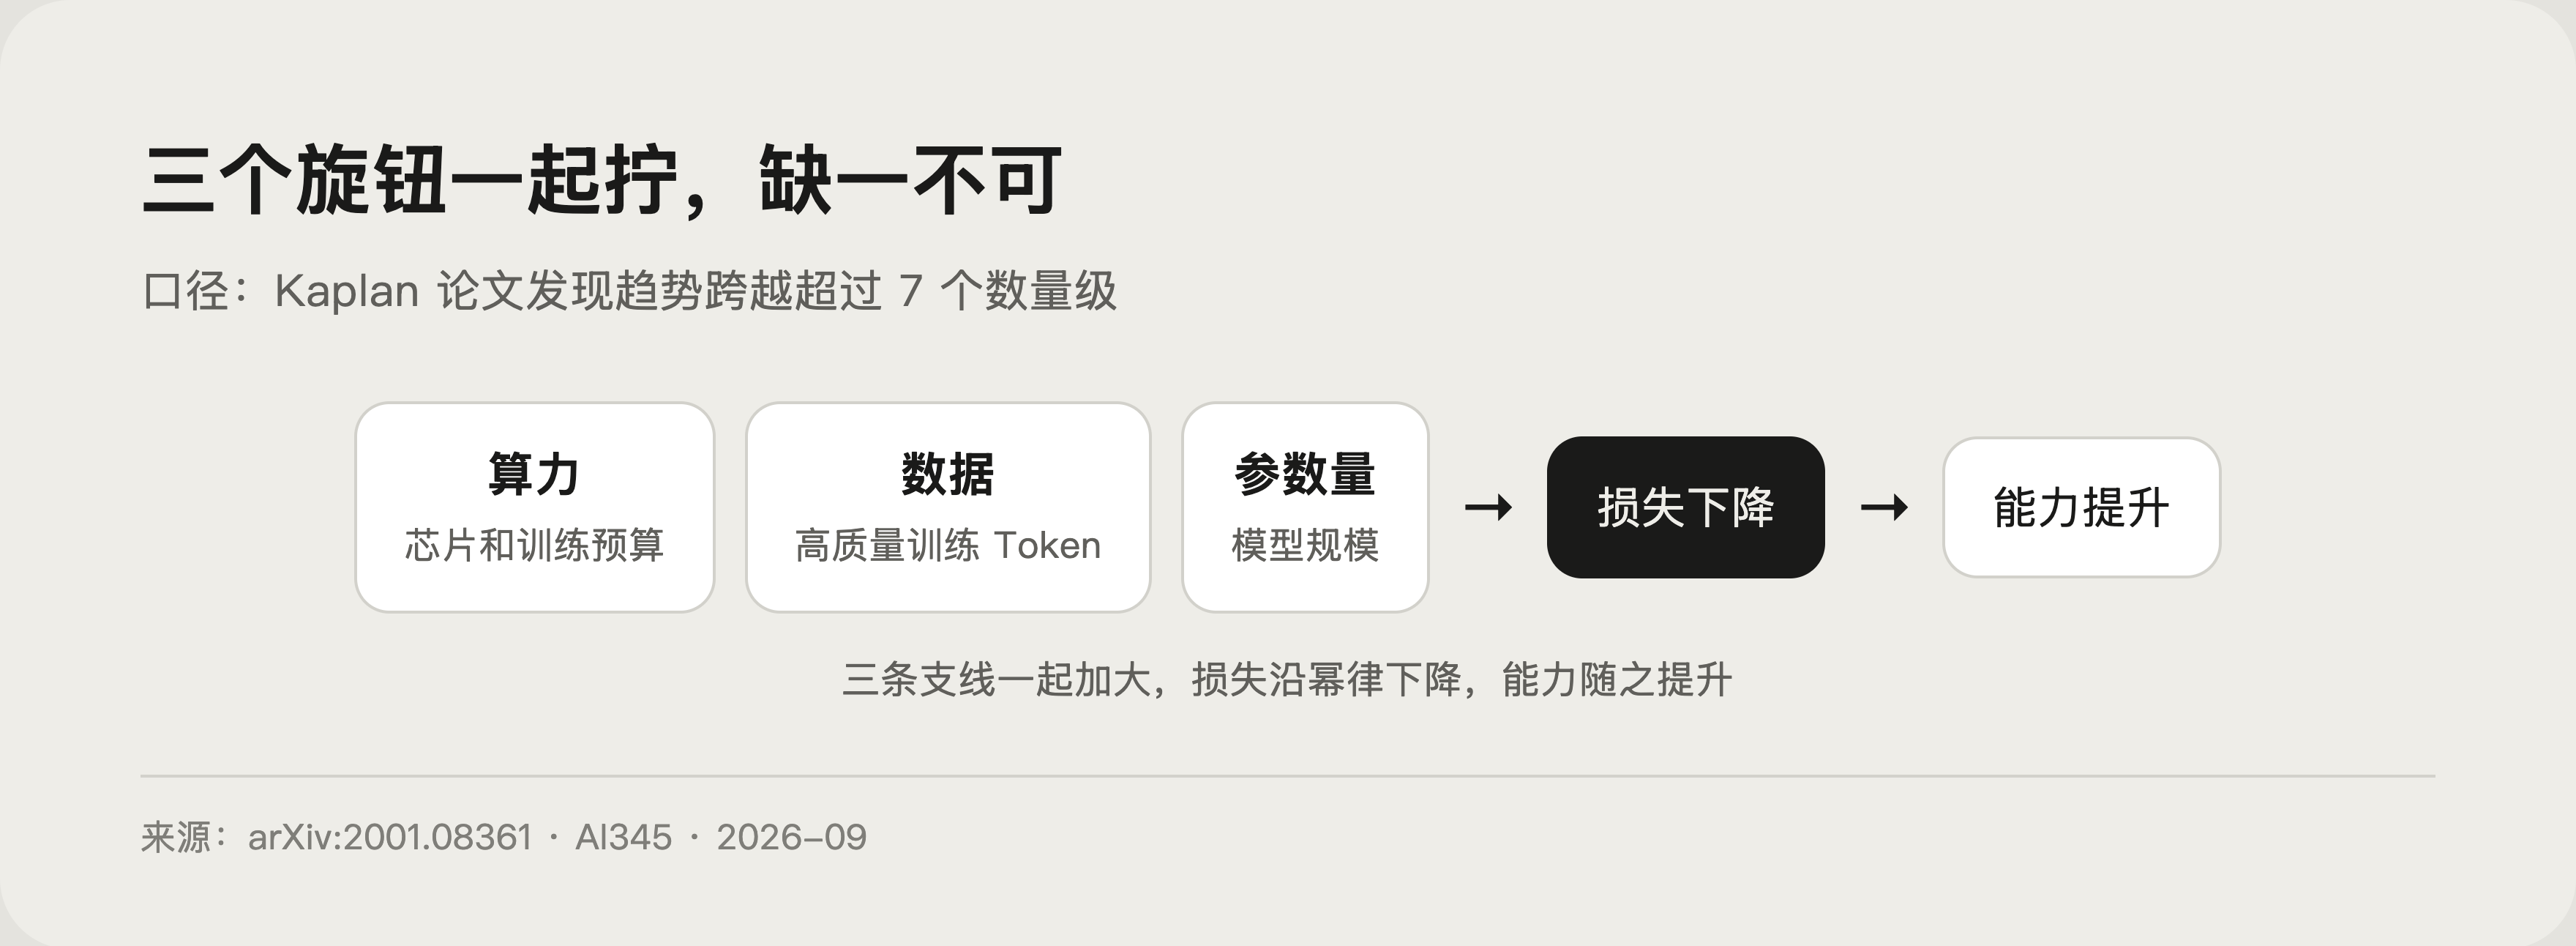
2020 年 1 月,OpenAI 的 Kaplan 等人发表 Scaling Laws for Neural Language Models,三条核心结论:
- 模型的交叉熵损失随参数量、数据量、训练算力按幂律平滑下降,部分趋势跨越超过 7 个数量级。
- 网络宽度、深度这些架构细节,在很大范围内对结果影响很小。
- 大模型更「省数据」:同样算力预算下,最优策略是训一个很大的模型、配相对适中的数据、在收敛前就停。
这份论文给之后几年的算力竞赛提供了理论弹药:只要继续堆,就能继续涨。
Chinchilla 修正:参数和数据要一起翻倍
2022 年 3 月,DeepMind 的 Hoffmann 等人发表 Training Compute-Optimal Large Language Models:他们训练了 400 多个模型(7000 万到 160 亿参数,50 亿到 5000 亿 Token),发现当时的模型普遍「训练不足」,固定算力下参数量和训练数据量应该同比例扩大,模型翻倍、数据也翻倍。
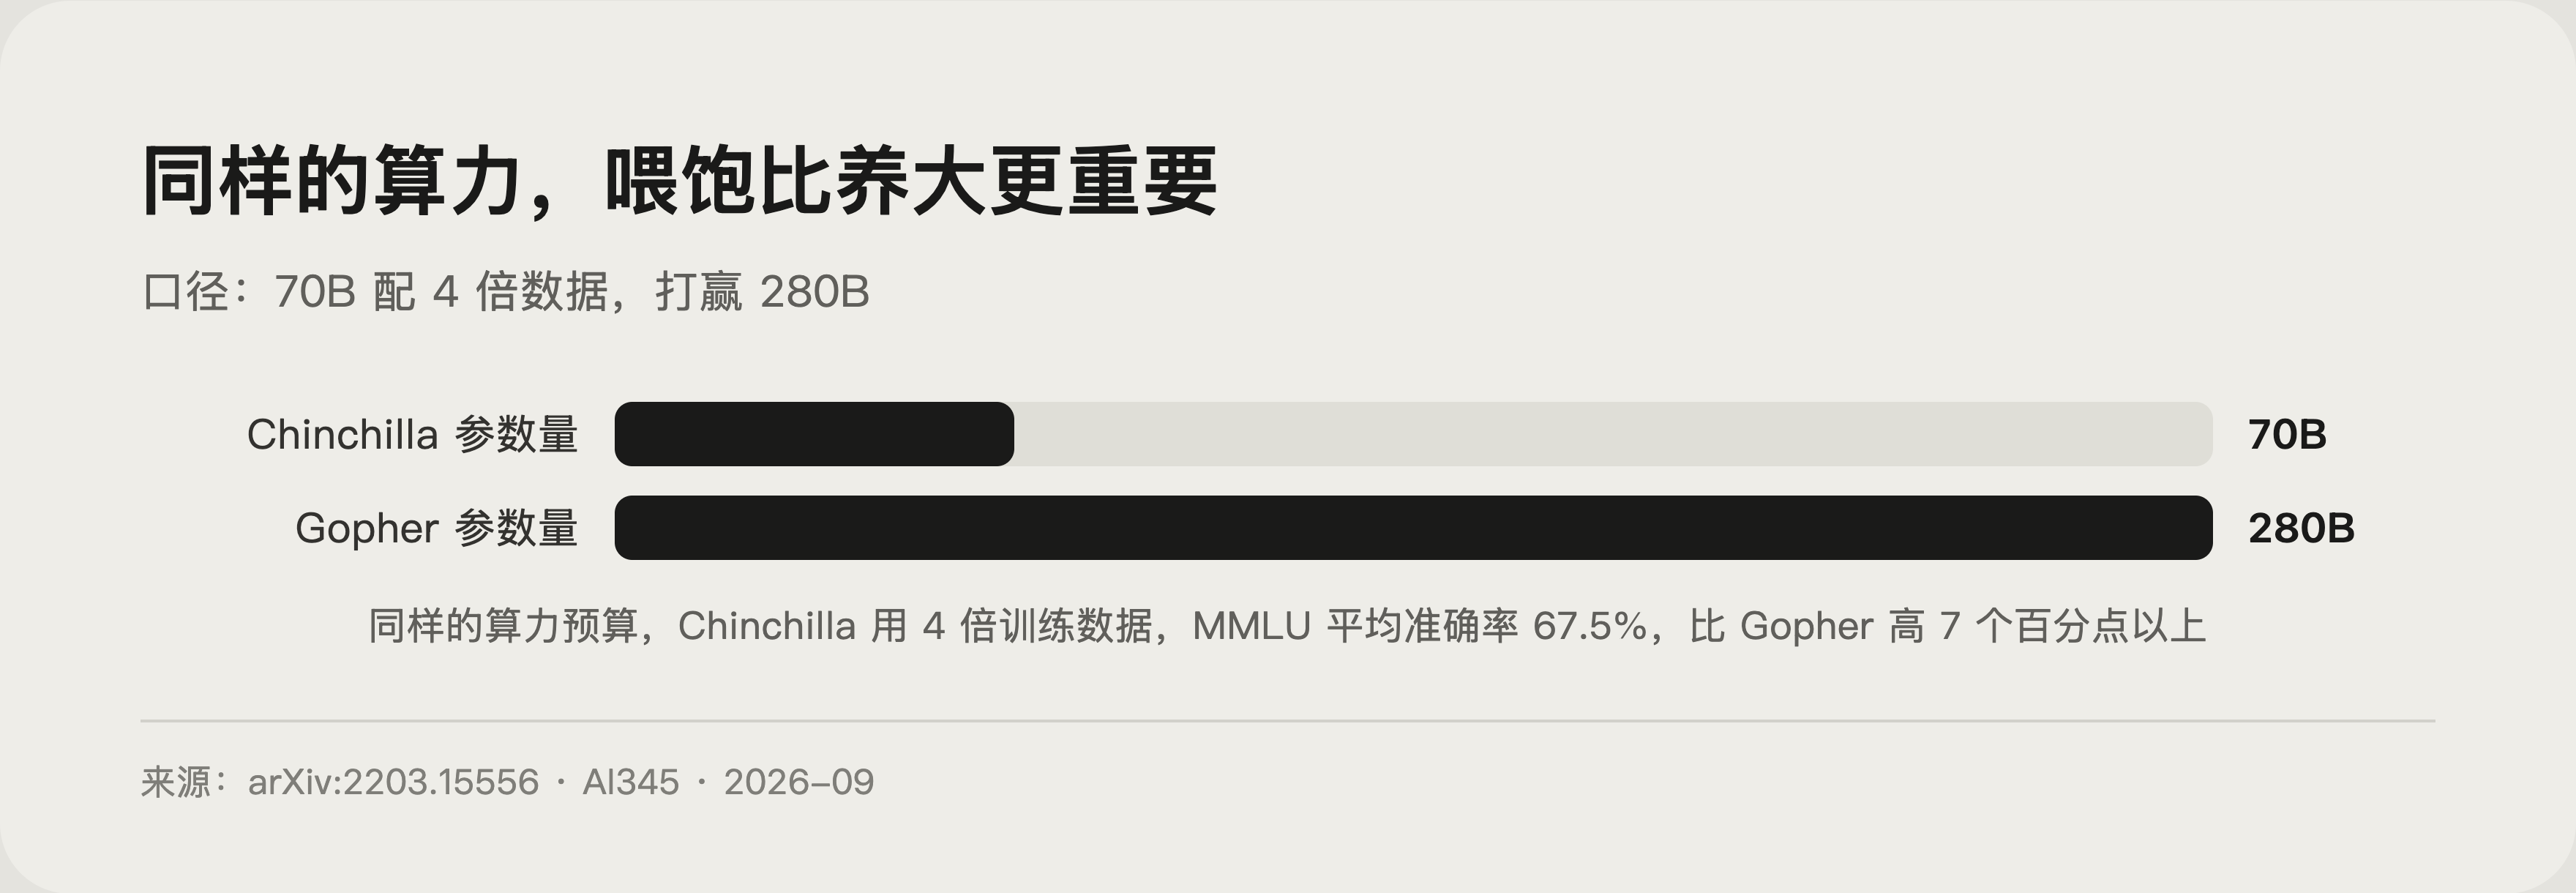
他们按新配方训练了 Chinchilla:和 280B 的 Gopher 用同样的算力预算,但参数只有 70B、数据量是其 4 倍。结果 Chinchilla 在大范围任务上全面超过 Gopher(280B)、GPT-3(175B)等更大的模型,MMLU 平均准确率 67.5%,比 Gopher 高出 7 个百分点以上。这套配比后来被称作 Chinchilla 最优,成了之后几年各家训练新模型的重要参考。
一句话记住这次修正:同样的算力,喂饱比养大更重要。
规模法则的局限:钱和数据都不是无限的
- 幂律意味着边际收益递减:性能每提高一点,成本要翻好几倍,账迟早算不下去,这条曲线也是各家持续抢算力、抢芯片的根本原因。
- 高质量数据有上限:互联网文本并非取之不尽,预训练数据耗尽时,光堆参数没用,合成数据和代码数据因此成了新的争夺方向。
- 规模改善的是平均损失,不保证新能力出现:推理、数学这类能力能否靠堆规模获得,学界至今有争论,推理模型走的是用强化学习和更多思考时间换能力的另一条路。
- Chinchilla 最优是训练视角不是部署视角:推理时小模型更便宜,所以实际产品常故意训「数据超配」的小模型。
怎么用 Scaling Law 指导日常判断
不做训练的人为什么也要懂它?三个用法:
- 看懂发布会的数字:新模型宣称「同参数更强」,多半是数据、配方或后训练的进步,而不是推翻了规模法则。
- 判断开源模型怎么选:预算(显存)固定时,与其追最大的参数,不如看训练数据配比是否充足,Chinchilla 的教训今天仍适用。
- 理解价格战:推理成本主要跟着激活参数和算力走,MoE 和小模型的流行,本质都是在规模法则约束下找性价比最优解。
一段话讲清 Scaling Law
「Scaling Law 指模型损失随参数、数据、算力按幂律下降,由 OpenAI 的 Kaplan 论文在 2020 年确立。2022 年 DeepMind 的 Chinchilla 论文修正了配方:固定算力下参数和数据应同比例扩展,70B 的 Chinchilla 靠 4 倍数据打赢了 280B 的 Gopher。它的局限是边际收益递减、高质量数据有限,且描述的是平均性能,不保证堆规模必然涌现新能力。」
高频追问是「现在还遵守 Scaling Law 吗」。可以答:遵守,但预算在分流,预训练继续扩规模的同时,更多资源转向推理时计算和强化学习,规模法则从唯一剧本变成了剧本之一。这条变化和模型参数量的关系,可以延伸看我们讲大语言模型是怎么工作的那篇。
常见问题
Scaling Law 是物理定律吗?
答:不是,它是经验规律。在特定模型家族和数据分布内拟合得很好,换架构、换数据类型未必成立。
参数越多模型一定越强吗?
答:不一定。参数只是三个变量之一,数据和算力必须跟上,Chinchilla 用 70B 配足数据就赢了 280B。
Chinchilla 最优是什么意思?
答:指固定算力预算下,参数量和训练 Token 量等比扩大时的最优配比,能让最终损失最低。
现在大模型训练还在遵守 Scaling Law 吗?
答:遵守但玩法变了。预训练继续扩规模,同时更多预算转向推理时计算和强化学习。
Scaling Law 对普通开发者有什么用?
答:帮你做预算决策:给定算力,能估出该训多大模型、喂多少数据,避免把钱全砸在参数上。另外它也能帮你判断宣传口径:参数翻倍不等于效果翻倍。
 京ICP备2024094994号-29