
中国电信开源 Xing4.0-29B-A4B:24G 显卡本地部署与踩坑
2026 年 9 月 17 日,中国电信旗下 TeleAI 开源了新一代星辰大模型 Xing4.0-29B-A4B(官方公告)。它总参数量 29B,但每个 token 只激活 4B,官方介绍的做法是 4-bit 量化后在 24GB 消费级显卡上就能跑。
这篇文章不复述发布公告,只解决本地部署真正会遇到的四个问题:要多少显存、选哪条部署路线、现在有哪些坑、值不值得为它腾一块卡。 如果你还不清楚它是什么,可以先看站内的 Xing4.0 是什么。
部署前先记住三个数字:29B、4B、256K
Xing4.0-29B-A4B 是纯 MoE 架构,判断它的部署成本只需要看三个数:
- 29B 总参数:决定权重文件多大,也就是要准备多少存储和显存。
- 4B 激活参数:每生成一个 token 只走 64 个路由专家里的 4 个,推理速度接近 4B 小模型,而不是 29B 稠密模型。
- 256K 上下文(可扩展至 512K):决定 KV 缓存吃多少显存,这才是长上下文任务真正吃显存的地方。
如果对 MoE 还不熟,可以看 MoE 是什么,一句话概括就是参数总量决定占用,激活量决定速度。
显存门槛:三档权重文件的真实体积
官方介绍的口径是 4-bit 量化后显存占用降到约 15GB,24GB 消费级显卡就能本地跑长上下文任务。但判断硬件更可靠的依据是 Hugging Face 上实际发布的文件体积,我按仓库文件清单把三档权重逐个加了一遍:
| 版本 | 权重总体积 | 实用判断 |
|---|---|---|
| BF16 原始权重 | 约 62.4 GB(41 个分片) | 单卡 80GB 才舒服,或双卡张量并行 |
| FP8 版本 | 约 33.2 GB | 40GB 单卡可以跑,24GB 卡装不下 |
| INT4 GGUF(IQ4_NL) | 约 20.1 GB | 24GB 卡能装下权重,上下文要裁剪 |
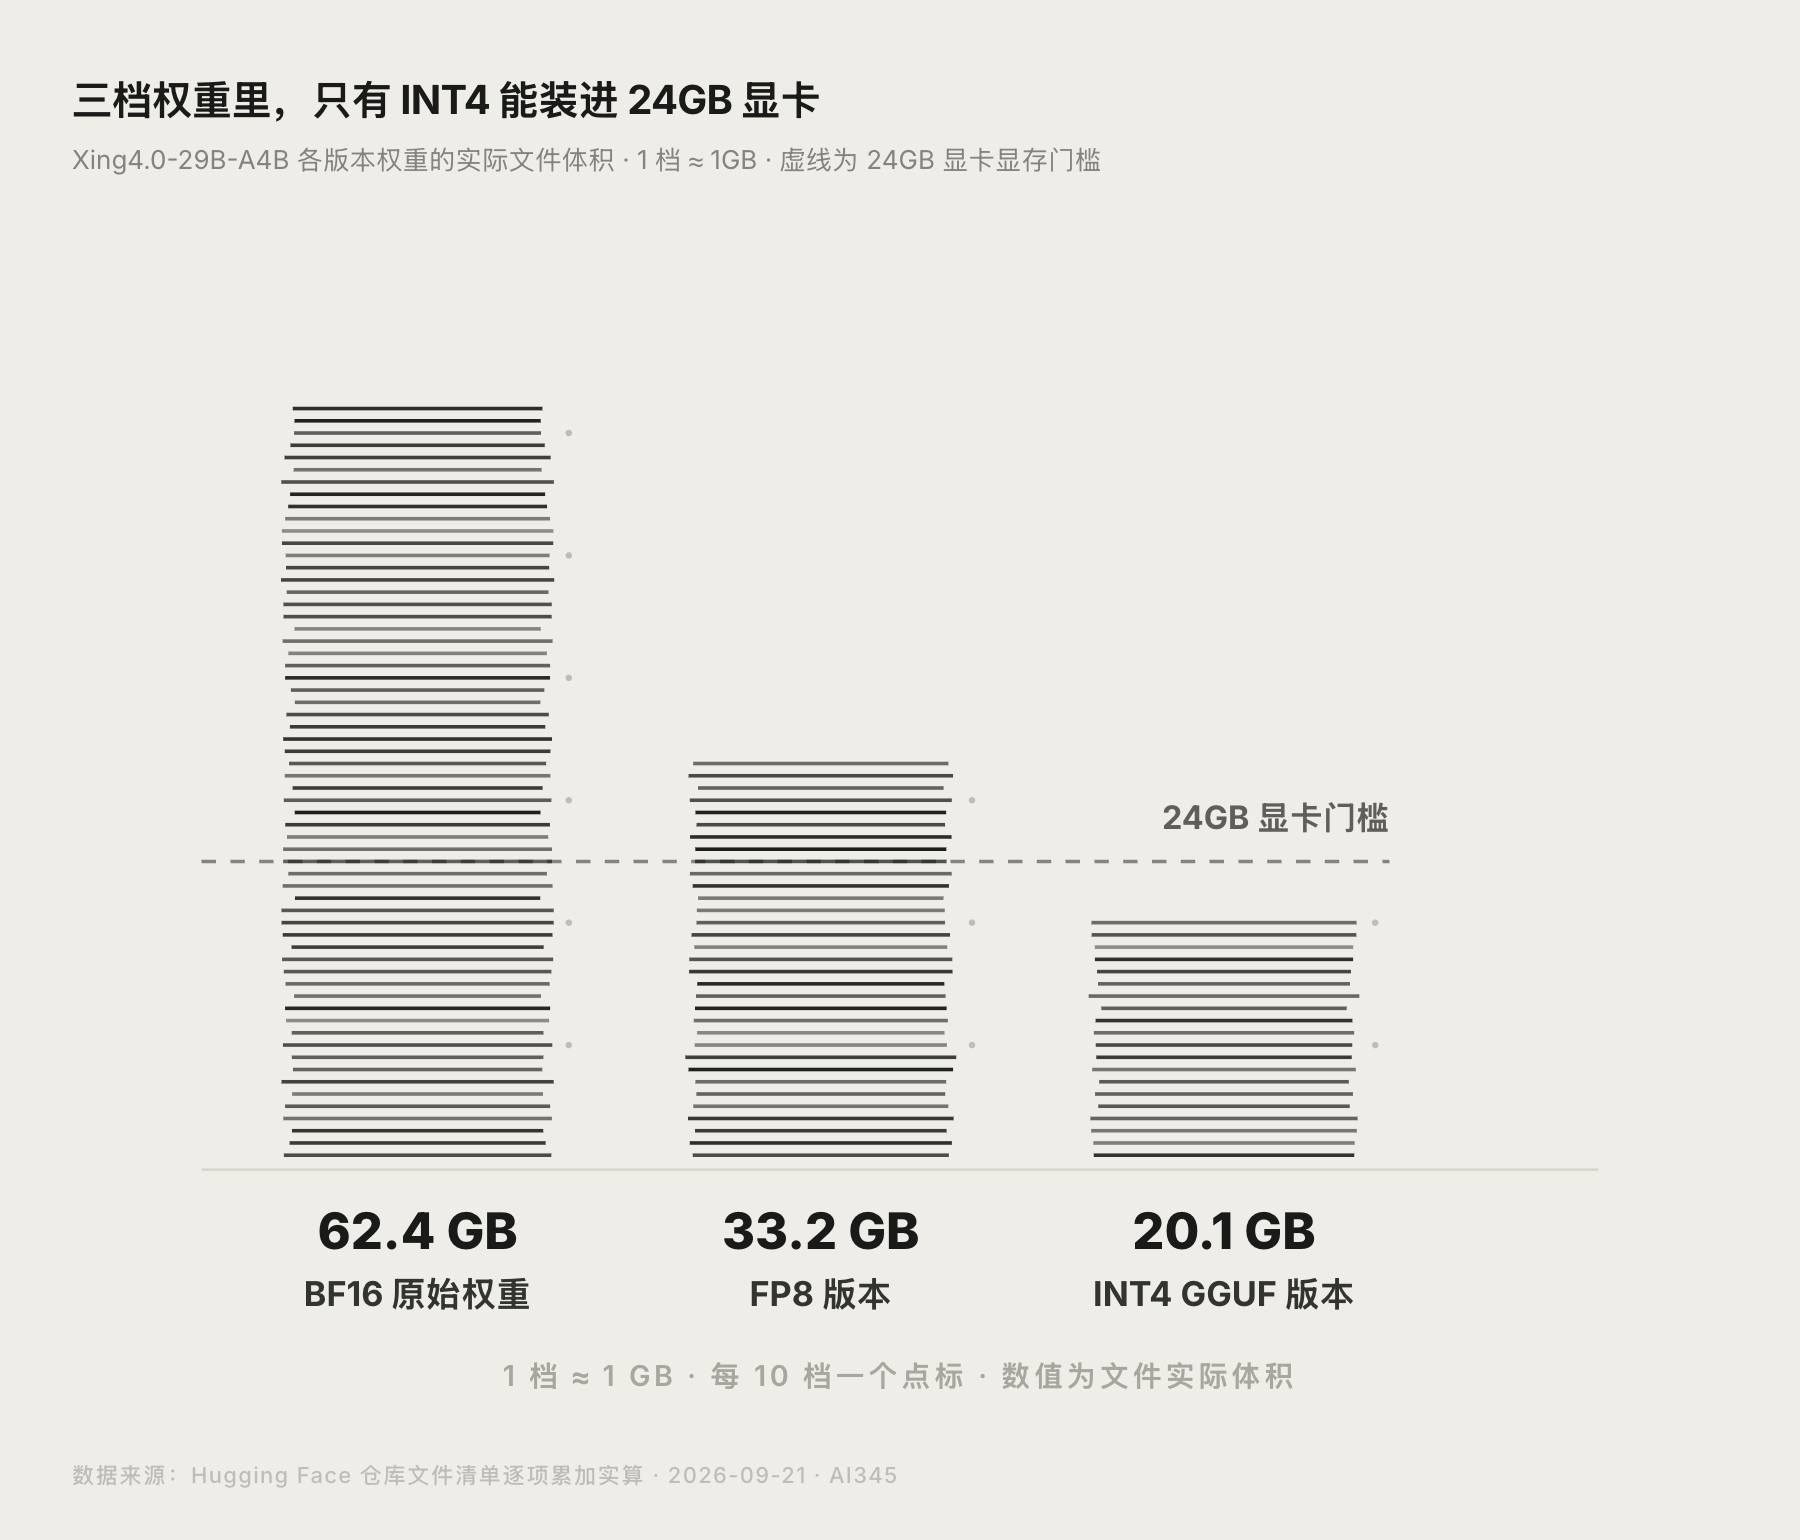
关键结论:24GB 显卡的门票来自 INT4 的 GGUF 版本,不是 FP8,也不是原始权重。 权重 20.1GB 装进 24GB 卡之后,留给 KV 缓存和运行时开销的不到 4GB,所以上下文必须按显存裁剪。社区做的 Windows 一键脚本默认给的是 65536,并不是官方标称的 256K。
还要注意官方说的 15GB 和实际文件 20.1GB 是两个口径:前者指显存占用,后者是下载体积。规划硬件按 20.1GB 这个真实文件体积算更稳妥。
三条部署路线,按硬件选
路线一:vLLM 或 SGLang(40GB 以上显存首选)
官方 GitHub 仓库 给的是标准 OpenAI 兼容服务方式,双卡 24GB 或单卡 40GB 以上比较顺。vLLM 启动命令如下:
vllm serve ${MODEL_PATH} \
    --served-model-name Xing4.0-29B-A4B \
    --tensor-parallel-size 2 \
    --trust-remote-code \
    --max-model-len 262144 \
    --reasoning-parser xing4 \
    --tool-call-parser xing4 \
    --speculative-config '{"method":"mtp", "num_speculative_tokens": 1}'
SGLang 参数风格接近,把 --tensor-parallel-size 换成 --tp-size,推测解码算法用 --speculative-algorithm EAGLE。启动后都是 OpenAI 兼容接口,直接换 base_url 就能接现有应用。
这里有个必须先知道的坑: 官方在 README 里写明,SGLang、vLLM、TensorRT-LLM、llama.cpp、KTransformers 的适配代码都还是 Pull Request,尚未合入各框架主分支。直接 pip install vllm 是跑不起来的,必须从对应 PR 分支安装。
| 框架 | PR | 状态 |
|---|---|---|
| SGLang | sgl-project/sglang#39793 | 待合入 |
| vLLM | vllm-project/vllm#57135 | 待合入 |
| TensorRT-LLM | NVIDIA/TensorRT-LLM#19283 | 待合入 |
| llama.cpp | ggml-org/llama.cpp#29012 | 待合入 |
| KTransformers | kvcache-ai/ktransformers#2168 | 待合入 |
路线二:KTransformers(显存不够就让 CPU 顶上)
KTransformers 走 GPU 和 CPU 异构推理,把一部分专家层放到内存里,适合显存只有 24GB 甚至更小的机器。官方给出的参数里 --kt-num-gpu-experts 24 就是控制放多少专家上 GPU。
代价是速度。这条路线换来的是跑得起来,不是跑得快,适合验证和低并发场景。
路线三:Windows 加消费级显卡的 llama.cpp(最容易上手)
如果只是想在本机试一试,而不是搭服务,社区里已经有人做好了 Windows 一键部署包。作者在 RTX 3090 24GB 的机器上测通了,从解压到能对话大约 10 分钟,不需要装 CUDA Toolkit,也不需要编译环境。
思路很简单:下载预编译的 llama-server.exe 压缩包,把 IQ4_NL 量化权重 和启动脚本放在一起,双击 run-server.bat,浏览器会自动打开对话页面。脚本顶部可以直接改这几个参数:
| 需求 | 改什么 |
|---|---|
| 显存不够 | 把 CTX 从 65536 调小 |
| 纯 CPU 跑 | NGL=0 |
| 只允许本机访问 | HOST=127.0.0.1 |
| 换端口 | 改 PORT |
需要注意,这个包用的是第三方 llama.cpp 分支,官方 llama.cpp 主分支目前还不支持 Xing4.0,Reddit 上有人等了几天也没等到合入。
现在部署会踩到的四个坑
把官方 README 和 Reddit 上的实测讨论 放在一起,有四个现在最容易踩的点:
- 推理框架要装 PR 分支。 vLLM、SGLang 都不能直接用正式版,得按 README 里的 commit hash 拉 PR 分支。
- llama.cpp 官方还不支持。 官方 PR #29012 仍是待合入,想用 llama.cpp 只能走第三方分支或专用部署包。
- 4-bit 体积不止 15GB。 实测的 IQ4_NL 文件是 20.1GB,24GB 卡长期跑长上下文会比较紧张。
- 官方没有公布 MMLU、HLE、GPQA 这类通用能力跑分。 Reddit 上有人专门问这个模型做 STEM 问题行不行,目前只能参考官方的 Agent 和编码基准,通用推理能力要靠自己实测。
社区反馈也要如实说:有用户在第三方分支上跑了一次性提示词测试,认为效果不如 Qwen3.6-35B-A3B;也有人认为它的基准成绩大致相当于三代前的小激活模型。这些是个人单次测试,不是严谨评测,但对「现在值不值得上」有参考意义。
不想折腾本地部署:官方 API 也能先试
天翼 AI 开放平台提供了 Xing4.0-29B-A4B 的在线入口,注册后可以免费领 1 亿 tokens(1QPS),超出后按 0.0015 元/千 tokens 计费。只想验证能力的话,用 API 比配显卡环境快得多。
如果你更关心同类小激活 MoE 的本地部署门槛,站内 openPangu 2.0 本地部署教程 和 MiniMax H3 的 8GB 显存部署方案 可以一起对照看。
值不值得部署:先看这几项跑分
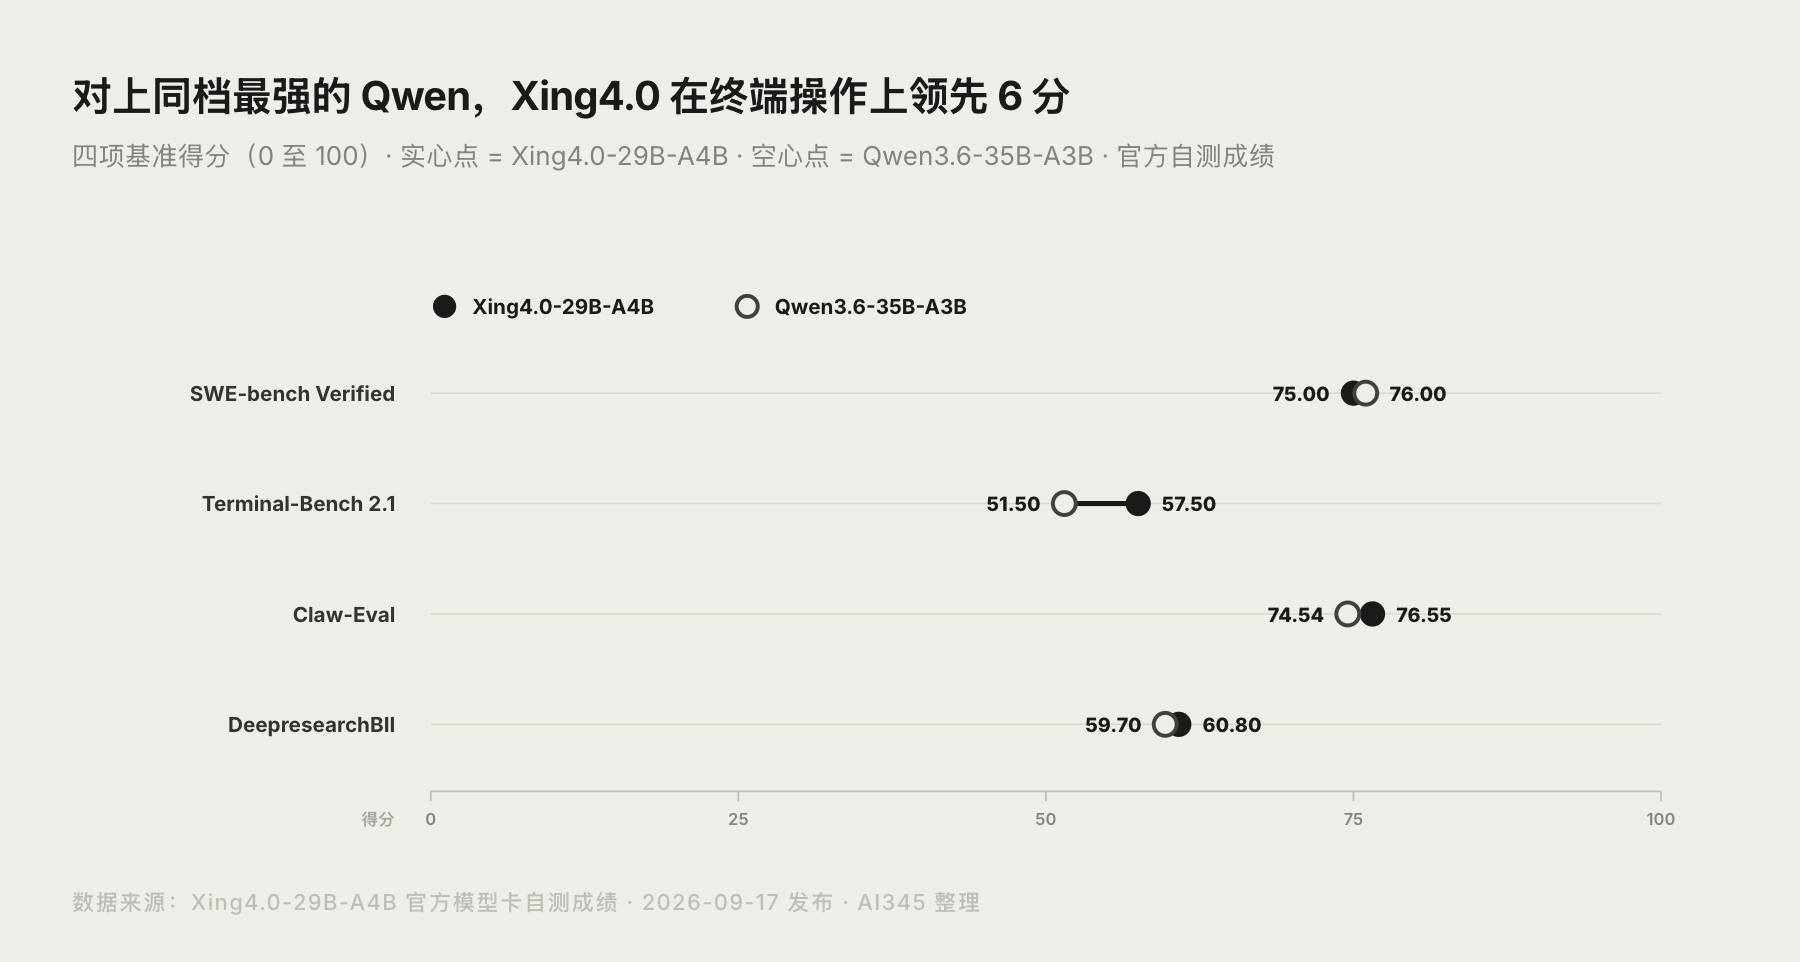
官方给的对标对象是 Gemma4-26B-A4B 和 Qwen3.6-35B-A3B,属于同一档小激活 MoE。四项基准里,Qwen3.6-35B-A3B 是整体更强的那个竞品,所以下面直接把它和 Xing4.0 拉在一起比。
结论很清楚:
- Terminal-Bench 2.1(57.5 对 51.5) 领先 6 分,终端操作和 Agent 任务上它的相对优势最大。
- SWE-bench Verified(75.0 对 76.0) 与 Qwen3.6-35B-A3B 基本持平,编程能力在同一水平线。
- Claw-Eval(76.55 对 74.54) 和 DeepresearchBII(60.80 对 59.70) 小幅领先,长链路研究任务有优势。
- AIME2026(90.0 对 92.7) 略低于 Qwen,纯数学推理不占优。
官方还引用了 SuperCLUE 的智能体能力榜,Xing4.0-29B-A4B 得分 93.52,排第 3,与两款头部 Qwen 模型的差距不到 1 分。但这些数字都来自官方自测,评测配置写在模型卡里,要判断是否适合自己的业务,最好用自己的数据再测一轮。
生态与热度:上线五天的情况
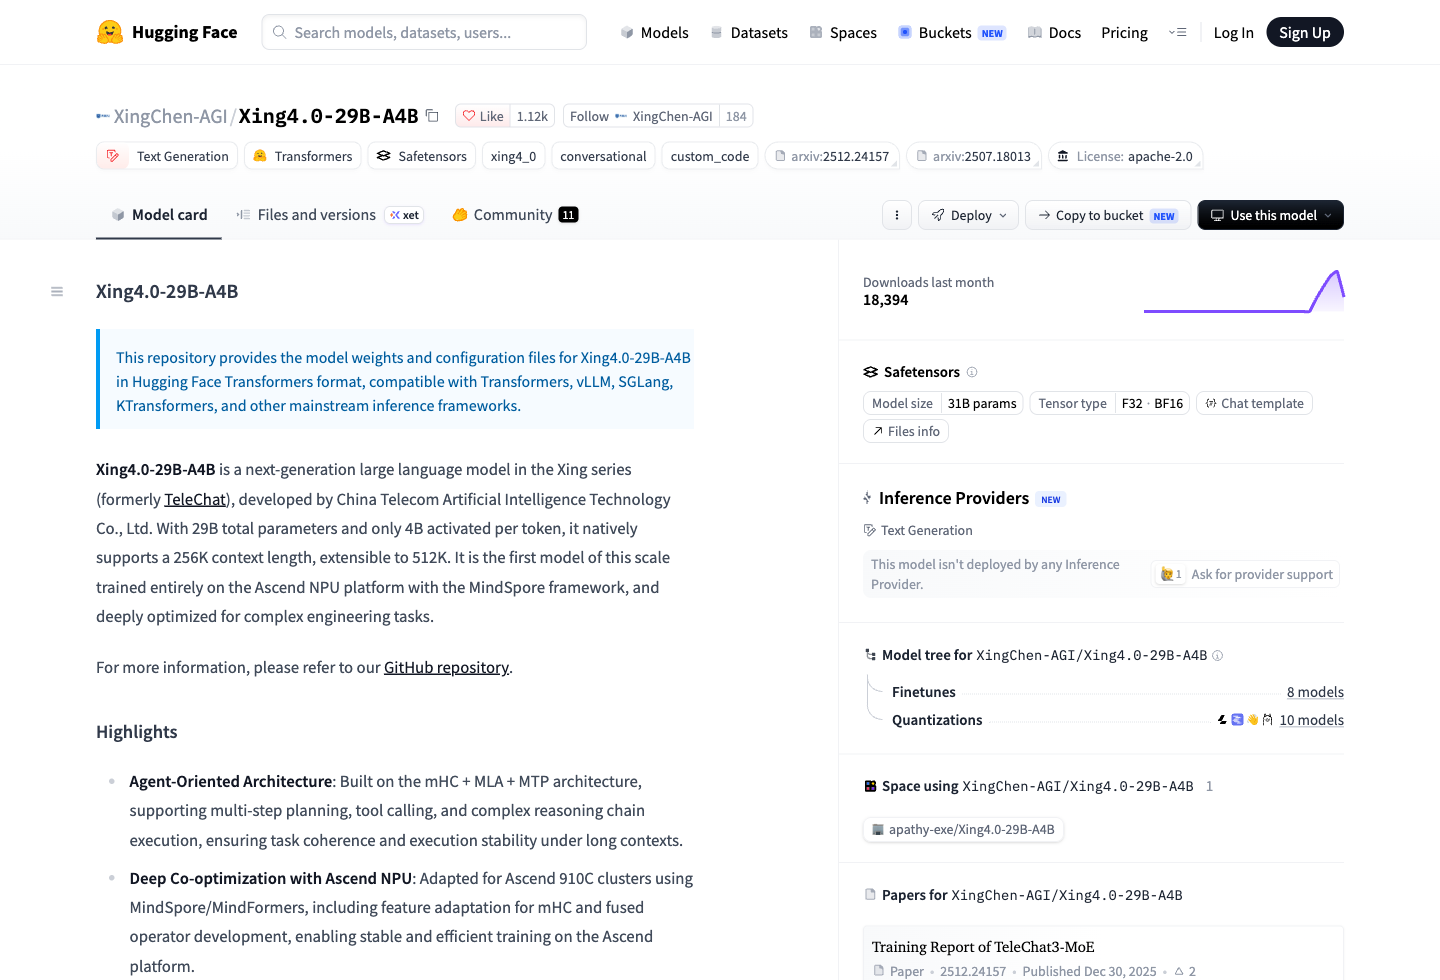
从 Hugging Face 的数据看,基础权重仓库截至 9 月 21 日的下载量是 18,394 次、点赞 1,124,FP8 版本下载 333 次。GitHub 仓库四天拿到 80 多个 star,热度真实但不算夸张,大部分开发者还在等推理框架的支持。
硬件生态这边,国产 GPU 厂商跟进很快:沐曦在发布当天完成了 Day 0 适配,智源 FlagOS 也放出了适配版本,支持跨架构部署。这与它全栈国产的定位是一致的。
总结
Xing4.0-29B-A4B 的部署门槛比想象中低:一张 24GB 显卡加 INT4 权重就能开工,Windows 上甚至有 10 分钟跑通的一键包。
但现阶段真正的门槛不在硬件,而在生态。主流推理框架都还没合入支持,要靠 PR 分支或第三方分支绕过。想现在就上手,Windows 一键包和 KTransformers 是最省事的两条路;要搭生产服务,建议等 vLLM、SGLang 的 PR 合入。
本文由 AI345 整理,最后更新于 2026 年 9 月。
常见问题
Xing4.0-29B-A4B 本地部署需要什么显卡?
答:24GB 显存是本地跑的实用门槛,前提是用 INT4 的 GGUF 版本,权重约 20.1GB。如果用 BF16 原始权重(约 62.4GB)或 FP8(约 33.2GB),需要单卡 80GB 或双卡张量并行。
24GB 显卡能跑多长的上下文?
答:权重占掉约 20GB 后只剩不到 4GB 给 KV 缓存,社区部署脚本默认是 65536。想要更长上下文,需要做 KV 缓存量化,或者走 KTransformers 的 CPU 混合方案。
llama.cpp 现在支持 Xing4.0 吗?
答:官方主分支还不支持,适配 PR(#29012)仍在待合入状态。目前能用的是第三方 llama.cpp 分支,或社区做的 Windows 一键部署包。
Xing4.0-29B-A4B 是免费开源的吗?
答:是,权重以 Apache 2.0 协议开源,可商用。官方同时声明禁止用于危害国家社会安全、违反法律法规,以及未经安全审查备案的互联网服务。
不本地部署,可以直接调用吗?
答:可以。天翼 AI 开放平台提供在线调用,新用户可免费领 1 亿 tokens,超出后 0.0015 元/千 tokens。
它和 Qwen3.6-35B-A3B 该选哪个?
答:终端操作和 Agent 长链路任务,Xing4.0 的官方数据更好;纯数学推理和指令跟随,Qwen 略优。上下文需求超过 256K 时,Xing4.0 可扩展到 512K 是加分项。
 京ICP备2024094994号-29