
Xing4.0 是什么?中国电信 29B 开源模型跑分解读
2026 年 9 月 17 日,中国电信旗下 TeleAI 开源了新一代大模型 Xing4.0,首发 Xing4.0-29B-A4B 为 29B 总参数、仅激活 4B 的 MoE,原生支持 256K 上下文,且完全在昇腾 NPU 上用 MindSpore 训练完成。
事实来源:Hugging Face 模型卡、Xing4.0 官方 GitHub 仓库(2026 年 9 月 17 日至 18 日更新)。
Xing4.0 是什么:一句话定位
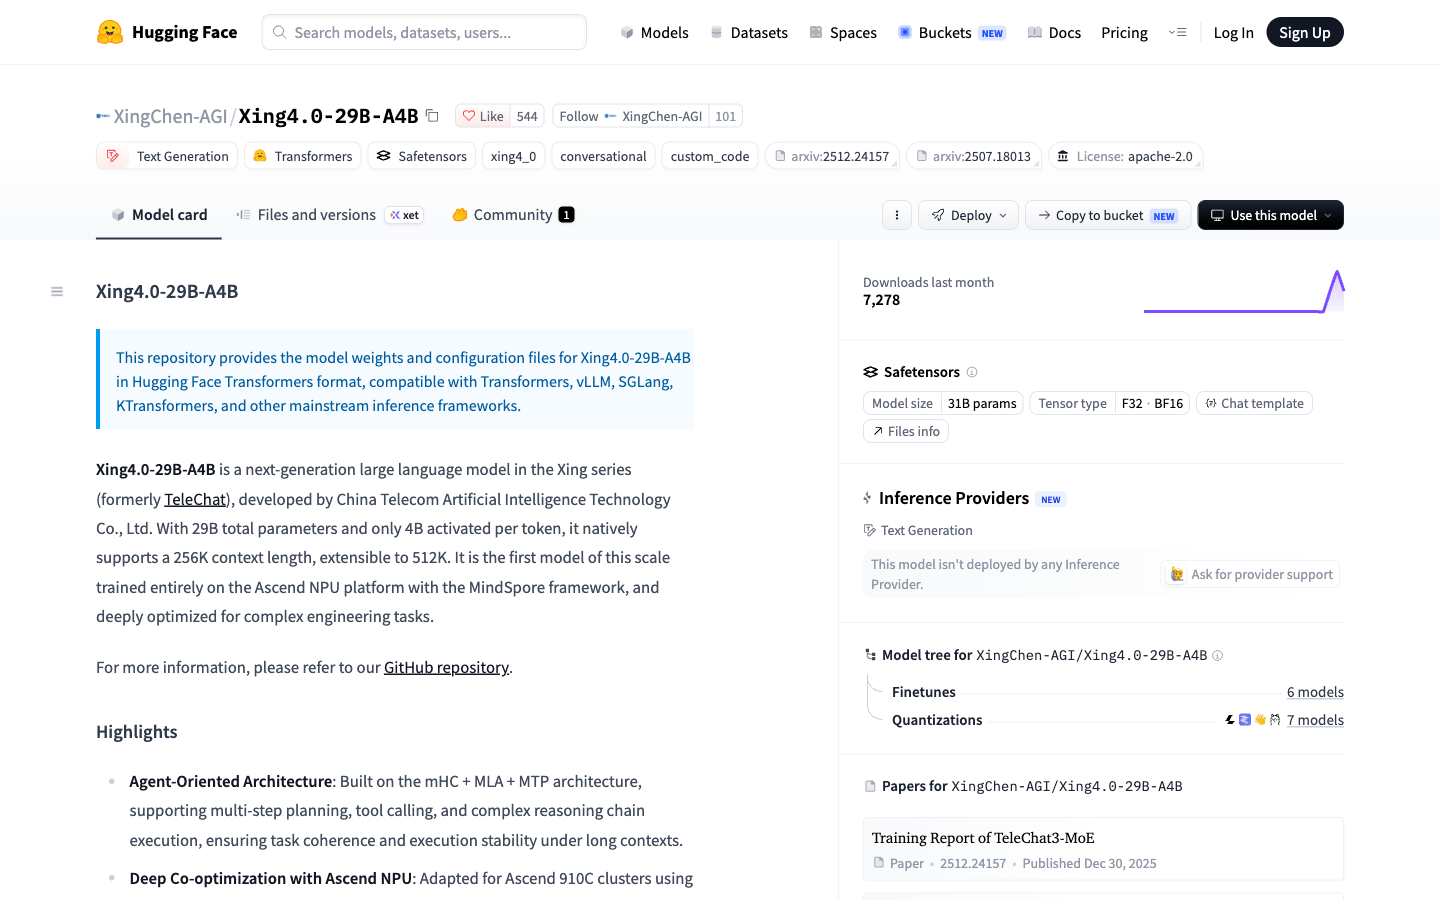
Xing4.0 是中国电信旗下 TeleAI 的大模型新系列,前身是 TeleChat。这次开源的是其中的 MoE 版本,命名为 Xing4.0-29B-A4B,后缀里的 A4B 表示每个 token 激活 4B 参数。权重与完整规格见 Hugging Face 仓库。
发布节奏上,9 月 17 日一次性放出三个版本:基础 BF16 权重、FP8 版本和 GGUF 版本,同步上线 Hugging Face、ModelScope 和 Modelers 三个渠道。截至发稿,Hugging Face 基础仓库下载量约 3000 次、点赞 469。
如果你之前关注过国内大模型开源节奏,可以对照站内 GLM-6.0 是什么?何时发布、全自训练与 393 亿募资 看另一条技术路线。
规格拆解:29B 总参数、4B 激活
| 项目 | 规格 |
|---|---|
| 总参数 / 激活参数 | 29B / 4B |
| 层数 | 40 |
| 隐藏维度 | 3584 |
| 稠密 FFN 中间维度 | 9216 |
| 专家中间维度 | 1024 |
| 注意力类型 | MLA |
| 路由专家数 / 每 token 激活 | 64 / 4 |
| 共享专家数 | 1 |
| 上下文长度 | 256K,可扩展至 512K |
架构上是 mHC 加 MLA 加 MTP 的组合:MLA 负责注意力压缩,MoE 部分用 64 个路由专家加 1 个共享专家,MTP 支撑多 token 预测,官方把整套设计定位为面向 Agent 任务。
对你意味着什么:29B 的总参数保住了知识容量,4B 的激活量让实际推理开销接近小模型。想在有限算力上跑 Agent 的团队,这是直接的降本空间。
打榜成绩:编程与 Agent 任务的表现
官方给出的对标对象是 Gemma4-26B-A4B 和 Qwen3.6-35B-A3B,同为小激活 MoE 路线。
| 基准 | Xing4.0-29B-A4B | Gemma4-26B-A4B | Qwen3.6-35B-A3B |
|---|---|---|---|
| SWE-bench Verified | 75.00 | 53.00 | 76.00 |
| Terminal-Bench 2.1 | 57.50 | 30.00 | 51.50 |
| Claw-Eval | 76.55 | 71.49 | 74.54 |
| DeepresearchBII | 60.80 | 39.30 | 59.70 |
| Tau3-Bench | 64.63 | 58.90 | 67.20 |
| AIME2026 | 90.00 | 88.30 | 92.70 |
| IFBench | 69.67 | 72.67 | 65.50 |
读数上,Xing4.0 优势最明显的是终端操作(Terminal-Bench 2.1 拿到 57.50,高于 Qwen 的 51.50 和 Gemma4 的 30.00)和深度研究(DeepresearchBII 60.80)。SWE-bench Verified 的 75.00 与 Qwen3.6-35B-A3B 的 76.00 基本持平,AIME2026 的 90.00 略低于 Qwen 的 92.70,IFBench 的 69.67 低于 Gemma4 的 72.67。
需要说明的是,这些数字来自官方自测,评测条件写在模型卡脚注里(例如 SWE-bench 使用 SWE-agent 框架、210K 上下文窗口、三次取平均),不是第三方独立复现。
为什么全昇腾训练值得单独说
官方称这是首个在这个规模上完全用昇腾 NPU 与 MindSpore 框架训练完成的模型,适配的是昇腾 910C 集群。
披露的优化手段包括细粒度 MoE 通信优化、选择性重算、DVM 图算融合以及 Ascend C mHC 融合算子,整体训练吞吐相比开箱状态提升约 96%。
对国内开发者来说,这条路线验证了一件事:国产算力栈能跑通 29B 级 MoE 的完整训练,而不只是做推理适配。这比单纯的跑分更有参考价值。
怎么用上 Xing4.0
三种方式:
- 下载权重:Hugging Face 仓库是 XingChen-AGI/Xing4.0-29B-A4B,ModelScope 与 Modelers 同步有镜像,国内下载通常走这两个更快。
- 本地推理:用 Transformers 加载时注意需要
trust_remote_code=True,输出里的思维链在</think>之前,最终答案在它之后,取值时记得切开。 - 服务化部署:支持 vLLM、SGLang、KTransformers、TensorRT-LLM 和 llama.cpp。官方提示这些框架的适配 PR 仍在审核、尚未合入主分支,合入前需要从对应 PR 分支安装,进度见 官方 GitHub 仓库。
采样参数官方给了两套:复杂推理任务用 temperature 1.0、top_p 0.95、repetition_penalty 1.05;编程与 Agent 任务用 temperature 0.8、top_p 0.95。Agent 框架侧已对 OpenCode、Claude Code、OpenClaw、Hermes 做过格式对齐。
和同量级模型怎么选
重心在终端操作和长链路研究任务,Xing4.0 目前的官方数据最亮眼;更看重数学推理和指令跟随,Qwen3.6-35B-A3B 与 Gemma4 各有优势。另外它的上下文可从 256K 扩展到 512K,长文档场景值得单独测一遍。
想做同类横向参考,也可以看站内 Anthropic MHS 是什么?模型硬件标准全解 了解 Agent 与硬件标准的配套趋势,或者看 GPT Image 2 是什么?OpenAI 新图像模型的 5 大能力、免费额度与用法详解 对比多模态方向。
常见问题
Xing4.0 是免费的吗?
答:权重采用 Apache 2.0 许可,下载和本地商用都免费,需要自备算力。官方没有公布官方 API 的定价信息。
Xing4.0 和 TeleChat 是什么关系?
答:Xing 是 TeleChat 系列的新名字,Xing4.0 是这一代的最新版本,由 TeleAI 研发,底座是同一技术谱系。
Xing4.0-29B-A4B 的 A4B 是什么意思?
答:表示每个 token 只激活约 4B 参数。总参数 29B 决定知识容量,4B 激活量决定实际推理开销。
部署 Xing4.0 需要什么硬件?
答:模型卡给出的 vLLM 与 SGLang 示例都是 2 卡张量并行,显存按 0.90 利用率配置。实际门槛取决于量化和上下文长度,建议按自己的场景实测。
Xing4.0 什么时候发布的?
答:2026 年 9 月 17 日宣布开源,同一天放出 BF16 基础版、FP8 版与 GGUF 版三个仓库。
 京ICP备2024094994号-29