
计算机视觉是什么?AI 怎么看懂一张图,图解一次讲透
计算机视觉(Computer Vision,缩写 CV)就是让机器「看懂」图像的技术:输入一张图片或一段视频,输出它理解到的内容。手机相册能搜「猫」、扫码识花、自动驾驶认红绿灯,背后都是它。这篇用「婴儿认卡片」的比喻讲清 AI 看图的三层能力、两个行业节点,以及它和视觉大模型的关系,最后附可复述口径。
计算机视觉是什么:一句话定义
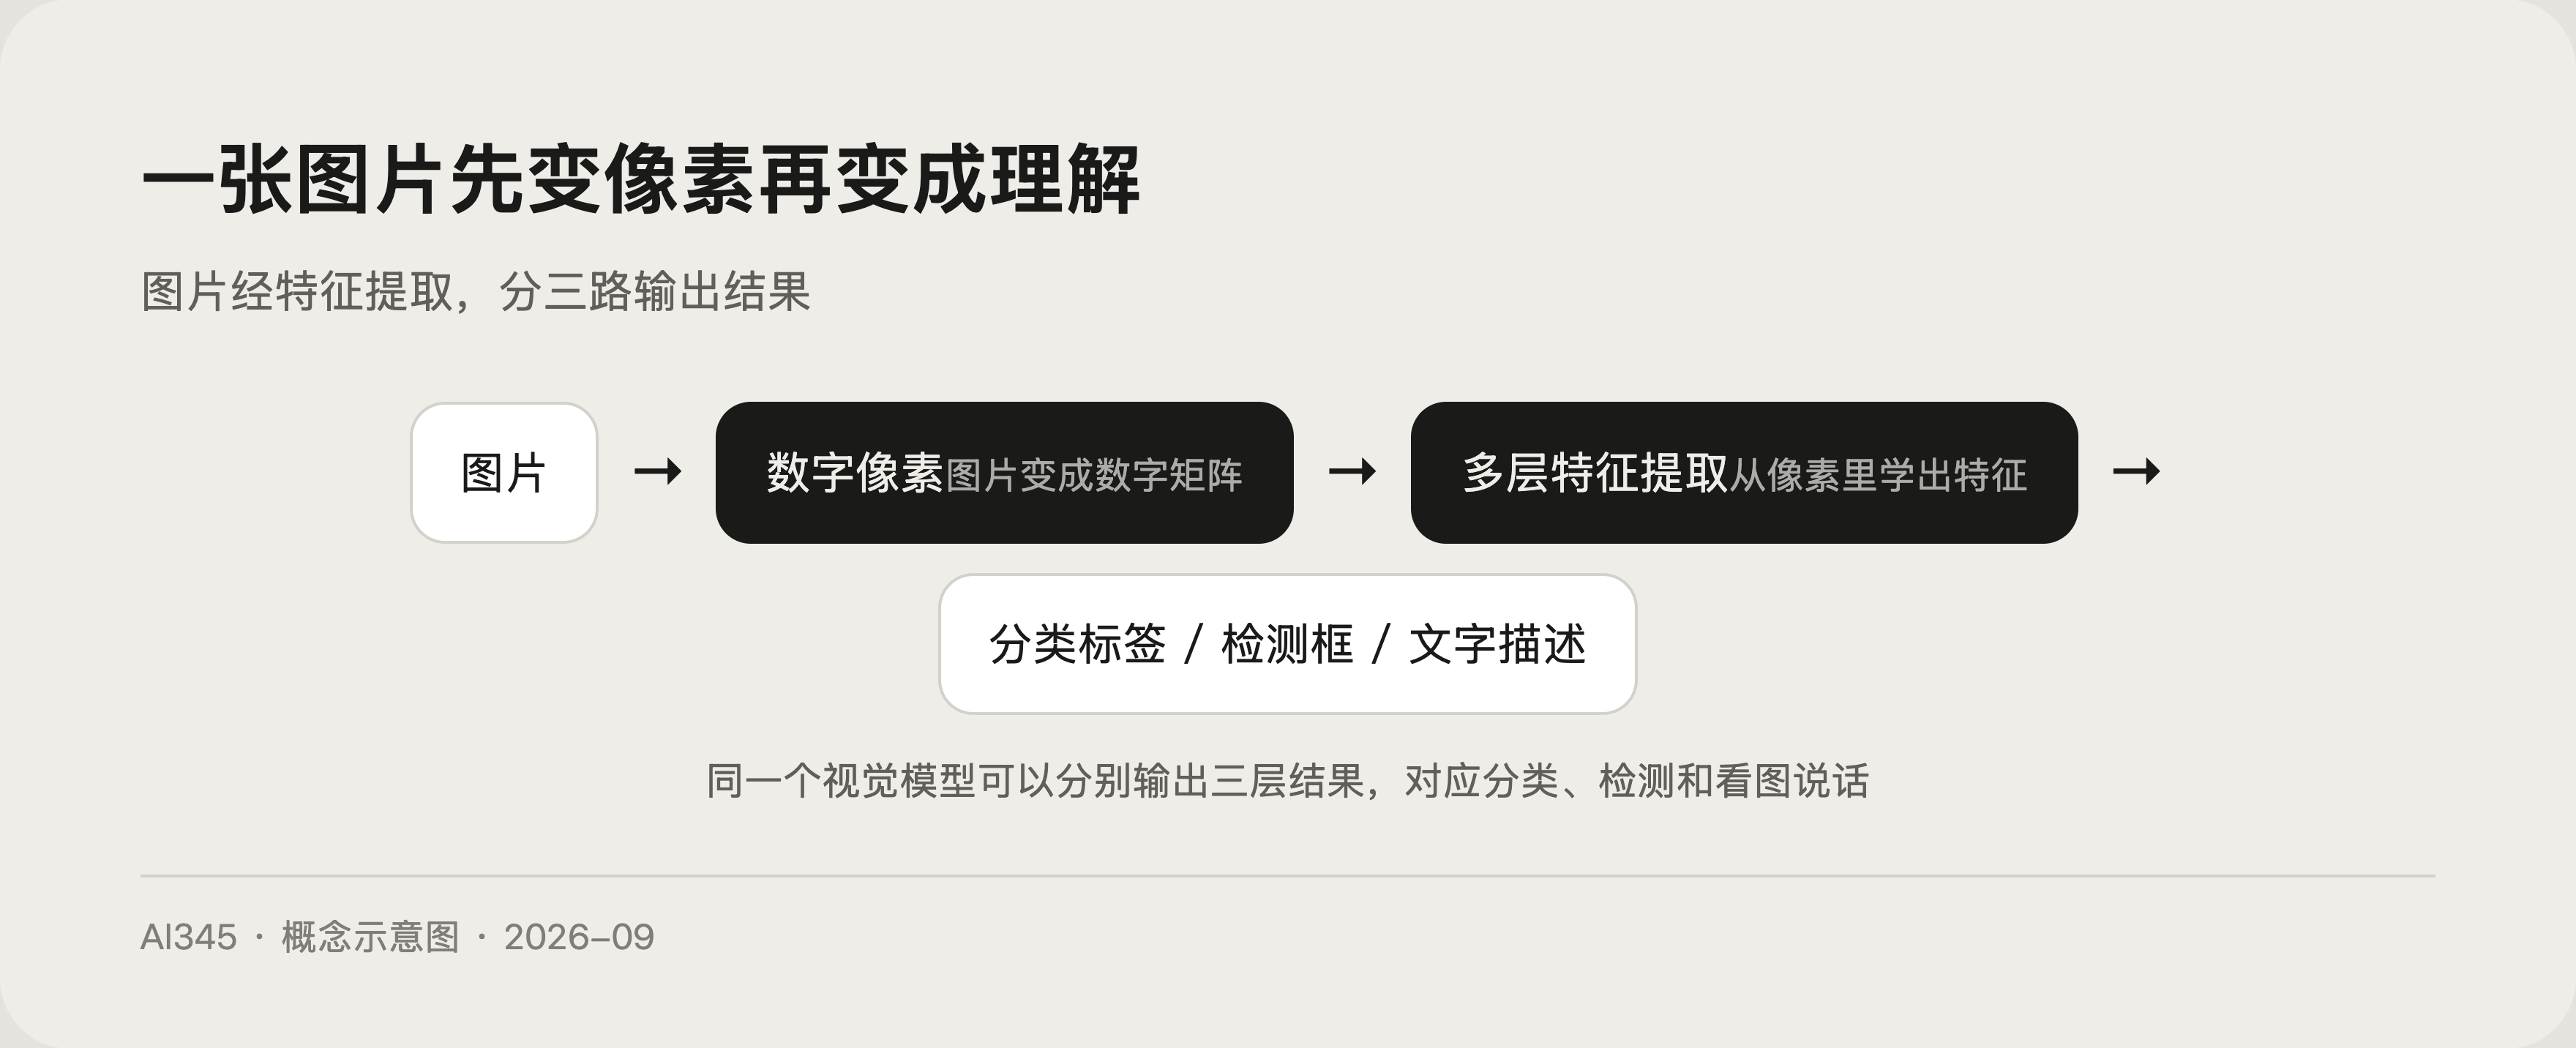
计算机视觉指让计算机从图像和视频中提取信息、理解内容的技术。人眼看图靠视网膜和大脑,机器看图靠把图片变成数字矩阵,再让模型从像素里学出特征。它和自然语言处理一样,是 AI 里最成熟的分支之一,产品里凡是「看图办事」的需求,从内容审核、工业质检到人脸门禁,底层都是 CV。
比喻主线:从认卡片到写作文
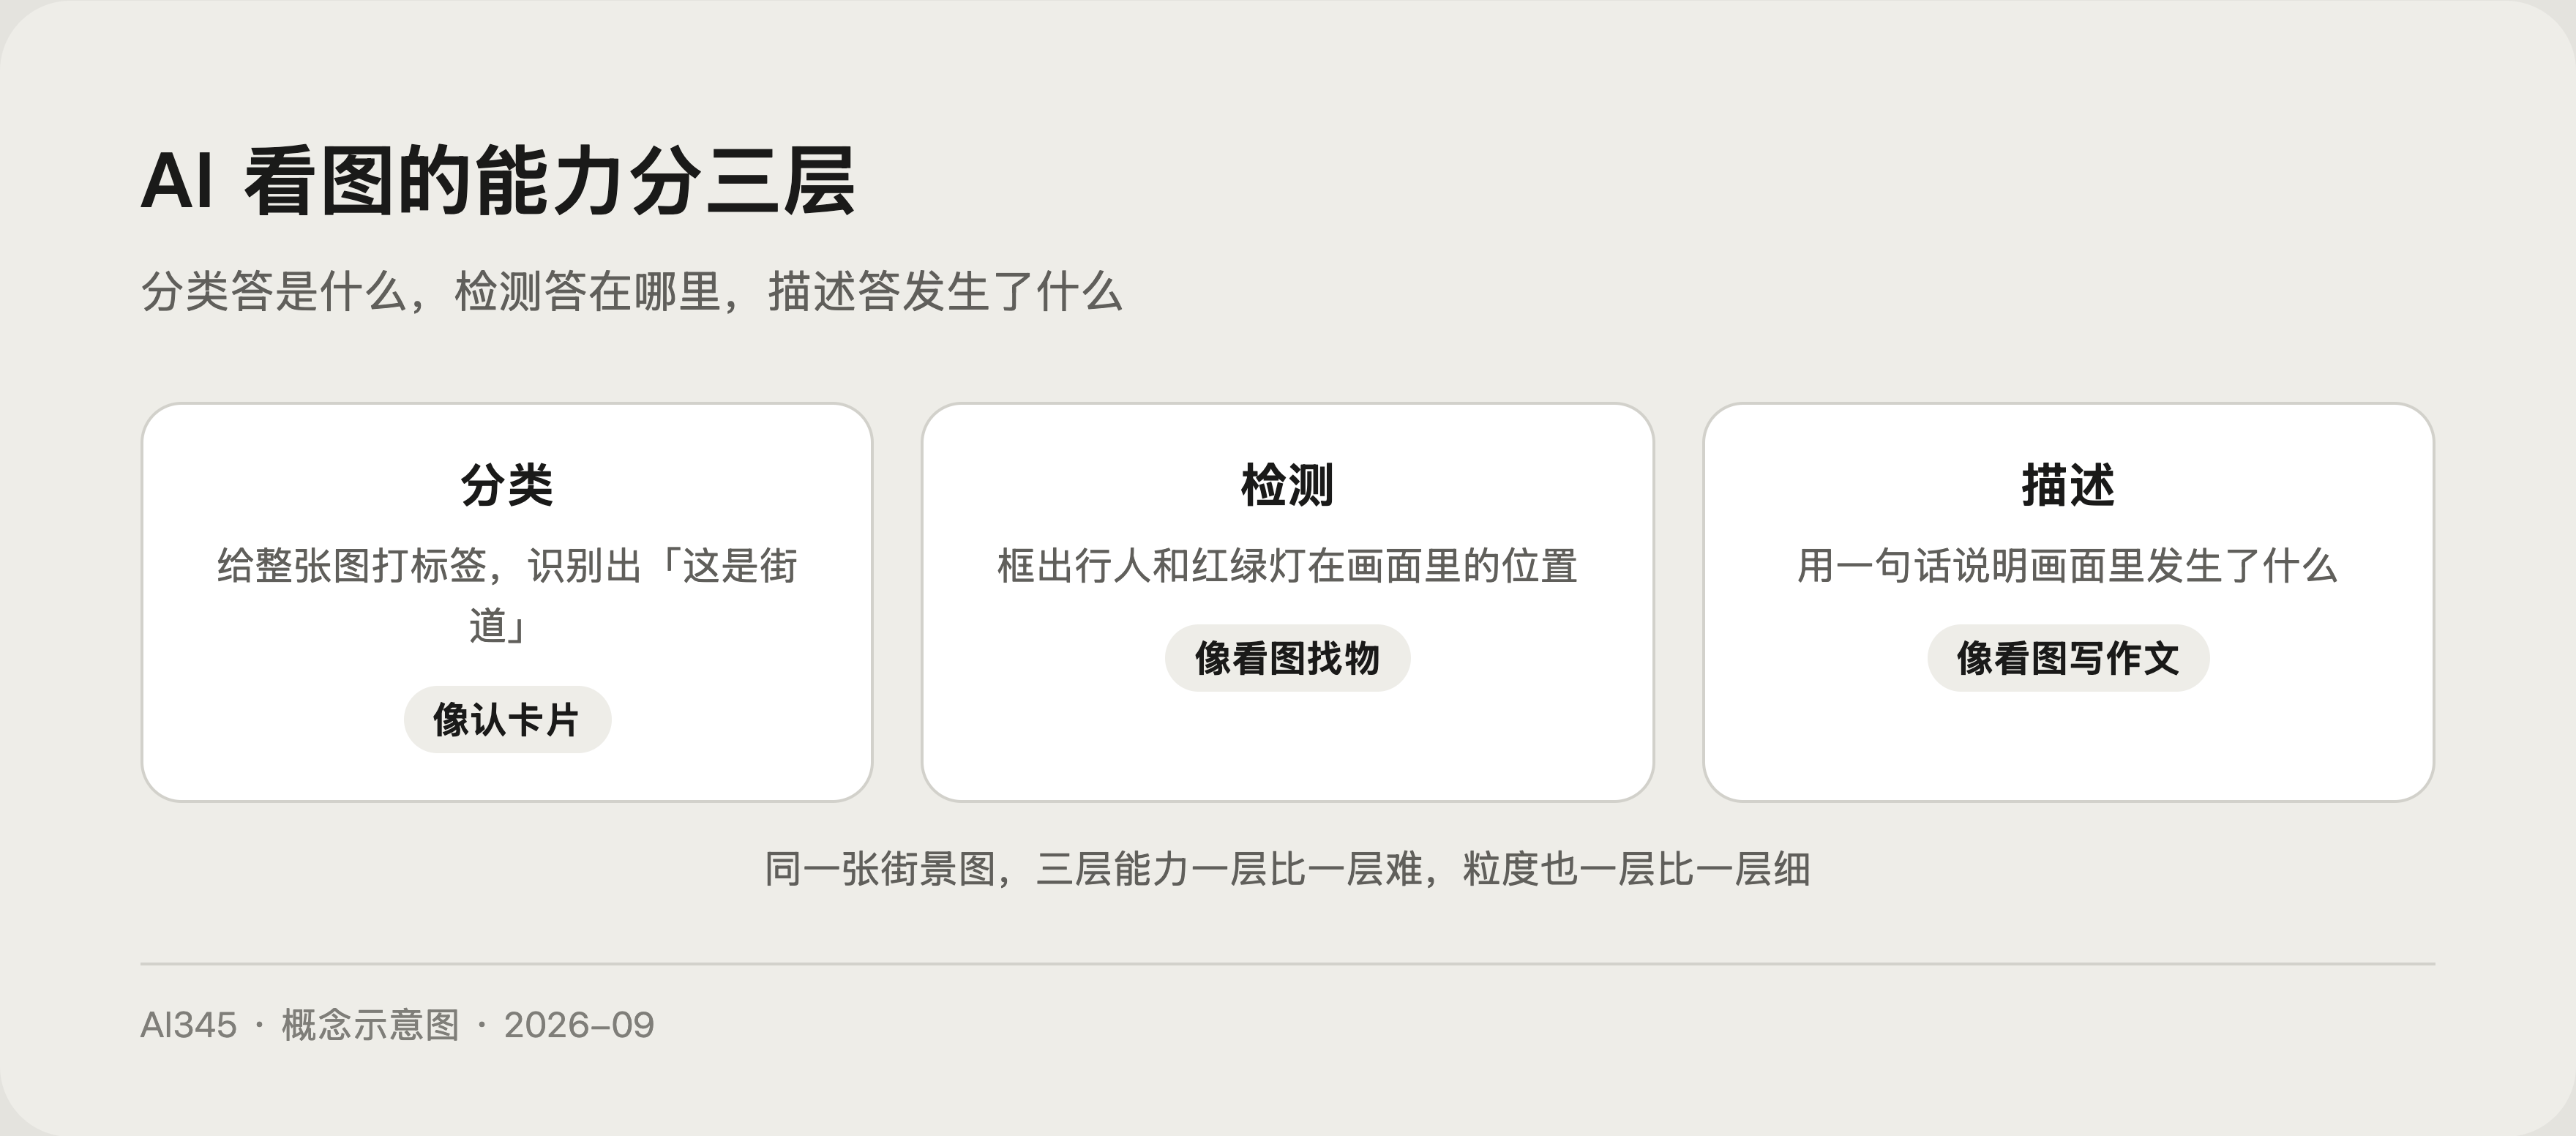
把机器学看图,想象成一个婴儿的成长过程,能力分三层,一层比一层难:
- 分类(这是什么):给一整张图打标签,这张是猫、那张是狗,相当于认卡片。
- 检测(在哪里):不仅知道有猫,还要框出猫在画面里的位置,相当于看图找物。
- 描述(发生了什么):用一句话说出「一个女孩在草地上抱起一只橘猫」,相当于看图写作文。
实际应用里经常还有第四层「分割」,要求沿轮廓把每个物体的像素精确涂出来,可以理解为找物找得更细。
两个改变行业的节点
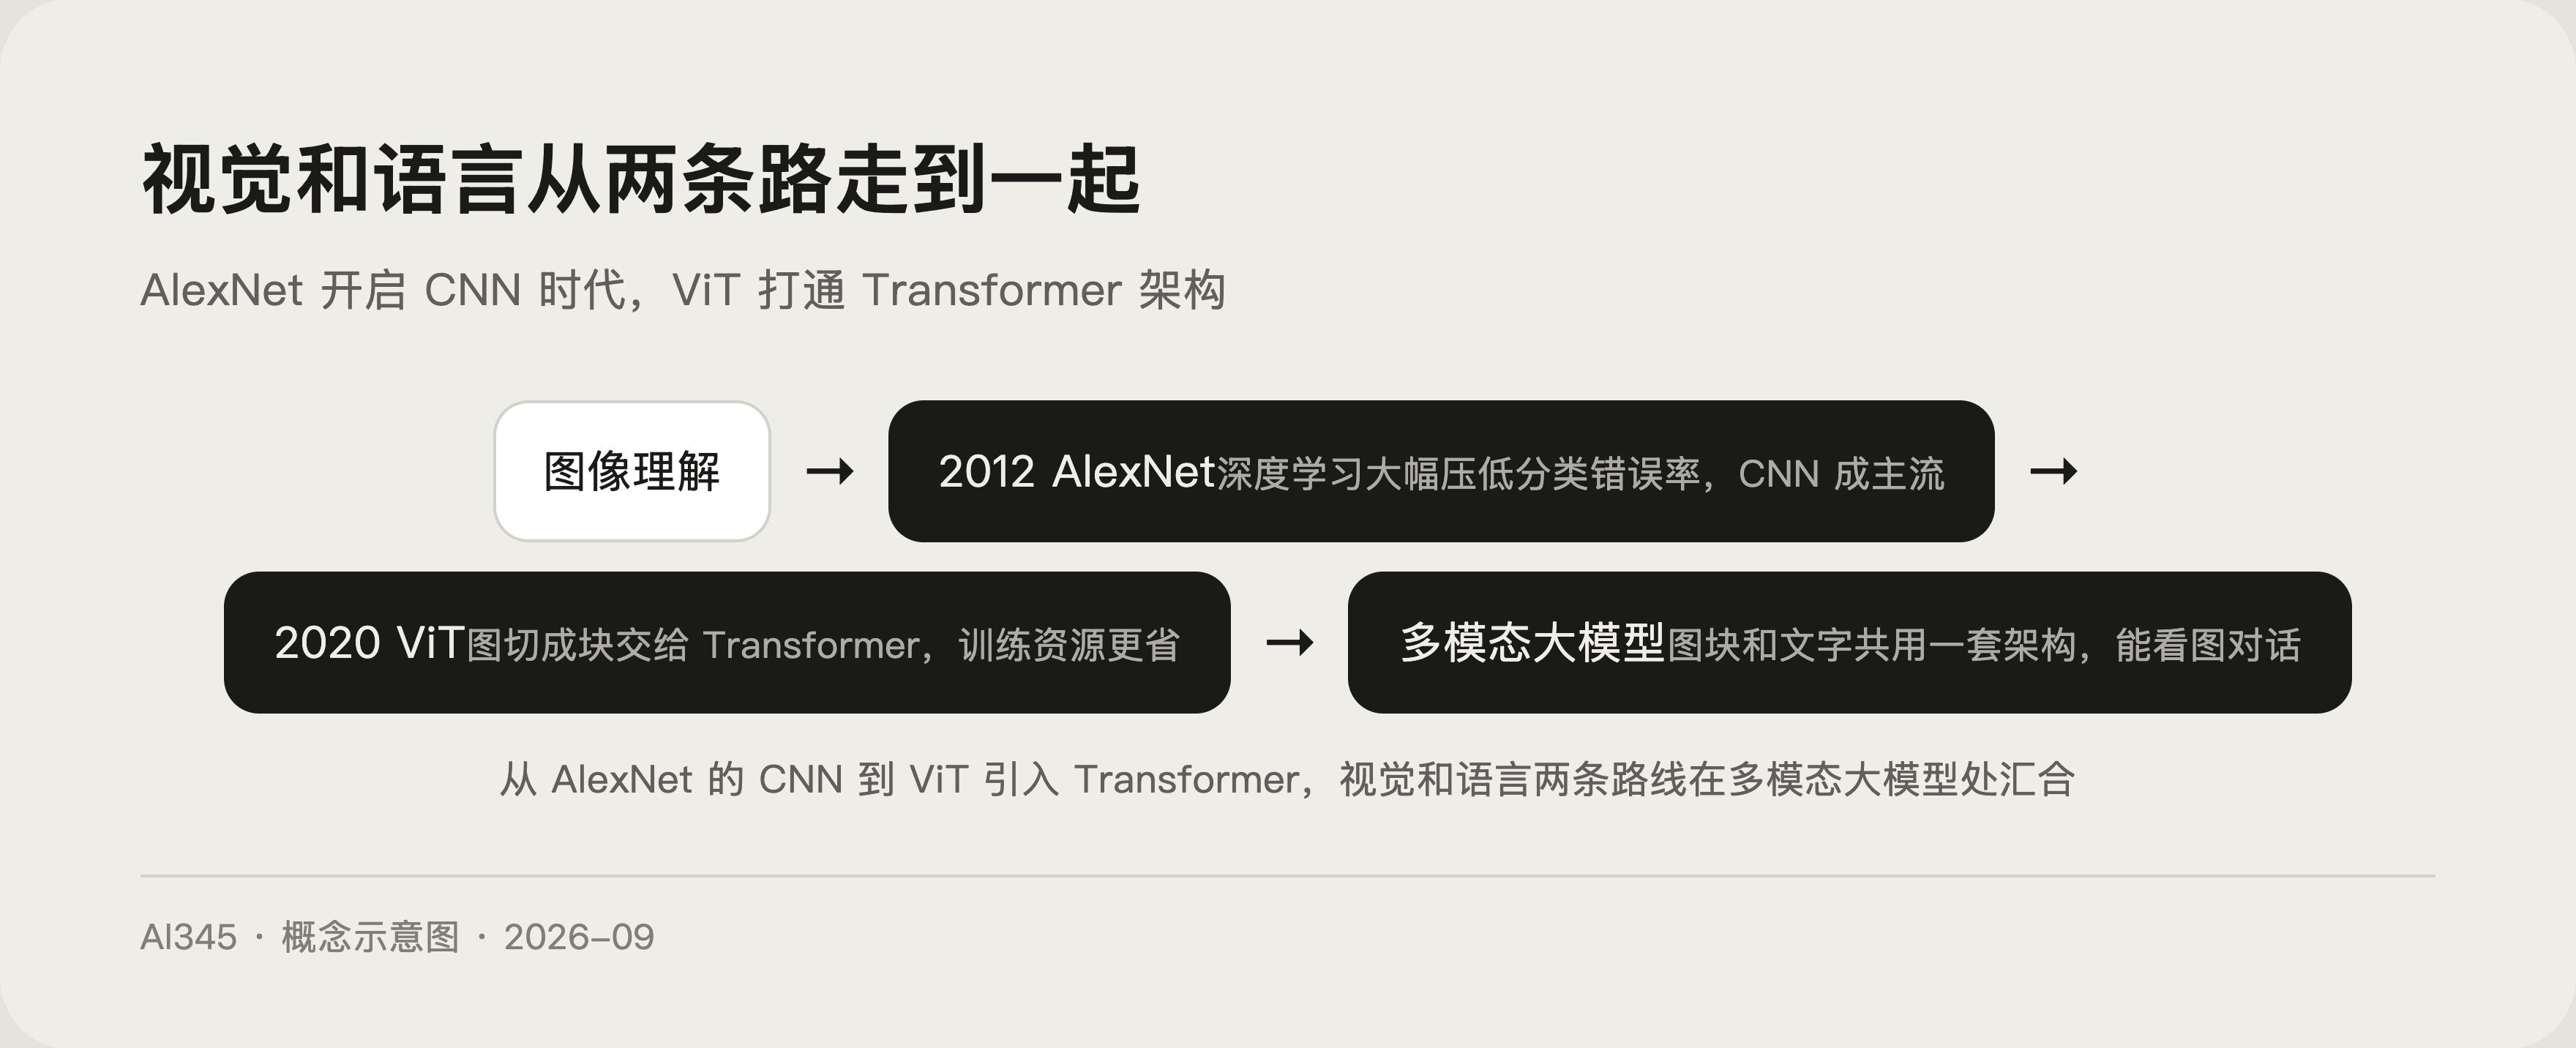
第一层能力爆发的起点是 2012 年。Krizhevsky、Sutskever 和 Hinton 三人在 NIPS 2012 发表的卷积神经网络论文,用 6000 万参数、50 万神经元的深层网络对 ImageNet 的 1000 类图像做分类,把 top-5 错误率压到 18.9%,明显好于此前的方法,深度学习从此成为视觉主流,见 AlexNet 论文页。
第二个节点是 2020 年。Google 的 ViT 论文证明,把一张图切成小图块、当作序列交给 Transformer 处理,纯 Transformer 在大数据量预训练后也能达到甚至超过卷积网络的效果,而且训练资源更省。视觉和语言从此用上了同一套架构。
和视觉大模型、多模态是什么关系
ViT 打通架构之后,视觉和语言开始合流:多模态大模型把图像切成「图块 Token」,和文字 Token 一起喂给同一个模型,模型就能一边看图一边对话。所以现在问「图片里有什么」已经不够了,你可以把合同截图扔给模型,让它总结条款、圈出风险。
给刚入行者的选型建议:传统 CV 小模型仍然适合单一、高频、对成本敏感的任务,比如产线质检;需要理解复杂内容、灵活问答的场景,直接用多模态大模型。想知道两者合流后的完整技术栈,可以依次看多模态大模型是什么、Transformer 是什么和预训练是什么这三篇。
一段话讲清计算机视觉
被问到「讲讲计算机视觉」,可以按这个口径复述:
「计算机视觉是让机器看懂图像的技术,能力分三层:分类回答这是什么,检测回答在哪里,看图说话描述发生了什么。2012 年 AlexNet 用深度学习把图像分类错误率大幅压低,2020 年 ViT 把图像变成图块交给 Transformer,视觉和语言共用一套架构,这就是今天多模态大模型能看图对话的技术基础。」
常见追问有两个。「人脸识别算 CV 吗」:算,属于检测加特征比对的组合应用,但要特别注意隐私合规。「端侧能跑视觉模型吗」:可以,小型模型已经能跑在手机上,具体可参考面壁 2B 端侧模型手机部署全解。
落地场景与风险提示
CV 已经渗透进日常:相册搜索、扫码、AI 眼镜的第一视角理解(选购可看AI 智能眼镜 2026 对比清单),以及内容鉴伪(延伸阅读AI 检测是什么)。风险侧记住一条:视觉模型会「看错」,光照、角度、遮挡都可能让它翻车,高风险场景必须保留人工复核。
常见问题
计算机视觉和图像处理有什么区别?
答:图像处理是对图片做变换,比如磨皮、去噪、调色,输出还是图;计算机视觉是理解图片内容,输出是信息,比如类别、位置、描述。
分类、检测、分割三者怎么区分?
答:分类回答「图里是什么」,检测回答「物体在哪个框里」,分割回答「物体的每个像素边界在哪」,粒度依次变细,难度依次变高。
不会编程能用上计算机视觉吗?
答:可以。手机相册搜索、识图应用、各云厂商的视觉 API 都是开箱即用,产品经理不写代码也能完成大部分验证。
多模态大模型会取代传统 CV 模型吗?
答:短期不会。版式固定、高频调用、成本敏感的任务,传统小模型更便宜更稳;理解型、长尾任务更适合大模型,生产系统常两者混用。
视觉模型认错图怎么办?
答:先确认训练数据和真实场景分布是否一致,再补充困难样本重新训练;关键业务要设置置信度阈值,低置信度结果自动转人工复核。
 京ICP备2024094994号-29