
AI检测是什么?实测3组文本,讲透原理、准确率与误判真相
AI检测(AIGC 检测)是用算法判断一段文本、一张图片或一段视频是否由 AI 生成的技术,目前中文场景最常用的免费工具是腾讯朱雀AI检测助手,官方宣称文本检测准确率超过 92%。但"宣称准确率"和"你手里那条文本的判定结果"是两回事:OpenAI 自己的检测器因为准确率太低只活了半年,斯坦福研究也证实检测器会大量误判人写内容。本文用 3 组真实文本实测了朱雀的判定结果,并讲清原理、准确率和误判后怎么办。
作者:AI345 | 最后更新于 2026 年 9 月 7 日 | 本文实测数据由 AI345 于 2026 年 9 月 7 日通过朱雀网页版实测取得
目录
- AI检测是什么?
- AI检测的原理:工具是怎么判断的?
- 主流 AI 检测工具有哪些?
- 实测:3 组文本放进腾讯朱雀AI检测
- AI检测准不准?官方与学术研究怎么说
- 为什么自己写的内容会被误判成 AI?
- 被 AI 检测误判了怎么办?4 步应对
- 常见问题 FAQ
- 总结
AI检测是什么?
AI检测指的是用专门的算法模型,判断一段内容是由人类创作还是由 AI 生成的。按检测对象分三类:
- 文本检测:判断文章、论文、评论是否由 ChatGPT、Claude、DeepSeek 等大模型生成,这是目前需求最大的一类。
- 图像检测:判断图片是否由 Midjourney、Stable Diffusion、即梦等生图模型生成。
- 视频检测:判断视频是否由 Sora、Veo 等文生视频模型生成,也用于识别 AI 换脸。
谁在用 AI检测?主要是四类人:高校和期刊编辑部(审查论文)、内容平台(过滤低质量 AI 批量内容)、企业审核团队(识别虚假材料),以及大量想"提交前自查"的学生、自媒体作者和职场人。
需要先建立一个关键认知:AI检测给出的不是"判决",而是"概率判断"。它和论文查重不一样,查重是拿你的文本和数据库里的已有文本逐字比对,有就是有;AI检测是分析文本的统计特征和写作风格,给出一个"疑似 AI 生成"的可能性。这个本质区别,决定了后面所有的误判争议。
AI检测的原理:工具是怎么判断的?
主流文本检测工具基本靠四类技术,多数工具是混合使用:
| 技术路线 | 一句话原理 | 弱点 |
|---|---|---|
| 困惑度分析 | 人写的文字用词更"意外",AI 生成的文字倾向选择高概率词汇 | 规范化的公文、报告困惑度天然就低,容易被误判 |
| 突发性(Burstiness)检测 | 人类写作长短句交错、节奏起伏大;AI 生成句子长度和结构更均匀 | 刻意口语化的 AI 文本也能伪装出突发性 |
| 分类器模型 | 用海量"人写文本 + AI 文本"训练一个分类模型,直接输出概率 | 训练数据过时后,对新模型的文本识别率下降 |
| 水印与指纹 | 让大模型生成时嵌入统计特征,检测时读取 | 只对配合的官方模型有效,无法覆盖第三方部署 |
理解了原理,就能明白两件事:
- AI 检测永远是概率游戏。风格特征是统计规律,不是铁证,误判(把人写的判成 AI)和漏判(把 AI 生成的判成人写)都无法降到零。
- 改写可以改变判定结果。既然检测依赖风格特征,那么对文本做深度改写、加入真实细节后,判定结果确实会变化。这也是"降 AI 率"灰色产业存在的原因,本文不推荐使用批量降 AI 工具,后面会讲合规的应对方式。
如果你对"如何区分人和 AI"这个话题感兴趣,可以看看我们之前的图灵测试游戏实战攻略,玩法和这里的检测逻辑异曲同工。
主流 AI 检测工具有哪些?
中文用户常用的工具分两派:
| 工具 | 出品方 | 检测对象 | 收费 |
|---|---|---|---|
| 朱雀AI检测助手 | 腾讯朱雀实验室 | 文本、图片、视频 | 免费(有每日次数限制) |
| 知网 AIGC 检测 | 知网 | 文本(学术论文) | 付费,学校/机构渠道为主 |
| 维普、万方 AIGC 检测 | 维普 / 万方 | 文本(学术论文) | 付费 |
| GPTZero | GPTZero | 文本 | 免费额度 + 付费 |
| Turnitin | Turnitin | 文本(学术) | 机构付费为主 |
| Copyleaks | Copyleaks | 文本,多语言 | 免费额度 + 付费 |
选工具时最容易踩的坑是:用 A 工具检测合格,提交时却被 B 系统判定不合格。学校、期刊、平台各自使用的检测系统不同,对同一段文本的判定可能相差很远。社区里多篇实测文章(如博客园这篇 5 款 AIGC 检测平台对比)报告过同一篇论文在不同平台的检测结果差异超过 30 个百分点。所以检测前先确认你的"验收方"用的是哪套系统,用同款工具自查才有意义。
以免费工具里最常用的朱雀为例,官方公布的 Benchmark 自测成绩相当亮眼:8 个公开基准全部在 96% 以上。
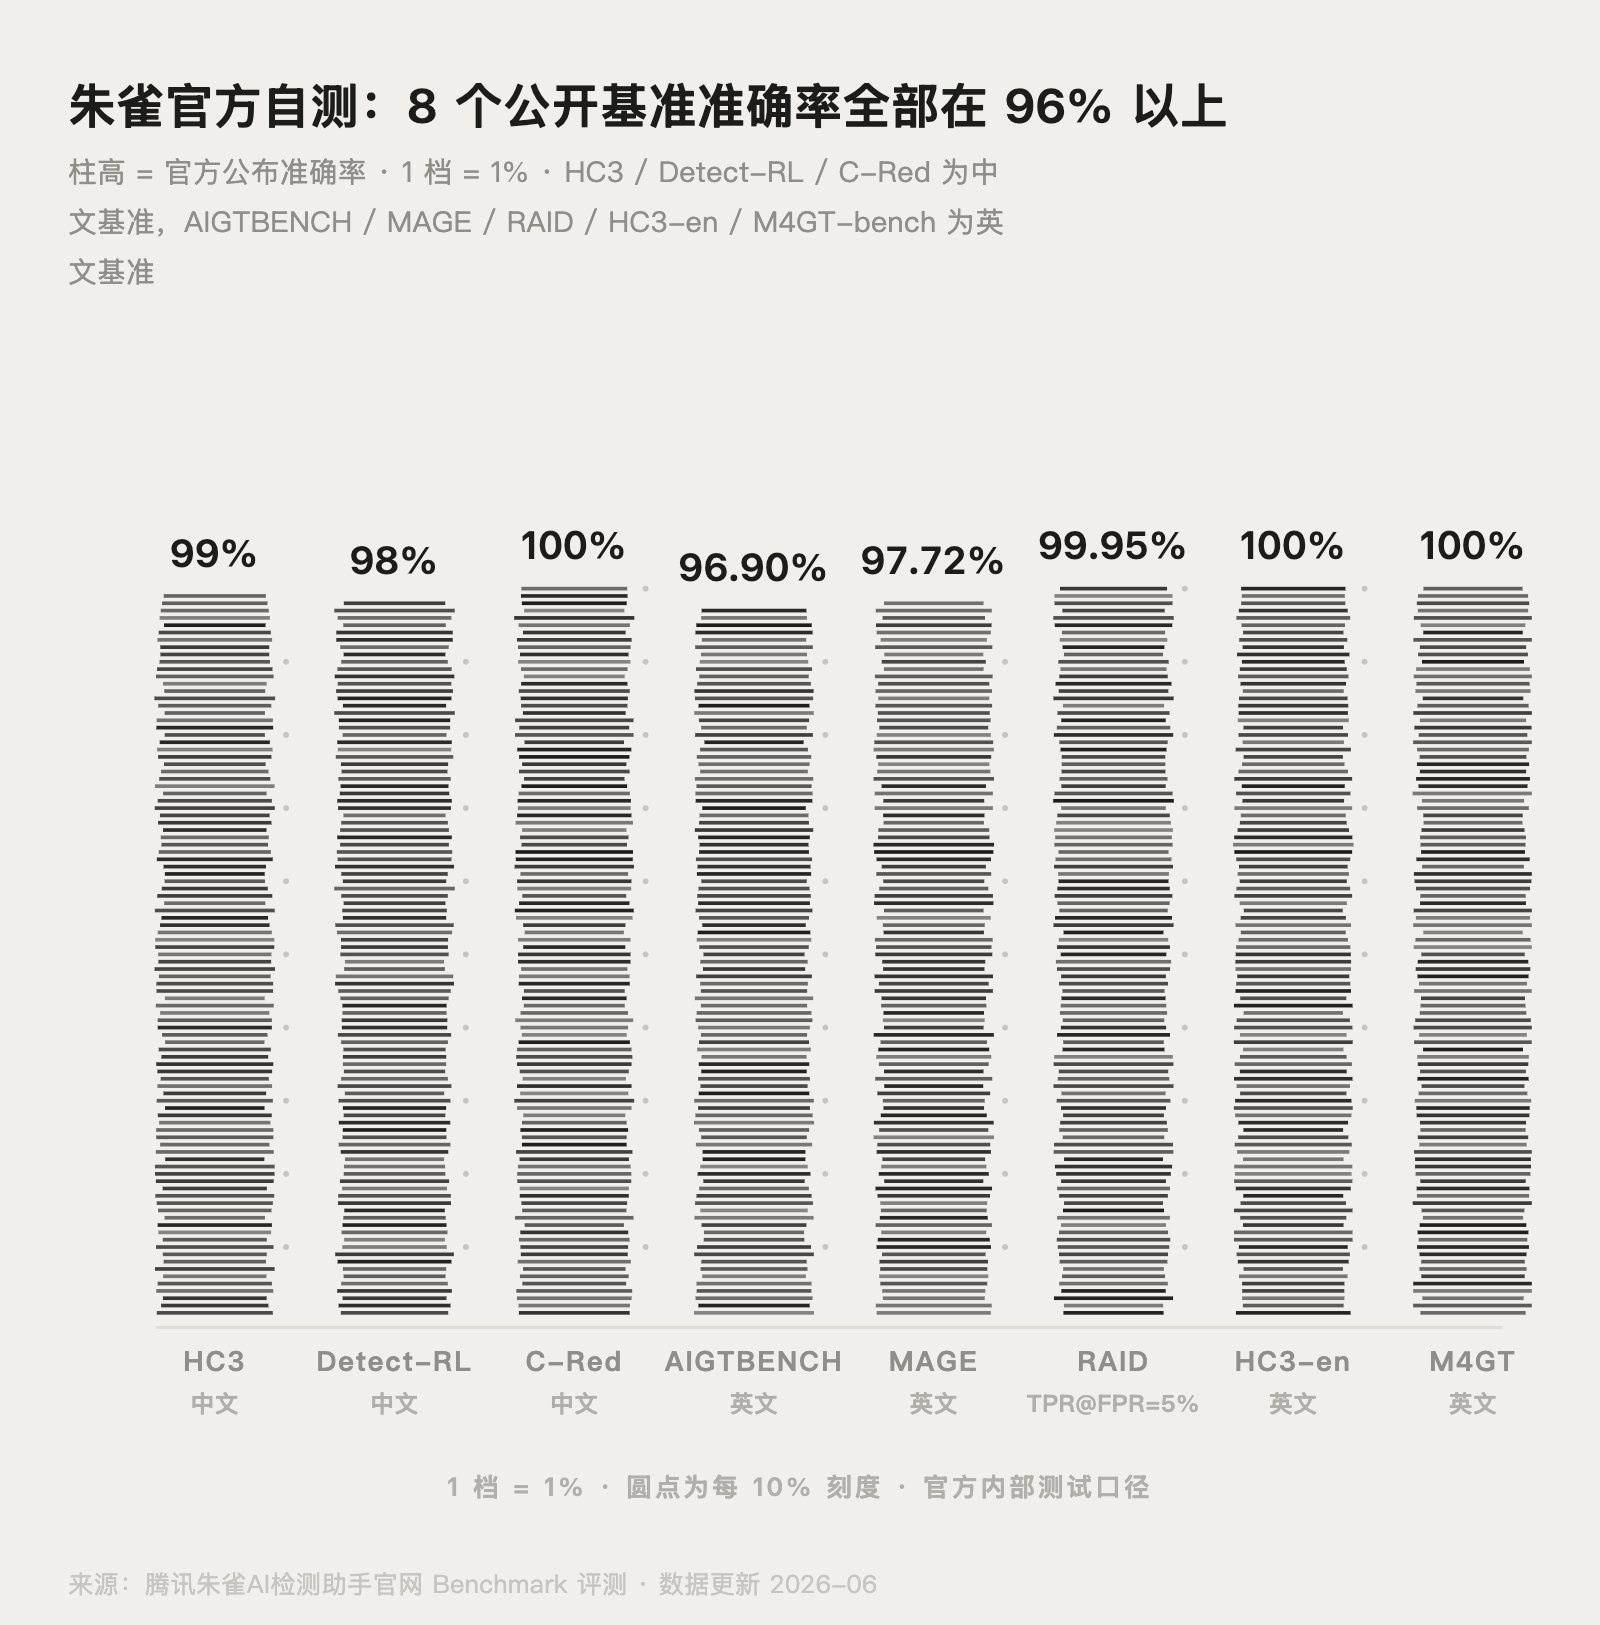
图内数据来源:腾讯朱雀AI检测助手官网 Benchmark 评测,数据更新于 2026 年 6 月。但请注意,这是官方内部测试口径的数字,和你在真实场景里的体验可能差距很大,下一节看实测。
实测:3 组文本放进腾讯朱雀AI检测
光看官方数字不够,我们做了个小实验。测试时间 2026 年 9 月 7 日,工具为朱雀网页版(无需登录,模型更新时间 2026-07-21),检测要求文本长度大于 350 字。
先诚实交代样本来源:3 组样本中,样本一、样本二均由 AI 生成(后者刻意改成了口语化风格),样本三是朱雀官网自带的"人工编写文本"示例。我们没能找到愿意提供原创文本的自然人来当样本,所以本实验验证的是"朱雀能不能稳定认出 AI 文本、能不能认出它自己认可的人工文本",不能直接推出"人写文本的误判率"。
样本一:AI 生成的书面风格文本(426 字)
一篇典型"AI 腔"的说明文:结构工整、逻辑连接词密集、"首先/其次/总之"齐全。
结果:未发现明显的人工创作特征,环形图 100% AI 特征。 判定干脆利落,这类文本正是检测模型训练时见过最多的形态。
样本二:AI 生成后刻意口语化的文本(415 字)
同一主题改写成大白话:加入"说真的""摸鱼不香吗"等口语,句子长短交错,还带了点个人叙事。
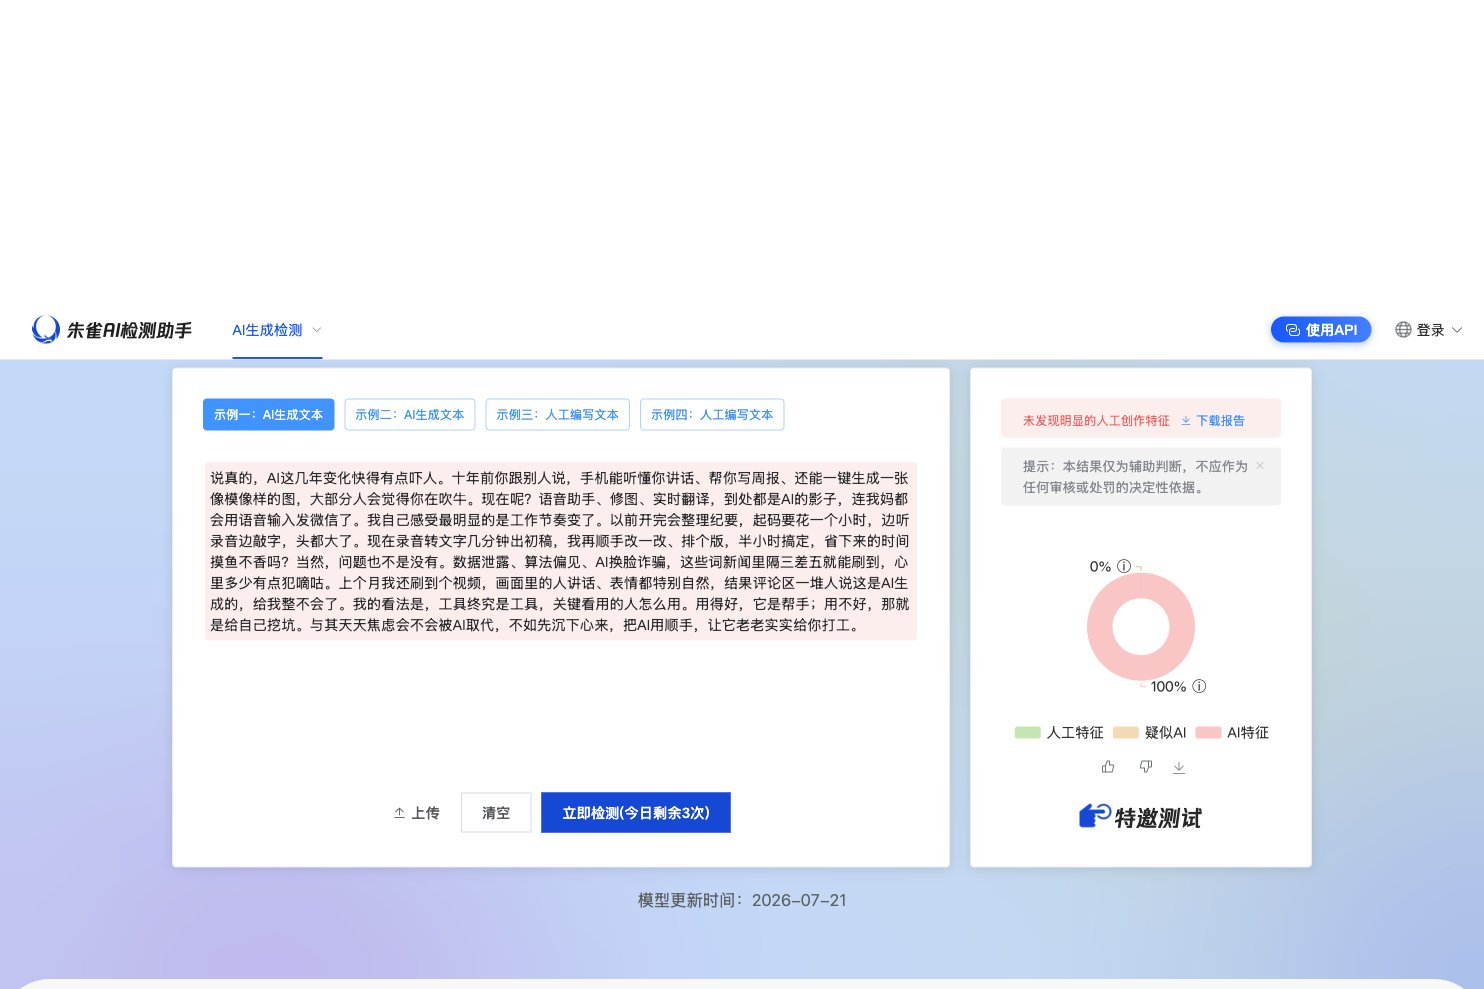
结果:依然是"未发现明显的人工创作特征",100% AI 特征。 这是个有价值的发现:只靠换语气、加口头禅的"表面口语化",骗不过当前的检测模型。模型抓的是更深层的统计特征,不是语气词。
样本三:朱雀官方自带的人工编写示例
直接使用官网提供的"示例三:人工编写文本"(一段写智能跟踪算法的技术文本)。
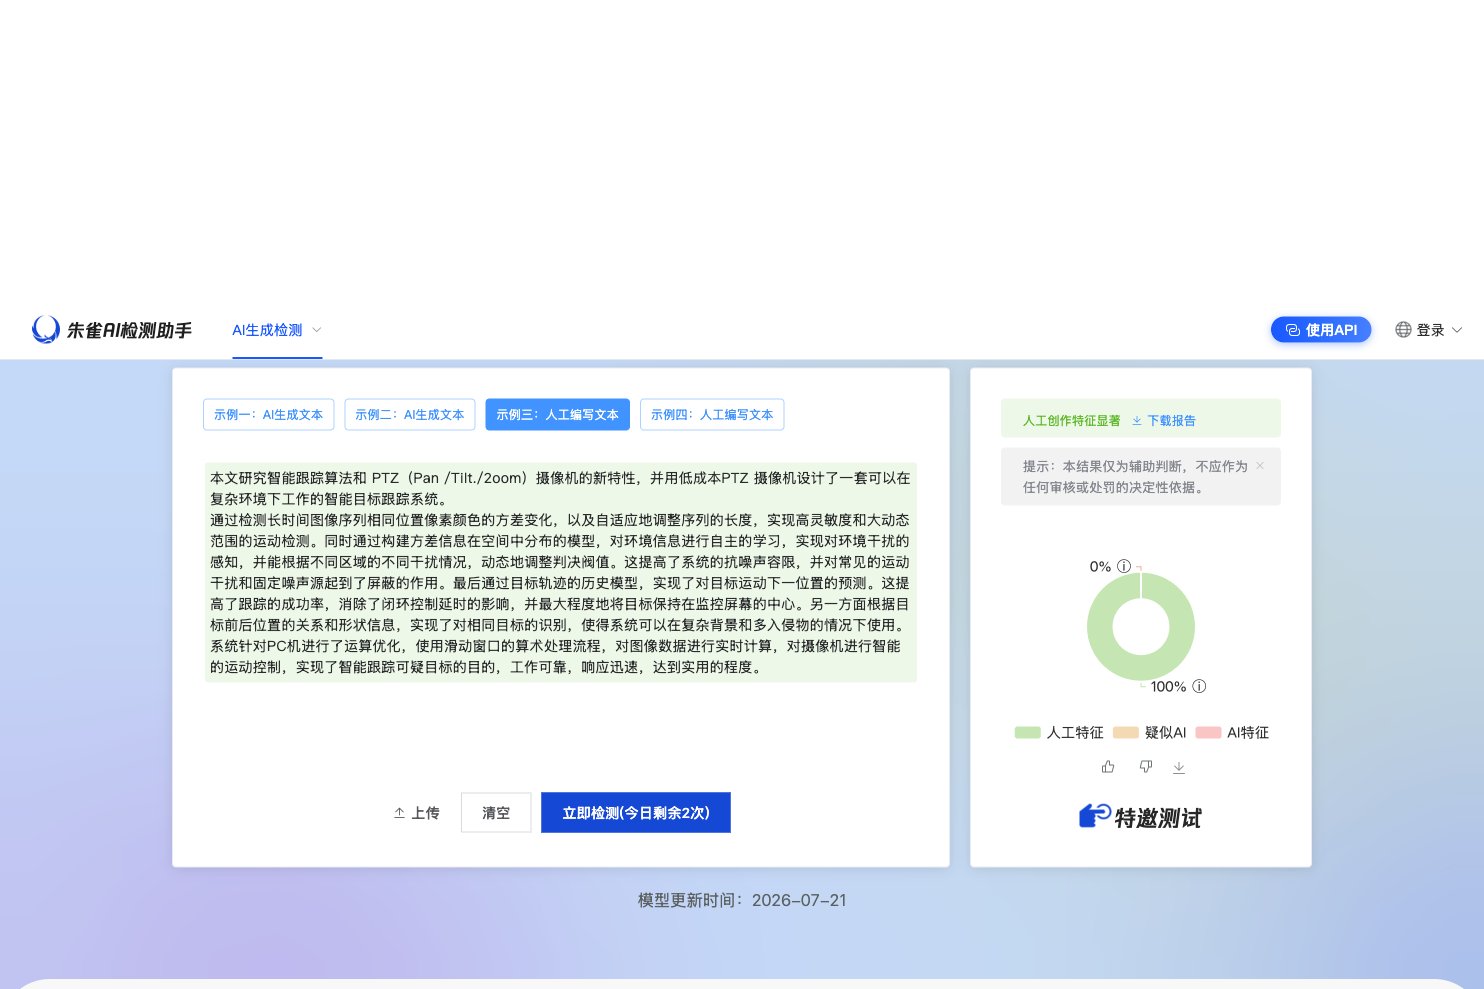
结果:人工创作特征显著,100% 人工特征。 官方示例判定正确。
实测小结
| 样本 | 来源 | 朱雀判定 | 是否符合预期 |
|---|---|---|---|
| 样本一 | AI 生成(书面风格) | 100% AI 特征 | ✅ |
| 样本二 | AI 生成(口语化改写) | 100% AI 特征 | ✅ |
| 样本三 | 官方人工示例 | 100% 人工特征 | ✅ |
三组样本朱雀全部判对,说明它对"典型 AI 文本"和"典型人工文本"的区分能力是可靠的。但真正的难点在于中间地带:AI 辅助后深度改写的内容、人写的模板化公文,这类文本才是误判重灾区。另外别忘了朱雀页面上那行小字:"本结果仅为辅助判断,不应作为任何审核或处罚的决定性依据",官方自己都这么标注了。
AI检测准不准?官方与学术研究怎么说
两份来自"检测方自己"和"学术界"的材料,值得每个用 AI 检测的人知道。
证据一:OpenAI 亲手下线了自己的检测器
2023 年 1 月,OpenAI 发布了官方 AI 文本分类器(AI Text Classifier)。按官方博客公布的评估数据,这款工具在英文"挑战集"文本上的表现是:真阳性只有 26%(AI 生成的文本只有 26% 被正确识别),同时还有 9% 的假阳性(人写的文本被冤枉为 AI)。
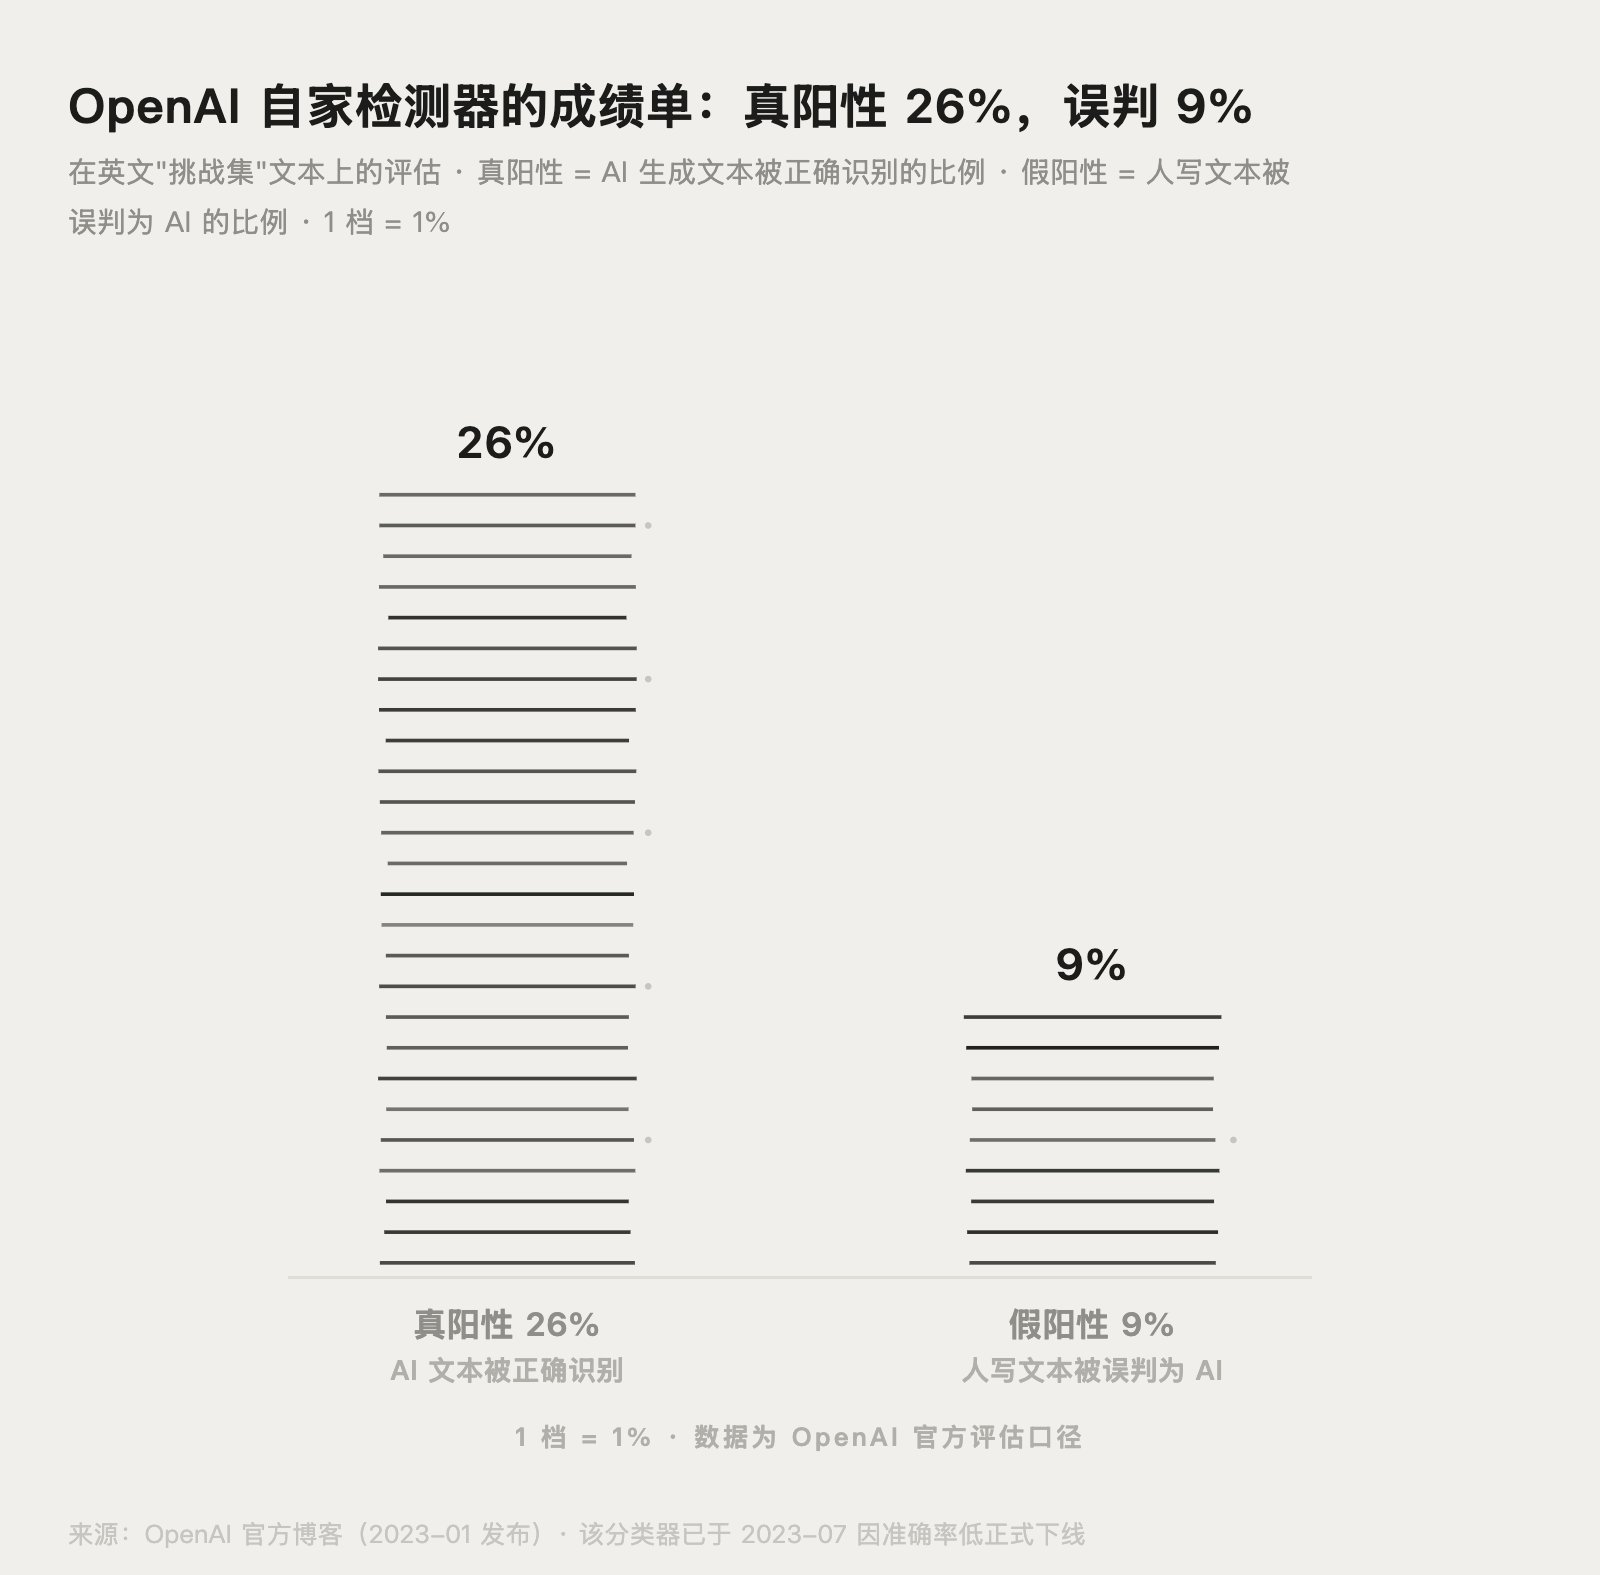
数据来源:OpenAI 官方博客(2023 年 1 月发布)。发布仅半年后,OpenAI 就以"准确率低"(low rate of accuracy)为由在 2023 年 7 月正式下线了这款工具(见 Ars Technica 当时的报道)。连最懂大模型的公司都做不准 AI 检测,这件事本身就说明了技术天花板在哪。
证据二:斯坦福研究证实检测器"欺负"特定人群
斯坦福大学团队 2023 年发表的论文《GPT detectors are biased against non-native English writers》测试了 7 款主流 GPT 检测器,用 91 篇由非英语母语者写的托福作文做样本,结果这些真人写的作文平均 61.3% 被误判为 AI 生成,其中一款检测器的误判率接近 98%;而美国八年级母语学生的作文几乎全部被正确识别(详见斯坦福 HAI 的解读文章)。原因前面讲过:非母语者的用词更"规范"、更可预测,困惑度天然偏低。
把两份材料放在一起,结论就很清楚了:官方宣传的准确率是"理想条件"下的数字,真实场景里,任何 AI 检测结果都需要人工复核。
为什么自己写的内容会被误判成 AI?
这是知乎、CSDN 上被问得最多的 AI 检测问题。结合检测原理和社区里的实测反馈(很多来自文章评论区的一手吐槽),被误判通常踩了下面一个或几个坑:
- 文体太规范。公文、实验报告、文献综述本身就用词标准、句式工整,困惑度低,和 AI 生成特征重叠。
- 重度参考了 AI 输出。先让 AI 生成框架再逐句"仿写",用词习惯已经被 AI 带跑,统计特征自然像 AI。
- 写作过程高度模板化。背模板、套范文写出来的内容,人写和机器生成在特征上难以区分。
- 文本太短。统计特征需要足够长的文本才稳定,一两百字的判定基本不可靠(朱雀要求 350 字以上就是这个原因)。
- 翻译腔。先写中文再翻成英文(或反之),欧化句式在英文检测器里是高风险特征,这正是斯坦福研究里非母语者被大量误判的原因。
- 检测模型更新滞后或阈值偏严。部分工具宁可错杀不可放过,把阈值调得很激进。
如果你是因为"AI 润色"导致文章 AI 味变重,可以看看这篇AI 润色的 5 步正确用法,讲了怎么改写才不会越改越像 AI。
被 AI 检测误判了怎么办?4 步应对
- 先复检。换 2-3 款工具交叉验证(比如朱雀 + 学校指定系统),结果差异大就说明该文本处于模糊地带,单次判定不足为凭。
- 留存写作证据。文档的编辑历史、带时间戳的草稿、参考资料的浏览记录、写作过程截图,都是申诉时的硬材料。平时用支持历史版本的工具写作,关键时刻能救命。
- 走正式申诉。高校和期刊普遍有人工复核流程,朱雀官网也明确标注检测结果"不应作为任何审核或处罚的决定性依据",引用这一点。提交写作证据 + 要求人工评审。
- 事前预防。如果用 AI 辅助写作,把 AI 输出当素材而不是成品:用自己的话重写、加入只有你知道的细节和判断、控制直接引用比例。这既是合规要求,也是真正降低 AI 特征的唯一健康方式,批量"降 AI 工具"改出来的文本通顺度差、可读性崩坏,且在部分学校属于违规。
给内容平台作者多说一句:各平台对 AI 生成内容的标注和限制规则不同,发布前先读平台规则,该声明 AI 辅助就声明,别赌检测概率。
总结
AI 检测已经成了内容行业的标配基础设施:学校用它审论文、平台用它过滤批量 AI 内容,普通用户也需要用它自查。但它的本质是概率判断而非铁证,OpenAI 自己的检测器 26% 真阳性的"成绩单"和斯坦福 61% 误判率的研究都说明:检测结果只能当参考,不能当判决。给你的三条行动建议:检测前确认验收方用的哪套系统;重要内容永远保留写作过程证据;用 AI 辅助写作时把它当素材深度重写,而不是找工具批量"降 AI"。
本文由 AI345 团队撰写,实测数据取自 2026 年 9 月 7 日腾讯朱雀网页版实测,官方数据引自朱雀官网与 OpenAI 官方博客,引用关系已在文中标注。转载请注明出处。
常见问题
AI检测和论文查重是一回事吗?
答:不是。查重是把你提交的文本与数据库中已有文献逐字比对,检测的是"抄袭";AI检测是分析文本的写作风格和统计特征,推测的是"是否由 AI 生成"。前者有明确数据库依据,后者是概率判断,两者结果互不影响。
AI检测工具标称的准确率可信吗?
答:要打折看。官方准确率(如朱雀宣称文本检测超 92%)来自内部测试的理想条件;OpenAI 自家检测器真阳性仅 26% 并因此下线、斯坦福研究显示非母语写作被 61% 误判,都说明真实场景表现会明显缩水,结果必须人工复核。
完全是自己写的,为什么 AI 检测率还是很高?
答:通常是文体问题。规范化的公文、报告、学术论文用词可预测、句式工整,统计特征与 AI 文本高度重叠;参考 AI 输出改写、套模板写作、翻译腔也会推高判定。可换工具复检并保留写作过程证据用于申诉。
换一个 AI 模型生成,能躲过检测吗?
答:基本不能。主流检测工具(如朱雀)宣称覆盖 GPT、Claude、DeepSeek、混元等常见大模型,社区实测中多模型混写的内容同样被识别。检测模型也在随新模型持续更新,靠换模型赌漏检不可靠。
把 AI 生成的文本改写后,检测得出来吗?
答:取决于改写深度。我们的实测显示,只换语气、加口语词的表面改写,朱雀仍判定 100% AI 特征;但经过融入真实细节的深度重写后,统计特征会明显变化。深度"降 AI"本质上是在生产一篇新文章,依赖批量降重工具既影响质量,也可能违反学校或平台规定。
往检测工具里贴文本,隐私有风险吗?
答:有,需要自己把关。未发表的课程论文、公司内部材料、涉及个人隐私的内容,贴给任何第三方在线服务前都应谨慎,优先选择支持不登录使用、明确不留存文本的工具,或使用本地部署方案。朱雀网页版未登录即可使用,但每日检测次数有限。
 京ICP备2024094994号-29