
AI 搜索引擎是什么?和传统搜索差在哪,3 分钟讲清
AI 搜索引擎就是「先替你读书,再给你答案」的搜索:输入一个问题,它不给你一排蓝色链接,而是直接给出一段综合后的回答,并在关键句后面附上来源编号。Perplexity、各大模型的联网搜索、搜索引擎里的 AI 概览都属于这一类。这篇用图书馆的比喻讲清它和传统搜索的差别、先搜后答的链路,以及引用来源为什么重要,最后附可复述口径。
AI 搜索是什么:一句话定义
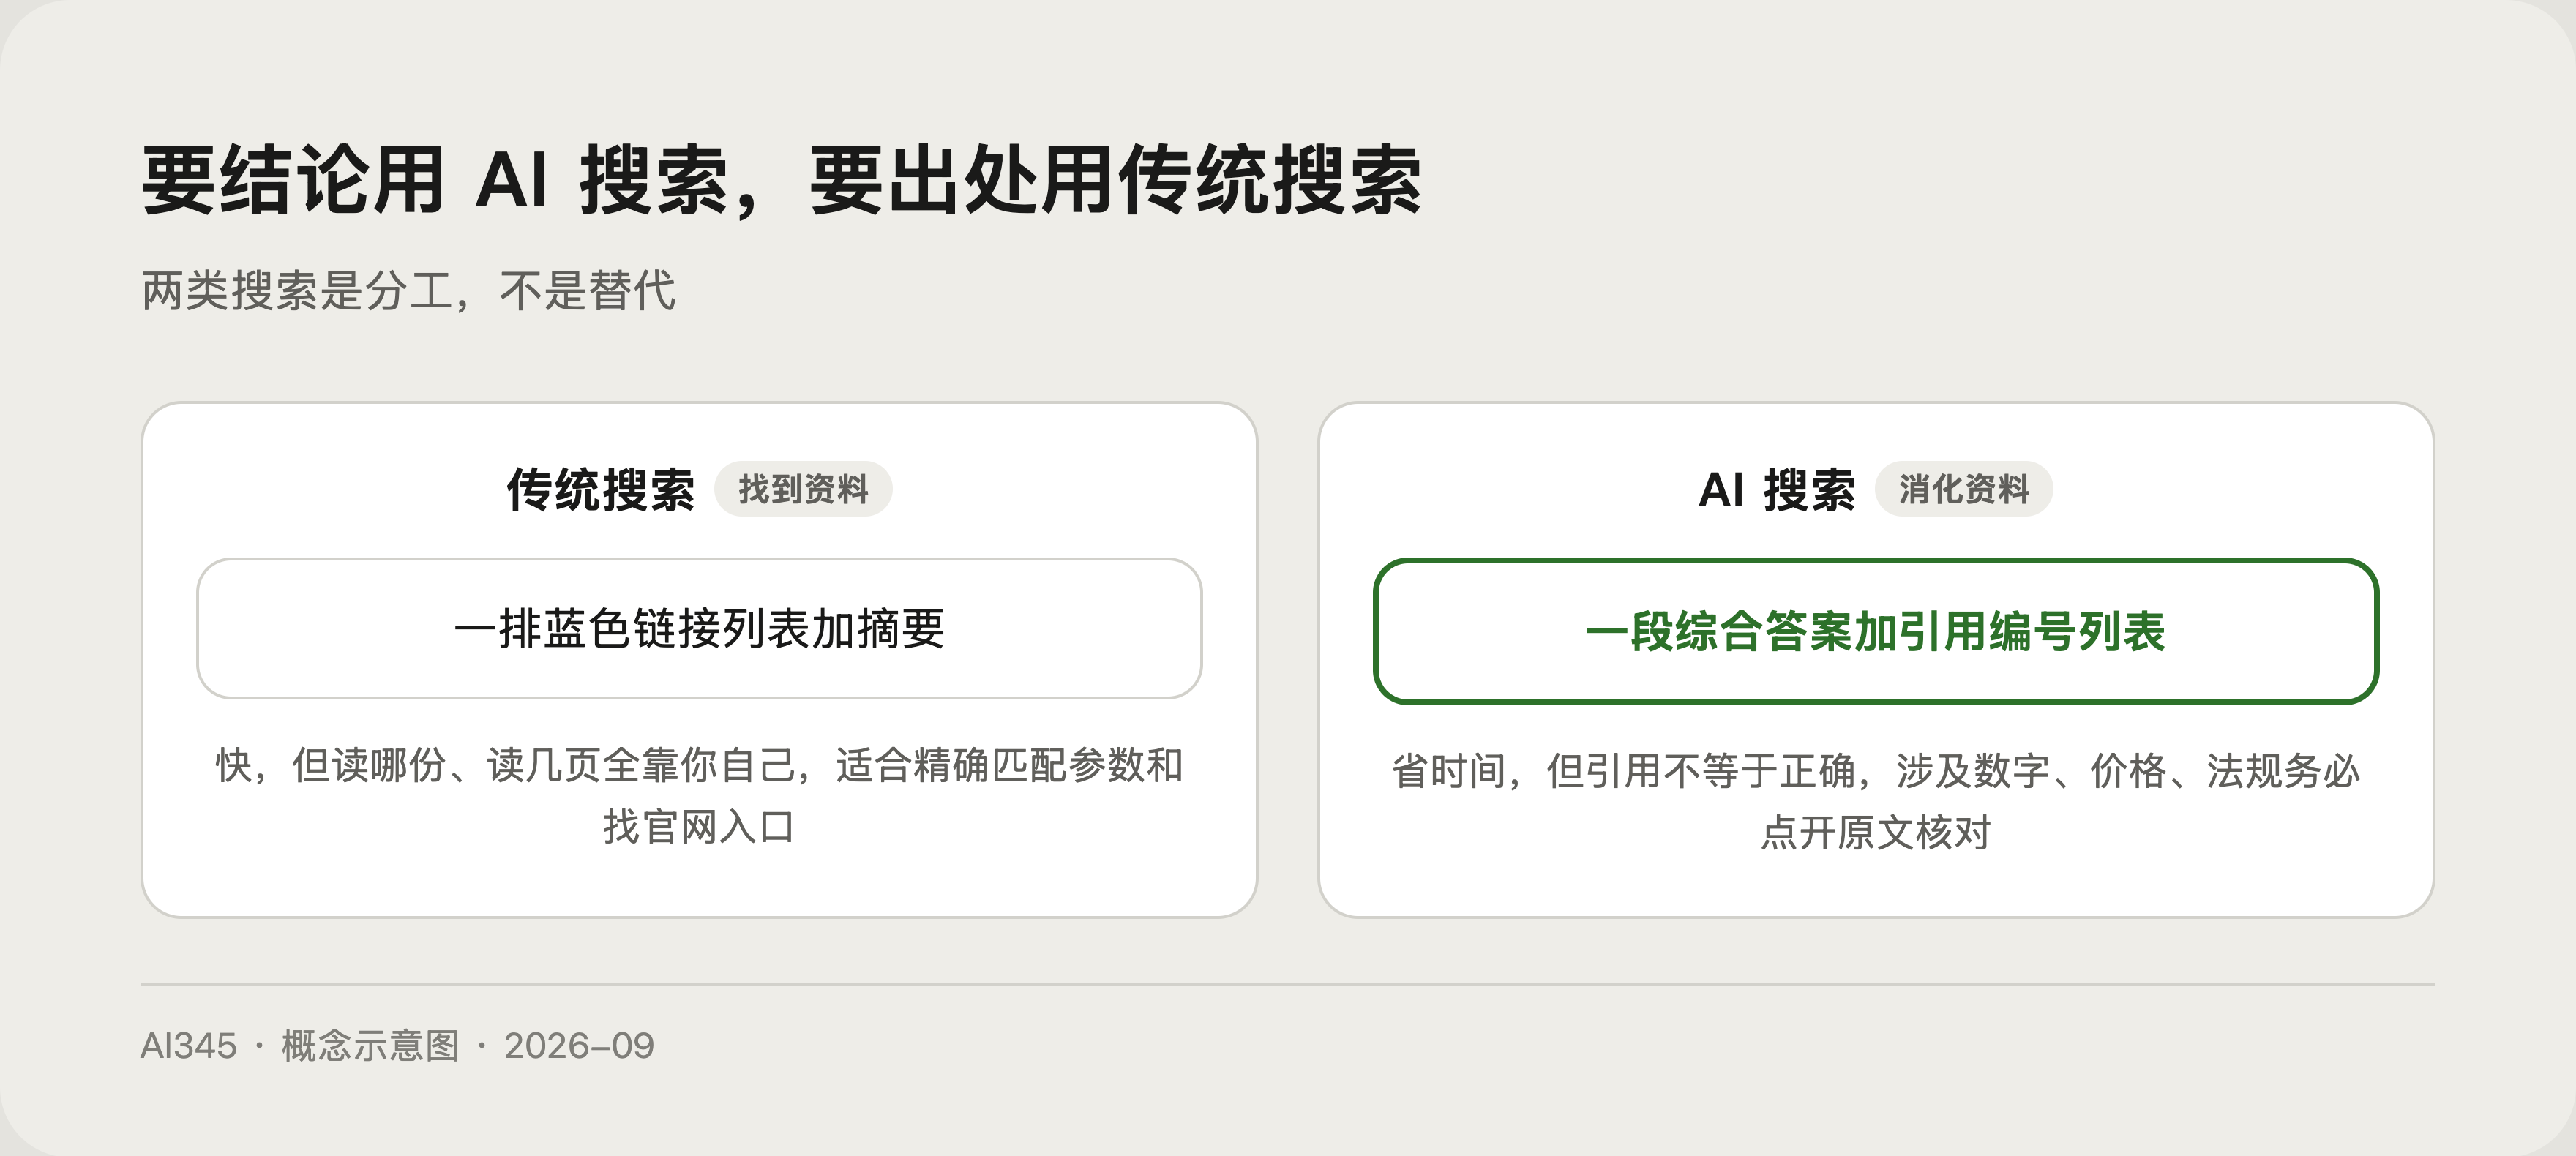
AI 搜索指把大语言模型接到实时搜索结果上的信息获取方式:模型先检索网页,再阅读筛选,最后把多份来源综合成一段直接可用的答案。它和传统搜索不冲突,更像分工:传统搜索负责「找到资料」,AI 搜索负责「消化资料」。
比喻主线:从书单到带脚注的报告
把两种搜索想象成图书馆里的两种服务。
传统搜索像图书管理员:你报书名,他递给你一排相关书目的卡片,读哪本、读几页,全靠你自己。快,但功夫要你自己下。
AI 搜索像研究助理:你提出问题,他跑去书库把相关章节翻一遍,回来给你一份摘要,还附上每条结论出自哪本书哪一页。省时间,但摘要是他写的,他对内容的理解可能出错,所以脚注必须可查。
先搜后答的链路
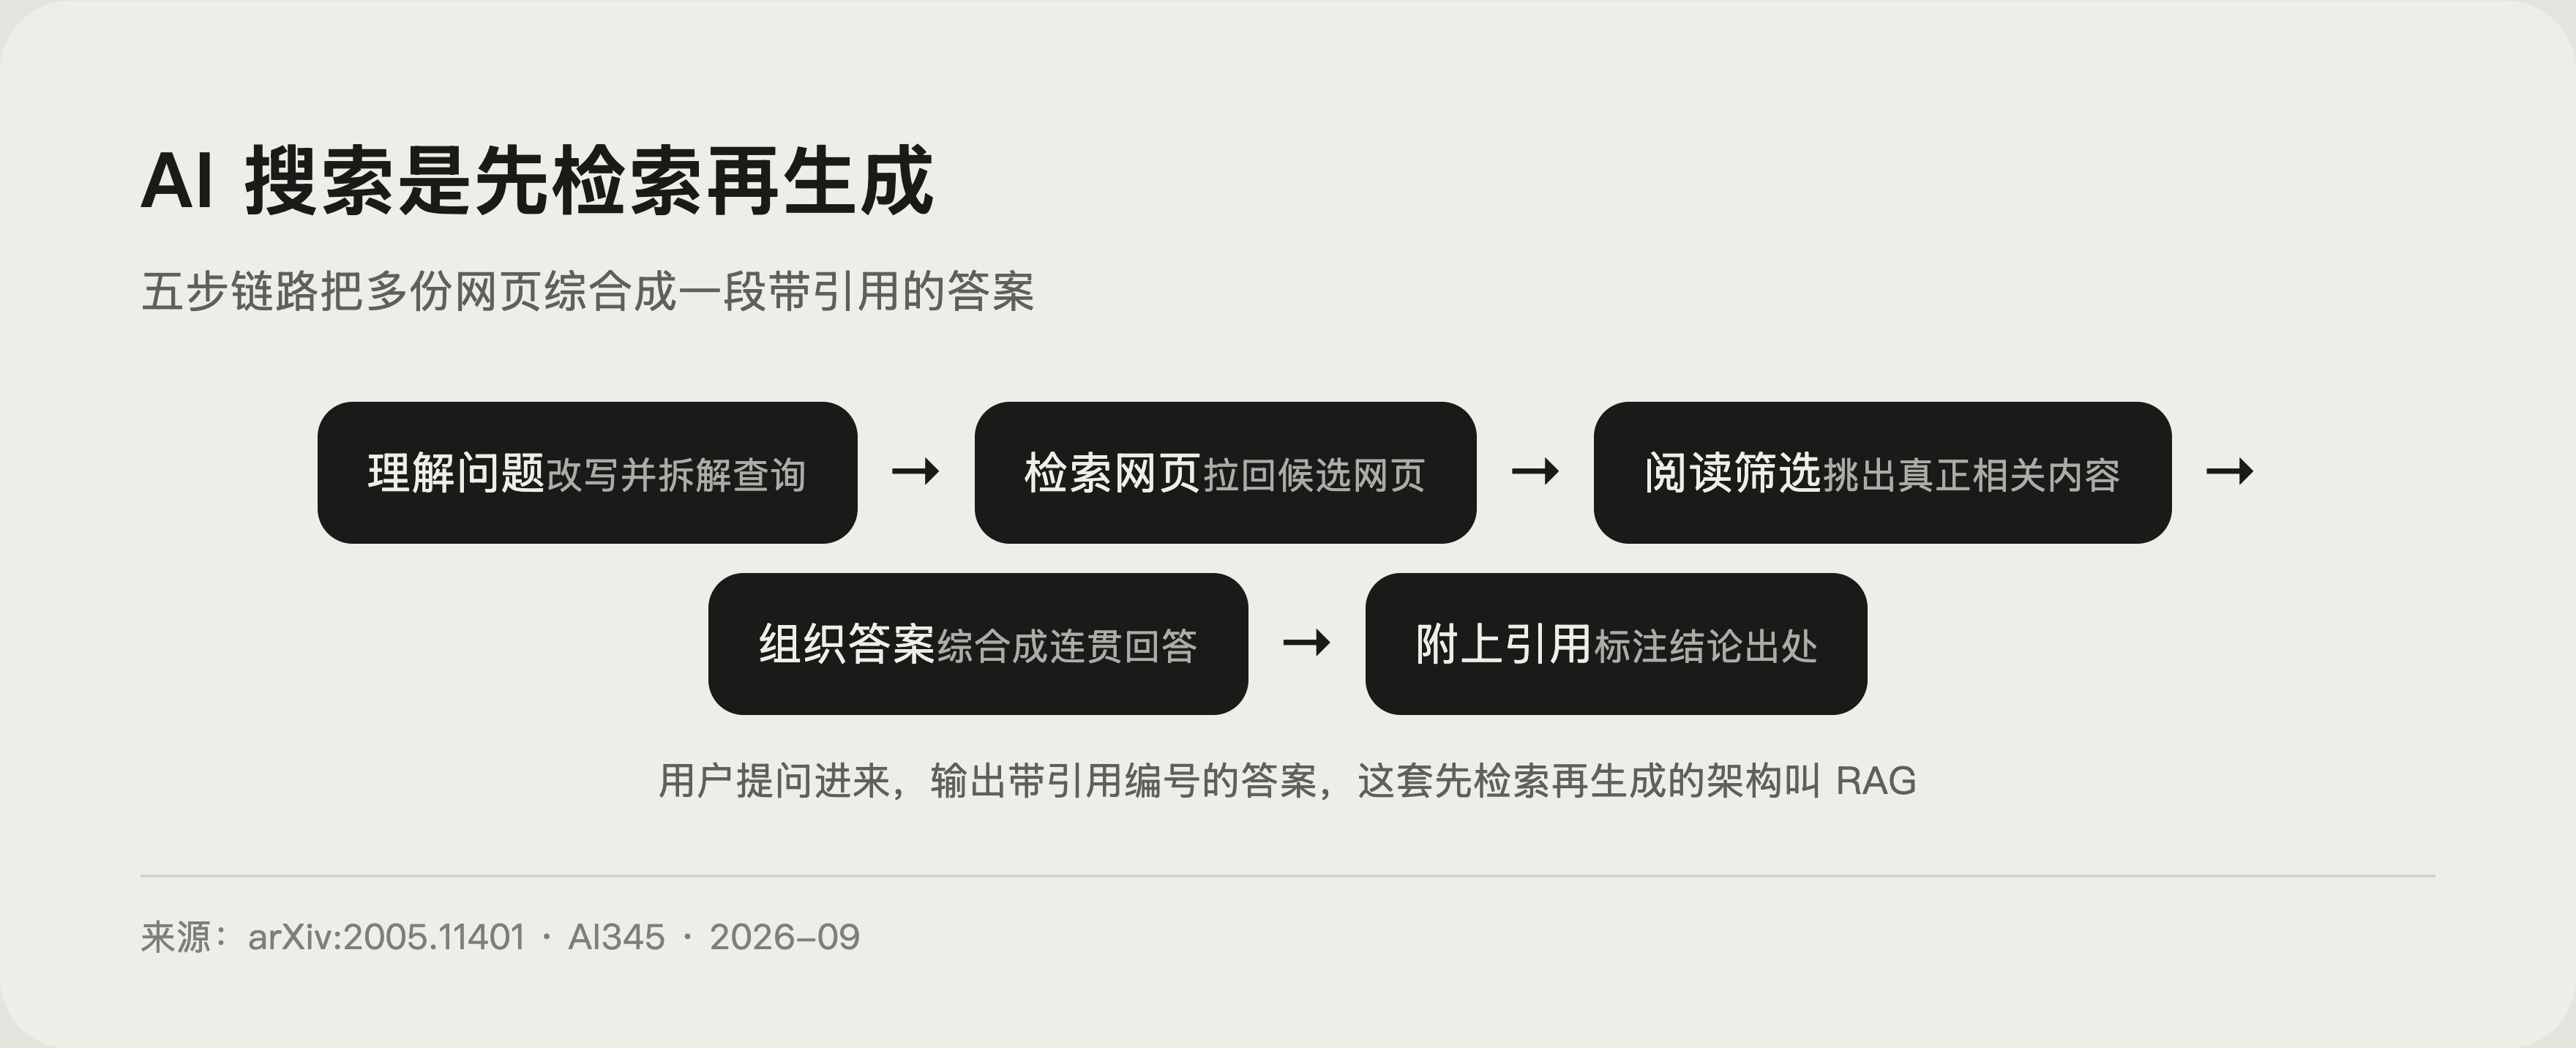
拆开看,AI 搜索的流程大致五步:
- 理解问题:把你的自然语言改写成适合检索的查询,复杂问题还会拆成多个子查询。
- 实时检索:去搜索引擎索引里拉回一批候选网页。
- 阅读筛选:模型通读候选网页,挑出和问题真正相关的内容。
- 组织答案:把多份来源综合成一段连贯回答。
- 附上引用:标注关键结论的出处,供你点开核对。
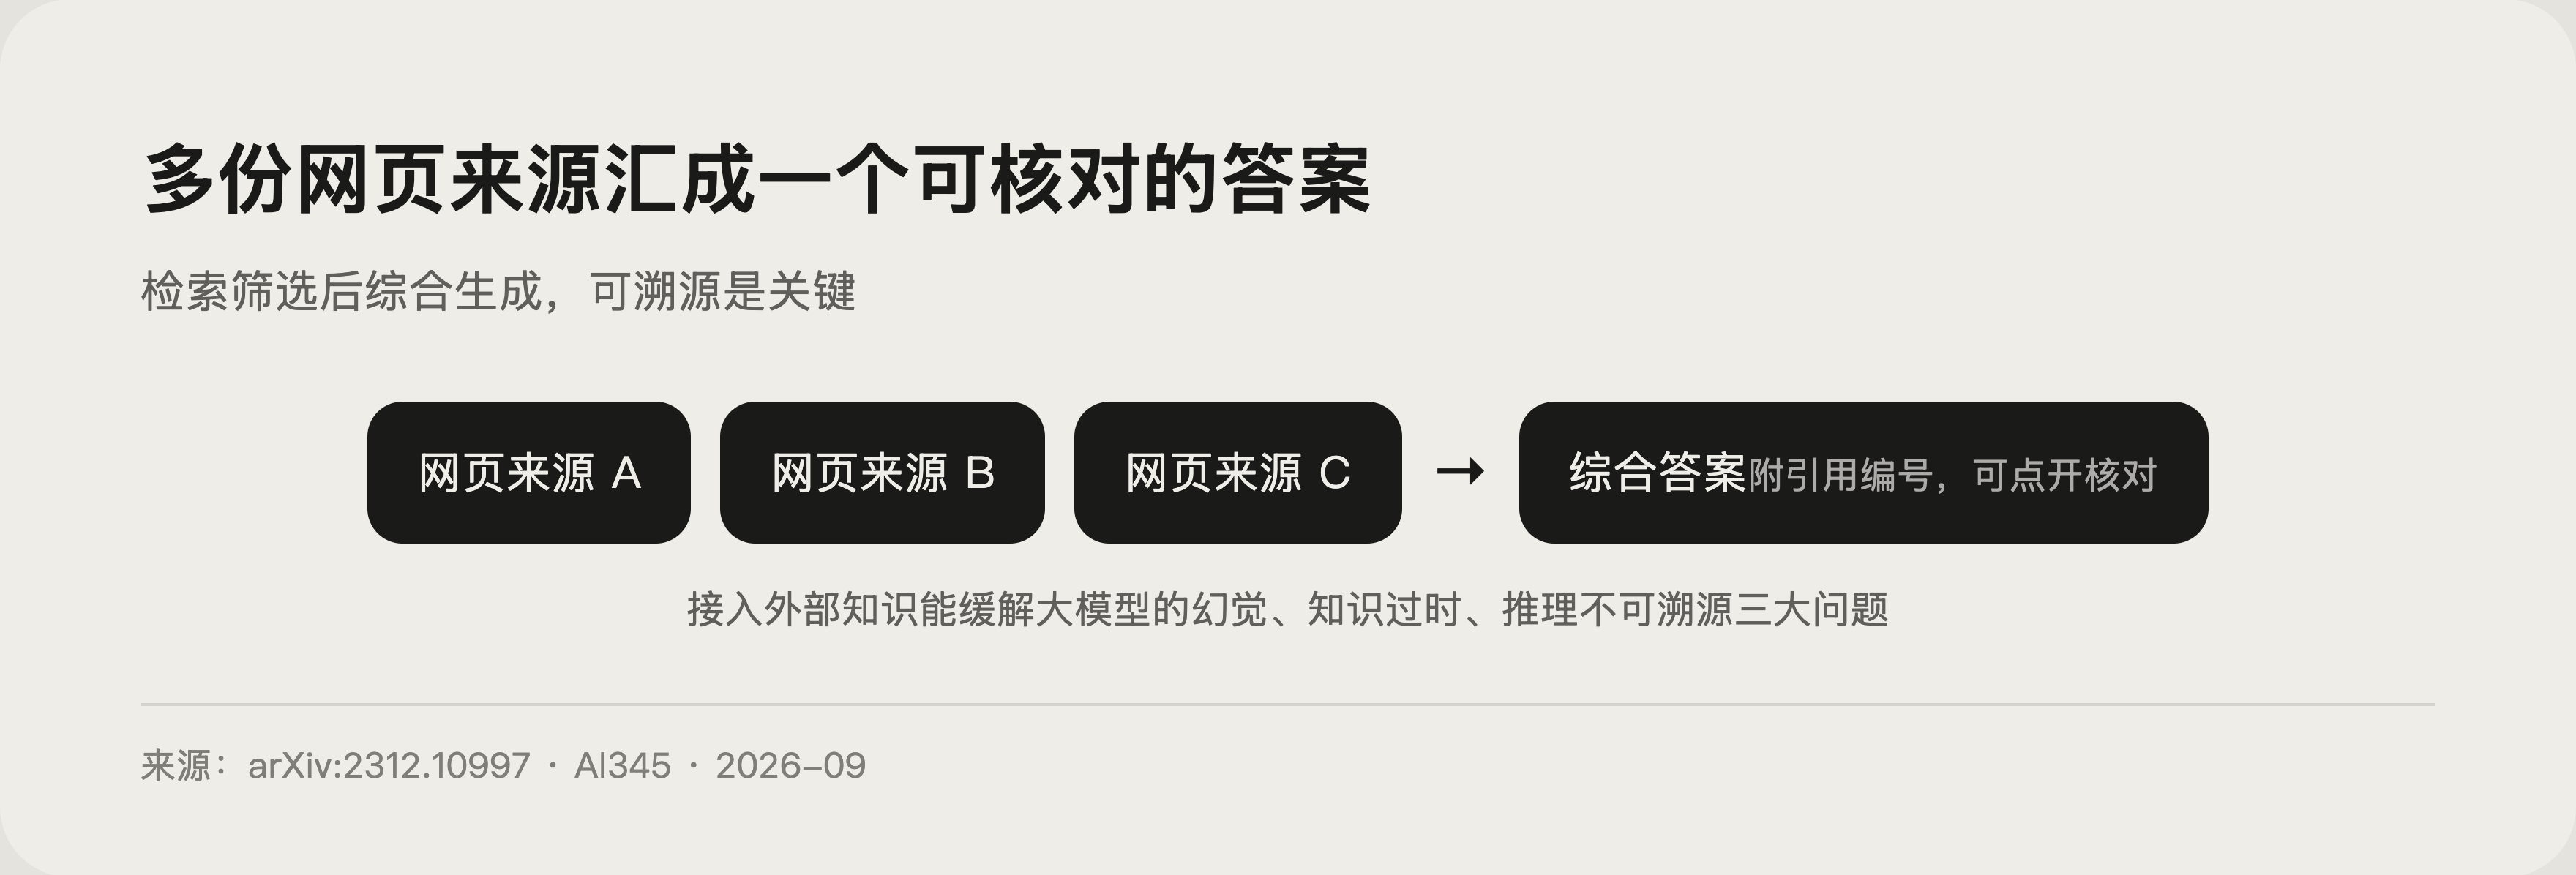
这套「先检索、再生成」的架构,学术上叫检索增强生成(RAG)。奠基论文是 Lewis 等人 2020 年发表、被 NeurIPS 2020 接收的 RAG 论文:模型把参数记忆和外部非参数记忆(当时的实验用维基百科的向量索引)结合,在开放问答任务上超过了纯参数模型。2023 年底的一篇 RAG 综述把价值讲得更直白:接入外部知识能缓解大模型的幻觉、知识过时、推理不可溯源三大问题,而「可溯源」正是 AI 搜索区别于纯聊天机器人的关键。
引用来源为什么重要
引用解决三个问题:一是可验证,结论对不对,点开原始网页就能核对;二是可信任,有出处的回答比凭记忆的回答更经得起追问;三是可持续,内容网站被引用、被带流,才愿意让搜索引擎继续抓取,生态才转得下去。做内容或 SEO 的读者,理解 AI 搜索怎么选源、怎么引用,比研究传统排名更紧迫,可以先读我们讲RAG 是什么的那篇。
但要记住:引用不等于正确。模型可能选错来源、断章取义,甚至引用和结论对不上的网页,这类「编造」的机理和缓解办法,我们在AI 幻觉是什么里拆过。涉及数字、价格、法规这类硬事实,务必点开引用原文核对。
怎么选:两类搜索各管什么
要结论、要跨多份资料的综述,用 AI 搜索快;要原始出处、精确匹配型号参数、找官网入口,传统搜索更稳。日常可以两条腿走路:先问 AI 搜索拿框架,再点引用去原文核实。
觉得搜索结果页的 AI 概览打扰,可以看关闭谷歌 AI 概览的 6 种方法实测。
对 Perplexity 这个赛道感兴趣,可以看Perplexity Portable Computer 详解和它自研的PPLX 27B 本地智能体模型。
一段话讲清 AI 搜索
被问到「AI 搜索和传统搜索差在哪」,可以按这个口径复述:
「传统搜索把网页排序交给用户自己读,AI 搜索用先搜后答的 RAG 链路替用户读:理解问题、检索网页、综合生成、附上引用。两者是分工不是替代,要结论用 AI 搜索,要原始出处用传统搜索。引用来源是 AI 搜索的信任基石,但引用不等于正确,重要结论必须核对原文。」
常见追问有两个。「AI 搜索会取代传统搜索吗」:短期是叠加,入口和商业模式还在演变。「为什么不直接问聊天机器人」:不接实时检索的模型知识会过时还容易编,检索加生成才是完整答案。
常见问题
AI 搜索引擎免费吗?
答:主流产品的网页版基本功能都免费,高阶模型、更多提问次数或深度研究功能通常要订阅,价格按产品差异较大。
AI 搜索引用的来源一定可信吗?
答:不一定。引用只是给了核对入口,模型可能选错来源或断章取义,涉及价格、法规等硬事实时要点开原文确认。
AI 搜索和直接问聊天机器人有什么区别?
答:聊天机器人靠模型参数里的知识回答,可能过时或编造;AI 搜索先实时检索再生成,答案更新、更可溯源,适合时效性问题。
为什么 AI 搜索有时答错数字和日期?
答:可能是检索到的来源本身有误,也可能模型在综合时写错。遇到关键数字,用传统搜索交叉核对两个独立来源再采信。
内容网站怎么更容易被 AI 搜索引用?
答:核心还是把内容做清楚:答案明确、结构清晰、事实有出处,再保证页面可抓取。AI 搜索偏好能直接回答问题的页面,堆砌关键词没有用。
 京ICP备2024094994号-29