
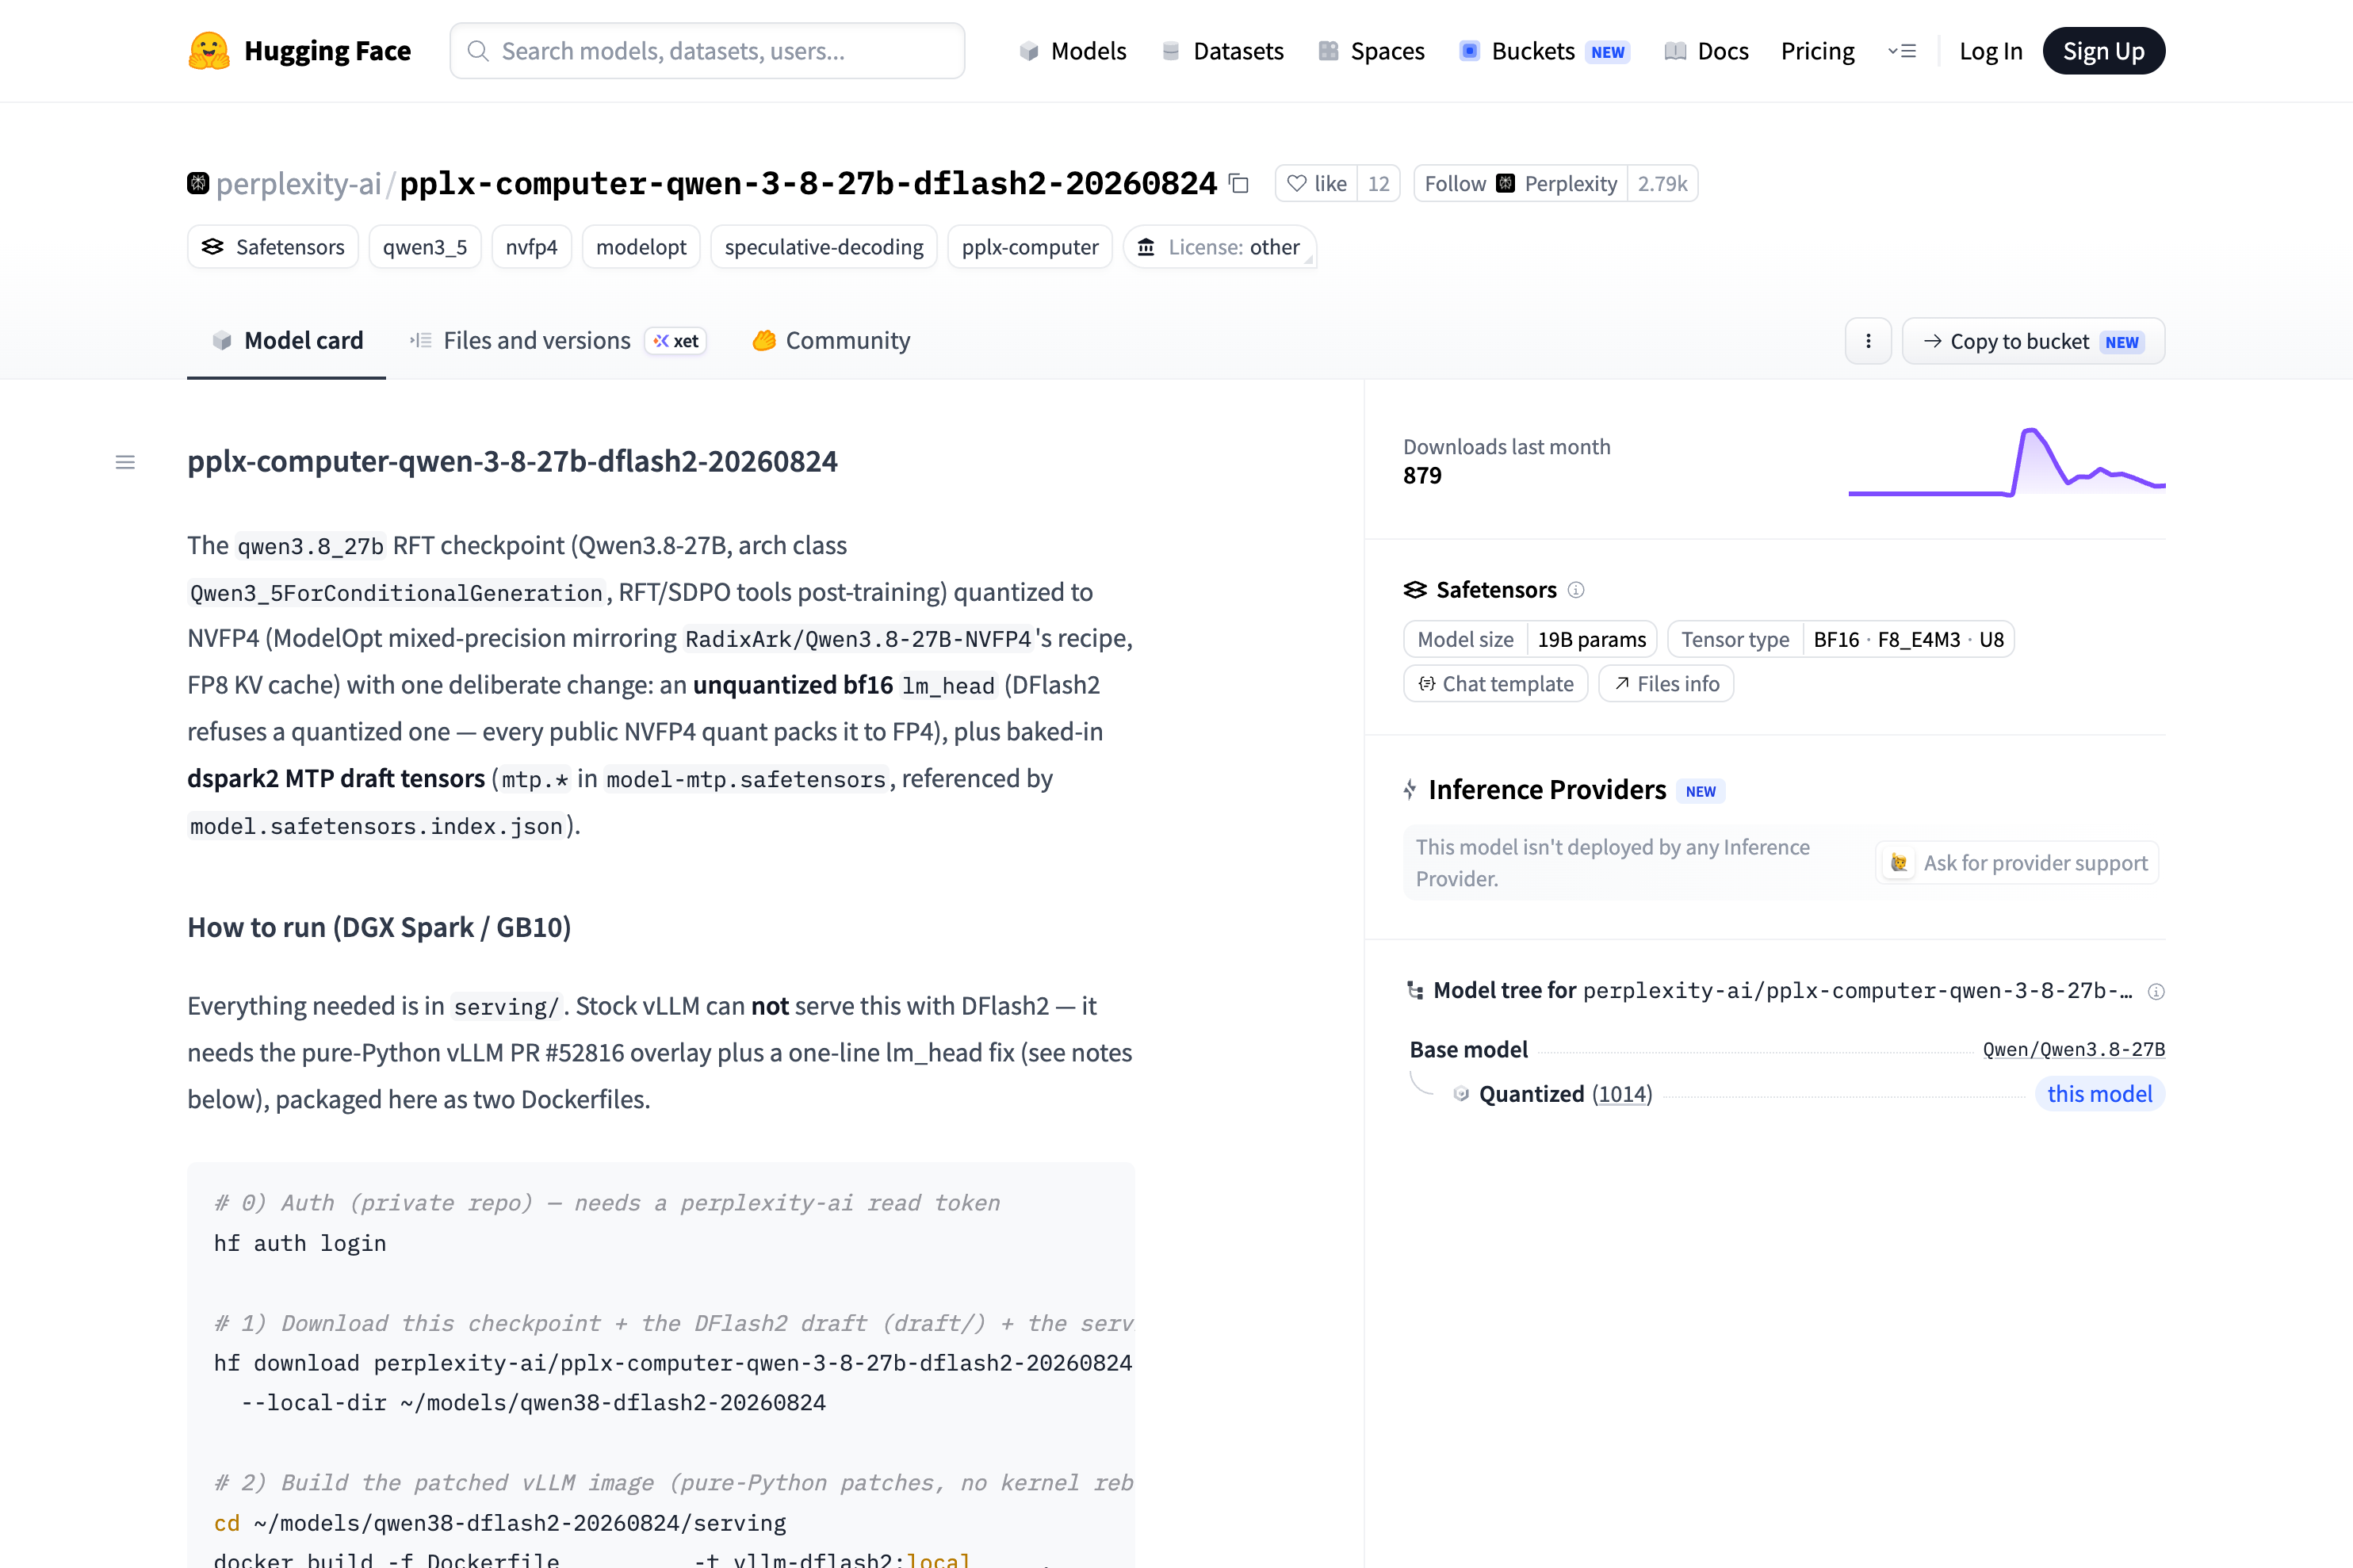
PPLX 27B 是什么?Perplexity 的本地智能体模型
PPLX 27B 不是某个官方注册名,而是社区对 Perplexity AI 在 2026 年 8 月放到 Hugging Face 上的 pplx-computer 系列 27B 模型的通俗叫法。
核心仓库是 perplexity-ai/pplx-computer-qwen-3-8-27b-dflash2-20260824:它以 Qwen/Qwen3.8-27B 为底座做后训练,再用 NVFP4 精度量化,目的是让 27B 级模型在本地设备上以更快的解码速度跑「电脑智能体」(computer use)类工作负载。
官方相关仓库在 2026 年 8 月 19 日到 26 日间密集上线,包括 NVFP4 版和 llama.cpp 可用的 GGUF 版(完整模型列表见 Perplexity 的 Hugging Face 组织页)。
名字拆开看:每个词都是一层技术
这个仓库名信息量很大,逐段翻译成人话:
- pplx-computer:Perplexity 的本地电脑智能体方向,模型服务的是操作电脑、执行多步任务这类场景,不是通用聊天。
- qwen-3-8-27b:底座是 Qwen3.8-27B,模型卡标注经过了 RFT/SDPO 后训练。
- dflash2:DFlash2 投机解码,配套的草稿模型已打包进仓库(vendored 自 incoai/Qwen3.8-27B-DFlash2),是提速的关键。
- nvfp4:权重被量化成 NVFP4 混合精度(ModelOpt 工具链,FP8 KV cache),显存占用大幅下降。
它在技术上做了什么不一样的事
两个细节最能体现工程深度,也是理解「为什么要专门做这个版本」的关键:
第一,lm_head 故意不量化。 模型卡明确写了:输出层 lm_head 保留 bf16 未量化精度,因为 DFlash2 拒绝在量化过的 lm_head 上工作,而市面公开的 NVFP4 量化版几乎都把它压到了 FP4。为了在 vLLM 里正确加载这个「例外」,他们还得打上 vLLM PR #52816 的补丁并修一个 lm_head 的类型判断问题,仓库里直接给了两个 Dockerfile。
第二,DFlash2 比内置 MTP 快约一倍。 权重里虽然烘焙了 dspark2 MTP 草稿张量,但官方实测 MTP k=7 虽然接受率相近,串行草稿解码要慢约 2 倍,所以推荐走 DFlash2 路径(投机解码一次生成 7 个 token 候选)。
和原版 Qwen3.8-27B 是什么关系
不是替代关系,是「专用化改装」关系:Perplexity 拿 Qwen3.8-27B 做了后训练和量化部署优化,原版权重照旧在 Qwen 官方仓库。如果你只想在普通设备上跑 27B 级模型,直接用原版或社区量化版更省事,可参考我们的 Qwen3.8-27B 16G 内存 Mac 本地部署实测 和 Qwen3.8-Flash-Next 本地部署教程。
PPLX 版的价值在两点:为本地智能体场景做过任务级后训练,以及整套「量化 + 投机解码」部署方案开源可复用。模型服务能力对比可再参考 OpenRouter 全解 了解多模型调度思路。
谁适合关注它
- 适合:手里有 DGX Spark / GB10 这类设备的本地推理玩家;研究投机解码与 NVFP4 量化部署的工程团队;关注电脑智能体(computer use)落地方向的开发者。
- 不适合:想找一个开箱即用聊天模型的普通用户,没有对应硬件和 vLLM 补丁环境,这个仓库的价值发挥不出来。
给普通用户一个能落地的点:仓库还发了 GGUF 版(pplx-computer-qwen-3-8-27b-dflash2-gguf-20260826),标注支持 llama.cpp 对话,这是消费级用户唯一可能本地体验到的形态。
常见问题
PPLX 27B 是 Perplexity 自研的模型吗?
答:底座是阿里的 Qwen3.8-27B,Perplexity 做的是后训练(RFT/SDPO)、NVFP4 量化和部署工程,属于深度定制而非从零自研。
普通电脑能跑 PPLX 27B 吗?
答:NVFP4 主版本面向 DGX Spark / GB10 级设备且需要补丁版 vLLM;普通设备只能尝试 GGUF 版配合 llama.cpp,体验和性能与官方目标场景有差距。
DFlash2 是什么?
答:一种投机解码技术,用小草稿模型一次提出 7 个候选 token,由主模型并行验证,从而加快解码;它要求主模型输出层保持未量化精度,这也是该仓库保留 bf16 lm_head 的原因。
它免费开源吗?
答:权重公开在 Hugging Face 的 perplexity-ai 组织下,但许可证标注为 other(非标准开源协议),商用前需查看仓库 License 说明;GGUF 版同为该协议体系。
为什么要等 10 分钟才能验证服务?
答:模型卡说明首次启动需要编译计算图,官方建议用 curl 请求 health 接口验证,等待约 10 分钟属正常现象。
 京ICP备2024094994号-29