
Perplexity Decider v1.1 发布:跑分反超 Jev 的开源决策模型
Perplexity Decider v1.1 发布:跑分反超 Jev 的开源决策模型
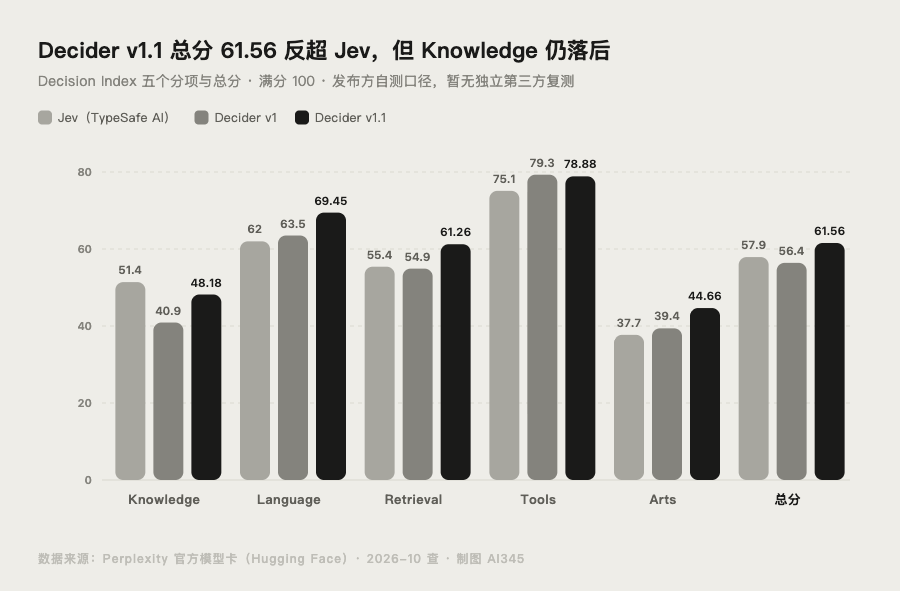
Perplexity Decider v1.1 是 Perplexity 于 2026 年 10 月 7 日在 Hugging Face 发布的开源决策模型 pplx-decider-v1.1-27b。官方模型卡显示,它把 Decision Index 总分从上一版的 56.4 提到 61.56,反超此前领先的决策模型 Jev(57.9)3.66 分。它不写文章、不聊天,只对你给定的内容输出带概率的结构化判断,专门给程序调用。
本文讲清它和 v1 的区别、分项跑分、API 用法、价格变化,以及自托管的硬件门槛。
Perplexity Decider v1.1 是什么
按官方文档的定义,决策模型(decision model)是一类专门做快速、结构化判断的模型。它像多模态语言模型一样能读文本、JSON 和图片,但不写回复、不生成代码、不解释推理,只返回带概率的类型化答案,由你的程序拿这些数字继续处理。
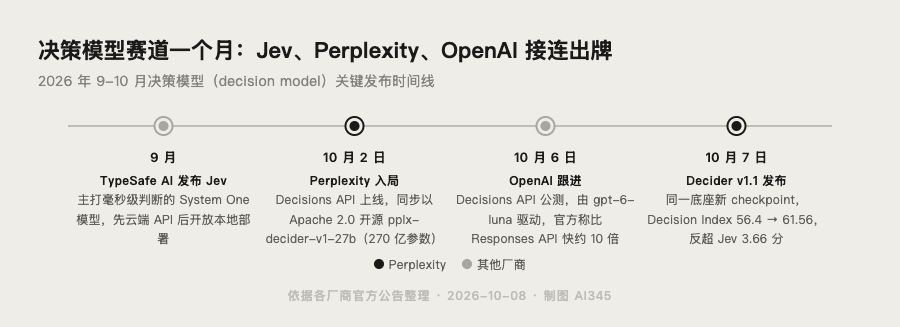
这个模型是 Perplexity 决策产品线的第二代,时间线如下:
- 2026 年 10 月 2 日:Perplexity 发布 Decisions API,同时以 Apache 2.0 协议开源第一代模型 pplx-decider-v1-27b,基于 Qwen3.8-27B 微调,270 亿参数
- 2026 年 10 月 7 日:发布 v1.1,同一底座的新 checkpoint,Decision Index 从 56.4 提到 61.56
官方模型卡说明,这次提升主要来自两处改动:把全注意力层的因果掩码取消(noncausal 模式),以及加入 tasksource 等更多训练数据。
Decision Index 跑分:反超 Jev 3.66 分,Knowledge 仍落后
官方模型卡给出与 Jev 的分项对比。总分按评测套件的权重合成,不是五项简单平均:
| Decision Index 分项 | Jev | v1 | v1.1 |
|---|---|---|---|
| Knowledge | 51.4 | 40.9 | 48.18 |
| Language | 62.0 | 63.5 | 69.45 |
| Retrieval | 55.4 | 54.9 | 61.26 |
| Tools | 75.1 | 79.3 | 78.88 |
| Arts | 37.7 | 39.4 | 44.66 |
| 总分 | 57.9 | 56.4 | 61.56 |
三个值得注意的点:
- v1.1 在 Language、Retrieval、Arts 三项提升明显,总分反超 Jev 3.66 分
- Tools 分项反而比 v1 微降,从 79.3 落到 78.88
- Knowledge 只有 48.18,仍是六项里最低,且低于 Jev 的 51.4,知识类判断不是它的强项
另外要提醒:此前 v1 模型卡上的 11 项基准(总体 85.71%,对比 Jev 84.51%、原底座 Qwen3.8-27B 的 74.76%)共 7210 条样本,全部是 Perplexity 自测,目前没有独立第三方复测。Decision Index 榜单托管在 Hugging Face 上,可以自己去核对。
Decider v1.1 怎么用:三类问题,一次问 128 个
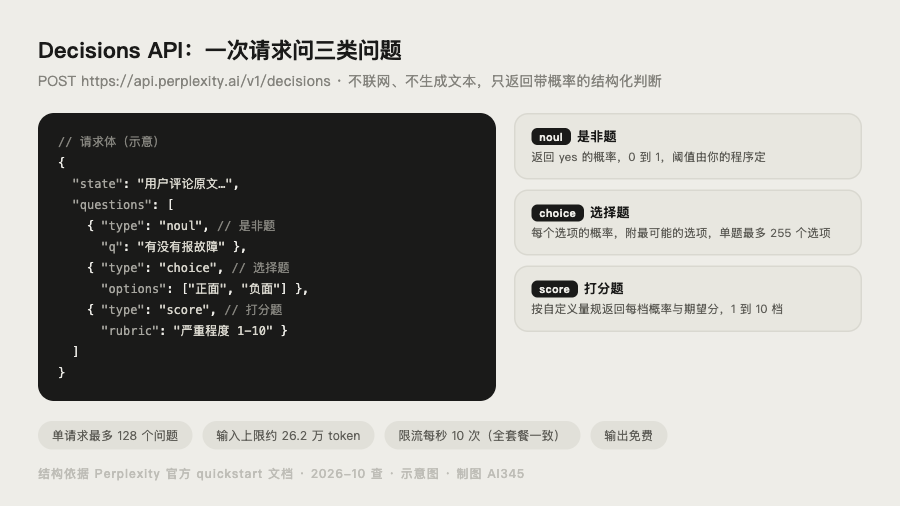
调用入口是 Decisions API:向 POST https://api.perplexity.ai/v1/decisions 发请求,用 Authorization: Bearer 传 Perplexity API key,任何套餐都能用,也可以走 OpenRouter 调用;国内网络连不上 Perplexity 的话,先看这篇 Perplexity 国内直连实测。
它只认三类问题,每类返回的东西不一样:
| 问题类型 | 你问什么 | 返回什么 |
|---|---|---|
| noul | 是非题 | yes 的概率,0 到 1 |
| choice | 从你定义的选项里选 | 每个选项的概率,加最可能的选项 |
| score | 按你定义的量规打分 | 每一档的概率,加期望分 |
官方文档给出的请求限制:
- 一次请求最多 128 个问题,针对同一段内容
- choice 单题最多 255 个选项,score 单题 1 到 10 档
- 输入上限约 26.2 万 token,state、图片、所有问题都算在内,请求体最大 32 MiB
- 图片只收 PNG、JPEG、WebP 的 data URL,不会去抓 http 链接;每图上限 2048 个 32x32 像素块,实测约每百万像素计 1000 输入 token
- 限流为每组织每秒 10 次请求,所有套餐一致
延迟方面,官方 9 月 30 日的测试是:几百 token 两秒内返回,9 万 token 约 5 秒,19 万 token 约 14 秒,接近上限约 23 秒,超时返回 504。
官方 quickstart 的示例很直观:传入一条商品评论,一次请求同时问「有没有报故障」(noul)、「整体情绪是正面还是负面」(choice)、「问题有多严重」(score),三个答案一次拿回来。
想自己部署的话,模型仓库自带推理实现,用 DecisionModel.predict 调用即可。注意全注意力层是非因果模式,默认的因果推理跑不出评测成绩,必须用官方实现并施加一次校准温度。
免费能用吗:API 一周降价一半,自托管要 49 GiB
价格是这个模型最敏感的部分,而且一周内变过一次:
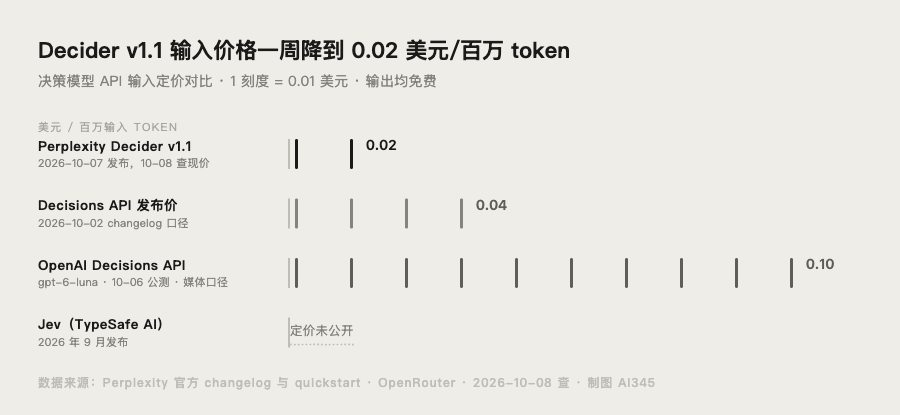
- 10 月 2 日发布时,官方 changelog 写的输入价格是 0.04 美元/百万 token
- 10 月 7 日 v1.1 上线后,官方文档的现价是输入 0.02 美元/百万 token,输出免费,没有单次请求费
OpenRouter 页面同样是输入 0.02 美元、输出 0 美元,上下文 262K,目前只有 Perplexity 一家托管。按这个费率,处理 100 万字左右的中文内容大约花 0.02 美元,批量分类的成本确实很低。
想免费用模型本身,可以走开源权重:Apache 2.0 协议。但门槛不低:需要 Python 3.12 以上、CUDA GPU,权重本身约 49 GiB,还要留工作内存,v1.1 的模型卡还注明需要认证访问该仓库。v1 权重月下载 1657 次,v1.1 上线一天约 170 次,都是开发者量级。
一句话总结:调用很便宜,自己部署则需要一张像样的卡。
和 Jev、OpenAI 比怎么样
决策模型在 2026 年秋天突然成了赛道,放到一张表里看:
| Perplexity Decider v1.1 | Jev(TypeSafe AI) | OpenAI Decisions API | |
|---|---|---|---|
| 发布时间 | 2026 年 10 月 7 日 | 2026 年 9 月 | 2026 年 10 月 6 日公测 |
| 权重 | Apache 2.0 开源 | 后开源 | 未开源 |
| 输入价格 | 0.02 美元/百万 token | 云端 API 付费 | 0.10 美元/百万 token(媒体口径) |
| Decision Index | 61.56 | 57.9 | 未上榜 |
两个观察:
- Decisions API 的 noul、choice、score 三个题型命名与 Jev 完全一致,接口形状明显是对标 Jev 设计的。Jev 是 TypeSafe AI 9 月发布的主打毫秒级判断的模型,先做云端 API,后开放了本地部署,上手可以看这篇 Jev API 调用教程
- OpenAI 在 10 月 6 日跟进公测 Decisions API,由 gpt-6-luna 驱动,官方称速度约为 Responses API 的 10 倍,只收输入费;此前头条的报道还提到 AWS、Cloudflare 也推出过同类模型
一周之内两家大厂接连入局,说明「分类、路由、打分」这类高频小判断,已经被当成 Agent 降本的确定性方向。
先别急着上生产:社区反馈与验证建议
这个模型太新,第三方声音还很少。Hacker News 上只有一条 10 月 7 日的模型卡分享帖,0 评论;Reddit 的 r/PerplexityAI 里暂时搜不到相关讨论。所有跑分目前都是发布方自报,这是评估它时最需要记住的一点。
如果你打算接入,建议按这个顺序验证:
- 取一段有真实标注的业务数据,比如 500 条已分好类的客服工单,人工标注结果作为对照
- 用 noul 或 choice 跑一遍,统计准确率和概率校准情况,再定阈值
- 高置信度的走自动处理,低置信度的留给人工,先分流再逐步放开
这也和 AI 邮报等媒体的观点一致:概率只是判断信号,能不能直接当自动执行的条件,要用你自己的数据说话,别拿官方榜单分数当生产保证。
常见问题
Decider v1.1 和 v1 有什么区别?
答:同一个 Qwen3.8-27B 底座的新 checkpoint,主要差别是取消了全注意力层的因果掩码、训练数据加入 tasksource 等,Decision Index 从 56.4 提到 61.56。API 调用方式不变,把模型名换成 pplx-decider-v1.1-27b 即可。
Decider v1.1 免费吗?
答:模型权重按 Apache 2.0 开源,自己下载部署不收授权费,但 API 调用按输入 0.02 美元/百万 token 计费,输出免费。自托管还需要约 49 GiB 权重显存加工作内存的 CUDA GPU,这部分成本自理。
Decision Index 是什么?61.56 算高吗?
答:这是托管在 Hugging Face 上的决策模型评测套件,覆盖知识、语言、检索、工具、艺术五个分项,按权重合成总分。61.56 是目前公开成绩里最高的,比 Jev 高 3.66 分,但属于官方自报,暂无独立复测。
它和 Perplexity 的 AI 搜索是一回事吗?
答:不是。AI 搜索联网检索后生成带引用的回答,Decisions API 不联网、不生成文本,只对你给定的内容输出概率判断。一个给人看答案,一个给程序供数字。
11 项基准 85.71% 的成绩可信吗?
答:这组成绩由 Perplexity 通过自家 API 测得,共 11 项、7210 条样本,属于发布方自测,且 Jev 在其中 6 项更高,并非全面领先。接入前请用自己的业务数据重新验证。
 京ICP备2024094994号-29