Jev 怎么用?5 分钟跑通第一次 API 调用(附代码)
Jev 怎么用,一句话说清:在控制台拿到 API Key,装上 Python SDK,向 POST /v1/systemone 发一次带 state 和 questions 的请求,拿回带概率的类型化决策。它是 TypeSafe AI 的决策模型,不生成文字,只回答你预先定义好的选择题、打分题和是非题。本文按官方文档把申请、接入、三种原语和选型一次讲清。
Jev 到底解决什么问题
大多数 AI 模型把结果输出成一段给人读的文字,想接进代码还得再解析、再校验,中间任何一步都可能出错。Jev 反过来:你把业务状态和问题一起发过去,它只回结构化的、带概率的答案,代码拿到就能直接用。
一句话总结:Jev 不是通用聊天模型,而是面向分类、评分、排序这类固定决策任务的低延迟模型。典型场景有三个。
- 从多个离散候选里选一个,比如把客服工单路由到 billing、technical 或 sales 组。
- 给一个对象打分或定级,比如判断工单严重程度、候选人匹配度。
- 输出 0 到 1 的连续判断值,比如这条消息有没有表达紧急情绪。
这一节先不展开 benchmark,把「是什么、能做什么」记住就够了,性能数据放到后面单独讲,而且会标清哪些是官方宣称、哪些只是官方的测试口径。
先判断:你到底需不需要 Jev
选型比性能更重要。先看这张表,一分钟内判断要不要继续往下读。
| 你的需求 | Jev 是否合适 |
|---|---|
| 写文章、总结、聊天 | 不适合,它不生成文字 |
| 分类 / 路由 | 适合,主场景 |
| 从固定候选里挑一个 | 适合,主场景 |
| 输出复杂 JSON | 不一定,先确认结构是否真的固定 |
| 需要多步复杂推理 | 不适合,属于非目标场景 |
| 极度关注延迟和调用成本 | 值得测试,但要用自己的数据压测确认 |
一句话判断:如果你要的是「在代码里做一个可靠的判断」,Jev 值得试试;如果你要的是「生成一段内容」,它帮不上忙。
Early Access 申请:从入口到拿到 API Key
Jev 目前只通过 early access 开放,流程四步就能走完。
- 申请入口:打开 typesafe.ai,点右上角 Join Waitlist,填写邮箱和使用意向。
- 等待通知:名额节奏由官方控制,具体等待时长官方没有公布,以收到邮件为准。任何声称能插队或代申请的都不要信。
- 进控制台:拿到账号后登录 console.typesafe.ai,在 Keys 页面生成 API Key。
- 下一步:把 Key 设成环境变量,装好 SDK,直接跑下一节的代码。
有两点要提前知道:官网和控制台目前都是英文,服务部署在美国西海岸,国内直连的稳定性和延迟要自己先评估,别把它当成国内可直连的服务。
5 分钟完成第一次调用
这是全文的核心。只需要做三件事:拿 Key、装 SDK、跑代码。
第一步,拿 API Key。登录控制台,在 Keys 页面创建一个密钥,复制备用。
第二步,安装 SDK。Python SDK 要求 Python 3.10 及以上。
pip install typesafe-sdk
装好后设置环境变量,SDK 会自动读取它,不用把密钥写死在代码里。
export TYPESAFE_API_KEY="你的 API Key"
第三步,写第一段可运行代码。下面这段把一个客服工单同时问三个问题。
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

ticket = "Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP."

response = client.system_one(
    state=ticket,
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={
                "billing": "Payment or subscription issues",
                "technical": "Bugs or integration problems",
                "sales": "Pricing or account questions",
            },
        ),
        "frustration": Score(
            instructions="How frustrated the customer appears",
            criteria=["Calm, just stating facts", "Frustrated but civil", "Very angry, strong language"],
        ),
        "is_urgent": Noul(
            instructions="The message conveys urgency or time-sensitivity",
        ),
    },
)

print(response.answers["department"].choice)   # technical
print(response.answers["frustration"].score)   # 1.0
print(response.answers["is_urgent"].noul)      # 1.0
返回的 JSON 长这样,每个字段都是可以直接消费的值。
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "technical",
      "confidence": 0.78,
      "probabilities": { "technical": 0.85, "sales": 0.0, "billing": 0.15 }
    },
    "frustration": {
      "type": "score",
      "score": 1.0,
      "confidence": 1.0,
      "legend": { "0": "Calm, just stating facts", "1": "Frustrated but civil", "2": "Very angry, strong language" },
      "probabilities": { "0": 0.0, "1": 1.0, "2": 0.0 }
    },
    "is_urgent": { "type": "noul", "noul": 1.0 }
  },
  "usage": { "input_tokens": 392, "output_tokens": 65 }
}
字段怎么读,逐条拆开。
choice是概率最高的选项,probabilities是每个选项的概率,两者配合就能设阈值判断。score是各等级按概率加权后的值,可能落在两级之间,比如 1.43;legend把等级编号还原成描述。confidence是 0 到 1 的置信度,只出现在 Choice 和 Score 的答案里,Noul 不返回它。usage给出本次输入输出 token 数,方便核算成本。
判断接入成功的标准很简单:上面三个 print 都能打出值,department 返回 technical,就算跑通了。第一次调用遇到报错,先对照 官方文档的 API reference 排查,官方文档站已经上线,不只是能看博客。
Choice / Score / Noul 分别什么时候用
三种原语各自回答一类问题,可以混在同一次请求里,互不影响。用哪种,取决于你要的答案长什么样,别用抽象的 schema 去理解,直接看输入输出。
Choice:从多个离散选项里选一个
答案是固定集合里的某一个,比如工单该去哪个组、商品属于哪个品类。返回 choice、每个选项的 probabilities 和 confidence,单次最多支持 255 个选项。
Choice(
    instructions="Which team should handle this",
    criteria={"billing": "支付问题", "technical": "技术故障", "sales": "销售咨询"},
)
Score:按有序等级给内容打分
答案是一条从低到高的刻度,比如严重程度、满意度、匹配度。返回 score、每个等级的概率、legend 和 confidence,等级数量在 2 到 10 之间。
Score(
    instructions="How severe is the issue",
    criteria=["轻微,不影响功能", "部分功能受影响但有临时方案", "阻塞,没有临时方案"],
)
Noul:问一个是非题
答案是一个 0 到 1 的连续值,表示「是」的概率,比如「这条消息是否表达紧急」。它只返回 noul,不返回 confidence,也不返回概率分布,这是它和 Choice、Score 最大的区别。
Noul(instructions="The message conveys urgency or time-sensitivity")
一个完整任务:从 100 个候选里挑出最佳商品
只讲原语还是太抽象,用一个真实任务串起来:从 100 个候选商品里选出最值得推荐的一个。思路是先用 Score 给每个候选打分,按分数排序取前几名,再用 Noul 判断要不要转人工。
from typesafe_sdk import Noul, Score, TypeSafeClient

client = TypeSafeClient()

candidates = ["商品 A:...", "商品 B:...", "商品 C:..."]  # 实际共 100 个
user_need = "用户想要一台 5000 元以内、适合剪辑视频的轻薄本"

questions = {}
for i in range(len(candidates)):
    questions[f"fit_{i}"] = Score(
        instructions="How well does this product fit the user's need",
        criteria=["完全不匹配", "勉强相关", "基本匹配", "高度匹配"],
    )
questions["need_manual_review"] = Noul(
    instructions="Is the state ambiguous enough to need a human",
)

response = client.system_one(
    state={"need": user_need, "candidates": candidates},
    questions=questions,
)

ranked = sorted(
    ((i, response.answers[f"fit_{i}"].score) for i in range(len(candidates))),
    key=lambda x: x[1],
    reverse=True,
)
top3 = ranked[:3]
print("Top 3:", [candidates[i] for i, _ in top3])

if response.answers["need_manual_review"].noul > 0.7:
    print("建议转人工复核")
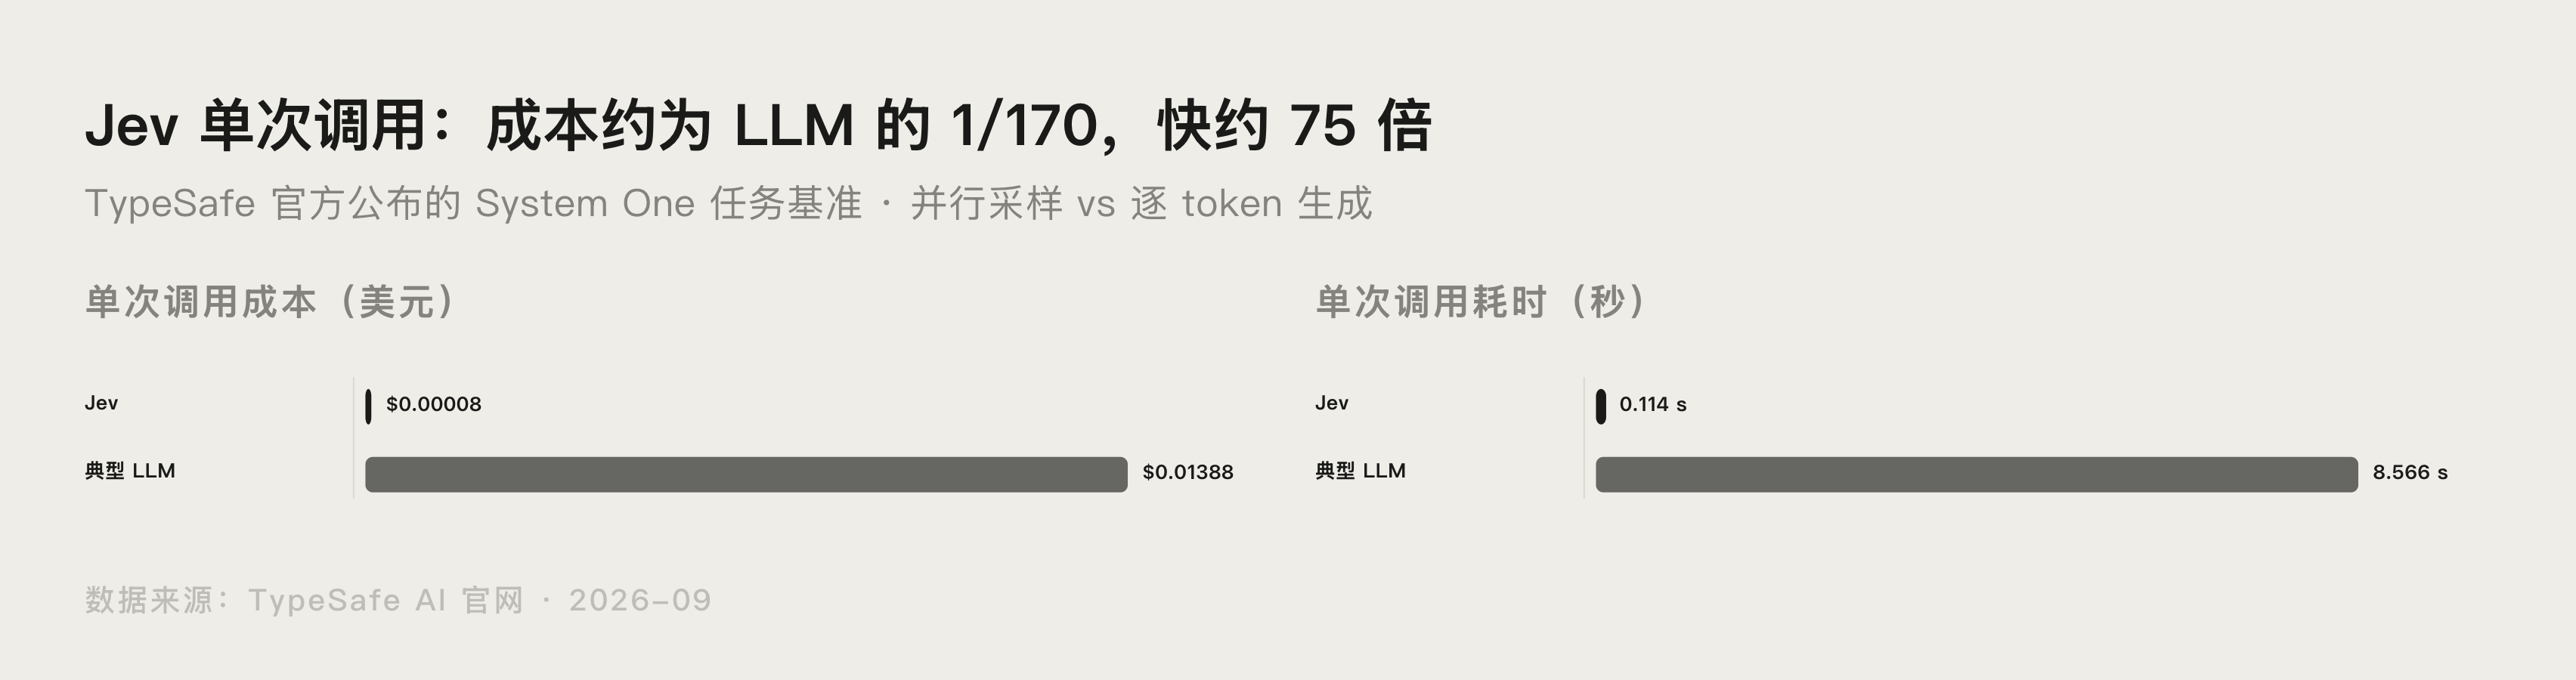
这就是官方推荐的用法:把一个大判断拆成可并行的原子问题,一次请求全部问完,再用代码里的权重和阈值组合结果。官方文档里还有 re-ranking、function calling、guardrails 等成套 cookbook 可以直接照搬。
Jev 和 LLM 到底怎么选
网上「LLM 做不到」的说法并不准确,更实用的是一张工程取舍表。
| 维度 | Jev | 通用 LLM |
|---|---|---|
| 开放式生成 | 弱,几乎不做 | 强 |
| 固定决策(分类/打分/选择) | 强项 | 可以,但要解析和校验 |
| 延迟 | 官方测试口径较低,70 到 500 毫秒 | 通常更高 |
| 成本 | 官方测试口径较低,输入 $0.042/百万 token、输出免费 | 通常更高 |
| 复杂推理 | 非目标场景 | 强 |
| 结构化输出 | 原生类型化,带校准概率 | 可借 Structured Outputs 约束,但概率靠提示,容易过度自信 |
结论不是二选一,而是分工:LLM 负责生成内容,Jev 负责在代码里做判断。
如果你在做 Agent 管线,可以先补齐 Function Calling 是什么 的基础概念,再对照 OpenAI Agents API 教程 理解编排边界。
和 LLM 的分工不同,Jev 解决的问题和 Agents API 和 Agents SDK 区别 里讨论的编排边界是同一族,模型定位见站内的 Jev 是什么?不做聊天的新模型类别一次讲清。
怎么读官方 benchmark
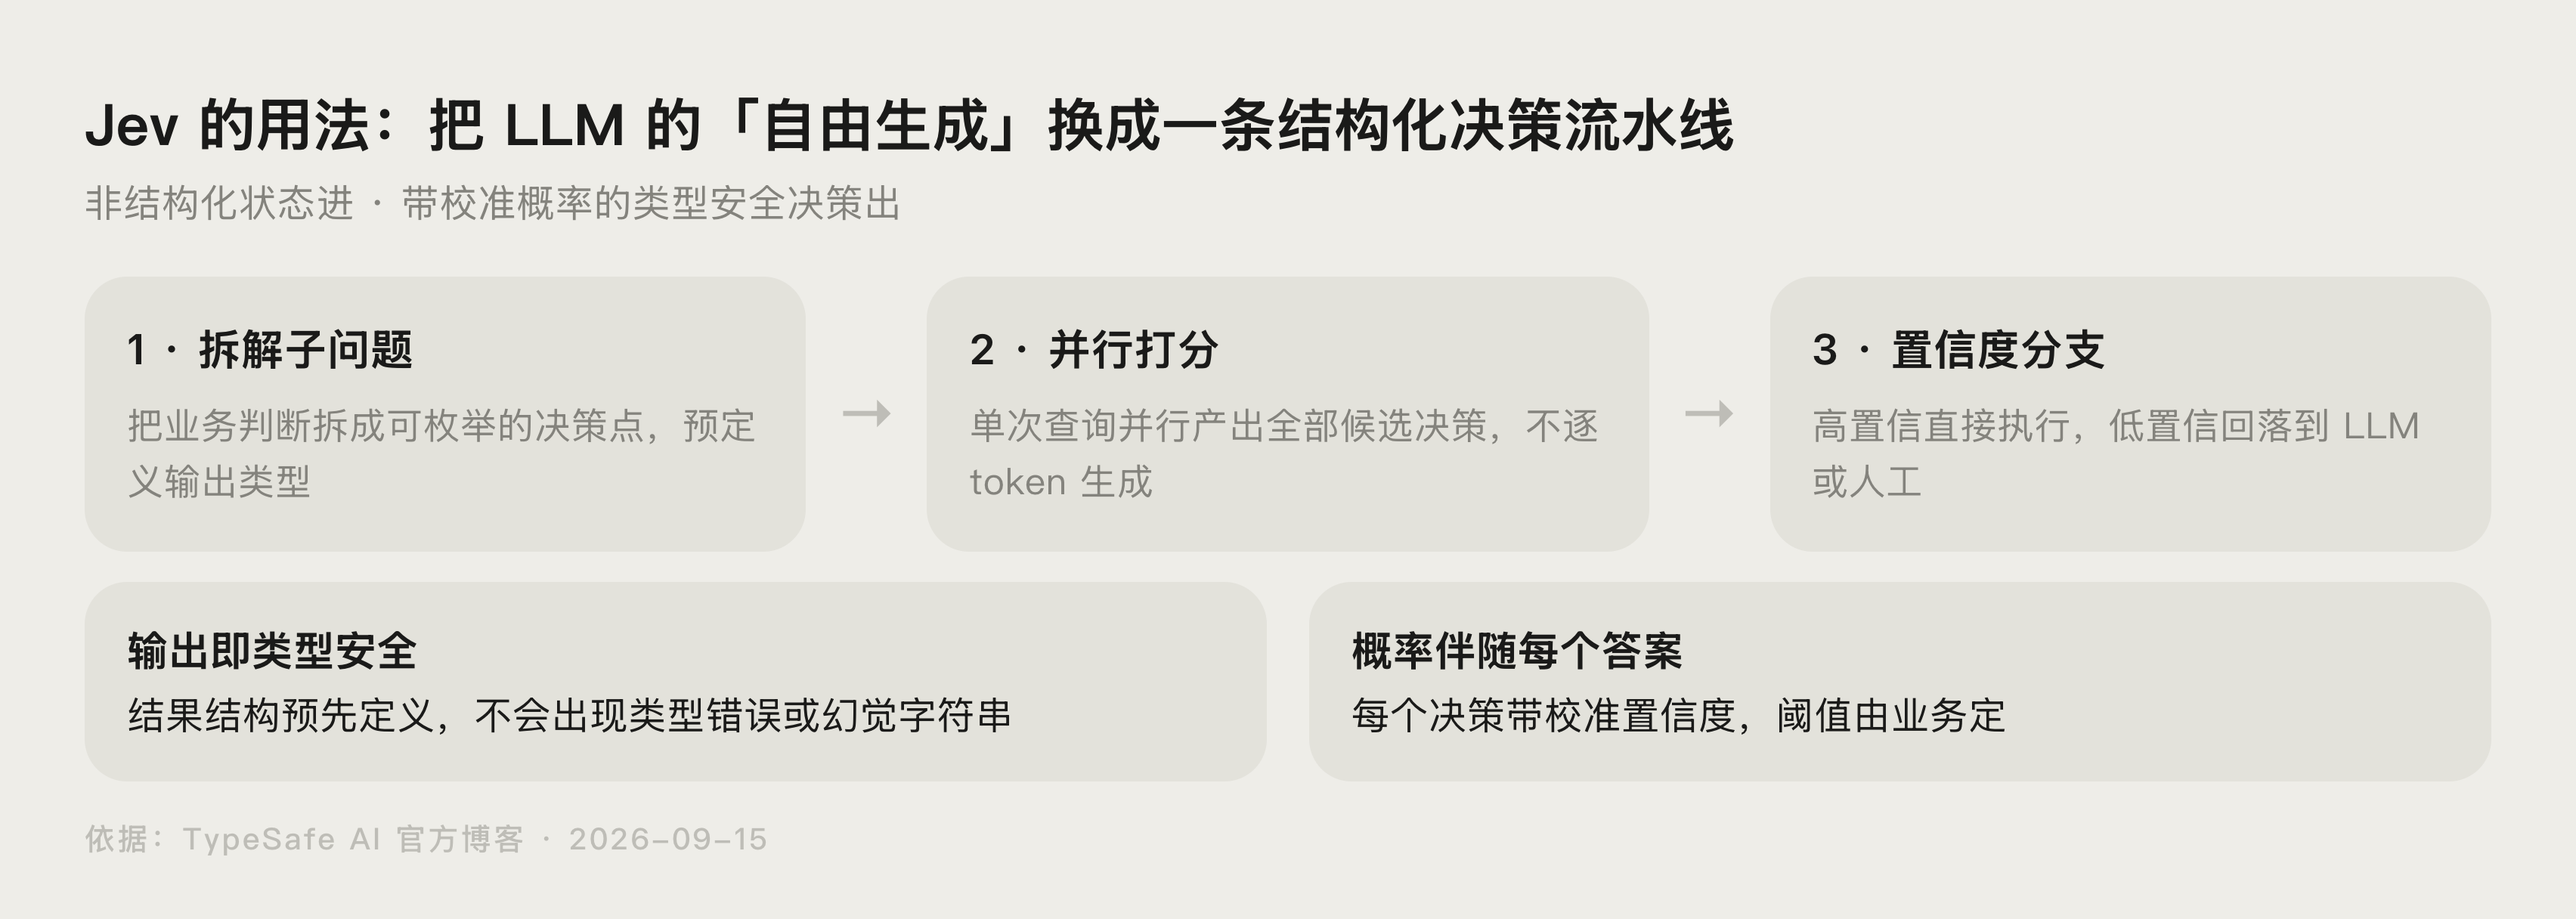
官方最抓眼球的数字,是某些工作流可达约 193 倍延迟提升和 444 倍成本改善。这些数字要看口径,才不会用错。
- 这是厂商自测。官方在博客里写明,评测一般在自己的西海岸笔记本上跑,不代表你机器上的表现。
- 只对 System One 形状的任务成立,也就是分类、打分、选择这类结构化决策,不能外推到开放生成。
- 单次调用对比是 TypeSafe 侧 $0.000081、耗时 0.114 秒,对 LLM 侧 $0.01388、耗时 8.566 秒。
- 官方自己也承认,不排除当前定价有补贴,长期可持续性需要时间证明,早期定价可能随时调整。
合理的读法是把官方数字当成上限参考,然后用自己业务的真实样本压一轮,看延迟、成本和准确率是否达标,再决定要不要上线。
什么情况下值得试 Jev:一张判断清单
满足以下任意两条以上,建议排一个 POC 先试。
- 你的判断是分类、打分、路由、抽取这类结构固定的决策。
- 你在为 LLM 输出做校验、评分或越狱检测。
- 业务对延迟敏感,需要百毫秒级响应。
- 调用量大,成本是主要约束。
- 你能接受把结果分成高、中、低置信三档,低置信转人工。
反过来,如果主诉求是生成文案、写代码或做多步推理,先别急着上 Jev,普通 LLM 更合适。
常见问题
Jev 有免费额度吗?
答:官方目前没有公布免费额度,计费口径是输入 $0.042/百万 token、输出免费。是否有调整以官方公告为准。
Jev 提供 API 吗?还是要装客户端?
答:是 API 服务,HTTP 端点为 `POST https://api.typesafe.ai/v1/systemone`,同时提供 Python 和 JavaScript SDK,不需要安装本地软件。
所有返回都带 confidence 吗?
答:不是。Choice 和 Score 的答案带 confidence,Noul 只返回一个 0 到 1 的 noul 值,不带 confidence 和概率分布。
国内开发者能申请吗?
答:官方没有公布地区限制,但申请和接入都需要稳定访问 typesafe.ai 并能收国际邮件。服务在美国西海岸,国内调用要评估延迟;另外英文是主要训练语言,官方称中文等 CJK 语料准确率不如英文,正式用之前要拿自己的中文数据测一遍。
Jev 和 LLM 的 function calling 有什么区别?
答:function calling 让 LLM 生成一次工具调用,本质仍是逐 token 生成字符串,可能格式出错;Jev 原生输出类型化决策和校准概率,官方称类型错误在数学上不可能,单次响应在百毫秒级。
什么时候正式开放注册?
答:截至发稿官方只公布了 early access 开放,GA(正式开放)时间和 waitlist 放完的节奏都没有公布。建议先进 waitlist 排队,以邮件通知为准。
 京ICP备2024094994号-29