
端侧 AI 是什么?3 分钟讲清云端分工和 NPU 的作用
端侧 AI 就是把 AI 模型直接装进手机、眼镜、耳机这类终端设备里跑,不把数据传到云端。你的相册搜「猫」秒出结果、拍照实时修图、断网也能用的语音助手,背后很多都是端侧 AI 在干活。
端侧 AI 是什么:中央食堂与家里厨房
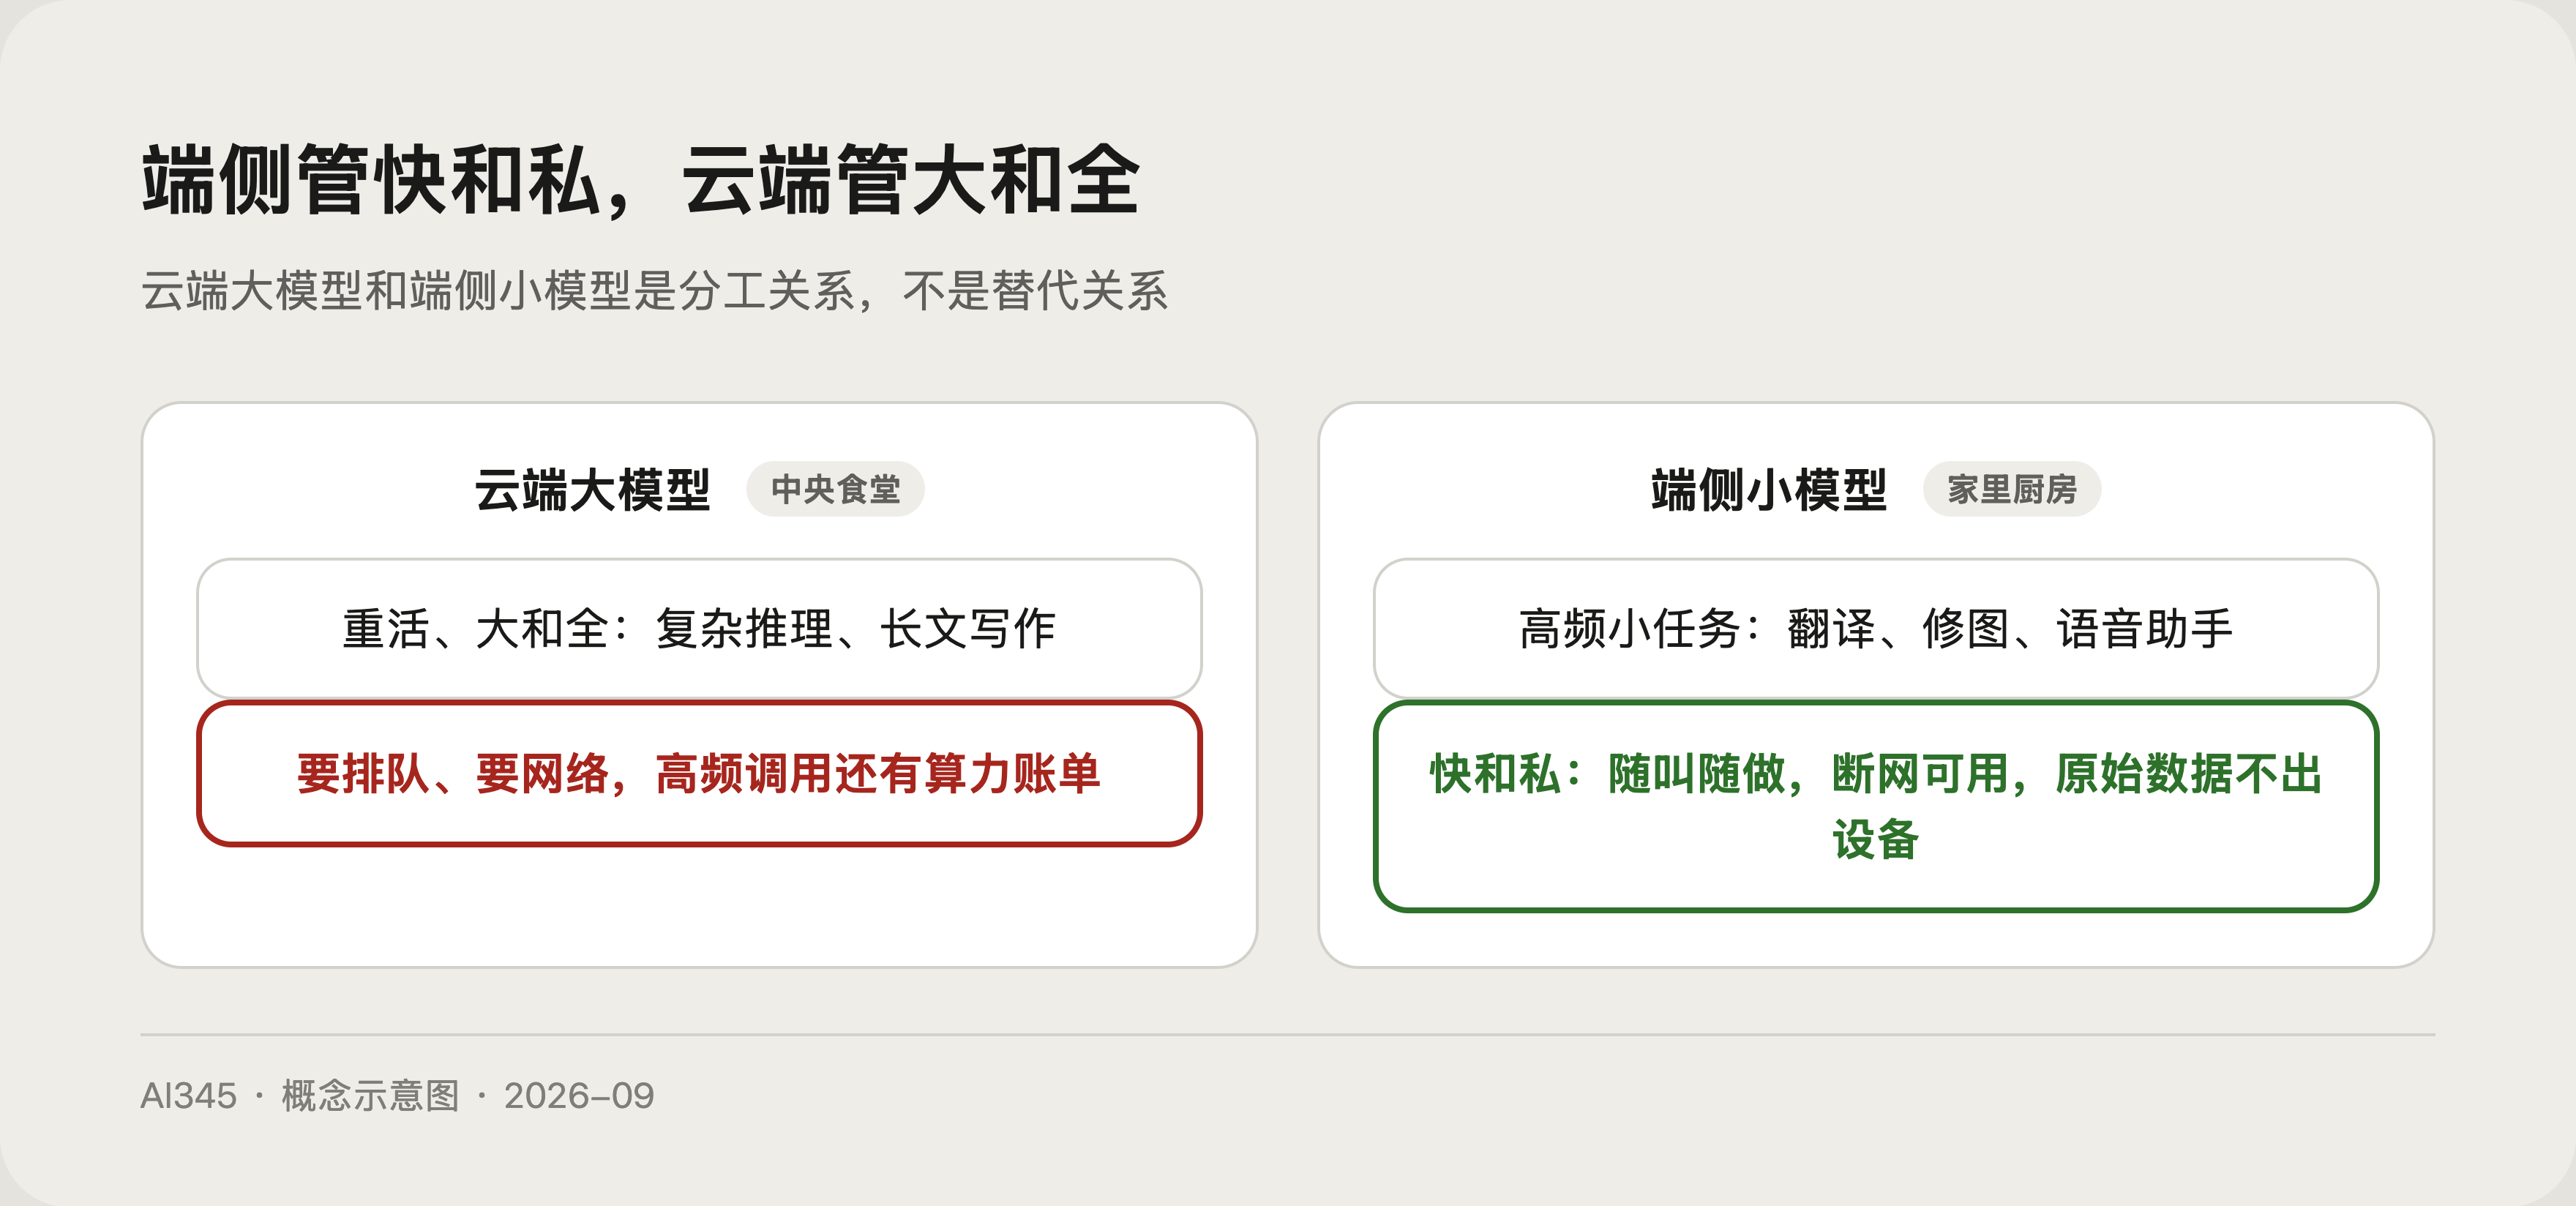
过去用 AI 像在中央食堂吃饭:所有饭菜都在云上做好,你的请求送过去,结果送回来。好处是菜全,坏处是要排队、要网络,而且你点什么,后厨都知道。
端侧 AI 相当于把小厨房搬回你家:模型小一些,菜没那么全,但随叫随做、断网也能开火,食材不出门。三个要点:
- 端侧指终端设备一侧,手机、眼镜、电脑、汽车座舱都算;
- 跑在端侧的通常是小参数模型,几亿到几十亿参数量级;
- 云端大模型和端侧小模型不是替代关系,是分工关系,下面细说。
为什么 AI 要跑进手机和眼镜
- 隐私:相册、聊天记录、健康数据最敏感,本地处理意味着原始数据不用上传;
- 延迟和网络:翻译、修图、语音助手这类高频任务,等云端一个来回的延迟很难接受,断网时云端直接不可用;
- 成本:每次调用云端模型都是真金白银的算力账单,高频简单任务放到本地,长期看更划算(方向性判断)。
技术上可行,是因为小模型在快速变好。Meta 2024 年发布的 MobileLLM 专门优化十亿参数以下模型,125M 和 350M 版本比此前同规模最优模型准确率高出 2.7% 和 4.3%,在 API 调用任务上的正确率已接近 LLaMA-2 7B(见 MobileLLM 论文)。
内存不够怎么办?苹果团队 2023 年底的方案是把模型参数存进闪存、按需搬进内存,能跑起最大可达可用内存两倍的模型,推理速度相比朴素加载在 CPU 和 GPU 上分别提升 4 到 5 倍和 20 到 25 倍(见 LLM in a flash 论文,后发表于 ACL 2024)。
云端和本地的分工:大活儿上云,小活儿在家
| 任务类型 | 谁来干 | 例子 |
|---|---|---|
| 复杂推理、长文写作 | 云端大模型 | 写方案、答难题 |
| 高频小任务 | 端侧模型 | 语音转文字、翻译、修图 |
| 敏感数据任务 | 端侧优先 | 相册搜索、输入法联想 |
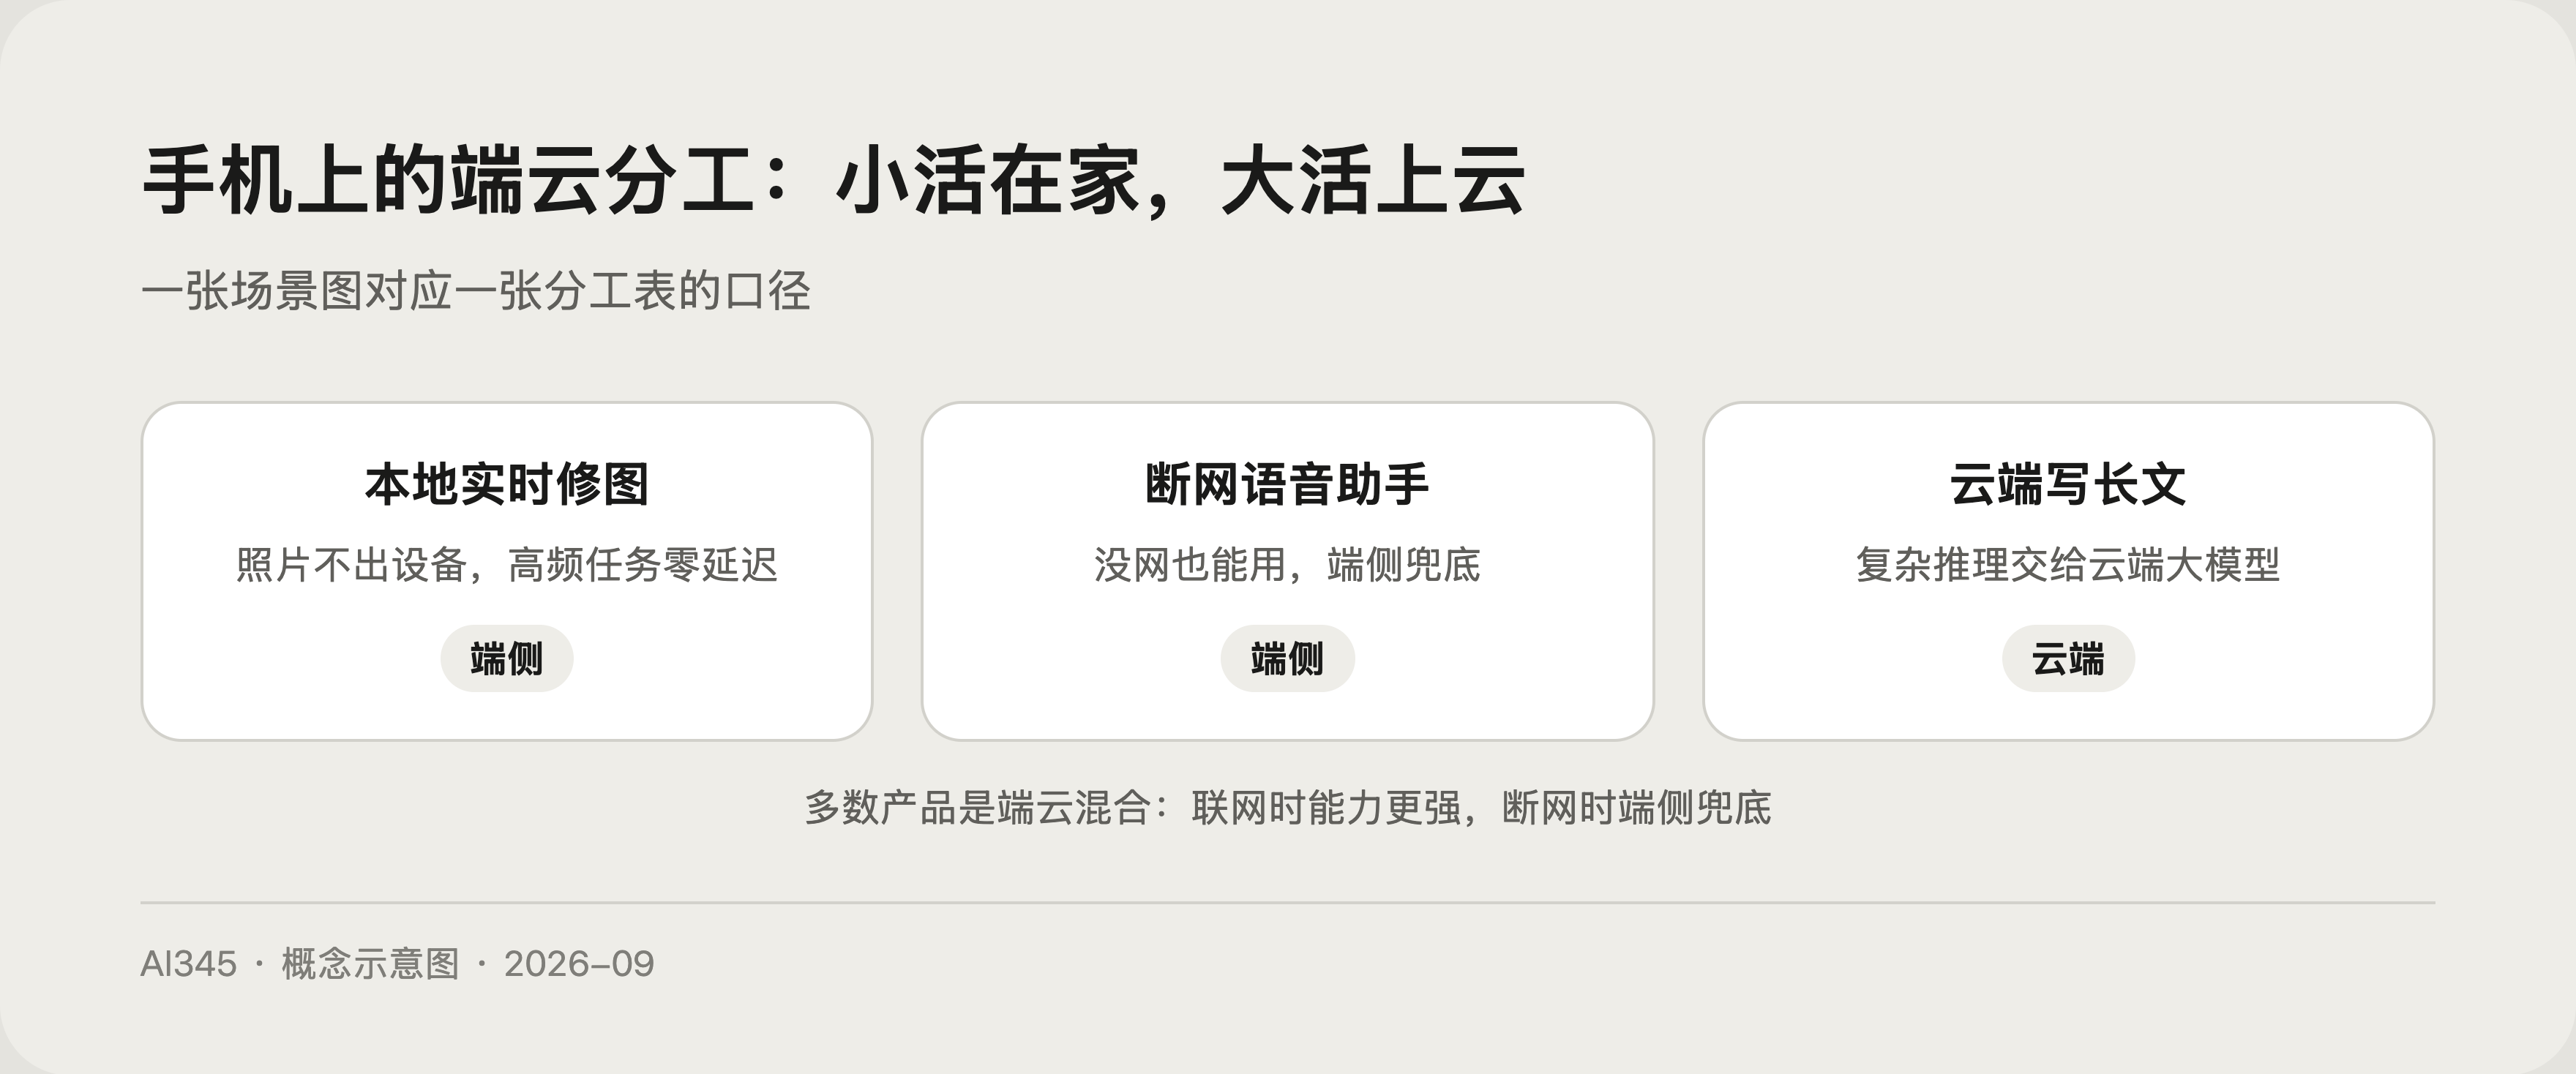
| 断网场景 | 端侧兜底 | 离线翻译、语音助手 |
这张表记住一行就够:端侧管「快和私」,云端管「大和全」。厂商的产品术语五花八门,落到分工上基本都长这样。
NPU 是干嘛的:给 AI 修的专用车道
手机芯片里原本有 CPU 和 GPU,现在普遍多了一块 NPU(神经网络处理单元)。分工可以这样理解:
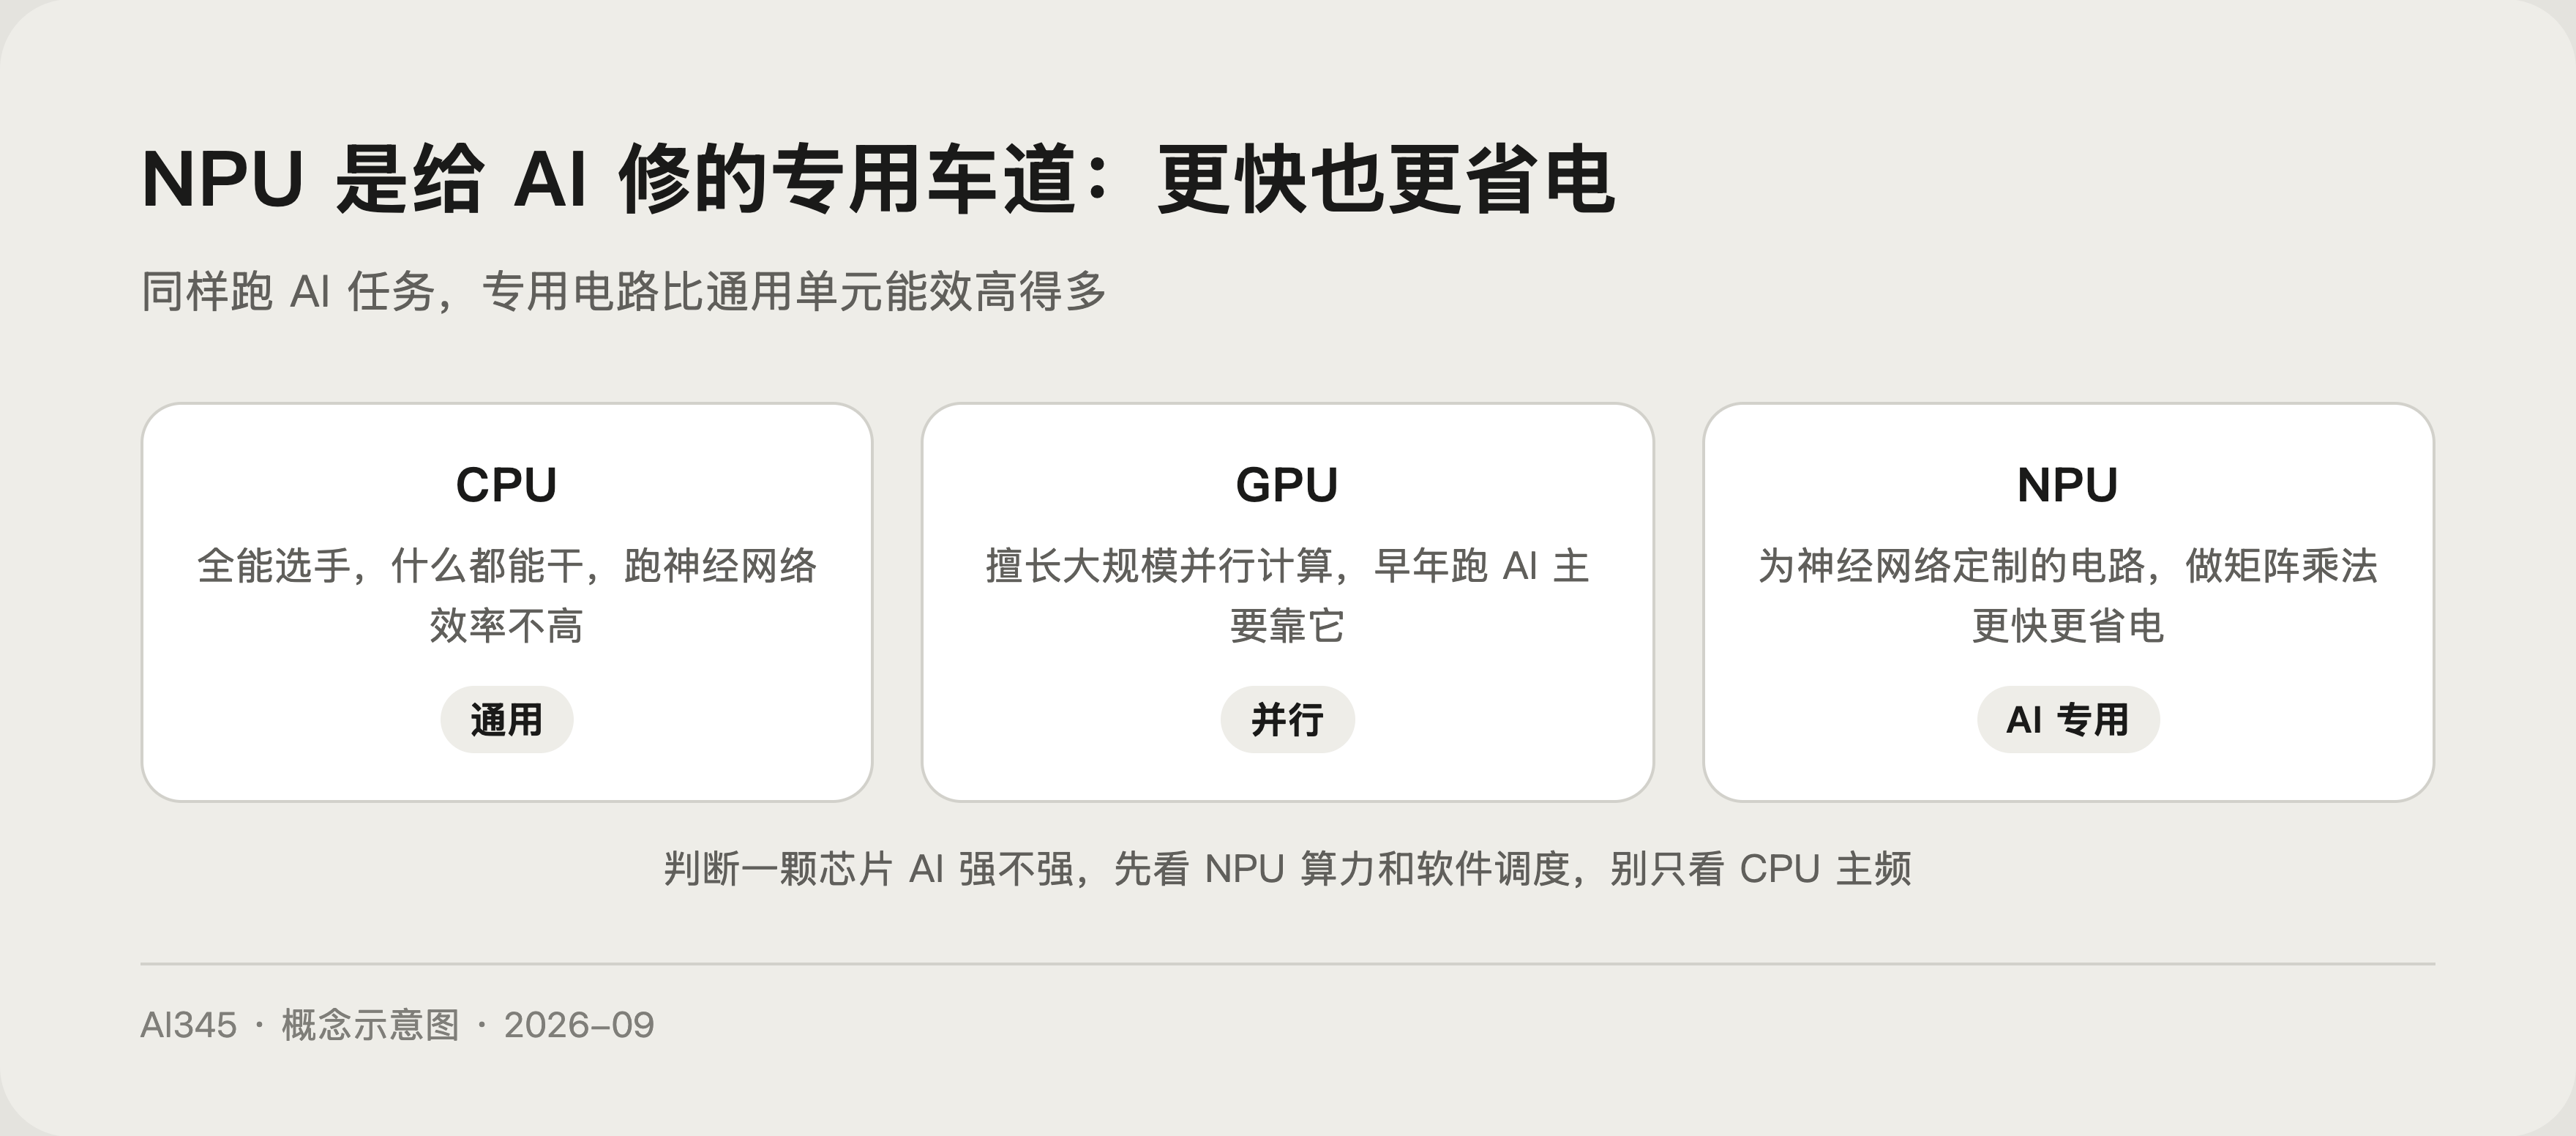
- CPU 是全能选手,什么都能干,但跑神经网络效率不高;
- GPU 擅长大规模并行计算,早年跑 AI 主要靠它;
- NPU 是为神经网络计算定制的电路,做同样的矩阵乘法更快更省电,AI 任务交给它,既提速又省电池。
所以判断「这颗芯片 AI 强不强」,很大程度要看 NPU 的算力和软件调度,而不是只看 CPU 主频。
一段话讲清端侧 AI
「端侧 AI 是把模型直接部署在手机、眼镜等终端上运行,核心价值是低延迟、保隐私、省云端成本。难点在算力和内存受限,解法是小模型加量化加 NPU 硬件加速,苹果的闪存按需加载是内存侧的代表作。云端和端侧是分工关系:端侧管高频小任务和敏感数据,云端管复杂推理。」
追问可能在两处:一个功能怎么决定放端侧还是云端,看延迟敏感度、隐私等级和模型大小;端侧模型怎么压,答出量化、蒸馏、剪枝三个词并各解释一句就够。
想动手体验端侧模型
不用等厂商,开源模型已经能玩:面壁的 MiniCPM5-2B 端侧部署全解、Meta 开源的 Muse Glimmer 30B 本地模型都可以在电脑上跑起来。选购 AI 眼镜这类端侧硬件前,建议先看2026 AI 智能眼镜选购对比,重点看芯片和内存。
常见问题
端侧 AI 和云端大模型谁更聪明?
答:云端更强,尤其在复杂推理上。端侧胜在延迟低、保隐私、离线可用,两者是分工不是替代,厂商产品里通常是端云协同。
NPU 和 GPU 有什么区别?
答:GPU 是通用并行计算单元,NPU 是专为神经网络计算定制的电路。跑 AI 任务时 NPU 能效更高、更省电,所以手机芯片都单独做了这块。
端侧 AI 就绝对安全吗?
答:不是绝对。数据不出设备减少了泄露面,但系统厂商怎么使用本地数据仍取决于产品政策,敏感功能要看清隐私说明。
端侧 AI 需要联网吗?
答:纯端侧任务不需要,安装或更新模型包时需要。多数产品是端云混合:联网时能力更强,断网时端侧兜底。
几年前的旧手机能跑端侧 AI 吗?
答:取决于芯片有没有 NPU 和内存大小。老机型多数只能跑很小的模型,体验有限,新机型基本都把端侧 AI 当卖点。
 京ICP备2024094994号-29