
LTX 2.5 本地部署教程:32GB 显存门槛与优化开关
LTX 2.5 的权重完全公开,本地部署有 ComfyUI、Python 管线和 Diffusers 三条路,官方给出的前置条件是 CUDA 显卡、32GB 以上显存与 100GB 以上磁盘空间。
先确认你的机器扛不扛得住
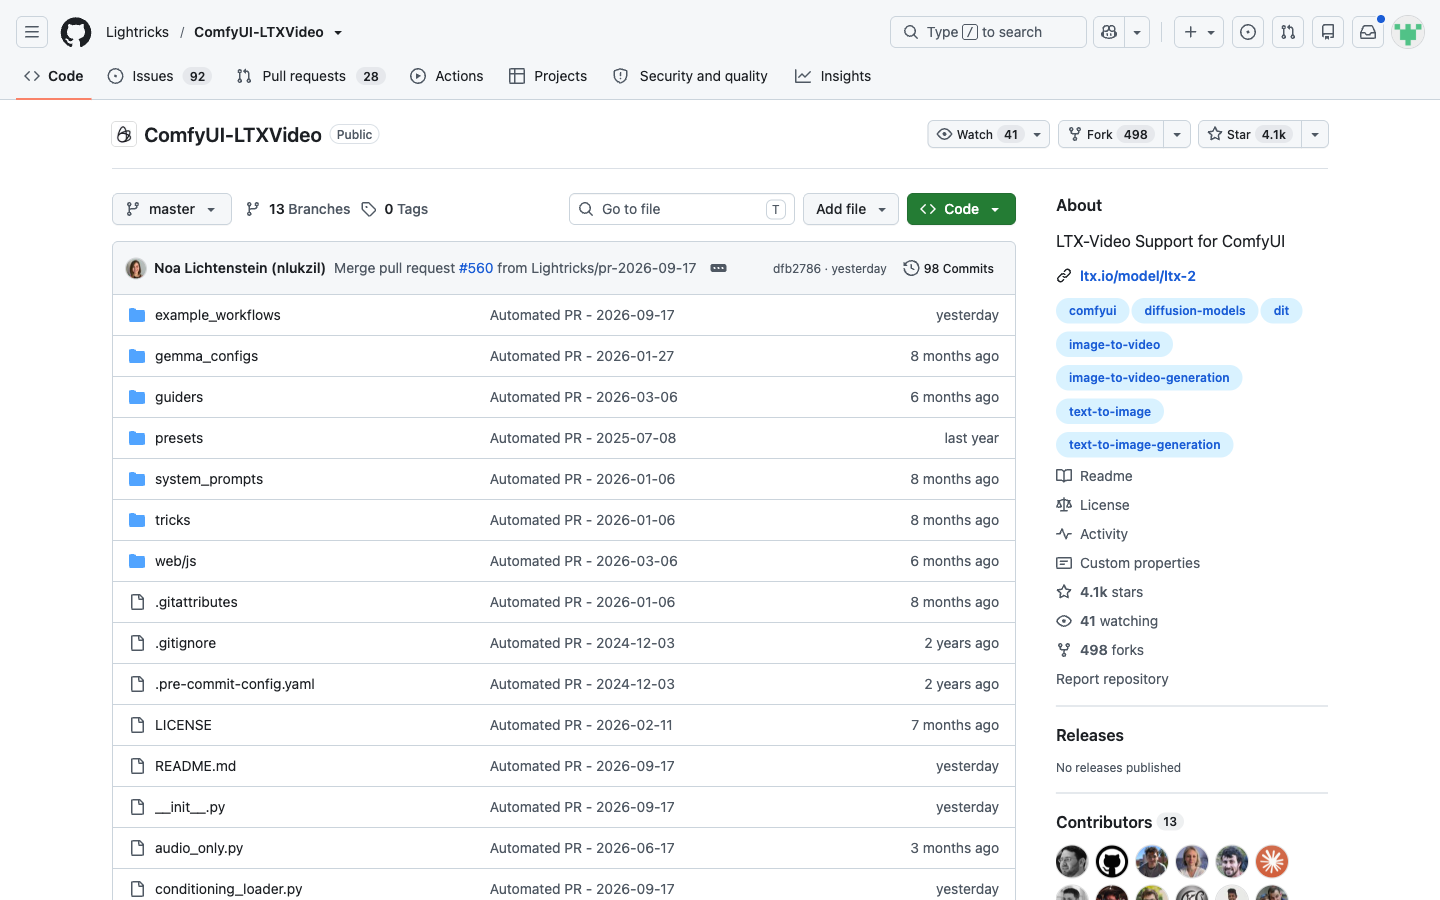
视频模型和文本模型的显存门槛不是一回事。文本模型可以用量化把 7B 塞进 8GB 显存,LTX 2.5 光是 22B 参数的 bf16 权重就接近 44GB,再叠加视频 VAE 解码和空间上采样,所以官方在 ComfyUI-LTXVideo 插件页 直接把门槛写成 32GB 显存加 100GB 磁盘,命令行路线的蒸馏权重一套下载约 66GiB。
如果你的卡达不到这条线,有三个现实的选择:
- 先用官方在线 Playground 验证效果,确认值得投入再买卡。
- 走命令行管线并打开 fp8 量化与卸载开关,把权重放到系统内存甚至硬盘上流式读取。
- 放弃本地,直接用官方 API。
顺便说一句,本地部署的显存门槛一直在涨,文本模型这一支还有 GLM-6.0 能本地部署吗 这类低门槛方案可选,通用规律可以先看 本地部署大模型需要什么配置?一张表看显存门槛。
三条路线怎么选
| 路线 | 适合谁 | 前置条件 | 显存压力 |
|---|---|---|---|
| ComfyUI | 想要图形界面和现成工作流 | ComfyUI + LTXV 节点 | 官方建议 32GB 以上 |
| Python 管线 | 要写脚本、接自动化 | Python 3.12+、CUDA 12.7+ | 可用 fp8 与卸载压低 |
| Diffusers | 已在用 Diffusers 生态 | 从主分支安装 diffusers | 支持 CPU offload 与 VAE 分块 |
三条路线的取舍逻辑和 openPangu 2.0 本地部署教程:三条路线与硬件门槛 讲的一样:图形化上手快,命令行可控性强,生态路线迁移成本低。
路线一:ComfyUI 装 LTXV 节点
这是新手最省事的一条路,全程在界面里点。
- 先装好 ComfyUI,官网有 Windows 与 macOS 的安装包。
- 打开 ComfyUI,点 Manager 按钮,或者按 Ctrl+M。
- 进入 Install Custom Nodes,搜索 LTXV 相关关键字。
- 点安装,等进度条走完,重启 ComfyUI。
- 节点会出现在 LTXVVideo 分类下,打开官方示例工作流即可开跑。
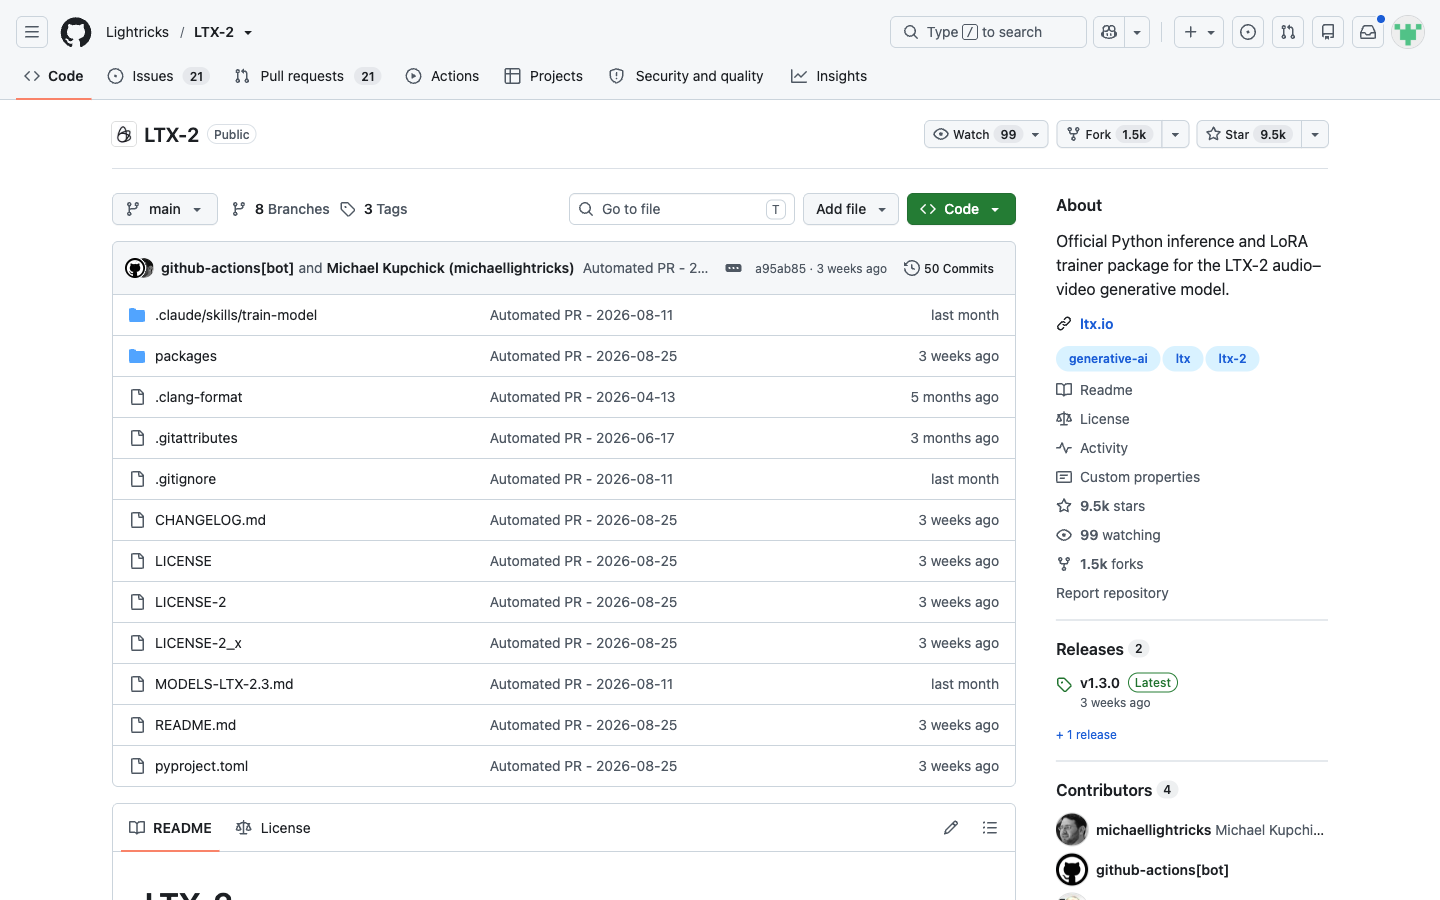
有个细节能省不少事:LTX-2 已经内置进 ComfyUI 核心代码,所以不装额外节点也能用基础能力,装 LTXV 插件主要是为了拿到 HDR、IC-LoRA 这类进阶工作流。模型文件会在首次运行时按工作流提示下载。
路线二:官方 Python 管线
这条路的软件前置是 Python 3.12 以上、CUDA 12.7 以上、PyTorch 约 2.7 版本,官方推荐用 uv 管理环境,完整说明见 ltx-pipelines 安装文档。
第一步,从 Lightricks/LTX-2 仓库 拉代码建环境:
git clone https://github.com/Lightricks/LTX-2.git
cd LTX-2
uv sync --extra natten
natten 这个附加项只在 Linux 加 CUDA 上生效,Windows 和 macOS 会自动跳过,视频解码退回 Triton 或 eager 实现,所以同一套命令在哪都能装。
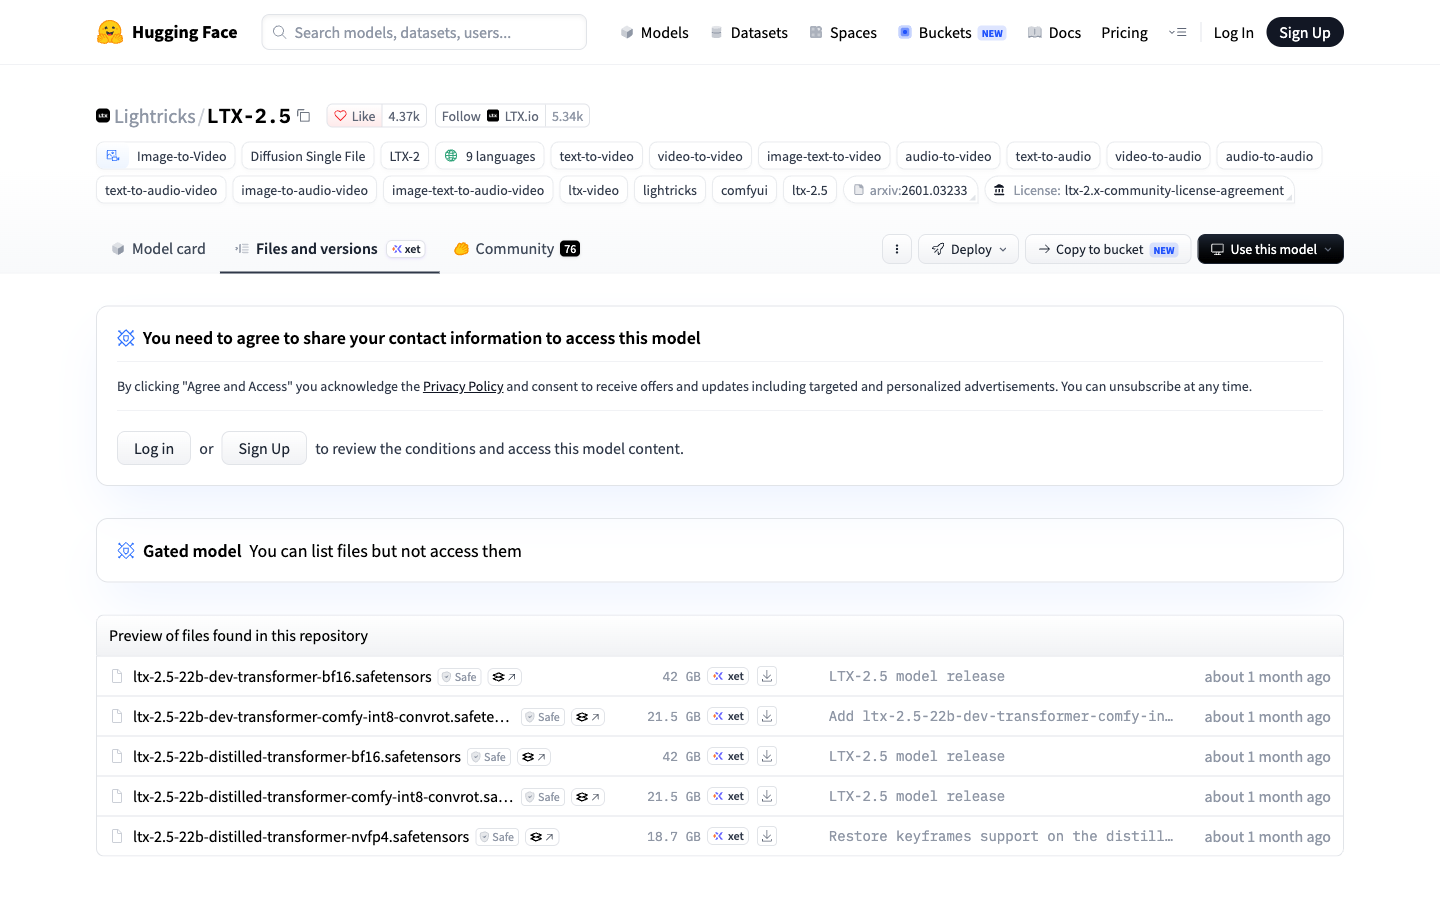
第二步,登录并下载蒸馏权重,这一套约 66GiB:
hf auth login
hf download Lightricks/LTX-2.5 \
  diffusion_models/ltx-2.5-22b-distilled-transformer-bf16.safetensors \
  text_encoders/gemma4-12b-with-proj-ltx-2.5-bf16.safetensors \
  vae/ltx-2.5-video-vae-bf16.safetensors \
  vae/ltx-2.5-audio-vae-bf16.safetensors \
  latent_upscale_models/ltx-2.5-latent-spatial-upscaler-x2-bf16-1.0.safetensors \
  --local-dir models/ltx-2.5
如果卡在 401 或 403,通常是没在 Hugging Face 上同意模型条款,或者 token 权限不够,用带读取权限的 token 重新登录即可。
第三步,跑第一条视频:
uv run python -m ltx_pipelines.distilled \
  --transformer-path models/ltx-2.5/diffusion_models/ltx-2.5-22b-distilled-transformer-bf16.safetensors \
  --text-encoder-path models/ltx-2.5/text_encoders/gemma4-12b-with-proj-ltx-2.5-bf16.safetensors \
  --video-vae-path models/ltx-2.5/vae/ltx-2.5-video-vae-bf16.safetensors \
  --audio-vae-path models/ltx-2.5/vae/ltx-2.5-audio-vae-bf16.safetensors \
  --spatial-upsampler-path models/ltx-2.5/latent_upscale_models/ltx-2.5-latent-spatial-upscaler-x2-bf16-1.0.safetensors \
  --num-frames 121 \
  --seed 42 \
  --prompt "A golden retriever running through a sunny meadow, cinematic lighting" \
  --output-path output.mp4
蒸馏管线参数最少、步数固定,适合当验证。追求成片质量就换 DFR 管线,它用同一个蒸馏权重,额外加一个细节 IC-LoRA 和一次空间细化,代价是更慢也更吃显存,两条管线的参数细节查 pipelines 文档 即可。
路线三:Diffusers
LTX 2.5 的 Diffusers 版本单独放在一个仓库里,目前还没进正式版,需要从主分支安装 diffusers。
pip install git+https://github.com/huggingface/diffusers
官方示例的思路是两阶段:先出低分辨率 latents,再上采样后解码,并用 enable_model_cpu_offload() 与 vae.enable_tiling() 压显存。如果你本来就在 Diffusers 生态里,这条路改动最小;如果你是第一次接触,建议还是先走 ComfyUI。
怎么确认真的跑通了
- 命令行路线:输出目录里出现能正常播放的 mp4,实际帧数与设置的
--num-frames一致。 - ComfyUI 路线:工作流从加载模型到保存视频全绿,预览窗口能播放,没有节点标红。
- 音频检查:LTX 2.5 是音视频联合生成,成片里应该有独立音轨,这是它和多数只出画面的视频模型最直观的差别。
显存不够时,这些开关按顺序加
官方 优化文档 明确不公布绝对显存数字,只给降级杠杆,按下面顺序加效果最划算:
| 开关 | 作用 | 代价 |
|---|---|---|
--quantization fp8-cast |
把 bf16 权重实时降精度 | 轻微质量损失 |
--quantization fp8-scaled-mm |
配 fp8 权重,Hopper 及以上更好 | 需要较新的卡 |
--offload cpu 或 --offload disk |
权重放内存,或从硬盘流式读取 | 明显变慢 |
| 换用卷积版 VAE | 替代扩散解码器,依赖更少 | 画质略降 |
--spatial-upscalings 2 |
4K 输出时让第二阶段保持半分辨率 | 细节表现有差别 |
--max-batch-size 调小 |
降低单次前向的峰值内存 | 更慢 |
另外两个提速点:一是蒸馏管线本身只跑 8 步,是官方给的最快路径;二是用梯度估计可以把推理步数从 40 降到 20 到 30,画质基本守得住。如果你的目标只是先跑起来一个视频模型,门槛更低的方案可以看 MiniMax H3 是什么?8GB 显存本地部署与 API 价格全解。
常见报错速查
| 现象 | 原因 | 解法 |
|---|---|---|
| 下载权重报 401 或 403 | 没同意模型条款,或 token 权限不足 | 先在模型页接受条款,再用带读取权限的 token 登录 |
| 一开跑就 OOM | 权重加解码超出显存 | 加 fp8 量化与卸载,换卷积 VAE,4K 时开两级上采样 |
| 报帧数不合法 | 帧数没满足 8k+1 规则 | 用 121、129 这类数值 |
| 报宽高不合法 | 尺寸不在网格上 | 宽高被 32 整除,DFR 的最终输出要被 64 整除 |
| Python 管线加载 int8 权重失败 | 那个文件只给 ComfyUI 用 | 换成 bf16 权重 |
| ComfyUI 里找不到 LTXVVideo 节点 | 节点没装或没重启 | 在 Manager 里重新安装并重启 |
常见问题
LTX 2.5 本地部署要什么显卡?
答:官方 ComfyUI 插件页写的是 CUDA 兼容显卡加 32GB 以上显存,这是官方唯一给出的硬性数字。命令行路线可以用 fp8 量化与卸载把需求压下来,代价是速度变慢,官方没有承诺最低显存。
LTX 2.5 能装在 Mac 上吗?
答:软件层可以装,`natten` 会在非 Linux 环境自动跳过并退回 Triton 或 eager 解码。但官方没有给出 Mac 上的性能承诺,如果你的机器是 Mac,建议先参考 [Qwen3.8-27B Mac 本地部署教程:16G 内存也能跑](https://www.ai345.info/ai-guide/qwen3-8-27b-mac-16gb-local-deployment-guide) 里压内存的思路,再评估要不要投入。
只下载一部分权重能跑吗?
答:可以。权重是按组件拆分的,transformer、文本编码器、视频 VAE、音频 VAE、上采样器各是一个文件,文件清单见 [Hugging Face 权重页](https://huggingface.co/Lightricks/LTX-2.5),你只需要下当前管线用到的那几个,所以 66GiB 是蒸馏路线的总量,不是不可拆的黑盒。
本地部署和用官方 API 哪个更划算?
答:看出片频率。低频、想先看效果,用官方 Playground 或 API 最省事;高频出片、已经有合适的卡,本地跑没有按次计费,长期成本更低。注意本地部署不等于免费商用,商用授权仍按公司营收分档。
显存不够,能不能只用蒸馏版本来跑?
答:可以,而且这是官方的推荐起点。蒸馏 transformer 跑得更快、占用更低,DFR 高质量管线也是用同一个蒸馏权重,只是额外挂一个细节 IC-LoRA 并多跑一次空间细化。
 京ICP备2024094994号-29