
LFM2.5-24B-A2B 本地部署教程:5 步跑通
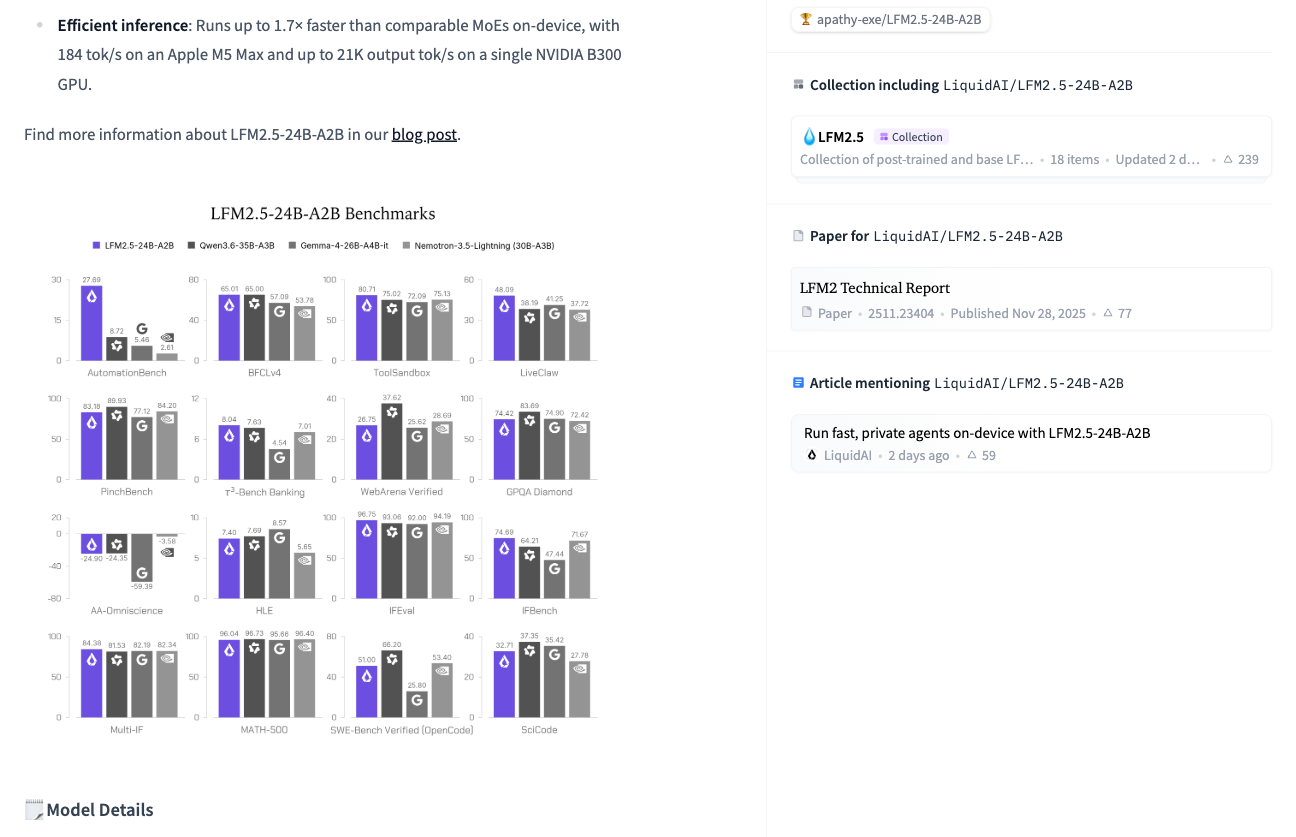
LFM2.5-24B-A2B 是 Liquid AI 在 2026-10-13 发布的端侧 Agent 推理模型:总参数 24B,每跑一个 token 只激活约 2.45B,官方说在 Apple M5 Max 上约 15GB 显存就能本地跑通,速度 184 tok/s。完整流程就 5 步:确认硬件、装推理后端、拉权重、启动服务、接进 Agent 工具。权重和工具都免费,下面一步步来。
这个模型值得先装,这几条先对号入座
在动手前,先确认你属于哪类用户。如果你是想给笔记本或 Mac 配一个能本地连续跑、不依赖云端的 AI 副手,它正是当下能放在本地的选择,因为激活参数少,推理成本低,可以一直开着。如果你只是想聊聊天,那没必要用它,它是推理专用模型,回答任何问题前都会先走一段思维链,速度不如同档的普通聊天模型顺滑。
它是纯推理模型这件事很关键。官方口径里写得很清楚:回答前先生成显式思维链,同时能调用工具,能在 OpenClaw、Hermes Agent、Pi、OpenCode 这类 Agent 工作台里处理多步任务。OpenAI 兼容后端就是为接这类 Agent 工具留的口子。
如果想把 Agent 跑在这个小模型上到底值不值算清楚,可以顺带读一下「开源模型和闭源模型怎么选?一张对比表讲清 6 个真实成本」。回到正题,先说硬件。
前置准备:先确认硬件能不能扛
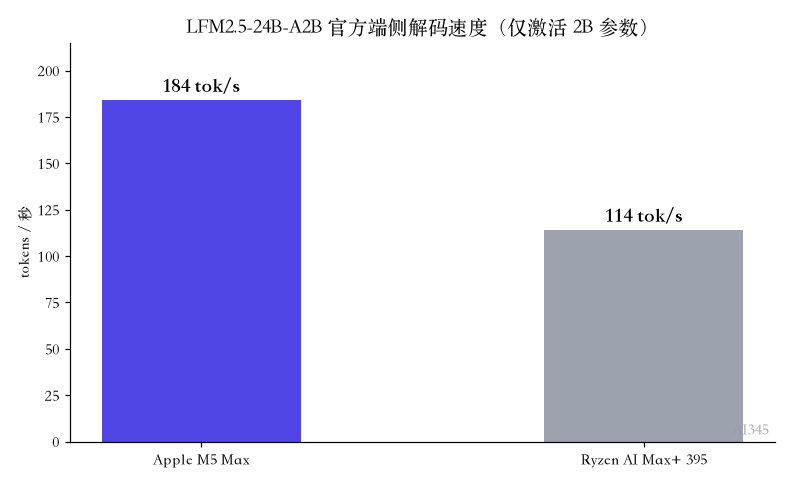
核心判断很简单:显存约 15GB 起步。官方给的两组参考是 Apple M5 Max(184 tok/s)和 AMD Ryzen AI Max+ 395(114 tok/s),也就是说在带大内存 MacBook 或新一代 AI 笔记本上跑得比较顺。独立显存不足时,可以把权重量化到更低位,牺牲一点速度换显存,这部分后面讲。
除了显卡和内存,下面这几项基础也顺手确认一下:
预装 Python 3.10 以上,外加一个能建虚拟环境的终端。
磁盘留出 15GB 以上的空间放权重。
下载权重需要能访问 Hugging Face,国内直连不稳可以走镜像(hf-mirror.com),这一步国内用户务必提前备好。
API 客户端不走镜像,后面连的是你自己起的本地服务,基本不碰网络问题。
带 Apple 芯片的 Mac 优先用 MLX 后端,NVIDIA 卡和 Linux 优先 llama.cpp 或 vLLM,Windows 桌面用 llama.cpp 官方构建。选型逻辑我放在下面的步骤里一步步带出来。更小的模型怎么做新手起手,可以参考「d1-3B 本地部署教程:显存要求与 5 步跑通第一次推理」,那边把最基础的流程拆得更碎。
本地部署完整 5 步
下面以最通用的 llama.cpp 为例,Apple 芯片会在括号里单独标注 MLX 的命令。每一步都给预期结果,方便你对照检查。
第 1 步:选好后端并装好推理工具
先决定走哪个后端。llama.cpp 覆盖最广(支持 CPU,也能兼容常见 GPU),先学它不容易错;Apple 芯片的机器建议直接上 MLX,官方在 Mac 上就是用 MLX 测的。
创建一个工作目录:mkdir lfm && cd lfm
建虚拟环境:python3 -m venv venv && source venv/bin/activate
走 llama.cpp 的话,去 llama.cpp 仓库 克隆后按 README 编译:git clone https://github.com/ggerganov/llama.cpp
走 MLX 的话,直接 pip install mlx-lm(Apple 芯片专用)
确认安装成功:llama-cli --version 能看到版本号,MLX 用 mlx_lm.server --help
第 2 步:拉取权重,国内走镜像
LFM2.5-24B-A2B 的权重以开放形式发布在 Hugging Face 模型卡 上,架构细节也能在 Liquid AI 官方博客 这条产品线里查到。注意官方加载器要求 transformers 大于等于 5.0.0,版本低了会先报警告甚至直接报错。
先确认 transformers 版本够不够:pip show transformers
版本不够就升级:pip install -U "transformers>=5.0.0"
官方拉取:huggingface-cli download LiquidAI/LFM2.5-24B-A2B --local-dir ./lfm24b
国内镜像:HF_ENDPOINT=https://hf-mirror.com huggingface-cli download LiquidAI/LFM2.5-24B-A2B --local-dir ./lfm24b
预期结果:./lfm24b 目录下看到完整权重文件,分片累加约 15GB。
第 3 步:启动 OpenAI 兼容服务
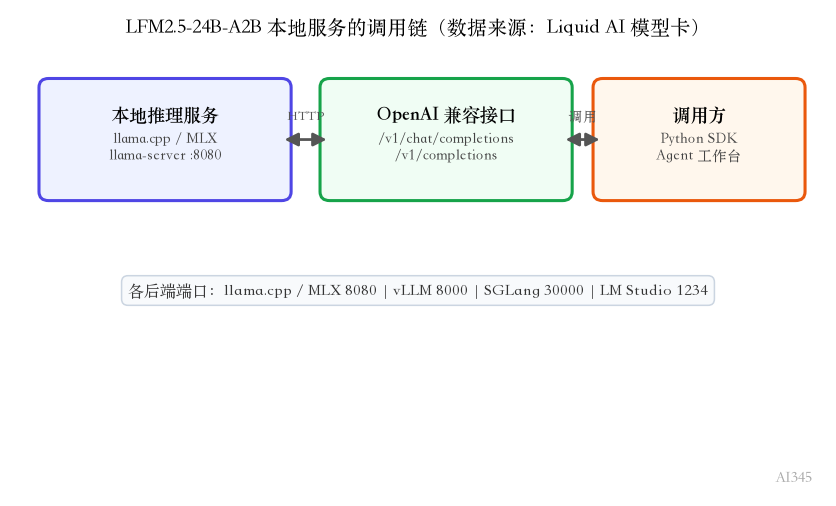
这一步是所有 Agent 工具直接接上的关键。llama.cpp 和 MLX 都用 8080 端口,vLLM 用 8000,SGLang 用 30000,LM Studio 用 1234。
llama.cpp:./build/bin/llama-server -m ./lfm24b/model.gguf --port 8080
MLX(Apple 芯片):mlx_lm.server --model LiquidAI/LFM2.5-24B-A2B --port 8080
vLLM:python -m vllm.entrypoints.openai.api_server --model LiquidAI/LFM2.5-24B-A2B --port 8000
预期结果:终端出现 Uvicorn running on http://localhost:8080 这类提示,服务就起来了。
第 4 步:发一个请求验证跑通
服务起来后,先在终端直接打一发,确认它会先输出思维链再给结论。
用 curl 发:curl -X POST http://localhost:8080/v1/chat/completions
body 里带 model 名、messages 和 max_tokens
看到返回的 content 开头是一段思考过程、后面才是答案,就算跑通
预期结果:一个包含 reasoning_steps 和 content 两个字段的标准 JSON。
第 5 步:接进 Agent 工具
LFM2.5-24B-A2B 是 Agent 优先的模型,最后一步是把你喜欢的 Agent 工具指到这个服务上。以官方提到的 Hermes Agent 为例:
安装 Agent 工具后,新建一份配置文件
把 base_url 填成 http://localhost:8080/v1
把 model 填成 LFM2.5-24B-A2B
跑一个带工具的测试任务,比如让它查天气或调一个本地脚本
预期结果:Agent 能多次调用工具、把中间结果喂回模型、最后给出决策,这就是一个真正能用的本地 Agent。
常见报错速查
下面几个是部署时最容易卡住的地方,按现象对号入座。
安装和下载阶段的排错:
| 现象 | 原因 | 解法 |
|---|---|---|
| 加载权重时报 transformers 版本错误 | transformers 低于 5.0.0 | pip install -U "transformers>=5.0.0" 后重开终端 |
| 国内下载权重卡住或超时 | 直连 Hugging Face 不稳 | 设置 HF_ENDPOINT=https://hf-mirror.com 走镜像 |
运行阶段的排错:
| 现象 | 原因 | 解法 |
|---|---|---|
| 启动后崩显存 OOM | 显存不足 15GB | 用低位量化版本或压缩上下文长度 |
| 服务启动但请求 404 | 端口和后端约定不一致 | 按后端改端口,llama.cpp/MLX 8080、vLLM 8000 |
| 首次请求漫长 | 模型在加载权重 | 属正常,二次之后就快了 |
| Agent 工具连不上服务 | base_url 路径填错 | 统一填 http://localhost:端口/v1 |
进阶:量化、长上下文与开源选型
如果 15GB 显存还不够,把权重量化后跑,占用会降下来,速度损失在可控范围。想让它处理长一点的多步 Agent 任务,默认 131K 上下文别为了省显存砍太猛,那会影响多轮工具调用。
本地部署这个领域的模型不止它一家。想找一个更轻、自带视觉能力的,可以看「MiniCPM-V 4.7 本地部署教程:3GB 内存跑 35B 模型」;想要无独显也能稳定跑起来,参考「EmbeddingGemma 2 本地部署教程:无独显 5 步跑通」更合适。它们换的都是后端和权重,思路和本篇一致。
如果还在犹豫要不要上本地开源,而不是继续用闭源 API,结合「开源模型和闭源模型怎么选?一张对比表讲清 6 个真实成本」,把隐私、算力、维护这几笔账算明白,再看这是不是你的长期方案。
常见问题
LFM2.5-24B-A2B 需要多少显存?
官方参考约 15GB 显存,Apple M5 Max 上可到 184 tok/s、AMD Ryzen AI Max+ 395 上 114 tok/s。显存不够可以量化权重或压缩上下文,但要牺牲一些速度。
transformers 版本有什么要求?
模型卡标明 transformers 大于等于 5.0.0。加载时版本低会报错,先 pip install -U "transformers>=5.0.0"。
支持中文部署吗?
支持。模型覆盖包括中文在内的 16 种语言,词表从 65K 扩到 128K,专门改善了非拉丁文字分词,中文部署不需额外处理。
2026 年这个模型要钱吗?
权重开放,发布在 Hugging Face,部署免费。llama.cpp、MLX、vLLM、SGLang 这些后端也是免费的。
没有独立显卡能跑吗?
能。Ryzen AI Max+ 395 这类把显存吞进内存的 AI 笔记本都能跑,Mac 走 MLX 也可以。纯 CPU 老机器会慢,不建议作主用场景。
 京ICP备2024094994号-29