
EmbeddingGemma 2 本地部署教程:无独显 5 步跑通
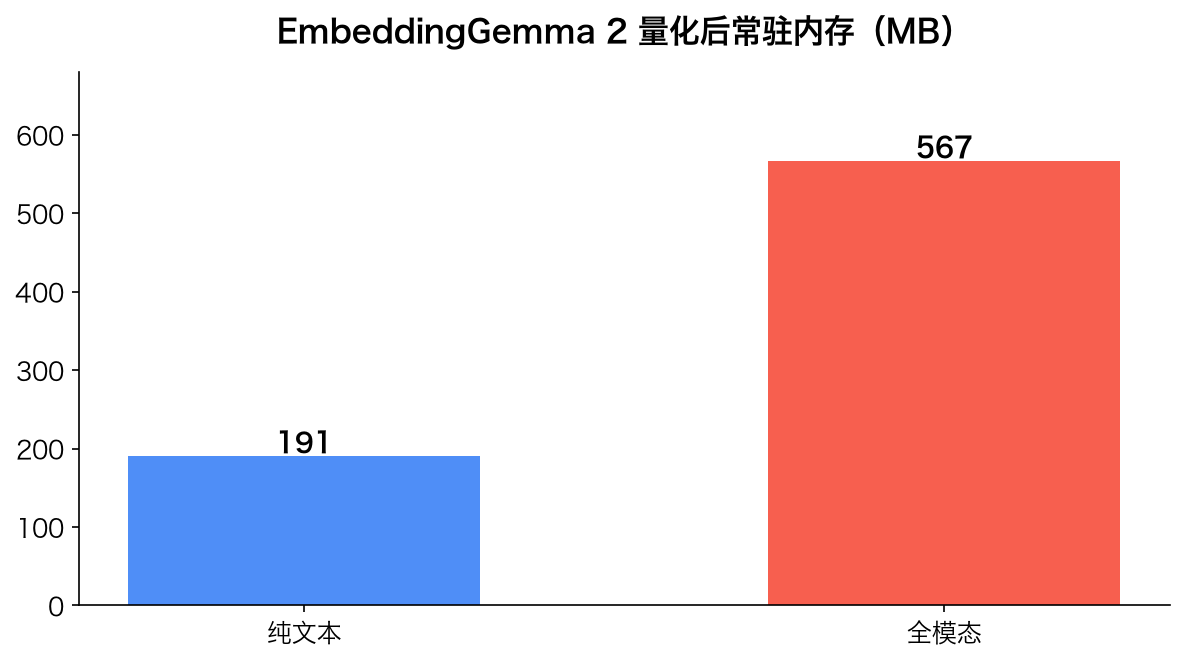
谷歌 EmbeddingGemma 2 于 2026 年 10 月 6 日开源,是谷歌首个原生多模态开源嵌入模型,Apache 2.0 许可,本地部署免费且可商用。完整流程 5 步:下载权重、装依赖、跑通一个 Python 脚本、按需加载视觉与音频模块、用 MRL 截断省存储。CPU 就能跑,无独显 MacBook 也有实测先例,纯文本量化版只占约 191MB 内存。
这个模型能干什么:先把嵌入模型说清楚
嵌入模型是把内容变成一串数字(向量)的模型,相当于在一张地图上给每段内容标一个坐标,语义相近的坐标挨得近,不相干的离得远。AI 搜索、推荐、知识库(RAG)背后都靠它。
EmbeddingGemma 2 的特别之处,是第一次把文字、代码、图片、视频、音频全部标进同一个 768 维空间。以前搜图片要先配文字说明,搜录音要先转成文字;现在一张火烈鸟的照片、一段火烈鸟的视频、一段解释火烈鸟为什么是粉红色的文字,坐标都邻近,搜其中一个,另外两个也会被带出来。
模型按模块拆分,用不上的部分可以不加载:
| 模块 | 参数量 | 干什么用 |
|---|---|---|
| 文本 | 2.7 亿 | 文字、代码检索 |
| 视觉 | 1.7 亿 | 图片、视频检索 |
| 音频 | 3 亿 | 声音、语音检索 |
| 全模态合计 | 7.4 亿 | 全部加载,量化后约 567MB 内存 |
其他几个关键数字:上下文窗口 8K token,是上一代的 4 倍,能直接处理约 5.5 分钟音频、29 张图片或 58 帧视频;代码检索在 MTEB Code 上从 68.76 分涨到 78.68 分,超过阿里 Qwen3-Embedding-0.6B 的 75.41;纯文字综合跑分 61.36,和上一代基本持平。
时效信息:为什么现在补这篇教程
信息发布时间:谷歌 2026 年 10 月 6 日开源(华尔街见闻 10 月 7 日报道、IT之家 10 月 7 日报道、新浪科技 10 月 12 日中文实测),同日发布的还有 Nano Banana 2.1。
截至本文写作,中文网络上的相关内容以新闻和实测分享为主,还没有一篇逐步的本地部署教程,这篇补上这个空缺。
想先体验再动手部署,有三条路径:手机装谷歌官方 App Google AI Edge Gallery,用「即时媒体搜索」和「视频时刻查找」直接搜本地相册;浏览器打开 Hugging Face 官方网页演示搜中文;开发者按下面的步骤在本机部署。谷歌全家桶的更多用法可以看《Gemini Studio 使用指南》。
部署前准备:CPU 可跑,建议满足这几项
硬件:CPU 就能跑。新浪科技的实测就是在无独显 MacBook Pro 上完成的,24 张照片用中文描述搜索,23 次首个结果正确。建议内存 8GB 以上,量化权重纯文本约 191MB、全模态约 567MB。
软件:Python 3.10 以上,pip 可用。不想写代码的用 Ollama 或 LM Studio。
网络:权重在 Hugging Face 与 Kaggle 发布,国内直连 Hugging Face 不稳定时,可改用社区镜像站(如 hf-mirror.com,非官方,注意甄别)或从 Kaggle 下载。
费用:模型 Apache 2.0 许可,本地推理零 API 费用。对比之下,同源技术的 Gemini Embedding 云 API 是按量付费的,免费与付费额度的盘点见《Gemini CLI 免费额度与定价》。
第一步:下载模型权重,三选一
- Hugging Face:打开官方模型卡页面,选量化(quantized)版下载,仓库 ID 以模型卡标注为准。
- Kaggle:谷歌同步在 Kaggle 发布权重,适合 Kaggle 用户直接拉取。
- Ollama:一行命令拉取
ollama pull embeddinggemma-2(新浪实测文章推荐的方式),之后本地即可直接跑检索。
第二步:安装 Python 依赖
最小方案装 sentence-transformers,多模态方案再装最新版 transformers:
pip install sentence-transformers
多模态(图片/音频)加载需要的配套依赖,以 Hugging Face 模型卡上的说明为准,不同版本对 transformers 的版本要求不同。
第三步:最小 Python 示例,先跑通文本嵌入
from sentence_transformers import SentenceTransformer

# 仓库 ID 以 Hugging Face 模型卡为准
model = SentenceTransformer('google/embeddinggemma-2')

texts = [
    '一只趴在键盘上睡觉的猫',
    '早高峰挤满人的地铁车厢',
    '今天天气不错',
]
embeddings = model.encode(texts)
print(embeddings.shape)  # (3, 768)

# 用余弦相似度做最简单的语义检索
query = '我家主子在电脑上睡着了'
q_vec = model.encode([query])
sims = [
    (t, float(q_vec @ e / (q_vec[0].norm() * e.norm())))
    for t, e in zip(texts, embeddings)
]
print(sorted(sims, key=lambda x: -x[1])[0])
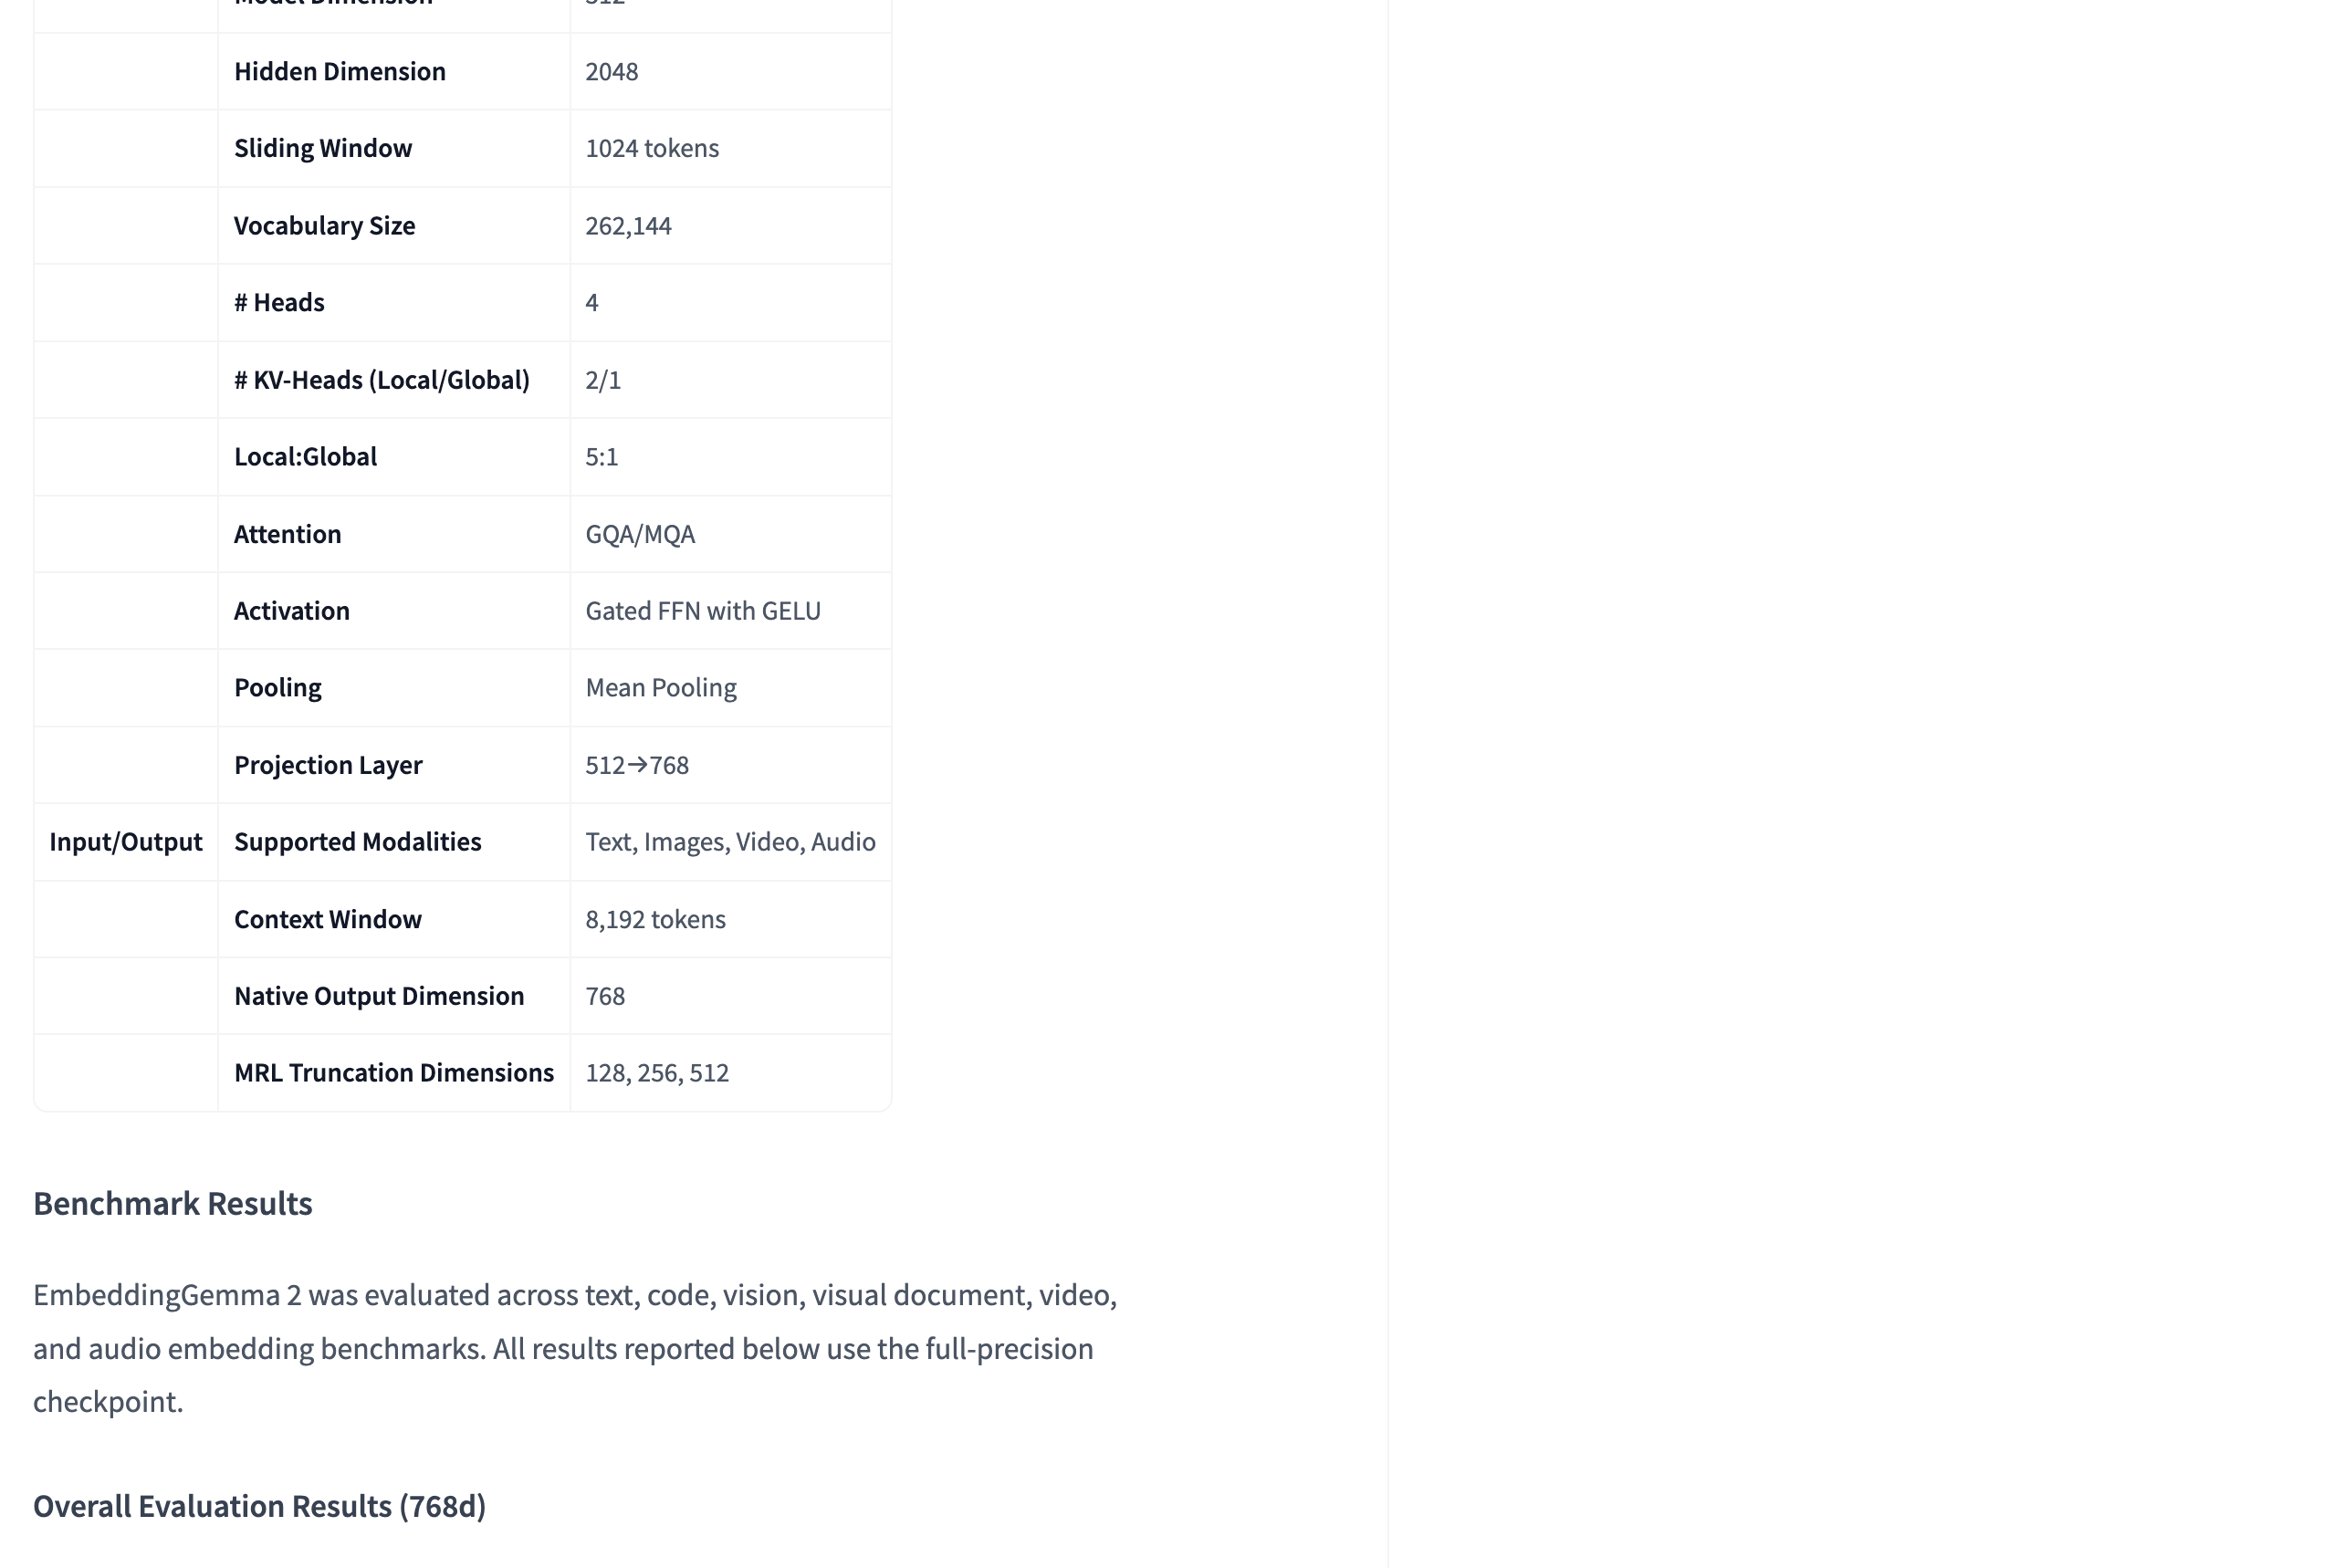
预期结果:embeddings.shape 打印 (3, 768),排序第一的是和「我家主子在电脑上睡着了」语义最近的文本。向量维度 768 是 EmbeddingGemma 2 的输出维度。
第四步:三种按需加载策略,内存从 191MB 到 567MB
这是 EmbeddingGemma 2 省内存的核心设计,按使用场景决定加载哪些模块:
- 只做文字/代码检索:只加载 2.7 亿参数的文本部分,量化后约 191MB 内存,笔记本、手机都能轻松带起来。
- 加视觉检索:加载 1.7 亿参数视觉编码器,用于图片和视频检索,截图找字这类场景表现尤其好。
- 全模态:再加载 3 亿参数音频编码器,文字、图片、视频、音频全支持,量化后约 567MB 内存。
| 场景 | 加载策略 | 内存参考 |
|---|---|---|
| 本地文件/代码库索引 | 纯文本 | 量化后约 191MB |
| 相册图片/视频检索 | 文本 + 视觉 | 官方未单独公布(介于 191MB 与 567MB 之间) |
| 音视频+文字全量检索 | 全模态 | 量化后约 567MB |
多模态场景官方提供了 MediaPipe、LiteRT 移动端方案,浏览器可用 transformers.js 和 WebGPU 跑,服务端用 transformers 或 Ollama。速度参考(谷歌官方数据):M5 Pro 芯片 MacBook Pro 纯 CPU 处理一张图约 0.15 秒,Pixel 11 Pro XL 用 NPU 约 0.05 秒。
第五步:MRL 维度截断,向量库存储最高省 6 倍
EmbeddingGemma 2 支持 Matryoshka 表示学习(MRL):输出向量默认 768 维,可以截断到 512、256 甚至 128 维,语义信息损失不大,但向量数据库的存储和内存最多能省到原来的六分之一。
emb = model.encode(['一段待入库的文本'])[0]
emb_128 = emb[:128]  # 截断到 128 维
# 检索时所有入库向量和查询向量必须用同一个截断维度
截断维度越低,向量库越小、检索越快,但极端情况下召回精度会下降。建议先在 256 维上试跑,批量索引大时再往下降。
怎么确认部署成功
- 脚本正常打印 (3, 768),说明模型加载成功、输出 768 维向量。
- 中文语义检索 top1 符合直觉。参考实测:中文描述搜照片 24 次 23 次首个正确,截图检索 16 次 15 次首个正确(新浪科技实测数据)。
- 换一张真实图片或一段录音跑一次跨模态检索,能返回语义相近的另一模态内容,全模态就打通了。
常见坑与报错速查
| 现象 | 原因 | 解法 |
|---|---|---|
| 中文语音检索经常找错 | 中文音频模态目前偏弱,实测中文语音找图 6 次只对 1 次,环境声中文描述 15 段对 4 段 | 语音检索场景先用英文查询,或暂时只用文本/图片检索 |
| 音频检索召回一般 | 音频维度表现输给 jina-embeddings-v5-omni-nano | 需要商用许可的选 EmbeddingGemma 2(jina 该模型为非商用许可) |
| 权重下载慢/失败 | Hugging Face 直连不稳 | 用社区镜像(hf-mirror.com)或 Kaggle 下载 |
| 加载报 OOM | 全模态权重超内存 | 只加载纯文本部分,或用量化版 |
| 模型 ID 加载报错 | 仓库 ID 或依赖版本不匹配 | 以模型卡标注的 ID 与依赖要求为准 |
部署好之后,可以把嵌入模型和生成模型组合成端侧 RAG:谷歌同源的 Gemma 4 与 EmbeddingGemma 2 共享分词器和音频编码器,能在同一流水线里跑,数据不出本地。谷歌多模态模型的更多实测可以看《Gemini Omni 1.1 Flash 实测》和《Gemini Skills 与 Claude Skills 对比》。
常见问题
EmbeddingGemma 2 本地部署需要显卡吗?
不需要。CPU 就能跑,新浪科技用无独显 MacBook Pro 实测通过,M5 Pro 芯片纯 CPU 处理一张图约 0.15 秒。纯文本量化版内存仅约 191MB,8GB 内存的机器完全够用。
EmbeddingGemma 2 免费吗?可以商用吗?
免费且可商用。模型采用 Apache 2.0 许可开源,本地推理不产生 API 费用。对比之下,同源技术的 Gemini Embedding 只能调用云端 API,用量大了要按量付费。
EmbeddingGemma 2 中文搜图片效果怎么样?
中文图片检索表现好。新浪科技实测:24 张照片用中文描述搜索,23 次首个结果正确;截图检索 16 次 15 次首个正确,搜「胆固醇偏高」能直接找到体检报告截图。
EmbeddingGemma 2 中文语音检索靠谱吗?
目前不推荐。实测中文语音找图 6 次只对 1 次,中文环境声描述 15 段只对 4 段,明显弱于英文。语音场景建议先用英文查询,或等后续版本优化。
EmbeddingGemma 2 和 Gemini Embedding 是什么关系?
同一套底层技术。谷歌官方称 EmbeddingGemma 2 与 Gemini Embedding 同源,但前者开源可本地部署、完全免费,后者是云端按量付费 API,可以理解成免费开源的青春版。
手机和浏览器能跑 EmbeddingGemma 2 吗?
能。手机可用谷歌官方 App Google AI Edge Gallery(含「即时媒体搜索」「视频时刻查找」),开发可用 MediaPipe 和 LiteRT;浏览器有 Hugging Face 网页演示,也支持 transformers.js 与 WebGPU 方案。
 京ICP备2024094994号-29