
d1-3B 本地部署教程:显存要求与 5 步跑通第一次推理
核心答案:d1-3B 本地部署总共 5 步:检查显卡与安装环境、下载权重、Transformers 跑通第一次推理、llama.cpp 起服务(可选)、验证概率输出。12GB 显存显卡即可流畅运行,RTX 3060 实测峰值显存约 6GB、单问 25 毫秒,全程免费(年收入低于 1000 万美元可商用)。
部署前先认清:d1-3B 是决策模型,不是聊天模型
d1-3B 是 LiquidAI 于 2026 年 10 月 7 日随 Open d1 系列开源的 3.12B 参数决策模型。它不做逐 token 的文本生成,而是接收「一个状态 + 一组命名问题」,一次前向传播直接返回每个答案的校准概率,输出 token 数为 0。官方发布的 Open d1 博客 给出了完整说明。
官方定义了三种问题原语(详见 Liquid 官方文档):
- Noul:是非题,返回 0 到 1 之间的概率,例如「这条消息是不是垃圾邮件」
- Choice:从多个命名选项中选一个,返回选项上的概率分布,例如「这张工单该分给哪个团队」
- Score:在有序刻度上打分,返回概率加权的位置,例如「这个 bug 有多严重」
多个问题可以在一次调用里共享同一个状态。例如给一段客服对话,同时问退款意图、处理团队、紧急程度三个问题,模型读一遍输入,三个答案一起返回。
所以部署后不要拿它跑聊天、写文章或生成代码,那会得到「模型不支持生成」的结果。官方推荐的用途是路由、审核、意图分类、重排序、LLM-as-a-judge 打分、智能体护栏和视觉检查。
第 1 步:检查显卡并安装环境
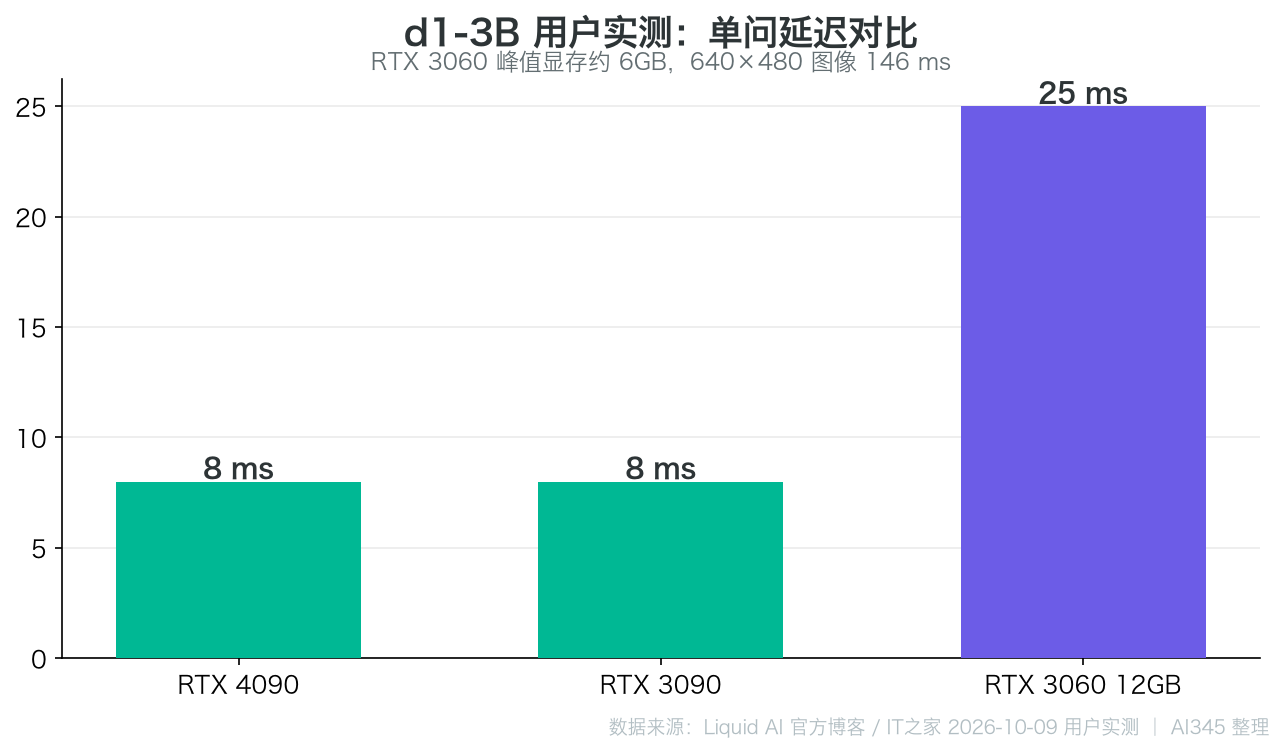
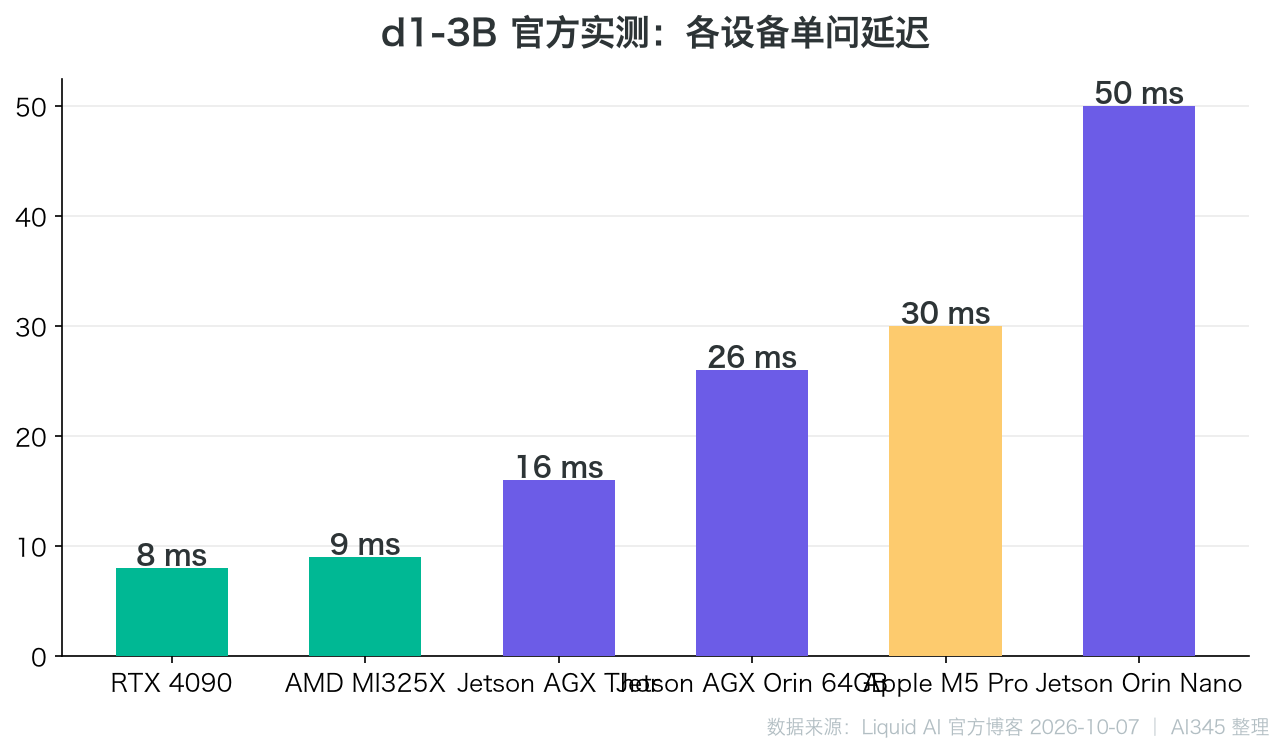
d1-3B 面向英伟达全栈,从数据中心 DGX 到 Jetson 边缘设备都支持,消费级显卡的实测参考线是有 12GB 显存的 RTX 3060。官方没有公布最低显存硬指标,用户实测数据是判断依据(数据来源 IT之家 2026-10-09):
| 显卡 / 设备 | 单问延迟 | 备注 |
|---|---|---|
| RTX 4090 | 8 ms | 官方实测;384px 图像 17 ms、3.4K token 状态 102 ms |
| RTX 3090 | 8 ms | 用户报告 |
| RTX 3060 12GB | 25 ms | 用户实测;640×480 图像 146 ms、峰值显存约 6GB |
| AMD MI325X | 9 ms | 官方实测 |
| Apple M5 Pro | 30 ms | 官方实测 |
| Jetson AGX Thor | 16 ms | 官方实测 |
| Jetson AGX Orin 64GB | 26 ms | 官方实测 |
| Jetson Orin Nano | 50 ms | 官方实测 |
Python 环境建议 3.10 以上。Transformers 方式要求 transformers>=5.14,另需 torch 与 pillow;国内用户下载权重可配置 Hugging Face 镜像(HF_ENDPOINT 指向 hf-mirror.com),避免直连超时。
第 2 步:从 Hugging Face 下载权重
官方提供两个仓库:
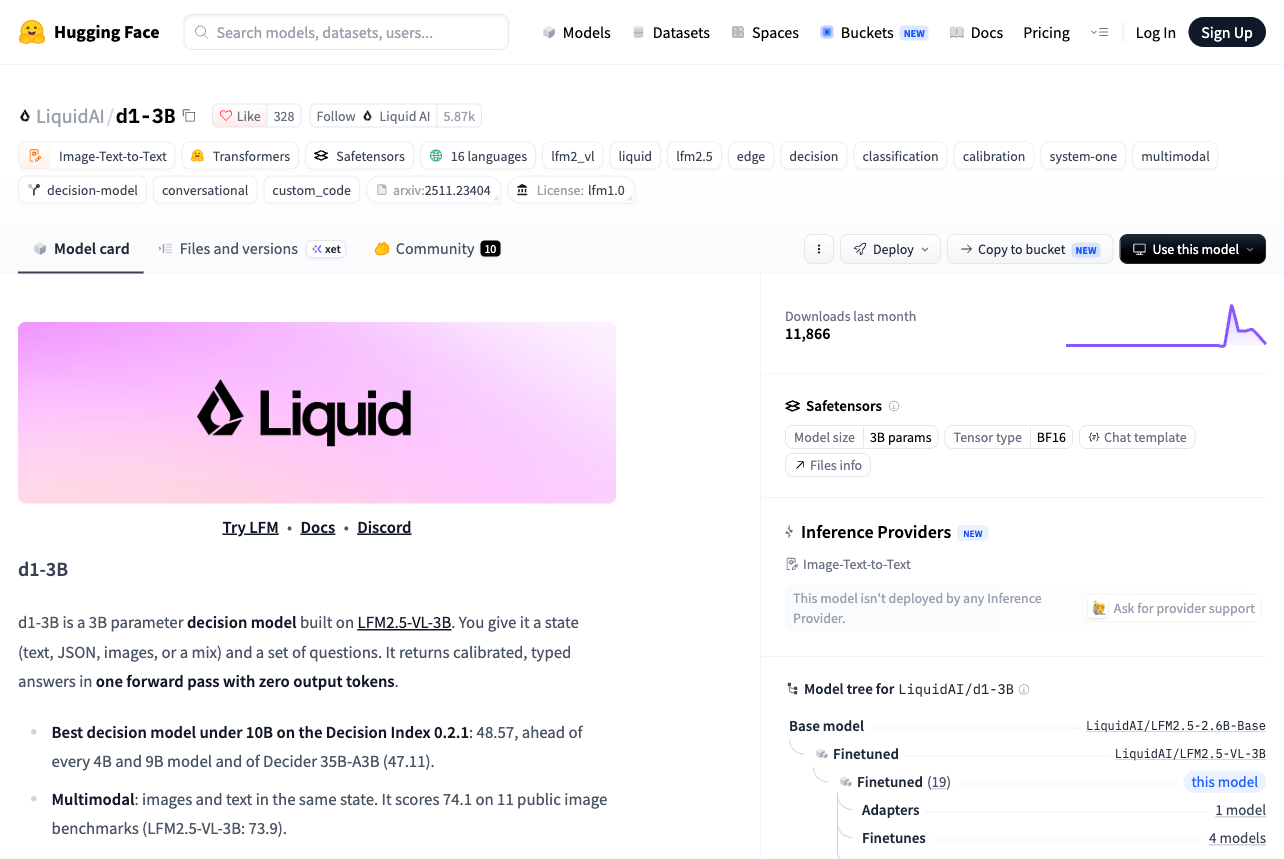
- LiquidAI/d1-3B:safetensors 权重,用 Transformers 加载
- LiquidAI/d1-3B-GGUF:GGUF 量化版,用 llama.cpp 加载,仓库全部量化文件合计约 2.7 GB(Hugging Face 仓库元数据,具体各档位以仓库列表为准)
下载命令:
huggingface-cli download LiquidAI/d1-3B --local-dir ./d1-3B
需要 GGUF 版则把仓库名换成 LiquidAI/d1-3B-GGUF。模型卡标注支持中英文等 17 种语言,上下文 32768 token。
第 3 步:Transformers 跑通第一次推理
安装依赖:
pip install "transformers>=5.14" torch torchvision pillow
官方 Quick Start 代码(来自 Liquid 官方文档 d1-3B 页,模型加载走 AutoModel 加自定义 remote code):
from transformers import AutoModel

model_id = "LiquidAI/d1-3B"
model = AutoModel.from_pretrained(model_id, trust_remote_code=True, dtype="bfloat16", device_map="auto")

state = "I was charged twice this month, please refund one of them."
questions = {
    "refund": {"type": "noul", "instructions": "Is the customer asking for a refund?"},
    "team": {"type": "choice", "instructions": "Which team should handle this?",
             "criteria": {"billing": "Charges, refunds, invoices", "technical": "App or site faults",
                          "fraud": "Suspected unauthorised use"}},
    "urgency": {"type": "score", "instructions": "How urgent is this?",
                "criteria": ["Can wait", "Today", "Blocking the customer now"]},
}
output = model.system_one(state, questions)
print(output)
要点:system_one 是决策模型的入口方法,不是 generate;问题字典里每个键是问题名,值里的 type 决定用 Noul、Choice 还是 Score。图像输入时把 state 传 None,用 images=[photo] 传入 PIL 图片对象。
第 4 步:llama.cpp 起本地服务(可选)
llama.cpp 在发布首日就支持 d1-3B(llama.cpp 官方 PR 合并,媒体报道见 DoNews)。用 GGUF 版直接起 OpenAI 风格的服务:
llama-server -hf LiquidAI/d1-3B-GGUF:Q8_0
然后向 /v1/systemone 发请求,请求体同样是「状态 + 命名问题」结构,图像用 base64 传入。响应里的每个答案带概率,output_tokens 为 0。
第 5 步:验证跑通
跑通的标准是拿到一组归一化概率,而不是一段文字。以第 3 步的代码为例,print(output) 应输出 refund、team、urgency 三个问题的概率分布,各选项概率和为 1;响应里能看到 output_tokens: 0 的标注,说明模型没有生成任何 token。
官方延迟数据可以做参照:RTX 4090 单问 8 ms、3 个问题一次调用 21 ms、3.4K token 长状态 102 ms;Jetson Orin Nano 单问 50 ms。如果你的机器明显慢于这个量级,先检查是否加载了 float32 权重或在用 CPU 推理。
常见报错速查
| 现象 | 原因 | 解法 |
|---|---|---|
| ImportError:transformers 版本过低 | 需要 5.14 以上 | pip install -U "transformers>=5.14" |
| 显存不足 OOM | 显存低于 6GB,或 dtype 未指定 | 用 dtype="bfloat16";或换 GGUF 量化档 |
| 报错提示需要 trust_remote_code | 模型使用自定义代码 | from_pretrained 加 trust_remote_code=True |
| llama-server 命令不存在 | 未安装 llama.cpp | 按 llama.cpp 官方 README 安装后重试 |
| 返回的是聊天文本而非概率 | 用错了加载方式 | 确认走 system_one,而不是 generate |
部署后能做什么
跑通之后,d1-3B 可以直接嵌入 Agent 工作流:模型路由、内容审核、意图分类、重排序、LLM-as-a-judge 打分、智能体护栏,以及带图像输入的视觉检查。同一个状态问多个问题只读一遍输入,适合高并发判断。
商用注意许可证:LFM Open License v1.0,年收入低于 1000 万美元免费,超过需联系官方。决策模型这个品类刚火起来,背景可以看 Jev 是什么:TypeSafe 的系统一模型。
想对比其他可本地部署的开源决策模型,参考 StartLux 决策模型 Ollama 本地部署。
云端决策 API 的接入方式见 Microsoft Decision-1 API 接入指南。更多同类选择可看 Perplexity Decider v1.1 指南。
常见问题
d1-3B 本地部署需要多大显存?
用户实测 RTX 3060 12GB 显卡跑 d1-3B 峰值显存约 6GB,单问 25 毫秒。官方没有公布最低显存硬指标,12GB 显卡是当前有实测验证的稳妥档位,6GB 及以下建议用 GGUF 量化版。
d1-3B 最低要什么显卡?
官方面向英伟达全栈(DGX、RTX 工作站、Jetson),Jetson Orin Nano 单问 50 毫秒可跑。消费级显卡中 RTX 3060 12GB 有用户实测数据,更低显存档位官方未公布数据。
d1-3B 能用来聊天吗?
不能。d1-3B 是决策模型,输入状态加命名问题、输出概率,输出 token 数为 0,不生成任何文字。要聊天请用生成式模型。
d1-3B 支持中文输入吗?
Hugging Face 模型卡标注支持中文等 17 种语言。官方尚未单独公布中文基准测试数据,中文场景建议先拿自己的语料验证。
d1-3B 商用免费吗?
许可证为 LFM Open License v1.0,年收入低于 1000 万美元的商业使用免费,超过该门槛需按官方条款授权。
d1-3B 和普通大模型本地部署有什么区别?
普通大模型用 generate 逐 token 生成,d1-3B 用 system_one 一次前向返回概率,不占输出缓存、没有解码循环,这也是它能做到毫秒级延迟的原因。
 京ICP备2024094994号-29