
Kimi K2.8 和 K3 有什么区别?一张表看懂怎么选
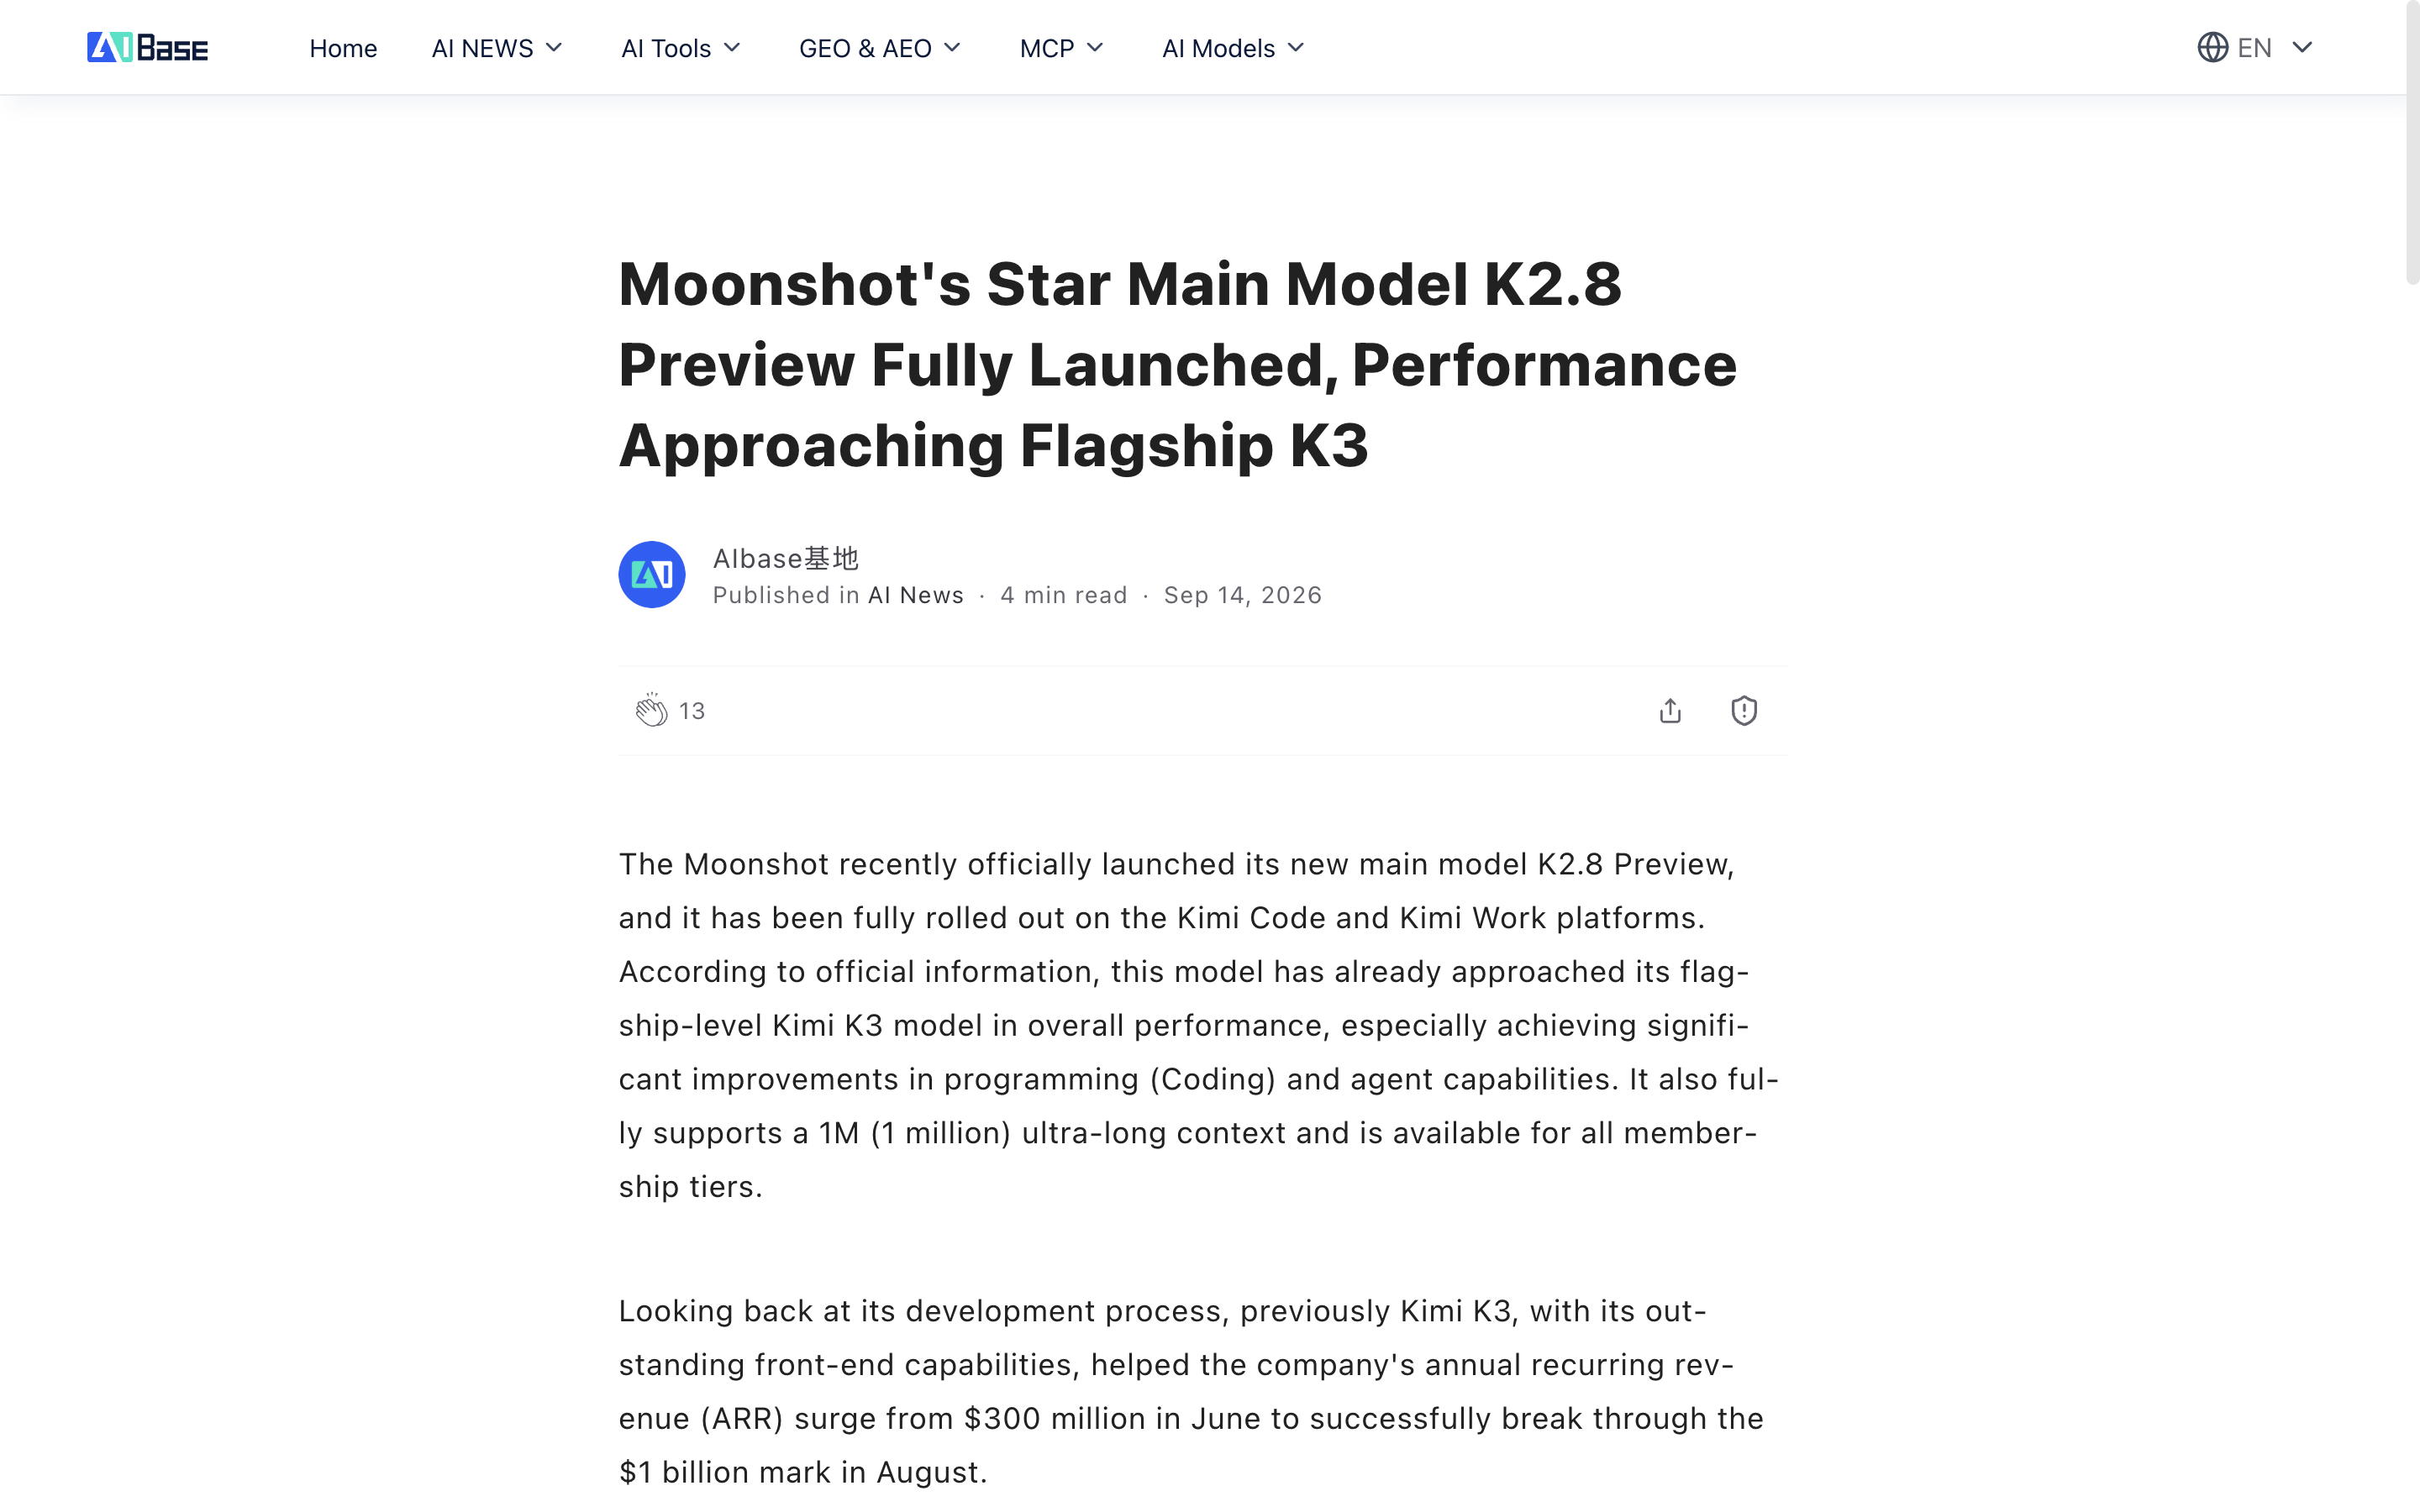
K2.8 Preview 和 K3 的关系一句话讲完:K3 是 Kimi 目前的旗舰天花板,API 开发和追求能力上限选它;K2.8 Preview 是 9 月 12 日上线的产品端新主力,百万上下文面向所有会员档位开放,官方口径整体性能已接近 K3。日常写代码、跑 Agent 任务优先用 K2.8,普通用户没必要纠结。
先看结论:三类人怎么选
- Kimi 会员、日常用 Kimi Code 编程或 Kimi Work 干活:直接用 K2.8 Preview,1M 上下文已对全部会员档位开放,没有额外付费动作。
- 开发者、要走 API 接入:目前只能选 kimi-k3,因为开放平台价格表里还没有 kimi-k2.8 这个模型。
- 追极限性能的重度用户:跑分和复杂推理继续用 K3,K2.8 毕竟带着 Preview 后缀;但如果你只是写业务代码,先试 K2.8 再决定值不值得多花钱。
两个模型分别是什么定位
K3 是月之暗面的旗舰模型。官方文档介绍它拥有 2.8 万亿参数,基于 KDA 混合线性注意力机制(Kimi Delta Attention)和注意力残差(Attention Residuals)构建,MoE 在 896 个专家中激活 16 个,支持 1,048,576 token 上下文窗口、原生视觉理解和 Tool Calling,7 月中旬正式发布。官方还提到,相比 K2 它的整体扩展效率提升约 2.5 倍,完整权重已发布。
据 AIbase 报道,K3 凭借前端能力带动 Kimi 的年经常性收入从 6 月的 3 亿美元冲到 8 月突破 10 亿美元。
K2.8 Preview 则是 9 月 12 日上线的产品端新主力,随后在 Kimi Code 和 Kimi Work 两个产品里全量铺开。官方信息是整体性能已接近旗舰 K3,编程(Coding)和 Agent 能力提升明显,1M 超长上下文面向所有会员档位开放。名字里的 Preview 表明它还是预览版,后续还会迭代。
一张表看懂核心差异
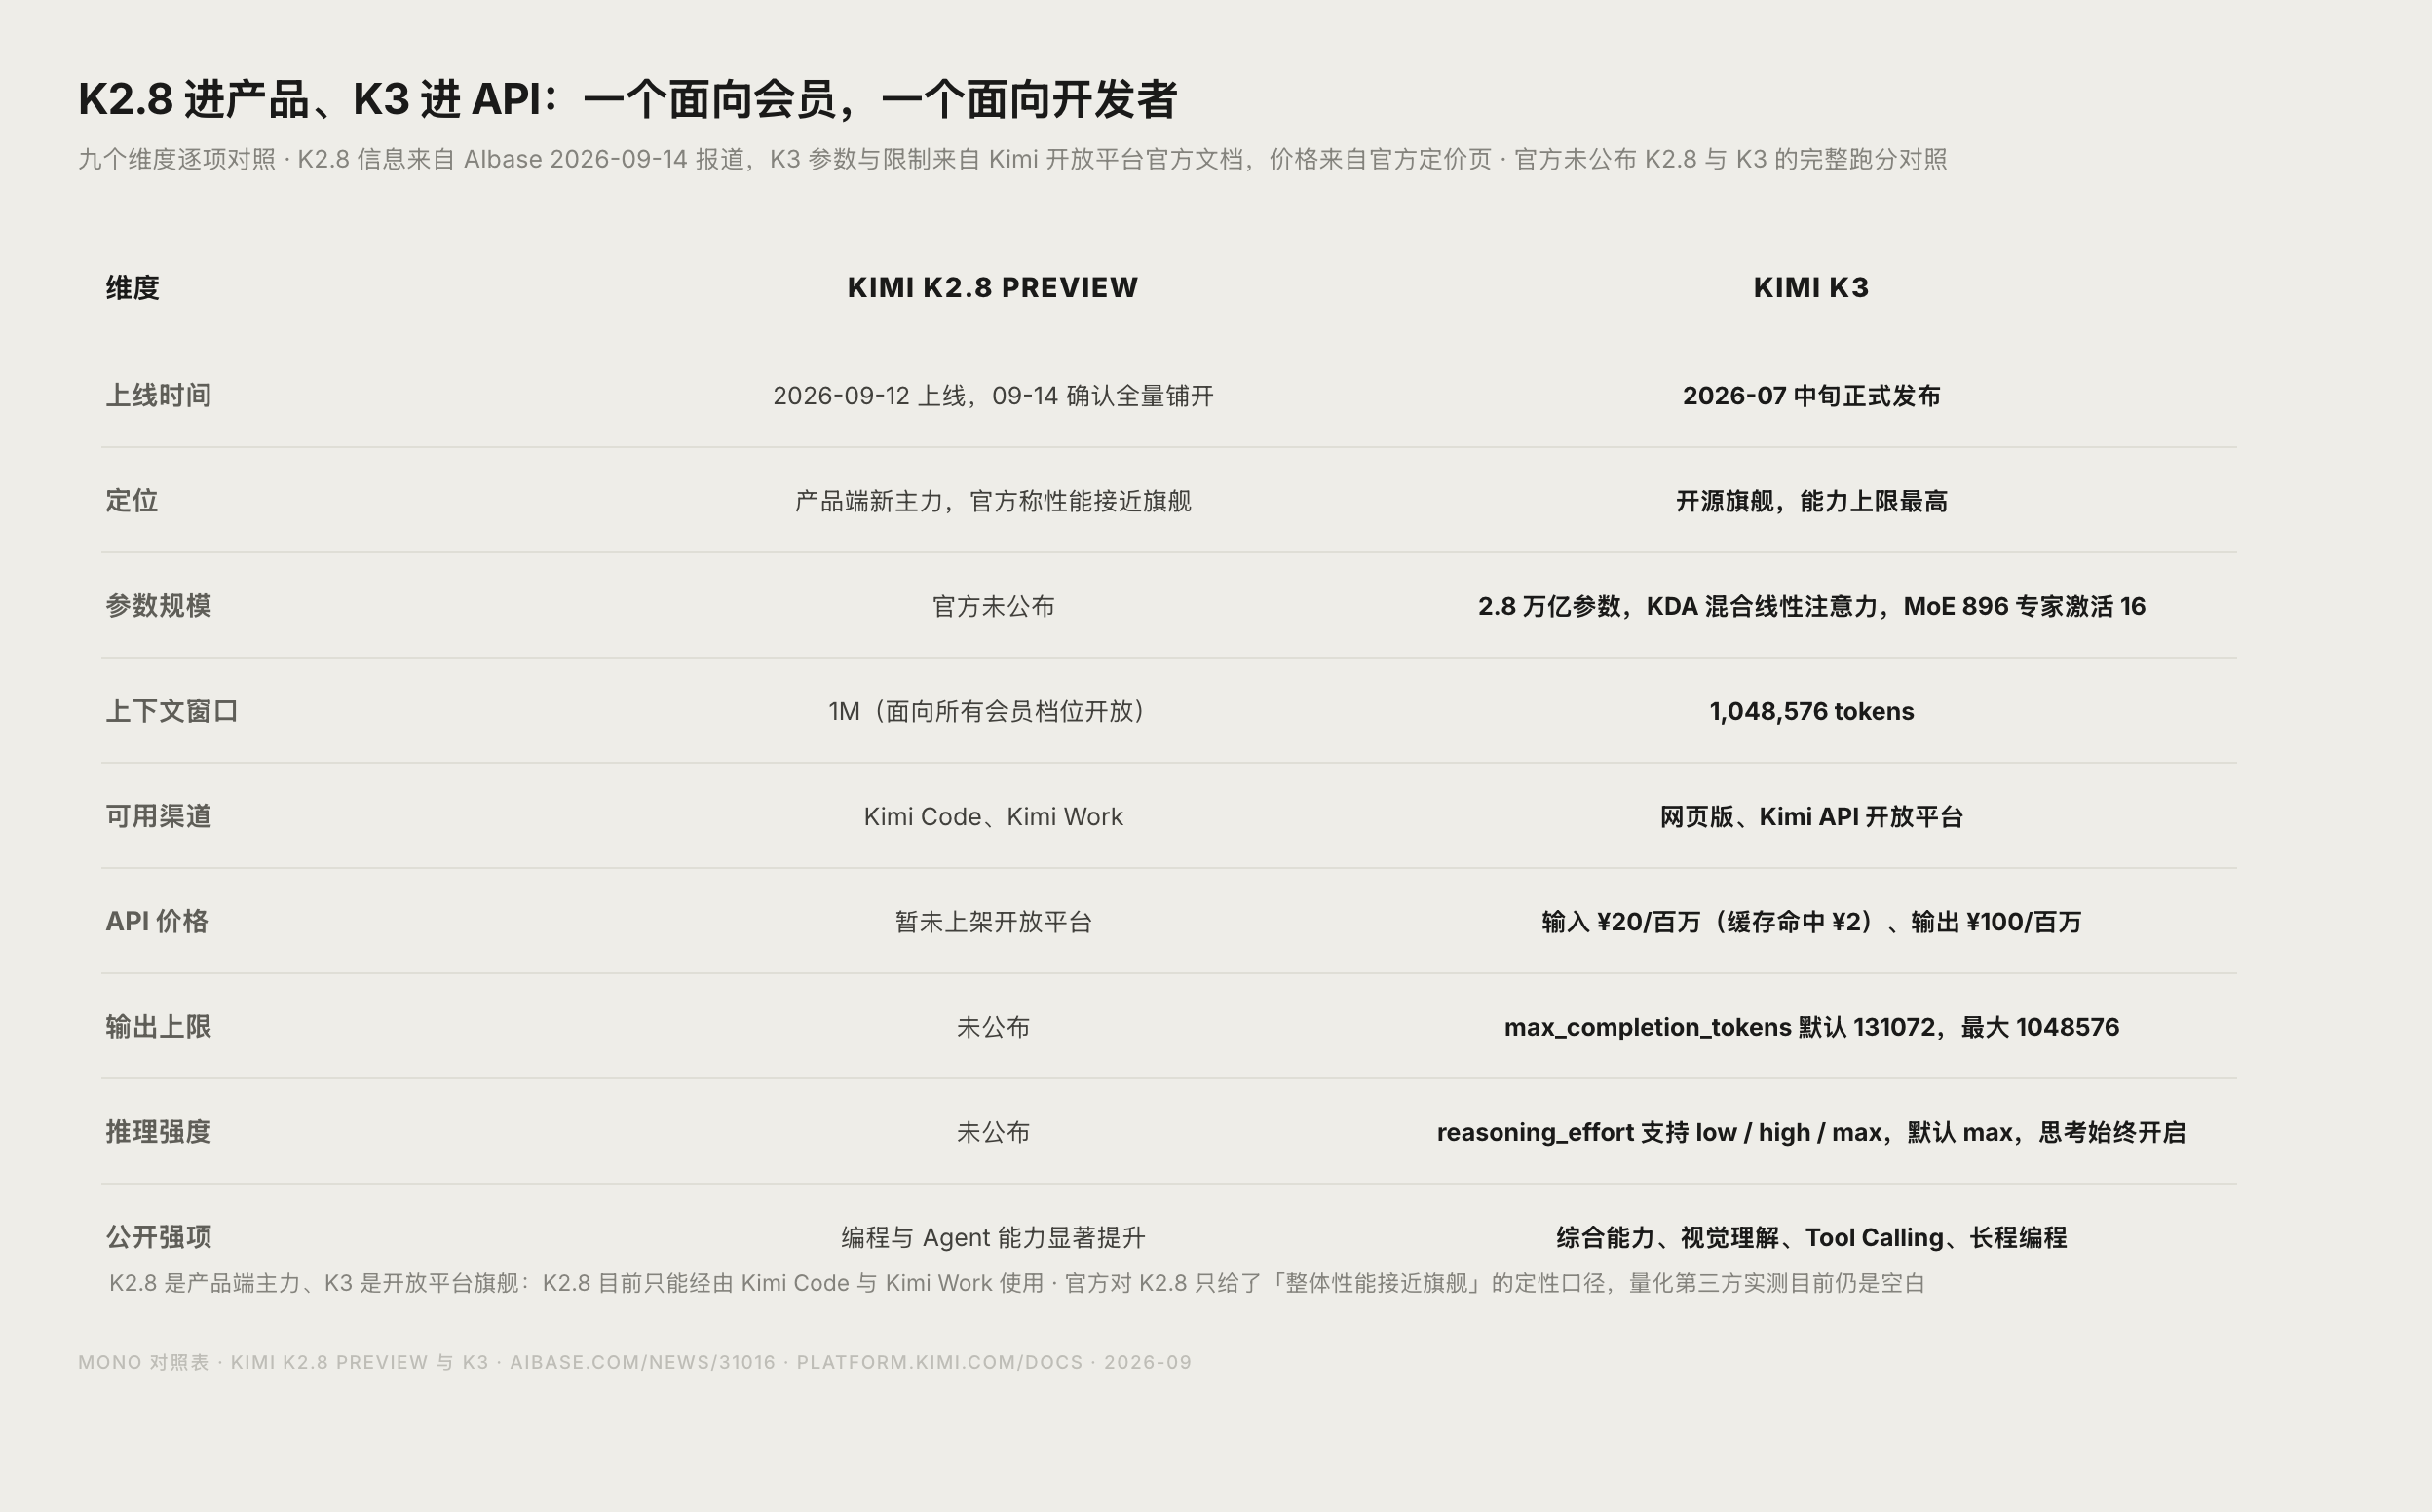
| 维度 | Kimi K2.8 Preview | Kimi K3 |
|---|---|---|
| 上线时间 | 2026 年 9 月 12 日(9 月 14 日确认全量铺开) | 2026 年 7 月中旬正式发布 |
| 定位 | 产品端新主力,性能接近旗舰 | 开源旗舰模型,能力上限最高 |
| 参数规模 | 官方未公布 | 2.8 万亿参数,KDA 混合线性注意力,MoE 896 专家激活 16 |
| 上下文窗口 | 1M(全会员档位开放) | 1,048,576 tokens |
| 可用渠道 | Kimi Code、Kimi Work | 网页版、Kimi API 开放平台 |
| API 价格 | 暂未上架开放平台 | 输入 ¥20/百万 tokens,输出 ¥100/百万,缓存命中输入 ¥2 |
| 输出上限 | 未公布 | max_completion_tokens 默认 131072,最大可设 1048576 |
| 推理强度 | 未公布 | reasoning_effort 支持 low / high / max,默认 max,思考始终开启 |
| 公开强项 | 编程与 Agent 能力显著提升 | 综合能力、视觉理解、Tool Calling、长程编程 |
数据说明:K2.8 信息来自 AIbase 9 月 14 日报道,K3 参数、能力与限制来自 Kimi 开放平台官方文档,价格来自 官方定价页。
能力差距到底有多大
官方没有放出 K2.8 与 K3 的完整跑分对照,只给了「整体性能接近旗舰」的定性口径,重点强调编程和 Agent 两项的提升。这正是 Preview 版的常见定位:用更低的资源成本给你旗舰九成左右的体验。
诚实地说,量化的第三方实测目前还是空白。公开发布里能拿到的一手信息只有三类:一是官方文档里 K3 的架构与能力描述(2.8 万亿参数、KDA、原生视觉、1M 上下文),二是官方对 K2.8「接近旗舰、编程与 Agent 提升明显」的定性口径,三是 K3 已验证的产品化能力清单,比如长程编码、截图与视觉反馈驱动的前端与 CAD 任务。建议等权威基准更新后回看本文,届时会补充实测数据。
有一条判断经验是站得住的:K2.8 带 Preview 后缀,意味着官方自己也没把它定成终版。追极限能力或有视觉输入需求,选 K3;要的是日常稳定与成本可控,K2.8 就是当前产品端的最优解。
开发者视角:API 该用哪个
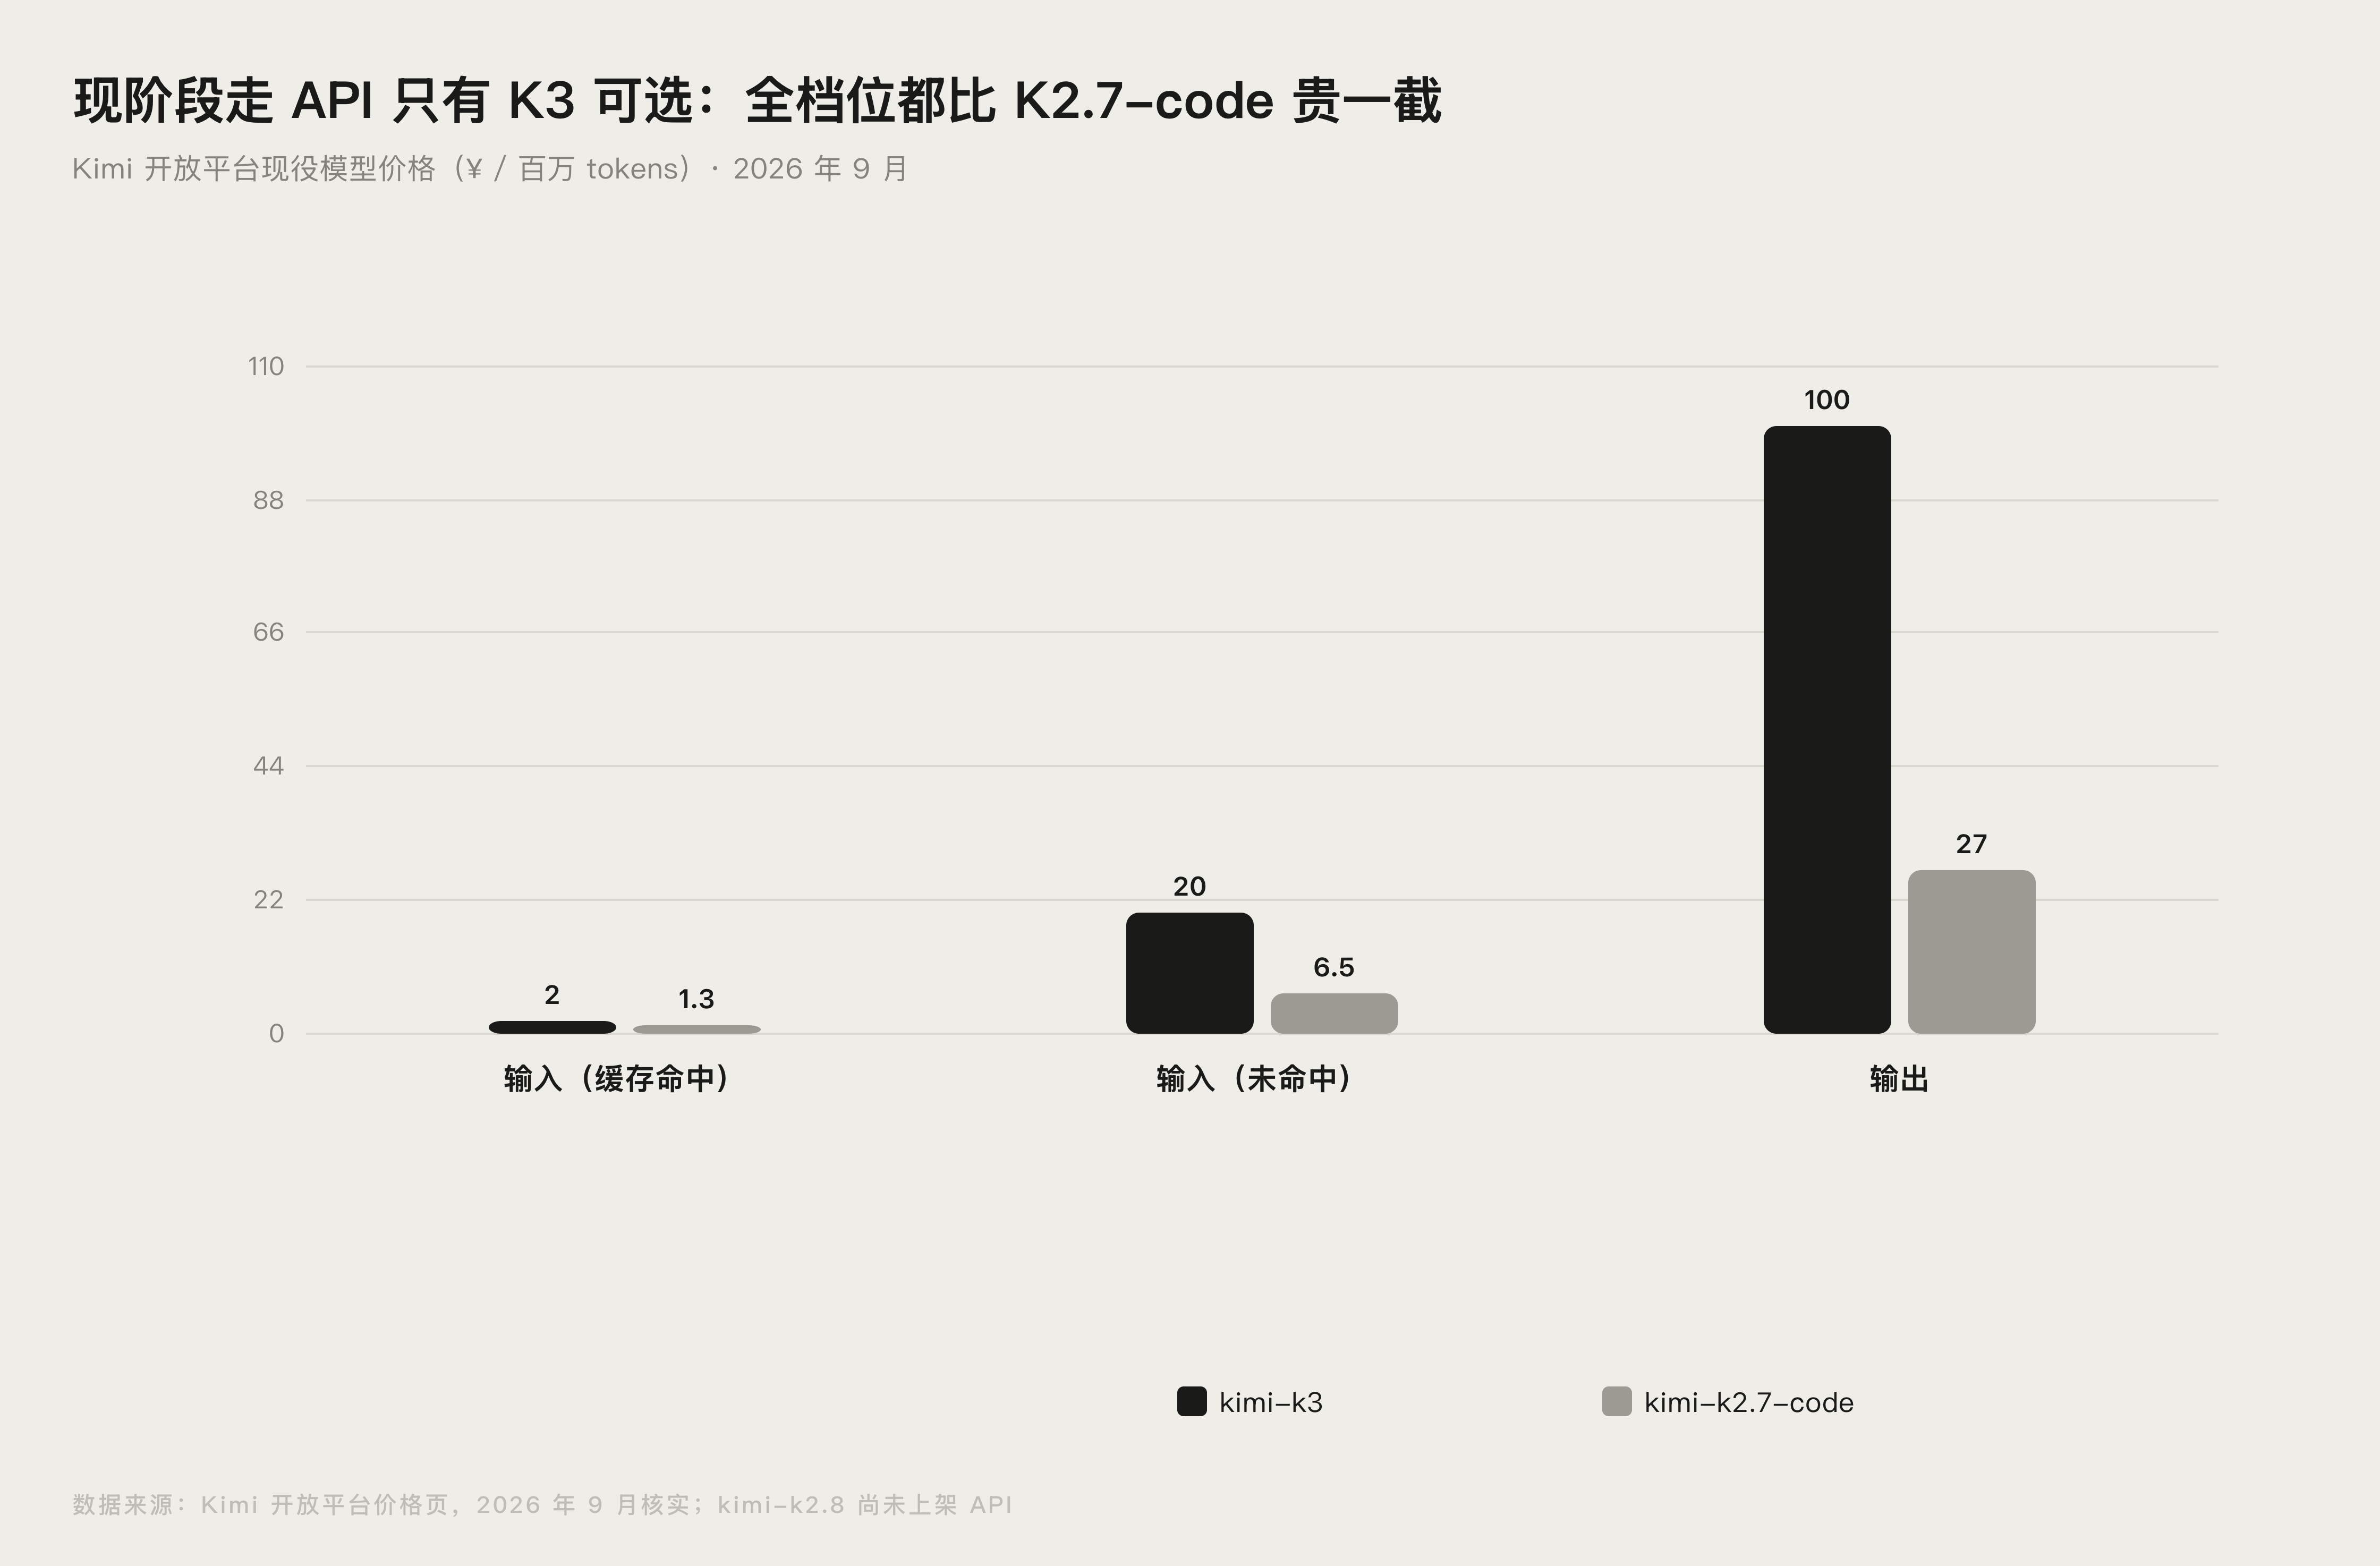
现阶段没有悬念,走 Kimi 开放平台只能调在售的这几个模型,价格全部来自官方定价页(每 1M tokens,1M = 1,000,000):
| 模型 | 输入(缓存命中) | 输入(未命中) | 输出 | 上下文窗口 |
|---|---|---|---|---|
| kimi-k3 | ¥2.00 | ¥20.00 | ¥100.00 | 1,048,576 tokens |
| kimi-k2.7-code | ¥1.30 | ¥6.50 | ¥27.00 | 262,144 tokens |
| kimi-k2.7-code-highspeed | ¥2.60 | ¥13.00 | ¥54.00 | 262,144 tokens |
| kimi-k2.6 | ¥1.10 | ¥6.50 | ¥27.00 | 262,144 tokens |
已下线、调用会返回 404 的是 kimi-k2.5 与 moonshot-v1 系列(2026 年 8 月 31 日)、以及更早退役的 kimi-k2 系列。另外 K3 需要在开放平台充值解锁(最低 10 元),新用户注册认证赠送的 15 元代金券不可用于 K3。
成本怎么算:按官方单价折算的两个场景
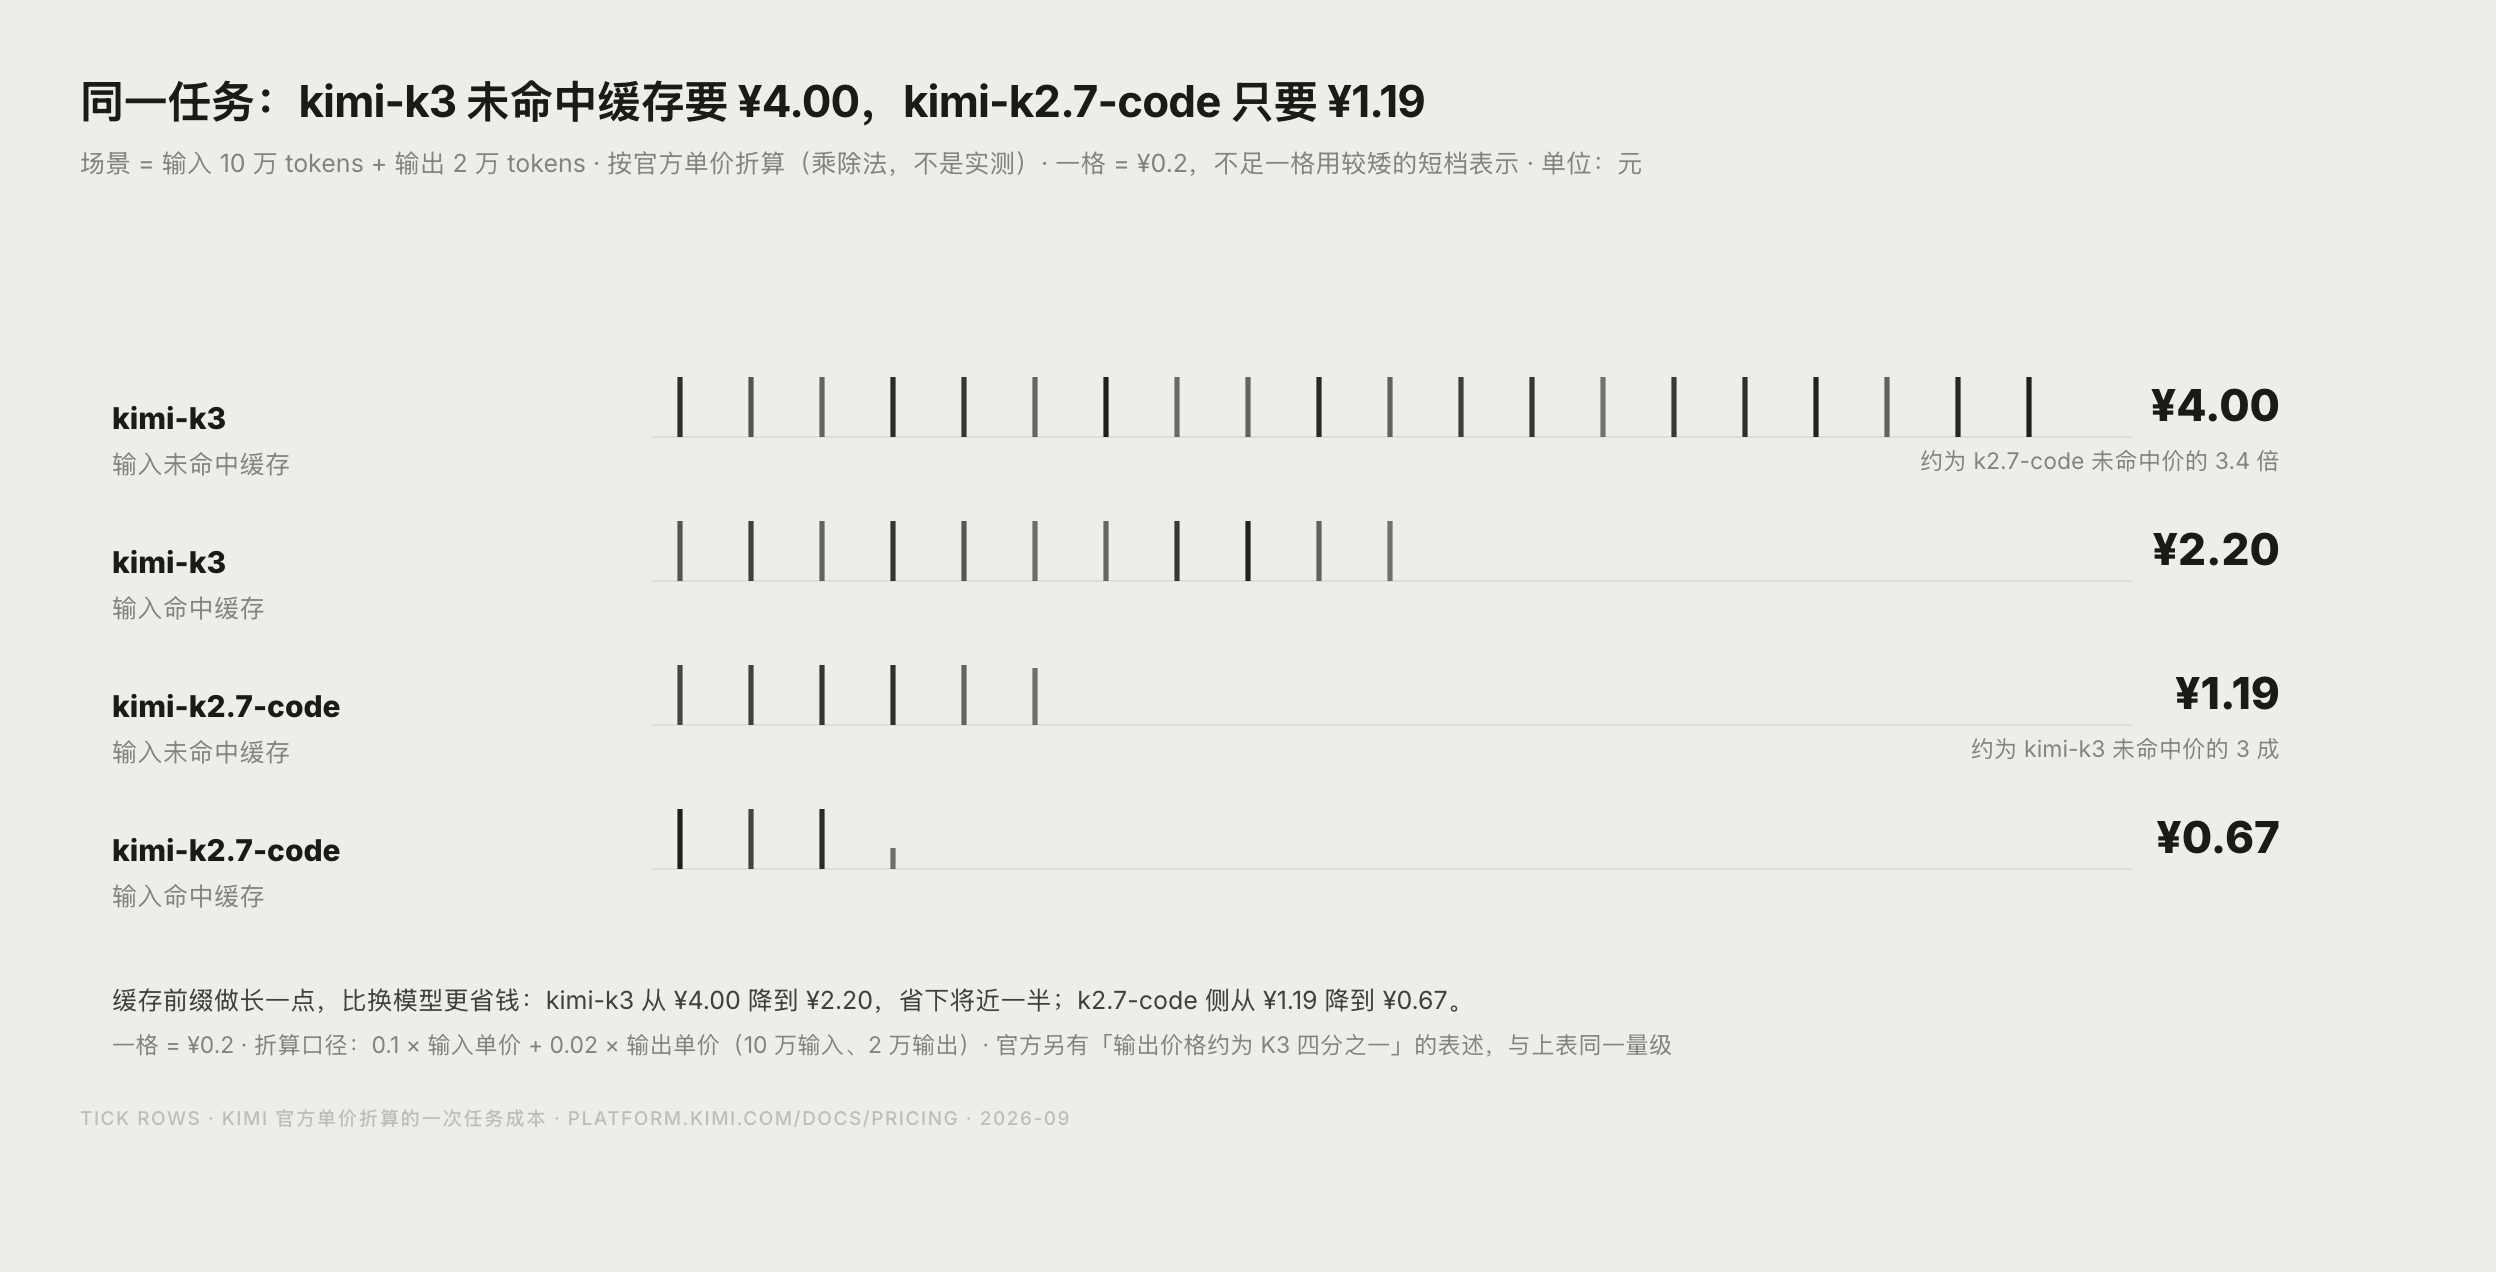
按官方单价折算(不是实测,只是乘除法),差距很直观。假设一次任务输入 10 万 tokens、输出 2 万 tokens:
- 输入全部未命中缓存:kimi-k3 是 0.1 × ¥20 + 0.02 × ¥100 = ¥2.00 + ¥2.00,合计约 ¥4.00;kimi-k2.7-code 是 0.1 × ¥6.50 + 0.02 × ¥27 = ¥0.65 + ¥0.54,合计约 ¥1.19。
- 输入全部命中缓存:kimi-k3 的输入单价降到 ¥2,合计约 ¥2.20;kimi-k2.7-code 的输入降到 ¥1.30,合计约 ¥0.67。
也就是说,纯代码场景用 kimi-k2.7-code,成本大致是 K3 的三成不到,官方口径里「输出价格约为 K3 四分之一」的说法也是同一个量级。预算敏感、任务又是批量重复的,先把缓存前缀做长,比换模型省得更多。
迁移与切换成本:从 K2 系列换到 K3 要改什么
如果是从旧 Kimi 模型迁过来,这几条官方限制必须提前知道,否则上线才发现:
- 旧模型直接 404。kimi-k2.5 和 moonshot-v1 系列 8 月 31 日下线,kimi-k2 系列 5 月退役,硬编码的模型名必须替换。
- 多轮与工具调用必须原样回传完整 assistant message。只保留
content,模型会丢掉工具调用链路,表现是「多聊几轮就失忆」。 - 思考模式关不掉。K3 始终开启思考,延迟敏感的场景只能把
reasoning_effort设成low,不能在请求里彻底关闭。 - 缓存有 256 tokens 门槛。上一个请求的 prompt 不足 256 tokens 时不会被缓存,而是被丢弃;稳定的长前缀(知识库、代码库上下文)要放在前面。
- 固定参数别乱传。
temperature=1.0、top_p=0.95、n=1、presence_penalty=0、frequency_penalty=0都是固定值,显式传反而容易出问题。 - 视觉输入不支持公网图片 URL。必须用 base64 或
ms://<file-id>,且content必须是对象数组。 - 联网搜索暂不建议用于生产。官方文档写明该工具正在更新。
对比其他国产模型的选择逻辑,可以参考站内的 ChatGPT Work 和 Claude Cowork 对比以及 DeepSeek V4 Pro 免费渠道实测。想知道 K2.8 本身是什么、怎么用上,可以看 [Kimi K2.8 Preview 是什么?
9月12日上线](https://www.ai345.info/ai-guide/kimi-k2-8-preview-explained)。
常见问题
K2.8 会取代 K3 吗?
答:不会。两者定位不同:K3 是开源旗舰,走 API 和开源生态;K2.8 是产品端的接近旗舰版本,官方还在持续迭代 K3 生态。
K2.8 什么时候上 API?
答:官方未公布时间表。截至发稿,开放平台价格表里只有 kimi-k3、kimi-k2.7-code、kimi-k2.7-code-highspeed 和 kimi-k2.6,没有 kimi-k2.8,一切以官方公告为准。
用 K2.8 需要开哪个档位的会员?
答:官方口径是 1M 超长上下文已面向所有会员档位开放,没有要求特定高档位。具体档位权益以 Kimi 会员页面实时说明为准。
写代码选 K2.8 还是 K3?
答:在 Kimi Code 里没得选,新主力就是 K2.8,直接用;走 API 的代码场景选 kimi-k3,预算紧可以用 kimi-k2.7-code 过渡,成本约为 K3 的四分之一。
Preview 是什么意思?
答:预览版。模型已可用且官方称整体性能接近旗舰,但仍处于快速迭代阶段,正式版可能在性能和稳定性上继续提升。
K3 的 1M 上下文和 K2.8 的 1M 是同一回事吗?
答:官方给的窗口规格在同一量级,K3 明确写的是 1,048,576 tokens,K2.8 用的是「100 万 token / 1M」口径。实际可用长度还会受输出上限和前文长度影响,K3 的输出上限默认 131072、最大可设 1048576。
 京ICP备2024094994号-29