
Kimi K2.8 API 价格查询:官方价目表现状与替代方案
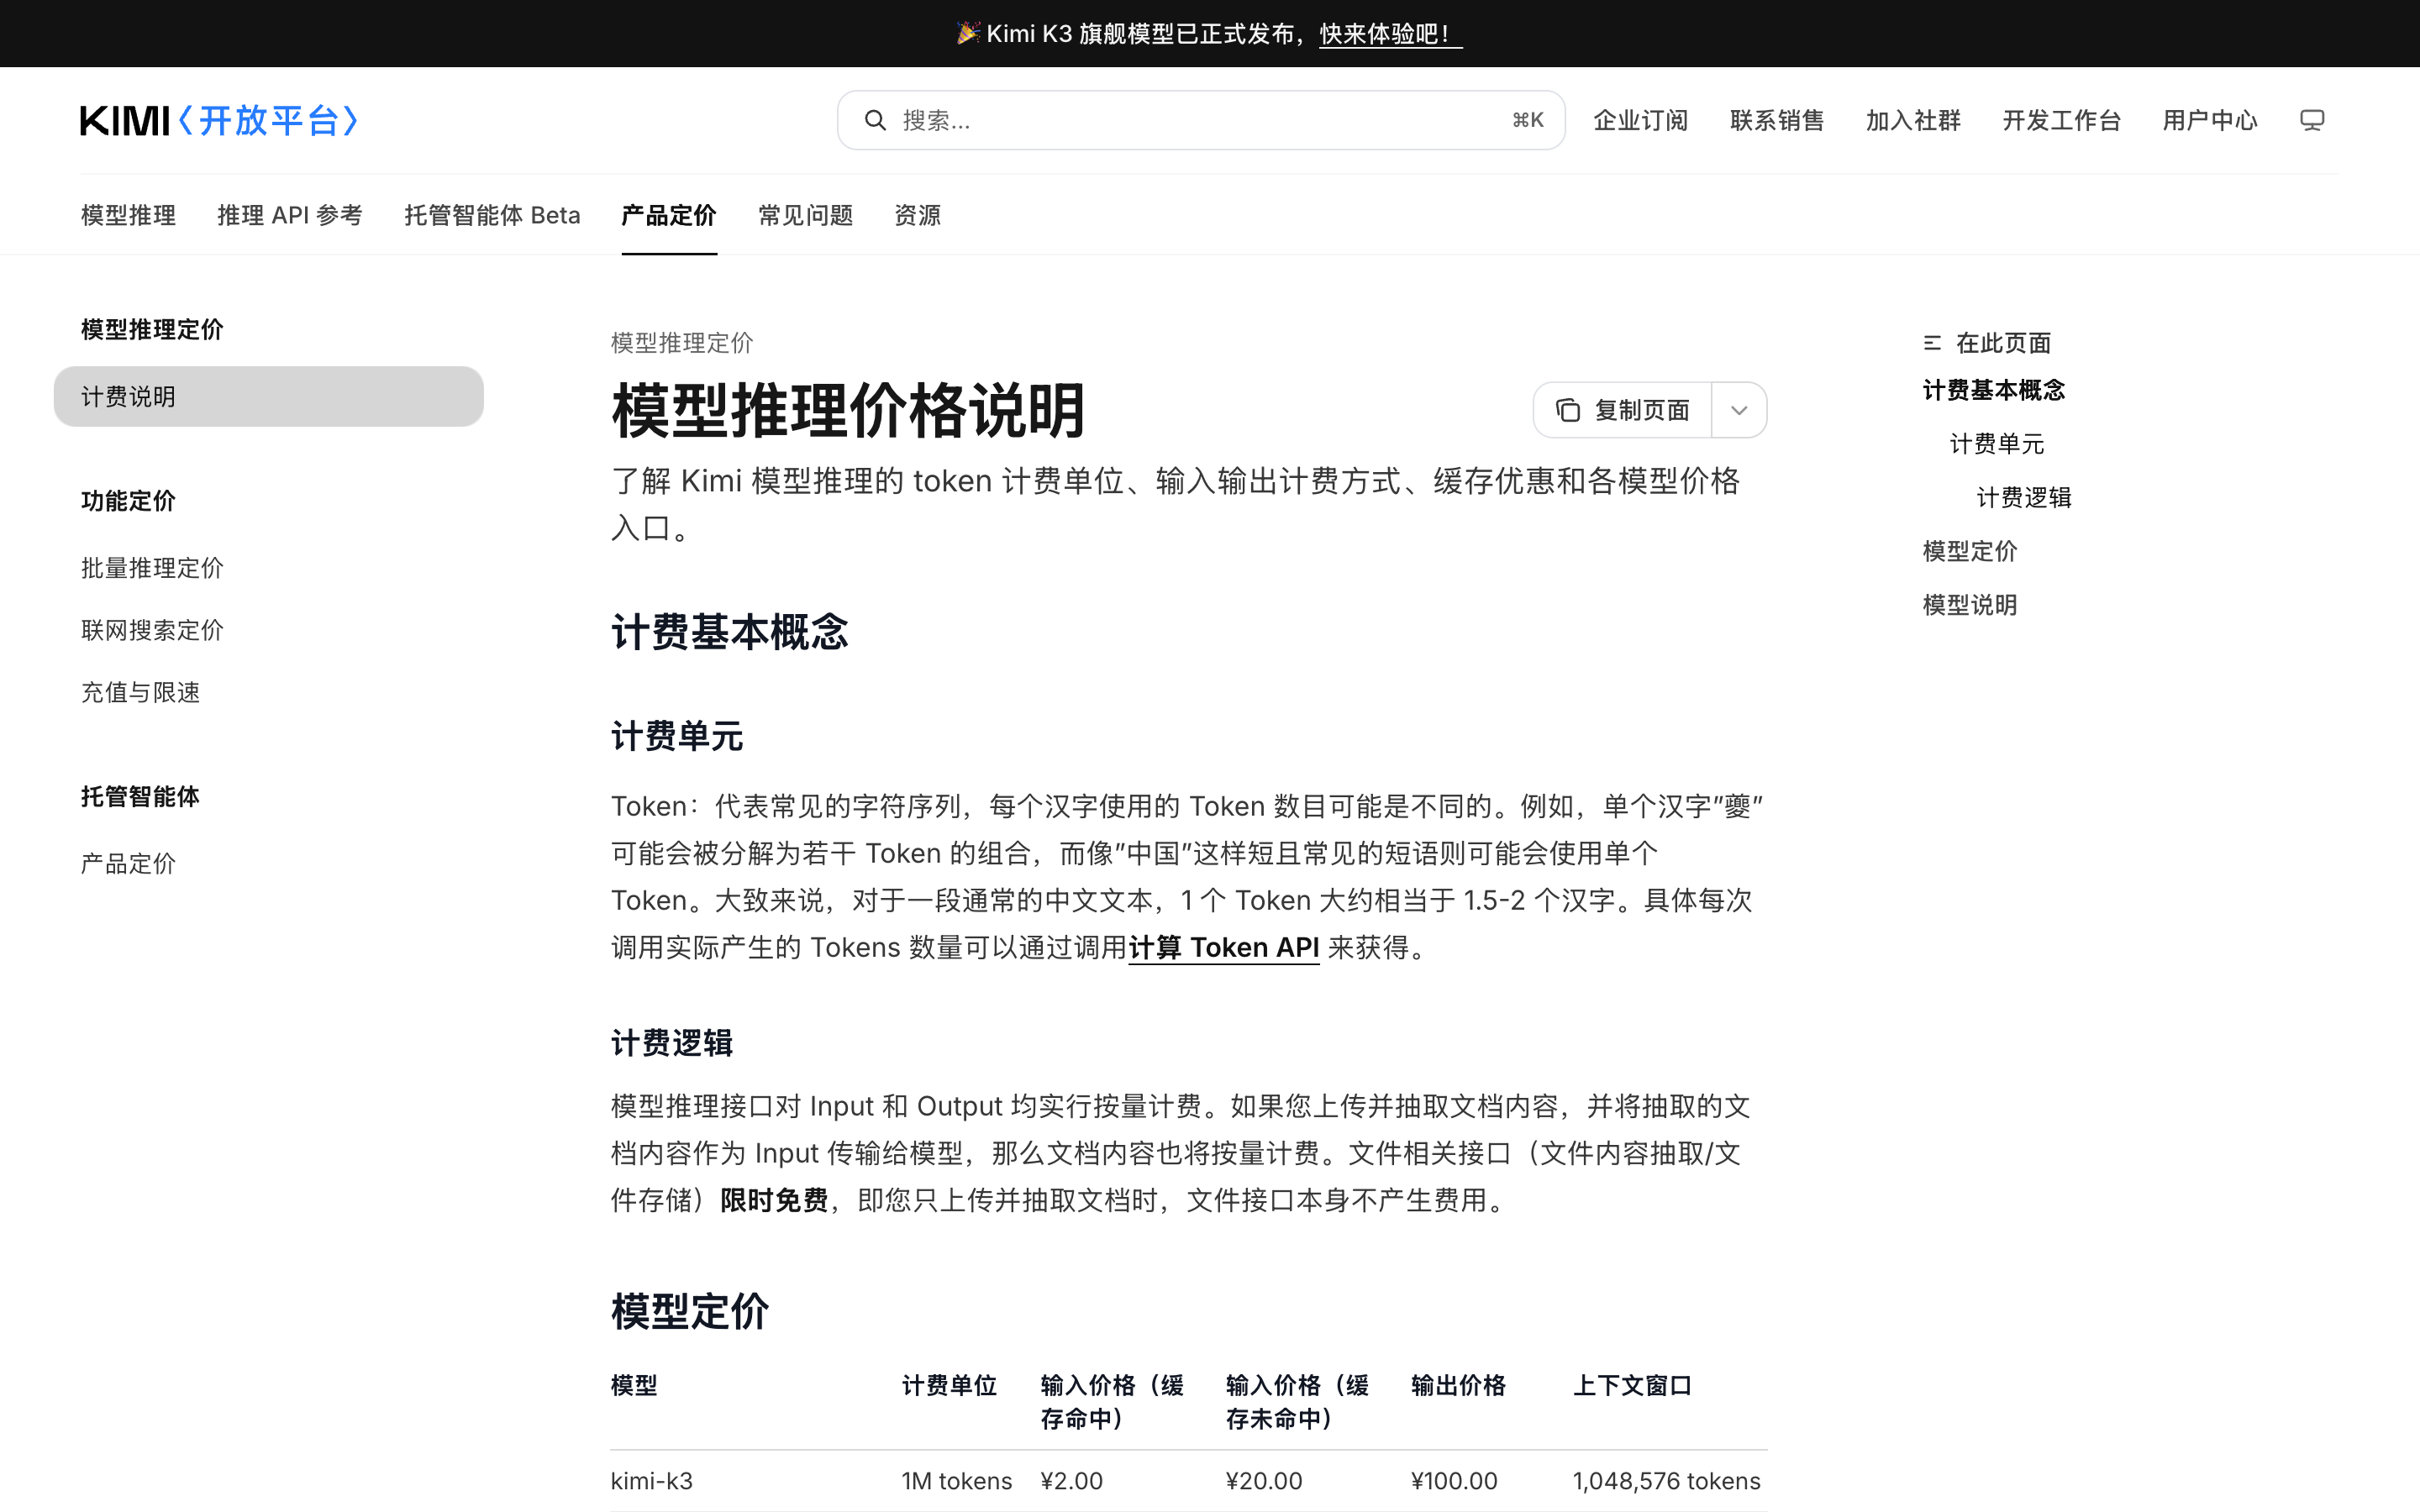
直接给答案:截至 2026 年 9 月 18 日,Kimi 开放平台官方价格表里没有 kimi-k2.8 这个模型。K2.8 Preview 目前只在 Kimi Code 和 Kimi Work 两个会员产品里全量上线,不走 API 计费,所以网上任何「K2.8 API 价格」的具体数字都不是官方口径。想在 API 里用最接近的能力,现在能选的是 kimi-k3。
为什么你搜不到 K2.8 的 API 价格
9 月 12 日 K2.8 Preview 上线时,覆盖的是 Kimi Code 和 Kimi Work 两个会员产品,官方同时把 1M 上下文权限开放给了全部会员档位。开放平台的价格表随后仍只列了四个模型条目,没有 kimi-k2.8。
也就是说,「Kimi K2.8 API 价格」这个搜索问题的准确答案分两层:一是还没上架、没有官方价格;二是想用 K2.8 的能力,有两条现成路径,下面分开说。
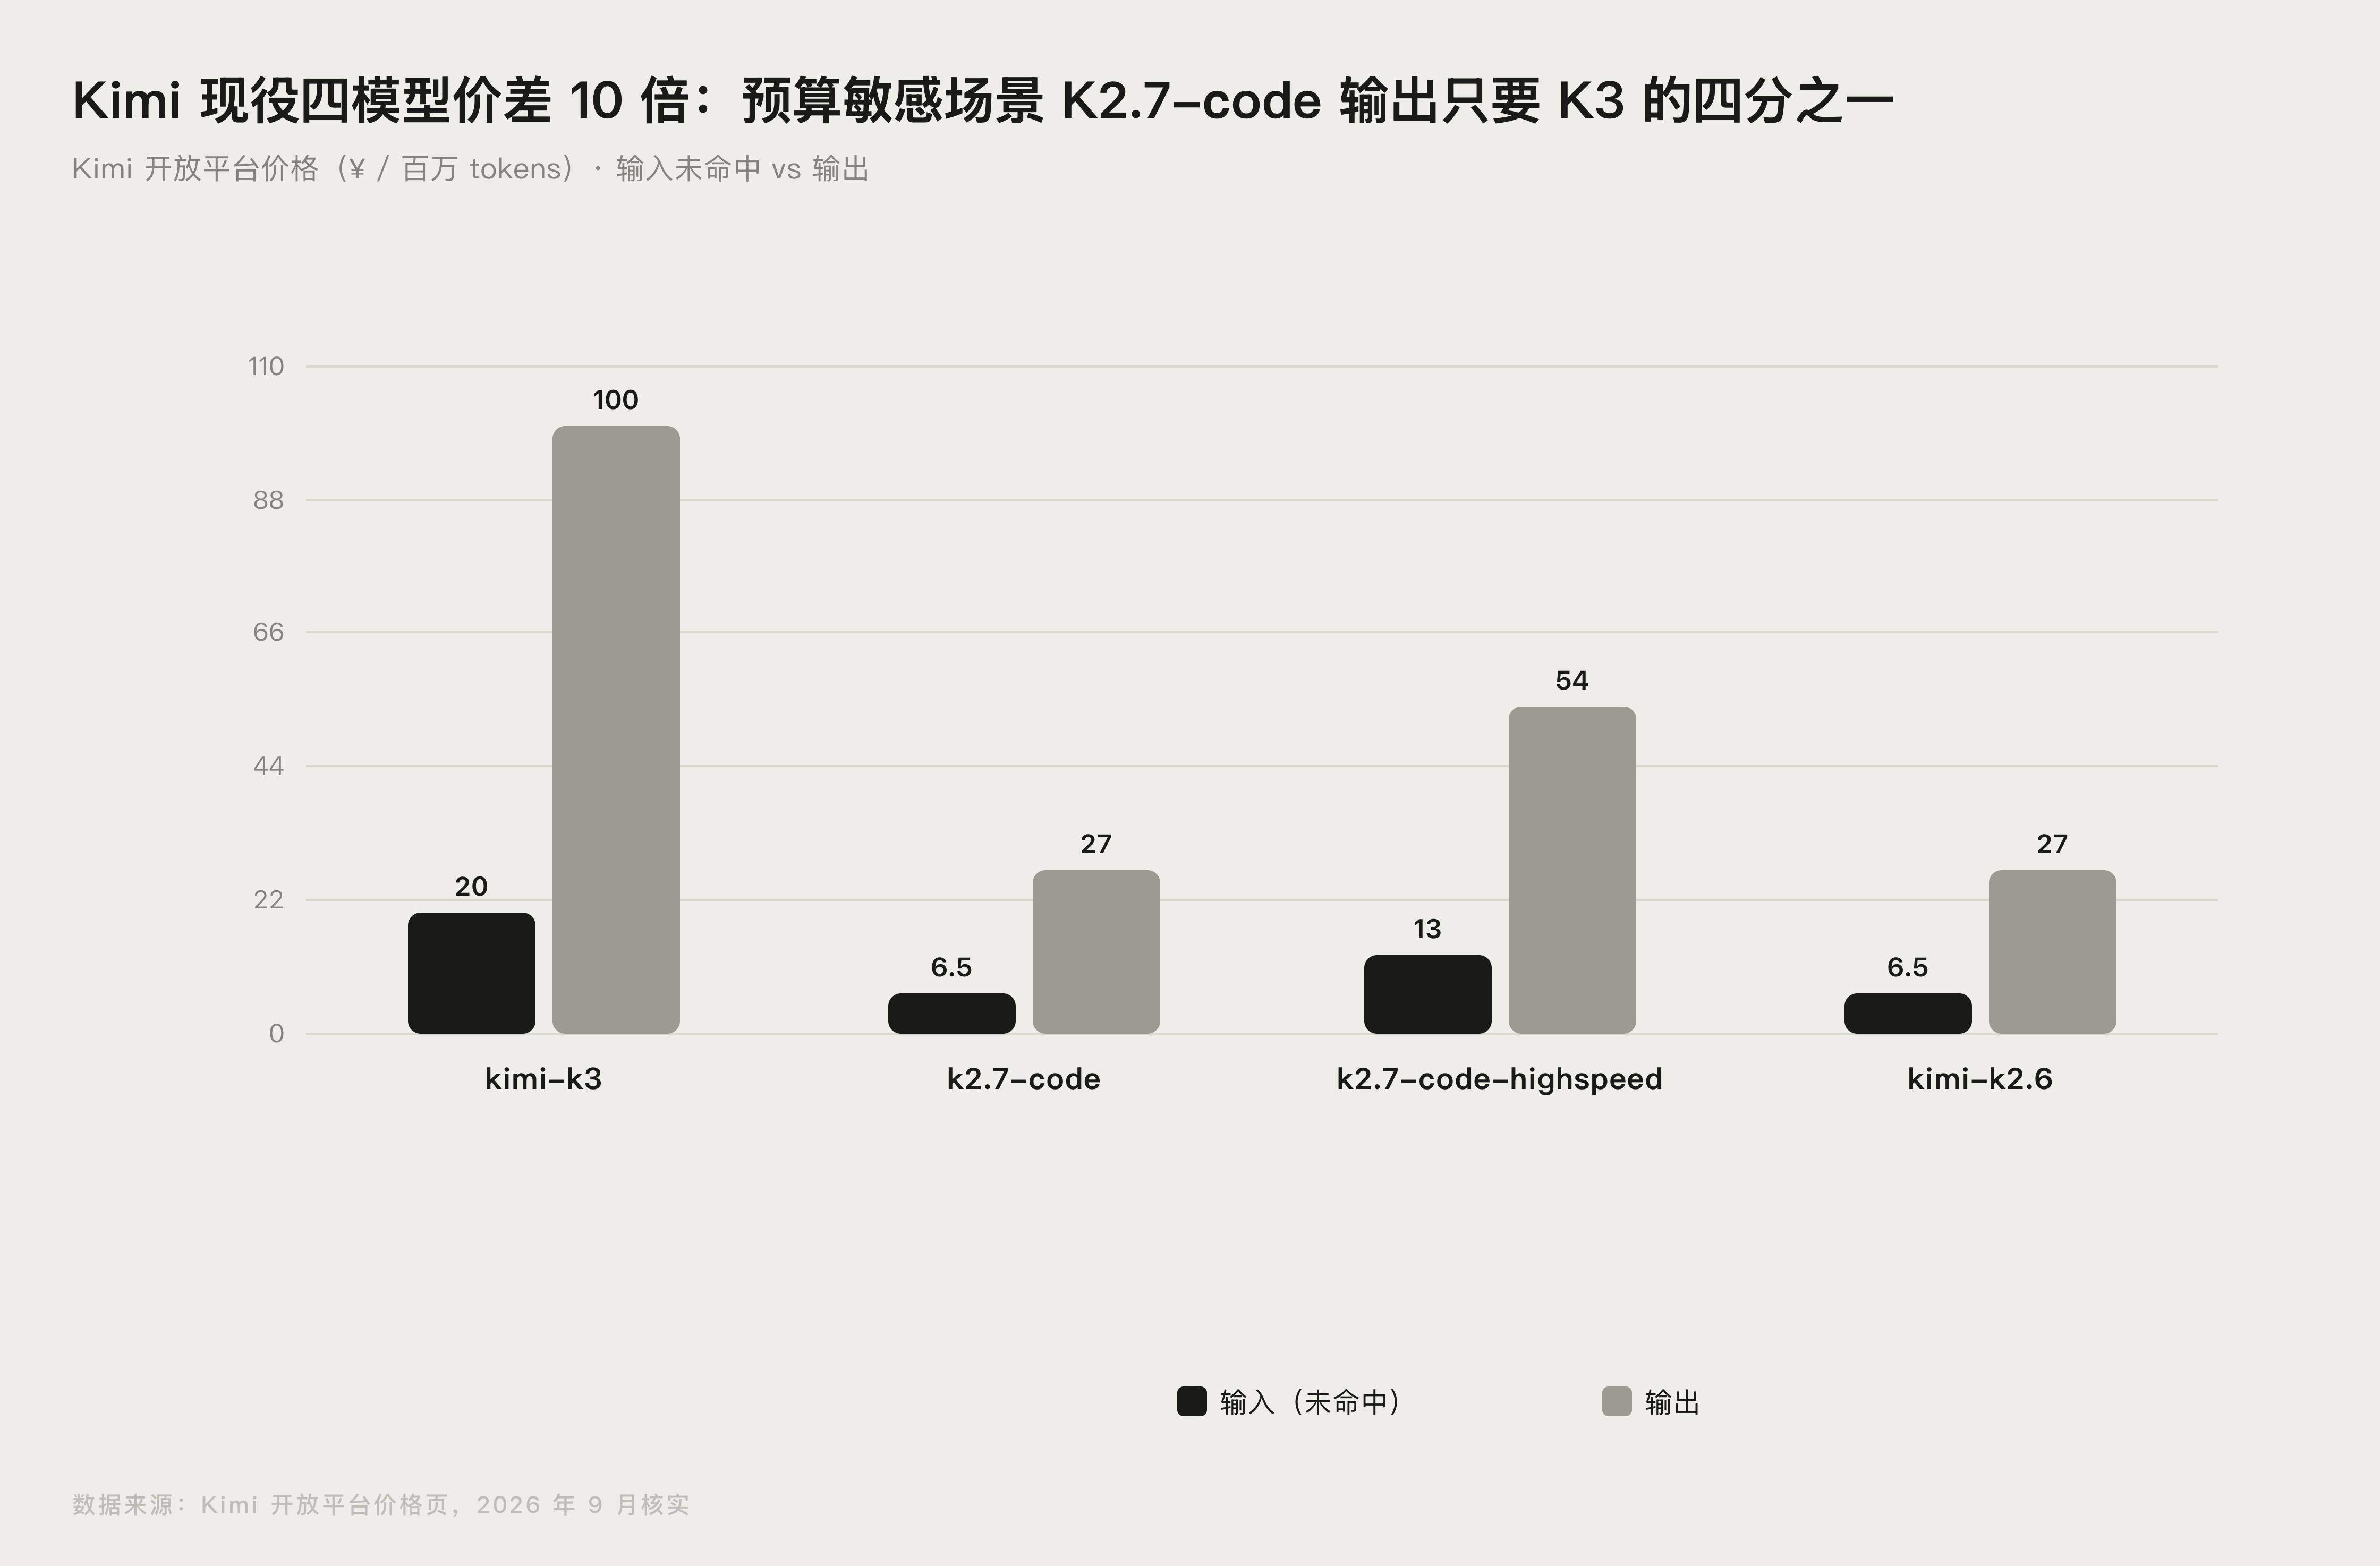
开放平台现役模型价格表(2026 年 9 月核实)
| 模型 | 输入(缓存命中) | 输入(缓存未命中) | 输出 | 上下文窗口 |
|---|---|---|---|---|
| kimi-k3 | ¥2.00 | ¥20.00 | ¥100.00 | 1,048,576 tokens |
| kimi-k2.7-code | ¥1.30 | ¥6.50 | ¥27.00 | 262,144 tokens |
| kimi-k2.7-code-highspeed | ¥2.60 | ¥13.00 | ¥54.00 | 262,144 tokens |
| kimi-k2.6 | ¥1.10 | ¥6.50 | ¥27.00 | 262,144 tokens |
计费单位是元/百万 tokens,1M = 1,000,000,数据来自官方价格页,以调用时控制台实时账单为准。中文文本大约 1 个 token 对应 1.5 到 2 个汉字,官方还提供 Token 估算 API 可以先算再调。文件相关接口(文件内容抽取、文件存储)官方标注限时免费,也就是说只上传并抽取文档这件事本身不产生费用。
四个模型分别适合什么场景
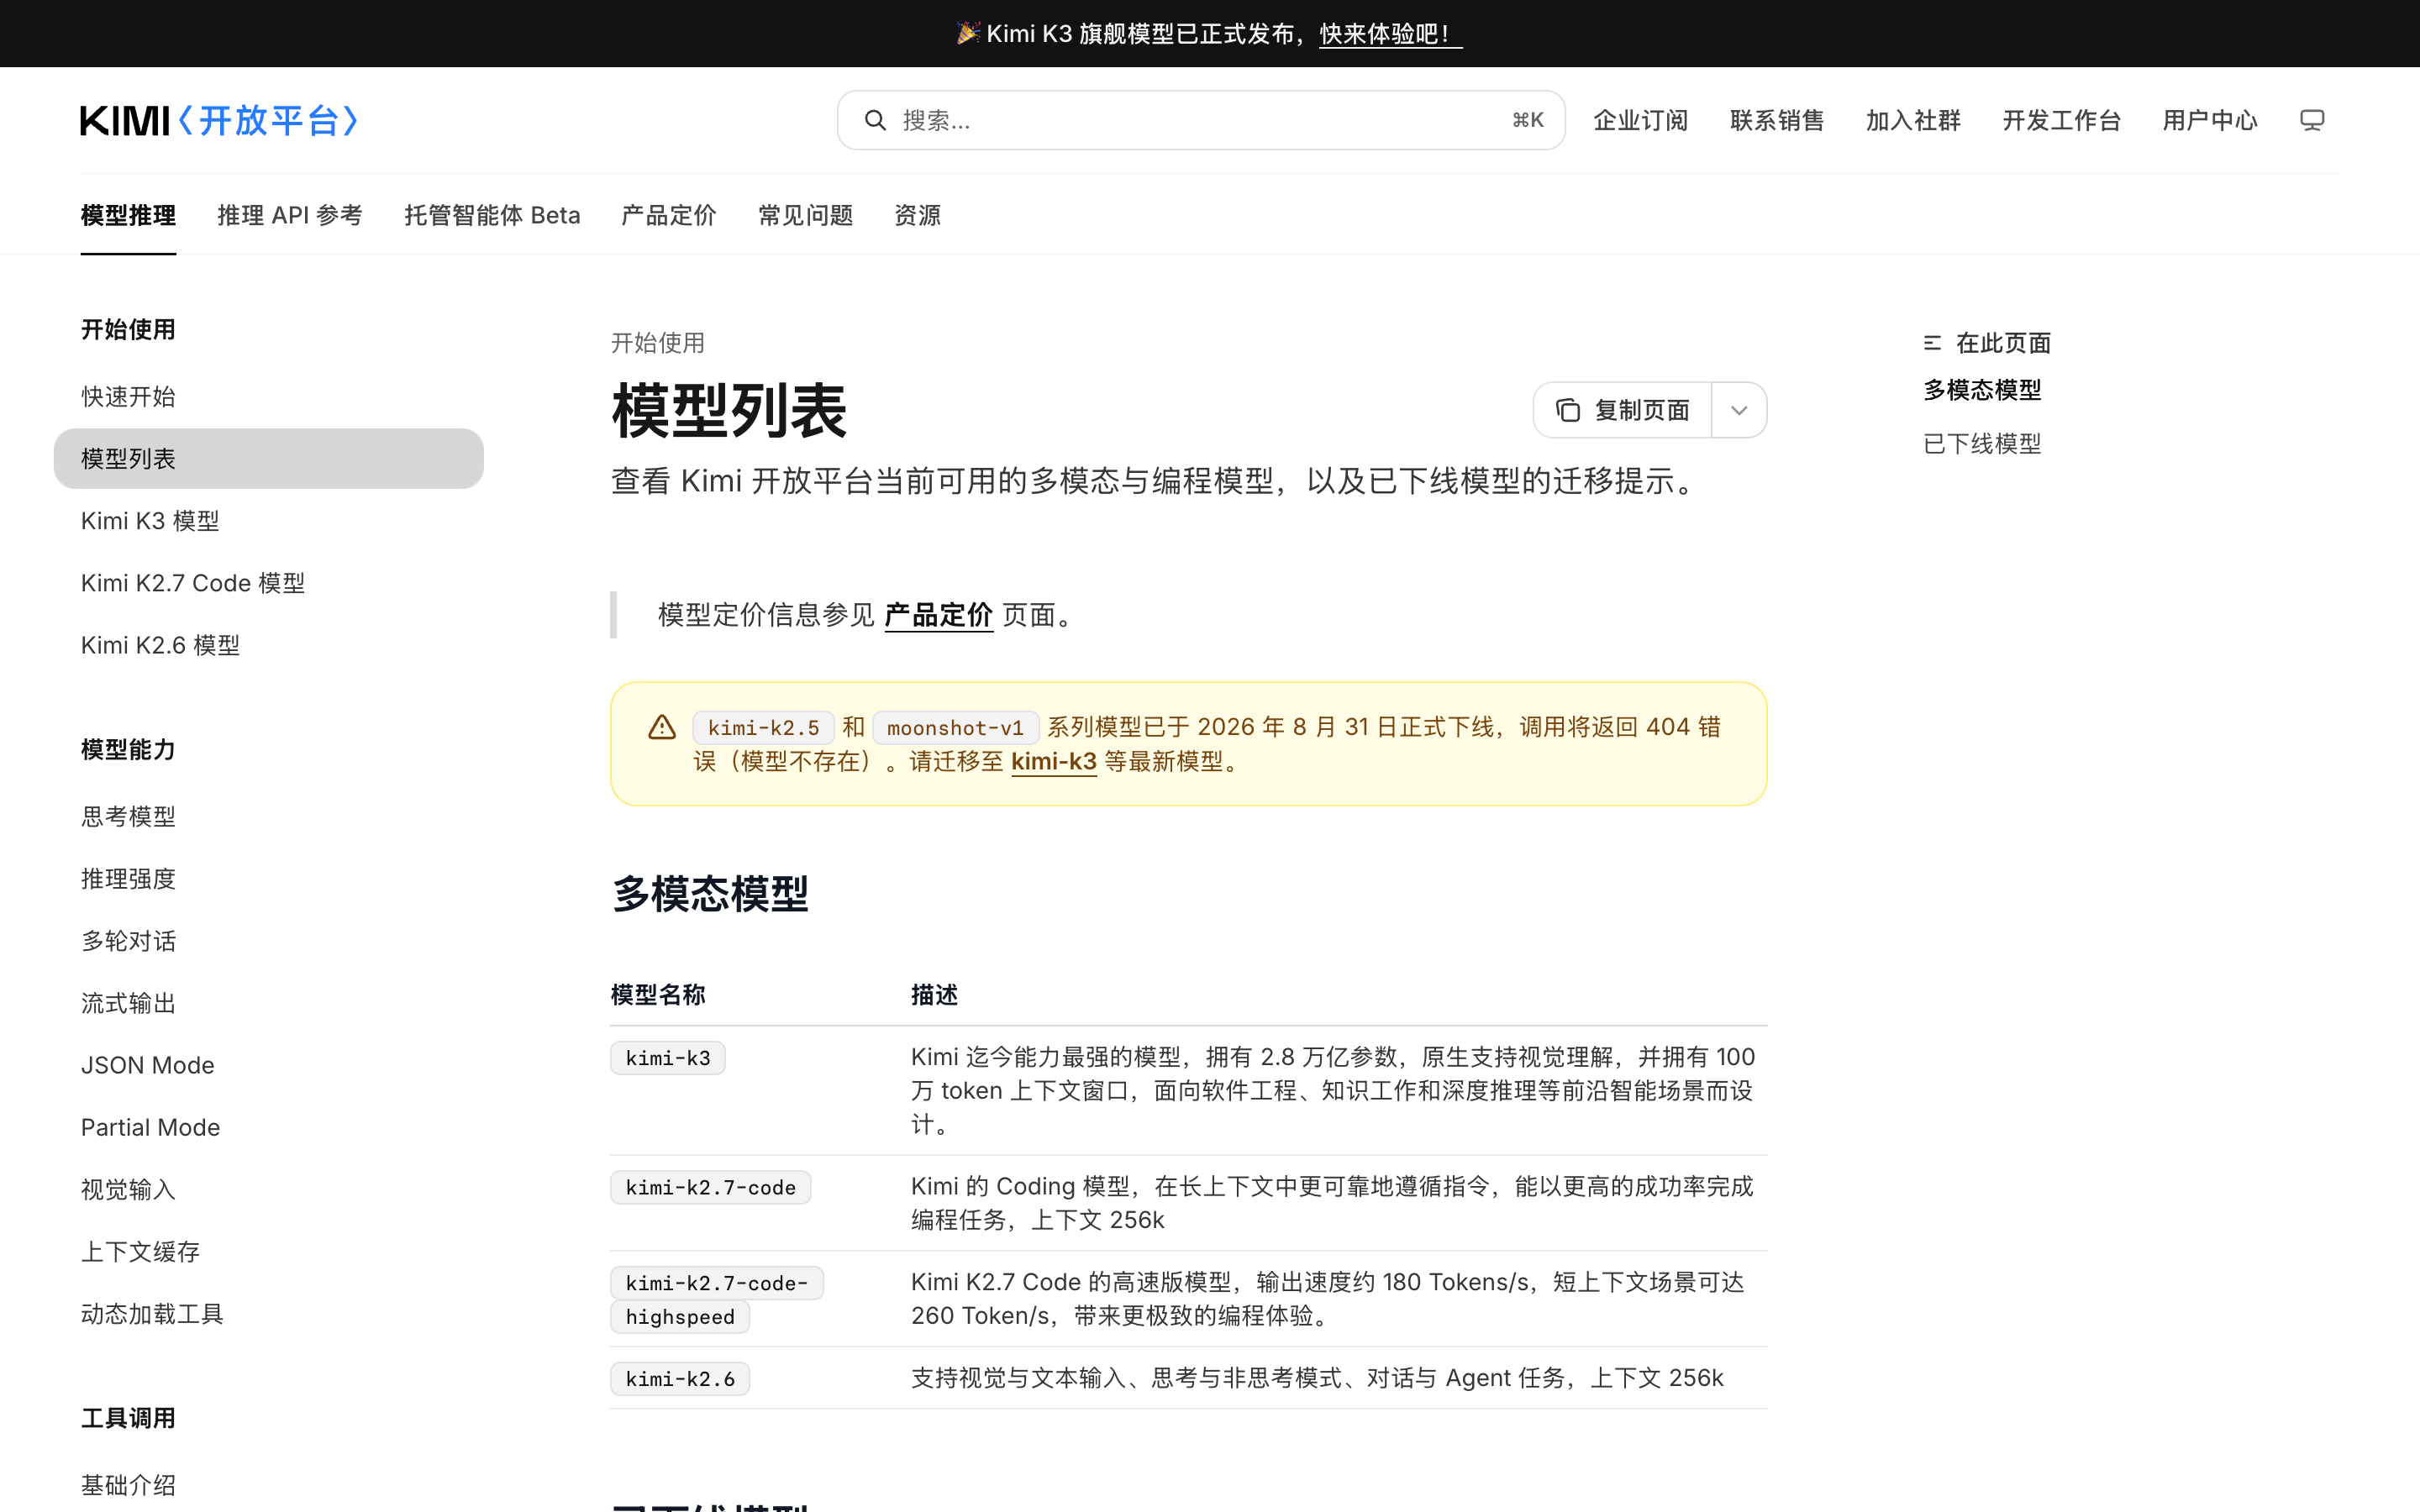
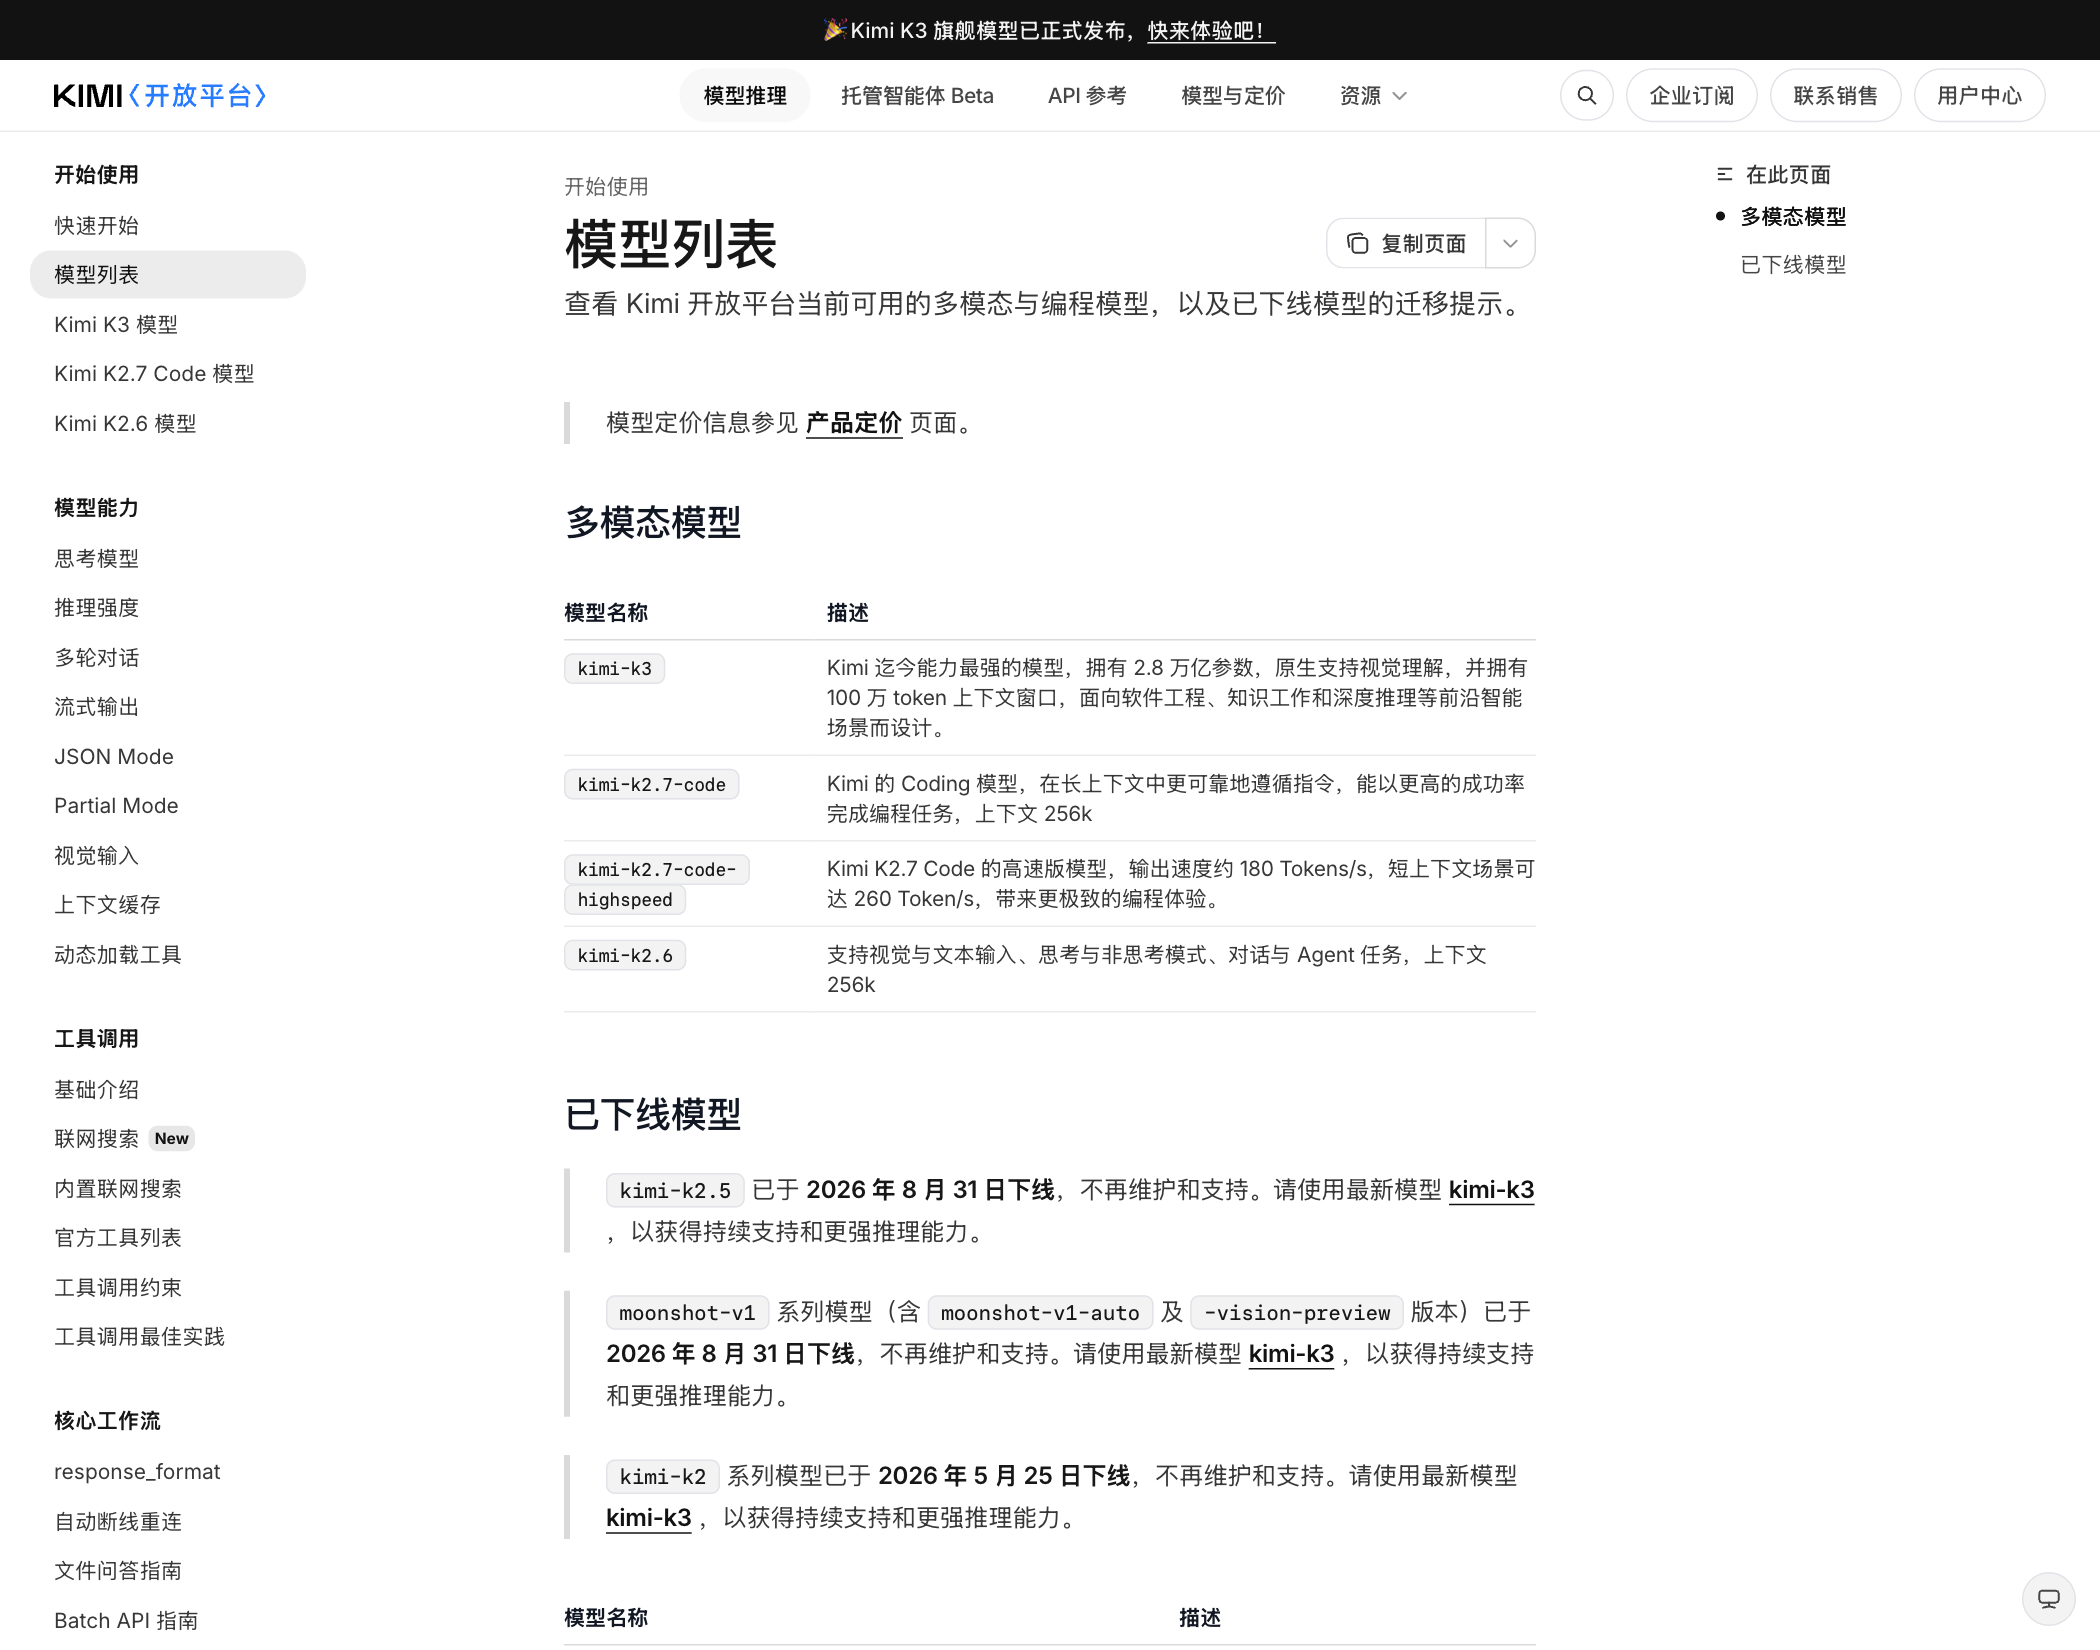
价格差不多的模型,选错一样浪费钱。按官方模型列表的描述:
- kimi-k3:2.8 万亿参数,原生支持视觉理解,100 万 token 上下文,面向软件工程、知识工作和深度推理。要最强能力、要超长上下文,选它。
- kimi-k2.7-code:编码专用,长上下文里更稳定地遵循指令,上下文 256k。日常补全、解释、小改动,选它性价比最高。
- kimi-k2.7-code-highspeed:K2.7 Code 的高速版,输出速度约 180 tokens/s,短上下文场景可达 260 tokens/s,价格约为标准版的两倍。交互式场景感觉慢的时候值得换。
- kimi-k2.6:支持视觉与文本输入、思考与非思考模式,上下文 256k,是四者里最便宜的一档。
除了实时推理,还有三档官方价格要知道
很多人只看了那张价格表,忽略了官方另外三个计费入口,实际成本差异不小。
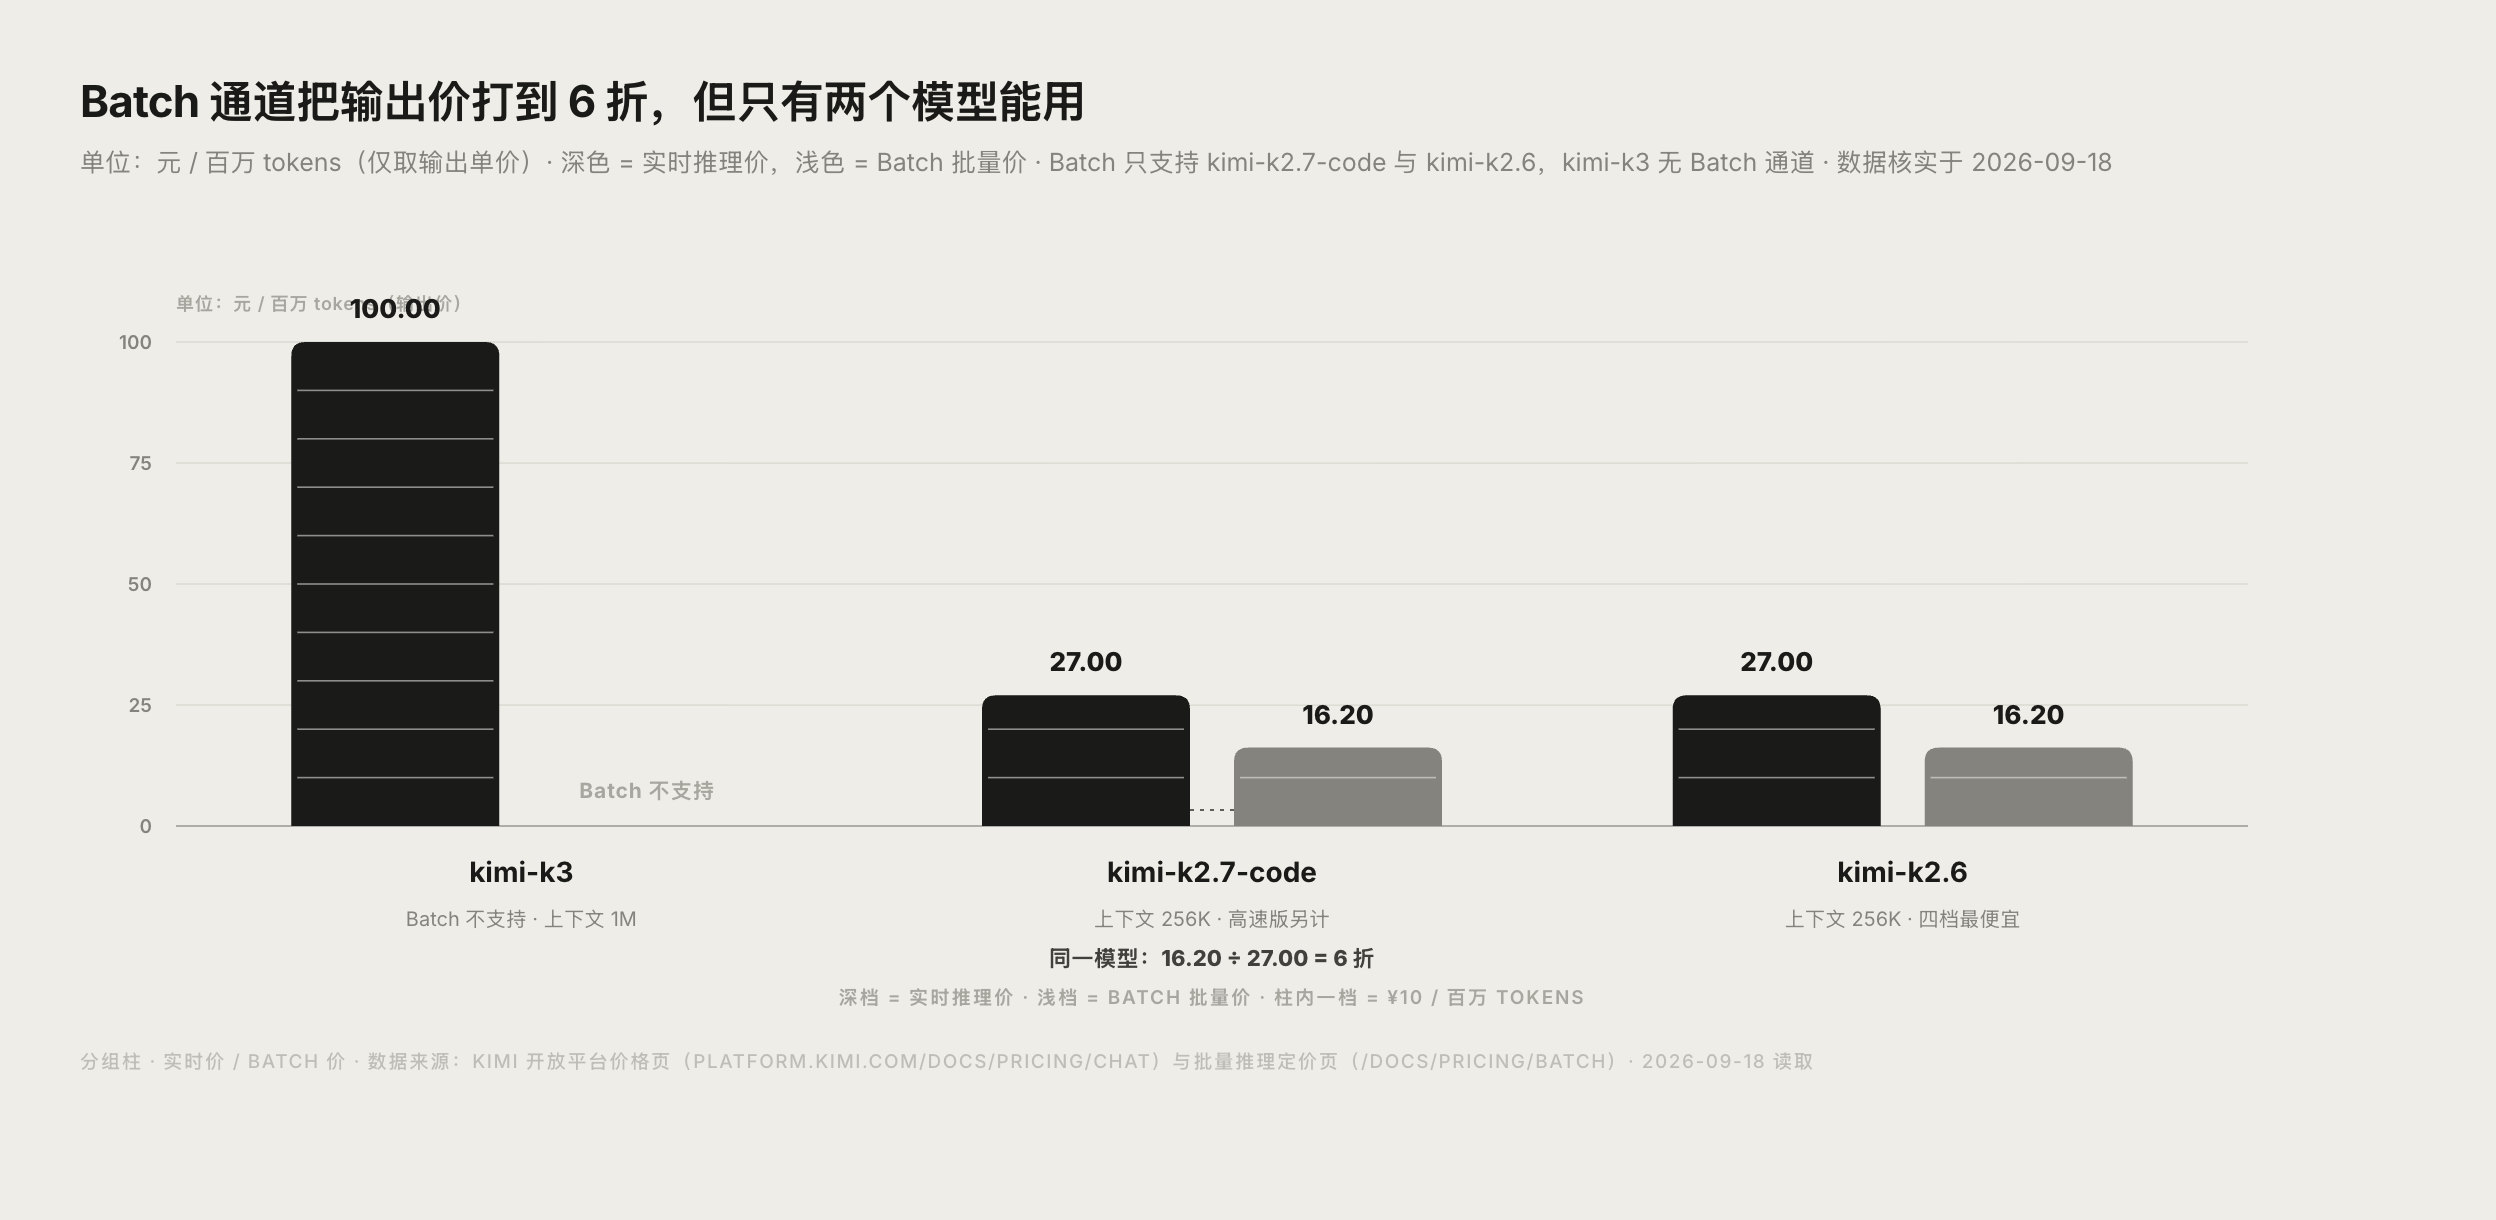
第一,批量推理是标准价的 6 折。 官方明确 Batch API 费用为标准模型价格的 60%,适合大规模、低实时性要求的任务。但它只支持两个模型:
| 模型 | 输入(缓存命中) | 输入(缓存未命中) | 输出 | 上下文窗口 |
|---|---|---|---|---|
| kimi-k2.7-code(Batch) | ¥0.78 | ¥3.90 | ¥16.20 | 262,144 tokens |
| kimi-k2.6(Batch) | ¥0.66 | ¥3.90 | ¥16.20 | 262,144 tokens |
Batch 任务不受实时并发限制,但要在指定的 completion_window 内完成,超时会变成 expired 状态。
第二,联网搜索与网页抓取按次计费。 走独立的 REST 接口,请求成功且返回数据才收费:
| 工具 | 调用方式 | 价格 | 计费条件 |
|---|---|---|---|
| 联网搜索 Basic | POST /v1/tools/search | ¥0.01 / 次 | HTTP 200 且 search_results 非空 |
| 联网搜索 Pro | POST /v1/tools/search_pro | ¥0.015 / 次 | HTTP 200 且 search_results 非空 |
| 网页抓取 | POST /v1/tools/fetch | ¥0.01 / 次 | HTTP 200 且返回 markdown 非空白 |
Pro 版与 Basic 的区别是:支持用 sites 把结果限制在指定站点、用 time_window 限制时间范围,并为每条结果返回结构化正文片段。请求失败、触发风控或没有结果都不计费。
第三,内建工具 $web_search 要换掉了。 在 /v1/chat/completions 的 tools 里触发 $web_search,按次收 ¥0.03,而且搜索结果占用的 token 会算进下一次请求的 prompt tokens 里。官方已经明确这个方式预计在 2026 年 10 月 20 日下线,新接入请改用 /v1/tools/search 接口或官方 web-search 工具。
想用 K2.8:两条替代路径
- 会员端直接用:开 Kimi 会员,在 Kimi Code(编程工具)或 Kimi Work(知识工作 Agent)里使用 K2.8 Preview,1M 上下文对全部会员档位开放,这是目前唯一的 K2.8 正规用法。
- API 用 K3:需要 API 的场景直接调 kimi-k3,能力上限更高;预算敏感的代码场景可以先跑 kimi-k2.7-code,输出价格约为 K3 的四分之一。
两条路径不冲突:个人学习和日常任务走会员端,产品化接入走 API。想先弄清 K2.8 和 K3 的能力差异,可以看站内 K2.8 vs K3 差异对比和 K2.8 Preview 解读。
API 省钱的四个技巧
- 吃透缓存命中:同一前缀的输入命中缓存后,单价从 ¥20 降到 ¥2,差距 10 倍。长系统提示词、固定文档内容务必设计成稳定前缀复用。
- 批量推理更便宜:对实时性没要求的离线任务,走 Batch 通道直接打 6 折,但记得它只支持 kimi-k2.7-code 和 kimi-k2.6。
- 代码场景降配:日常补全、解释、小改动用 kimi-k2.7-code,复杂架构任务再上 K3,混着用最省;延迟敏感的交互场景再换 highspeed 版。
- 注意搜索的隐性成本:用内建
$web_search时搜索结果会变成 prompt tokens 计费,改用独立 REST 接口后这部分按次计费,反而更好预算。
其他厂商的价格横向参考,可以看站内的 Grok 4.6 价格与 API 接入全解和腾讯混元 Hy4 Preview 发布解读。
避坑:这些模型已经下线
官方模型列表专门有一节「已下线模型」,写得很直白:
| 模型 | 下线时间 |
|---|---|
| kimi-k2.5 | 2026 年 8 月 31 日 |
| moonshot-v1 系列(含 moonshot-v1-auto、-vision-preview 各版本) | 2026 年 8 月 31 日 |
| kimi-k2 系列(含 k2-0905-preview、k2-0711-preview、k2-turbo-preview、k2-thinking 等) | 2026 年 5 月 25 日 |
| kimi-latest | 2026 年 1 月 28 日 |
| kimi-thinking-preview | 2025 年 11 月 11 日 |
老项目里引用这些模型名的要尽快切换,否则调用会直接报模型不存在。官方给出的迁移方向统一指向 kimi-k3。
常见问题
K2.8 什么时候会上 API?
答:官方没有公布时间表。以开放平台价格页和公告为准,出现转述价格先核对官方页面再相信。
K2.8 的 API 会比 K3 便宜吗?
答:没有官方信息,无法确认。参考行业惯例,介于旗舰和上代之间的模型定价通常更低,但这只是推测,本文不给编造数字。
Kimi 会员多少钱一档?
答:档位和价格以 kimi.com 会员页实时展示为准,会员权益会随产品调整变化,本文不固定引用旧价格。
kimi-k3 的价格换算成美元是多少?
答:按第三方统计口径约为输入 3 美元、输出 15 美元每百万 tokens,实际以人民币官方价和实时汇率为准。
缓存命中是怎么触发的?
答:当本次请求的输入前缀与近期请求完全一致时命中。把系统提示词和固定上下文放在请求最前面并保持不变,是最有效的省钱手段。
Batch 批量推理能省多少,有什么限制?
答:官方口径是标准价的 60%,适合实时性要求不高的离线任务。限制有三条:只支持 kimi-k2.7-code 和 kimi-k2.6;任务要在指定的 completion_window 内完成,超时变 expired;不走实时并发限制。
 京ICP备2024094994号-29