
Kimi K3.1 Pro 和 K3 区别:一张表看完
先给结论。K3.1 Pro 不是新架构,是 K3 的后训练加强版。同一个底座、同样 3 万亿级参数、同样 1M 上下文,差别全部来自更大规模的后训练算力投入。但就是这个「只是后训练」的差别,让它在编码、3D、金融三条线上拉开了明显距离,而且官方定价比 K3 低了三成。
所以对绝大多数人来说这不是个需要纠结的问题:同一个平台、同一套 API、更便宜、更强。真正值得讨论的是具体哪几项强了多少,以及 Highspeed 那笔加价该不该付。
一张表看完所有差异
| 对比维度 | Kimi K3 | Kimi K3.1 Pro | 差异意味着什么 |
|---|---|---|---|
| 定位 | 上一代旗舰,全球首个开源的 3 万亿级模型,2.8 万亿参数 | K3.1 系列首个模型,3 万亿级参数 | 同代不同版本,不是跨越 |
| 上下文 | 1,048,576 tokens | 1,048,576 tokens | 完全一致,没缩水 |
| 图像输入 | 支持 | 支持 | 完全一致 |
| 推理强度 | low / high / max,默认 max | low / high / max,默认 max | 完全一致,参数不用改 |
| 输入价(人民币) | 20 元 / MTok | 13 元 / MTok | 便宜 35% |
| 输出价(人民币) | 100 元 / MTok | 68 元 / MTok | 便宜 32% |
| 权重 | 已开源 | 承诺 11 月 4 日前发布 | 想本地跑还得等 |
价格和参数这两块是 官方定价页 和 模型列表 里能直接查到的硬数据,下面逐项拆开讲的是能力差异。
差异一:幻觉率砍掉了三分之二
这是我认为最有实际价值的一项,也是媒体报道里最容易被略过的一项。
官方在「用户标记过事实错误的去标识化对话」上做了一组测试。K3.1 Pro 的单条事实陈述错误率从 K3 的 23.35% 降到 6.85%,包含至少一处事实错误的回答比例只剩前代的 46.4%。
官方自己加了免责说明:这是针对事实准确性的压力测试,样本刻意挑了模型容易出错的情形,所以这些数字不代表日常使用的错误率。这个说明很重要,别把 6.85% 当成「日常会错 6.85%」。
但方向是明确的。如果你用 K3 写过需要核对数据的报告、做过财务口径核对、或者让 Agent 查过资料,你应该遇到过「看起来对但数字是编的」这种情况。6.85% 和 23.35% 的差距,就是你要多花多少时间复核。
差异二:编码基准反超 GPT-6 Astra
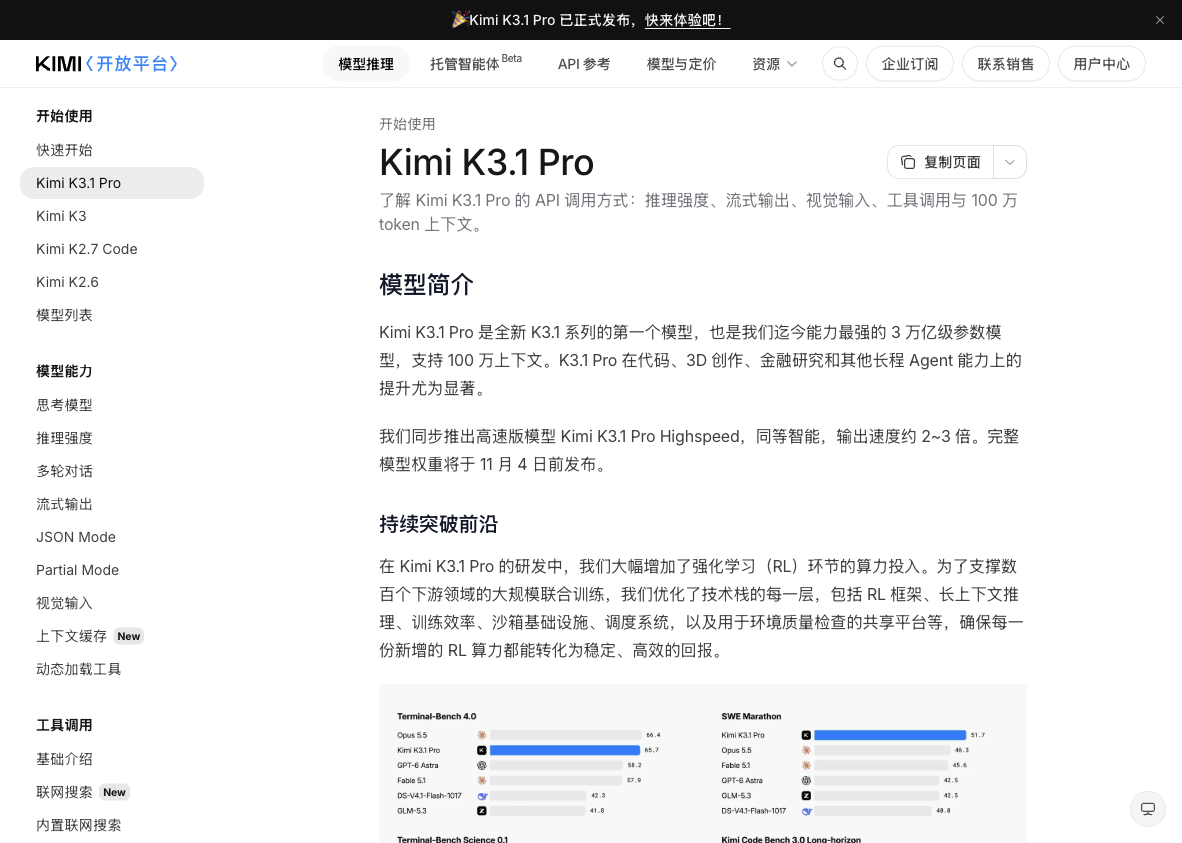
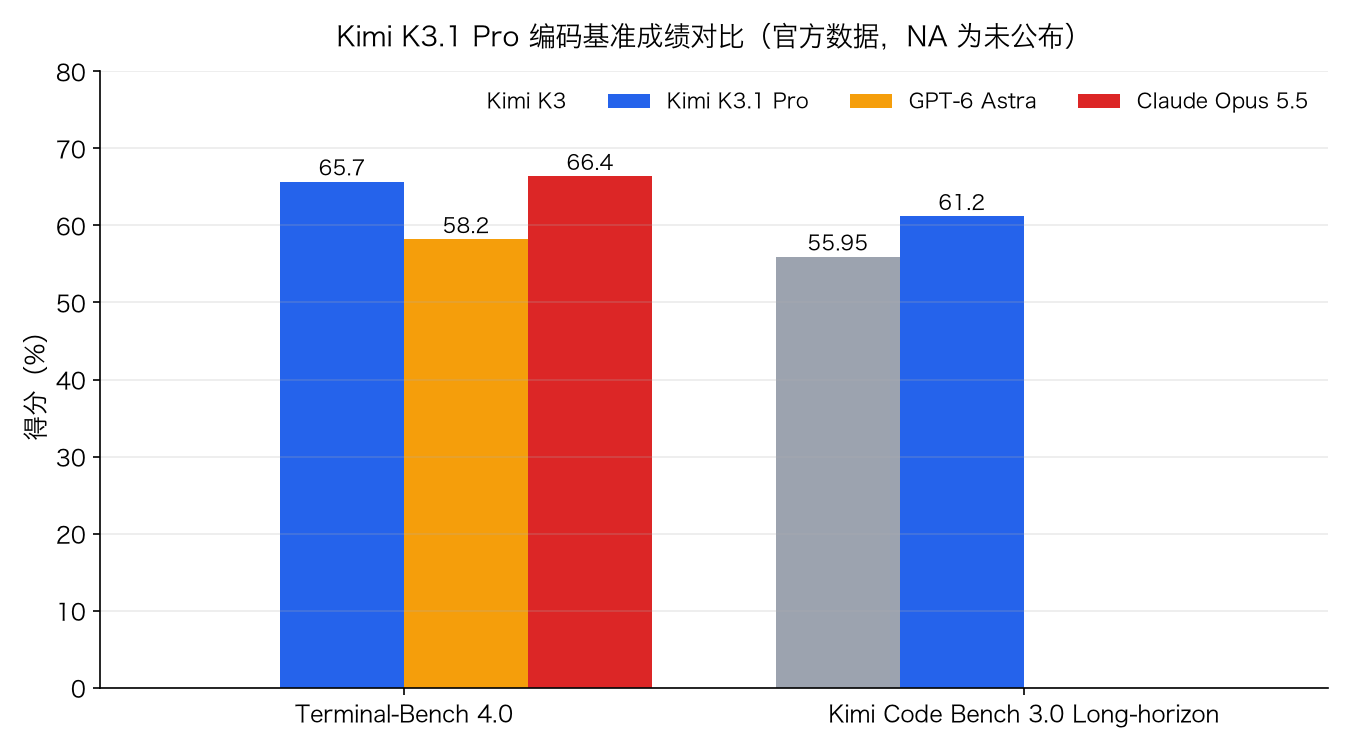
Terminal-Bench 4.0 是考察编程智能体在真实终端环境里完成资源受限任务的能力,每项任务有严格的专项测试。分数见 官方模型页,如下:
| 模型 | Terminal-Bench 4.0 得分 |
|---|---|
| Claude Opus 5.5 | 66.4% |
| Kimi K3.1 Pro | 65.7% |
| GPT-6 Astra | 58.2% |
K3.1 Pro 超过 GPT-6 Astra 7.5 个百分点,跟 Claude Opus 5.5 只差 0.7 个百分点。这个差距已经落在噪声范围内了。
Kimi 内部的 Kimi Code Bench 3.0 Long-horizon 测的是多步执行、工具调用和端到端问题解决,K3.1 Pro 拿 61.2%,比 K3 的 55.95% 高 5.25 个百分点。这是同门对比,没有跨厂商口径问题,可以放心参考。
还有一个能体现长程能力的细节,官方在英文页写了完整案例。K3.1 Pro 在一个叫 human-atlas 的开源人体解剖模型上搭行走动力学模拟器,模型包含 296 个骨骼组件和 402 个肌肉组件。跑 167 次任务、420 次独立评审之后,模拟人从「几秒内瘫倒」变成「连续交替步态行走 11.2 秒」。中途奖励塑形对摆臂失效时,它没有继续调奖励函数,而是主动做动力学开环探测,找出了肩部肌肉力臂计算里的 36 处错误,修正后重新训练控制器。这种「换思路而不是硬调参数」的行为,是长程 Agent 任务里最难做出来的部分。
差异三:3D 建模可以绕开 MCP
这项是 K3.1 Pro 拉开距离最明显的地方,也是这次升级里最少被中文报道提及的部分。
K3.1 Pro 可以不依赖 MCP 连接器,直接写脚本去跑 Blender、SolidWorks、Rhino 这些专业建模软件,完成素材构建、几何和材质细化、场景搭建,最后接进 Three.js 场景或者游戏引擎。
差别在哪:以前要接 3D 能力,你得先搭一套 MCP 服务器把工具包起来,再让模型调用。现在模型自己写脚本跑,链路短了两层,出错点少了两个,token 消耗也省了。对做参数化建模的人(机械零件、建筑模型、多参数可配置产品、定制家具)这个改动很实际。
游戏引擎这块官方也提了,K3.1 Pro 能熟练用 Unity、Unreal Engine、Godot,结合联网搜索和 3D 生成做出完整体验。前端页面、Three.js 交互场景、3D 资产在构图、排版、动效上的提升,是这次升级里主观感受最明显的部分。
差异四:金融是涨得最多的一块
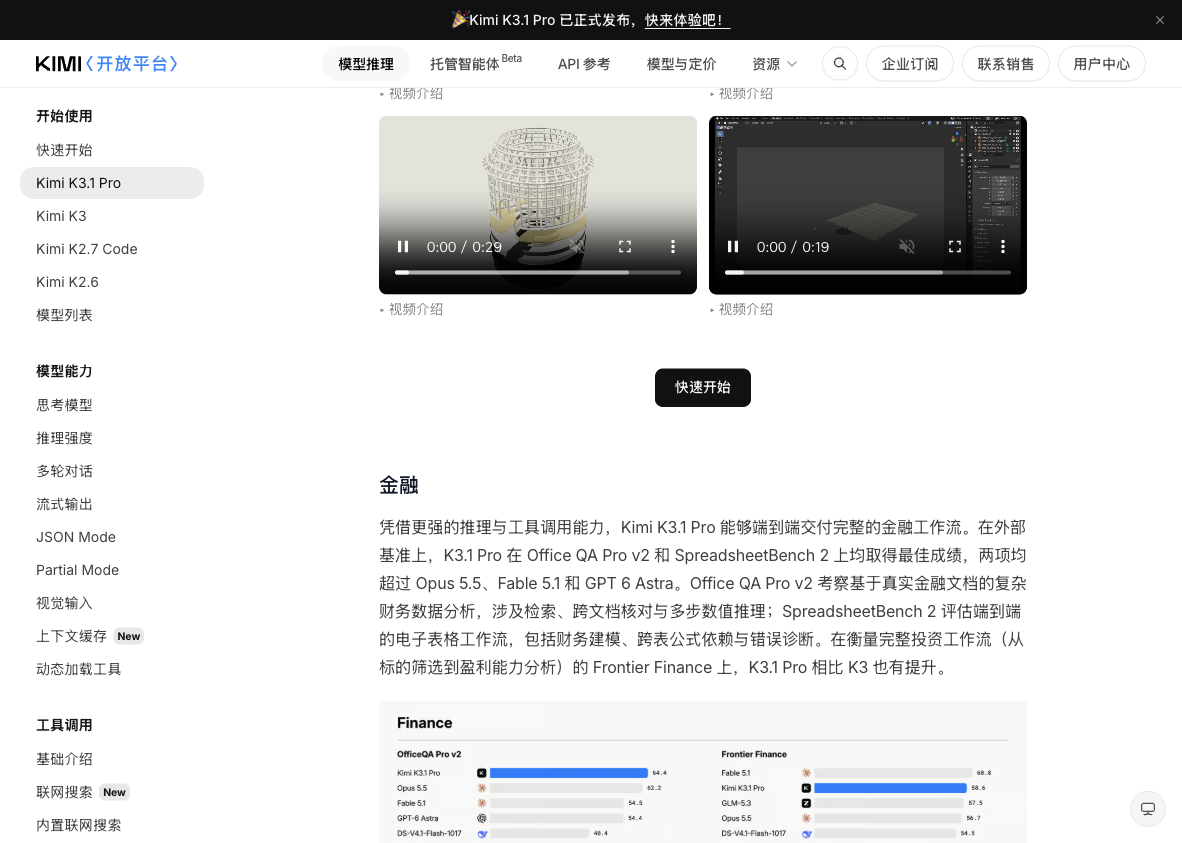
官方在 OfficeQA Pro v2 和 SpreadsheetBench 2 上拿了最佳成绩,两项都超过 Opus 5.5、Fable 5.1 和 GPT-6 Astra。
三个内部金融基准的涨幅:
- Financial Modelling(真实建模任务里的公式联动、财务逻辑、工作簿质量):比 K3 提高 14%
- Financial Research(在证据和截止条件约束下输出可核验的研究结果):比 K3 提高 20%
- Business Operation(模拟商业环境里的长程经营管理与决策,含资金管理、采购、库存分配、定价):得分 37.0,约为 K3 的 4.2 倍
Business Operation 那个 4.2 倍值得单独说一下。37 分听起来不高,但这是模拟经营的期末业绩指标,起评分低。4.2 倍的相对提升说明模型在长程资源分配这类任务上从「基本做不了」变成「能做出可见结果」。
如果你关注的是 Agent 跑经营类任务,这一项比编码基准更有参考意义。想看多智能体怎么分工协作,Kimi K3 多智能体协作教程 里有具体编排方式,K3.1 Pro 的接口行为跟 K3 一致,方法可以直接复用。
差异五:第三方评分首次逼近闭源前沿
第三方的 Artificial Analysis 给 K3.1 Pro 打了 55 分,中文侧见 网易号评测原文。横向看:
| 模型 | Artificial Analysis 得分 |
|---|---|
| Claude Opus 5.5 | 58 |
| Kimi K3.1 Pro | 55 |
| Claude Fable 5.1 | 53 |
| GPT-6 Astra | 53 |
| Gemini 4 Argon | 53 |
这个分数的意义不在 55 本身,而在于它是「即将开放权重的模型第一次在前沿对比里拿到这个位置」。开放权重模型过去跟闭源前沿之间有一道明显的沟,K3.1 Pro 把这沟填到只剩 3 分。
需要注意 Moonshot 自家基准的口径差异。官方说法是「在部分基准上领先,在另一些上接近」,跟 Artificial Analysis 的排序不完全一致。这很正常,自评和第三方评测的权重设计不同。判断时优先看第三方,厂商自评只看趋势。
现有 K3 用户要不要换:四个场景分开看
场景一:你在写代码、上下班都在用 Claude Code 或 Codex
换。没有犹豫的理由。编码是这次提升最确定的方向,Terminal-Bench 和内部长程基准都是明显上升,而且更便宜。迁移动作只有一步,把配置里的 kimi-k3 改成 kimi-k3.1-pro。
需要注意的是 Claude Code 官方示例配置里几个档位写的是 kimi-k3[1m],你要改成 K3.1 Pro 就得逐项替换,别只换主模型那一行。具体配置见我另一篇 Kimi K3.1 Pro API 接入教程,那篇按平台把国内海外的端点都列了。
场景二:你在做 3D、游戏、前端交互
换,而且优先试。绕开 MCP 直接跑建模软件脚本这一项,是功能层面的新增,不是参数调优能追上的。
场景三:你在做金融分析、财报核对、投研
换。幻觉率从 23.35% 降到 6.85%,这条对金融场景的价值远超编码提升。金融工作里错一个数字的成本比慢十分钟高得多。
场景四:你只是拿它写文案、做头脑风暴
可以先不急着换,但换了也不亏,因为更便宜。这个场景下 K3.1 Pro 的提升不明显,日常对话你感受不到 Terminal-Bench 那几分的差距。
Highspeed 那笔加价,什么时候值得付
官方口径:Highspeed 同等智能,输出速度约 2 到 3 倍,价格翻倍。人民币价从输入 13 元 / 输出 68 元变成输入 26 元 / 输出 136 元。
有个细节很多人不知道:两个版本的缓存命中价相同,都是 1.30 元每百万 token。这意味着如果你有大量重复前缀(比如每次都把同一个代码库塞进上下文),Highspeed 的实际溢价会被缓存摊薄一部分,没有表面上翻倍那么夸张。
值得付的场景:你在屏幕前等结果、交互式改代码、做演示。三倍速度换双倍钱,等待时间节省的体感价值更高。
不值得付的场景:批量任务、夜里挂的 Agent、跑评测、调提示词阶段。你不在场,速度不值这个钱。
迁移时要注意的三件事
第一,参数不用改。 官方模型参数参考里写得很清楚:kimi-k3.1-pro 和 kimi-k3.1-pro-highspeed 的参数约束与 kimi-k3 完全一致。上下文 1M、reasoning_effort 三档、tool_choice 支持 required、temperature 固定 1.0,全都一样。换 model 字段就行。
第二,推理强度的档位描述要小心。 有报道写 K3.1 Pro 在 low / high / max 基础上新增 medium,共四档。查官方文档,推理强度 页和快速开始页都明确写的是 low / high / max 三档,默认 max。官方没有 medium 档。所以以官方文档为准,别照着三方报道写代码。
第三,多轮回传完整 assistant message。 这条是从 K3 继承下来的老规矩,很多人迁移时忽略。API 返回的完整 assistant message 要原样塞回下一次请求的 messages,包括 reasoning_content,不能只保留 content。只留 content 会让模型丢掉思考上下文,长程任务效果明显变差。
还有一条时间线要记:K2 系列 10 月 31 日起停止向新注册用户开放,12 月底下线。如果你还停在 K2.x,这次是一步到位的时机,先到 K3 再跳 K3.1 Pro 意义不大。K2.8 时代那些参数差异,Kimi K2.8 与 K3 的差异清单 里有完整对照,迁移前扫一遍能少踩坑。
想确认 K3.1 Pro 现在在哪些渠道已经全量可用、哪些还没上,Kimi K3.1 发布状态追踪 按渠道逐个核对过。
常见问题
Kimi K3.1 Pro 和 K3 哪个更强?
K3.1 Pro 更强,而且是全面的。它是 K3 的后训练加强版,同底座、同 1M 上下文,但在编码、3D 建模、金融分析和长程 Agent 任务上都有明确提升,幻觉率还从 23.35% 降到 6.85%。Artificial Analysis 给 55 分,高于 GPT-6 Astra、Gemini 4 Argon 和 Claude Fable 5.1 的 53 分。
K3.1 Pro 比 K3 贵还是便宜?
便宜。官方人民币定价 K3.1 Pro 输入 13 元、输出 68 元每百万 token,K3 是输入 20 元、输出 100 元,分别便宜 35% 和 32%。美元价同理,K3.1 Pro 是 2 美元输入 / 10 美元输出,K3 是 3 美元 / 15 美元。
K3.1 Pro 的 reasoning_effort 有几档?有 medium 吗?
官方文档写的是三档,`low`、`high`、`max`,默认 `max`。官方没有 medium 档。部分三方报道提到四档,与官方文档不符,请以官方推理强度文档为准。
从 K3 换到 K3.1 Pro 要改哪些代码?
基本只改 `model` 字段。官方明确说明两款模型的参数约束完全一致,上下文、推理强度档位、tool_choice、temperature 都不用动。唯一要检查的是有没有显式传固定值参数(temperature 等),传了会报错。
Highspeed 版智能水平会降吗?
不会。官方口径是「同等智能,输出速度约 2 到 3 倍」。它跟标准版的参数约束也完全一致,区别只在输出速度,价格翻倍。
K3.1 Pro 是不是第一个开放权重的 3 万亿级模型?
不是。全球首个开源的 3 万亿级模型是 K3(2.8 万亿参数)。K3.1 Pro 是 3 万亿级参数,官方承诺完整权重 11 月 4 日前发布,截至发稿尚未放出。
 京ICP备2024094994号-29