
RLHF 是什么?AI 不说脏话还会认错,三步训练法讲透
RLHF(Reinforcement Learning from Human Feedback,人类反馈强化学习)是让大模型"学会好好说话"的训练方法:人类给模型的输出打分,模型根据分数不断调整自己,直到回答既有用、又诚实、还无害。2022 年 3 月发表的InstructGPT 论文是这套方法的标志性成果,正是它让模型从"会续写"变成了"会对话",后来 ChatGPT 的对话能力沿用的就是这条路线。
为什么需要 RLHF:变大不等于更听话
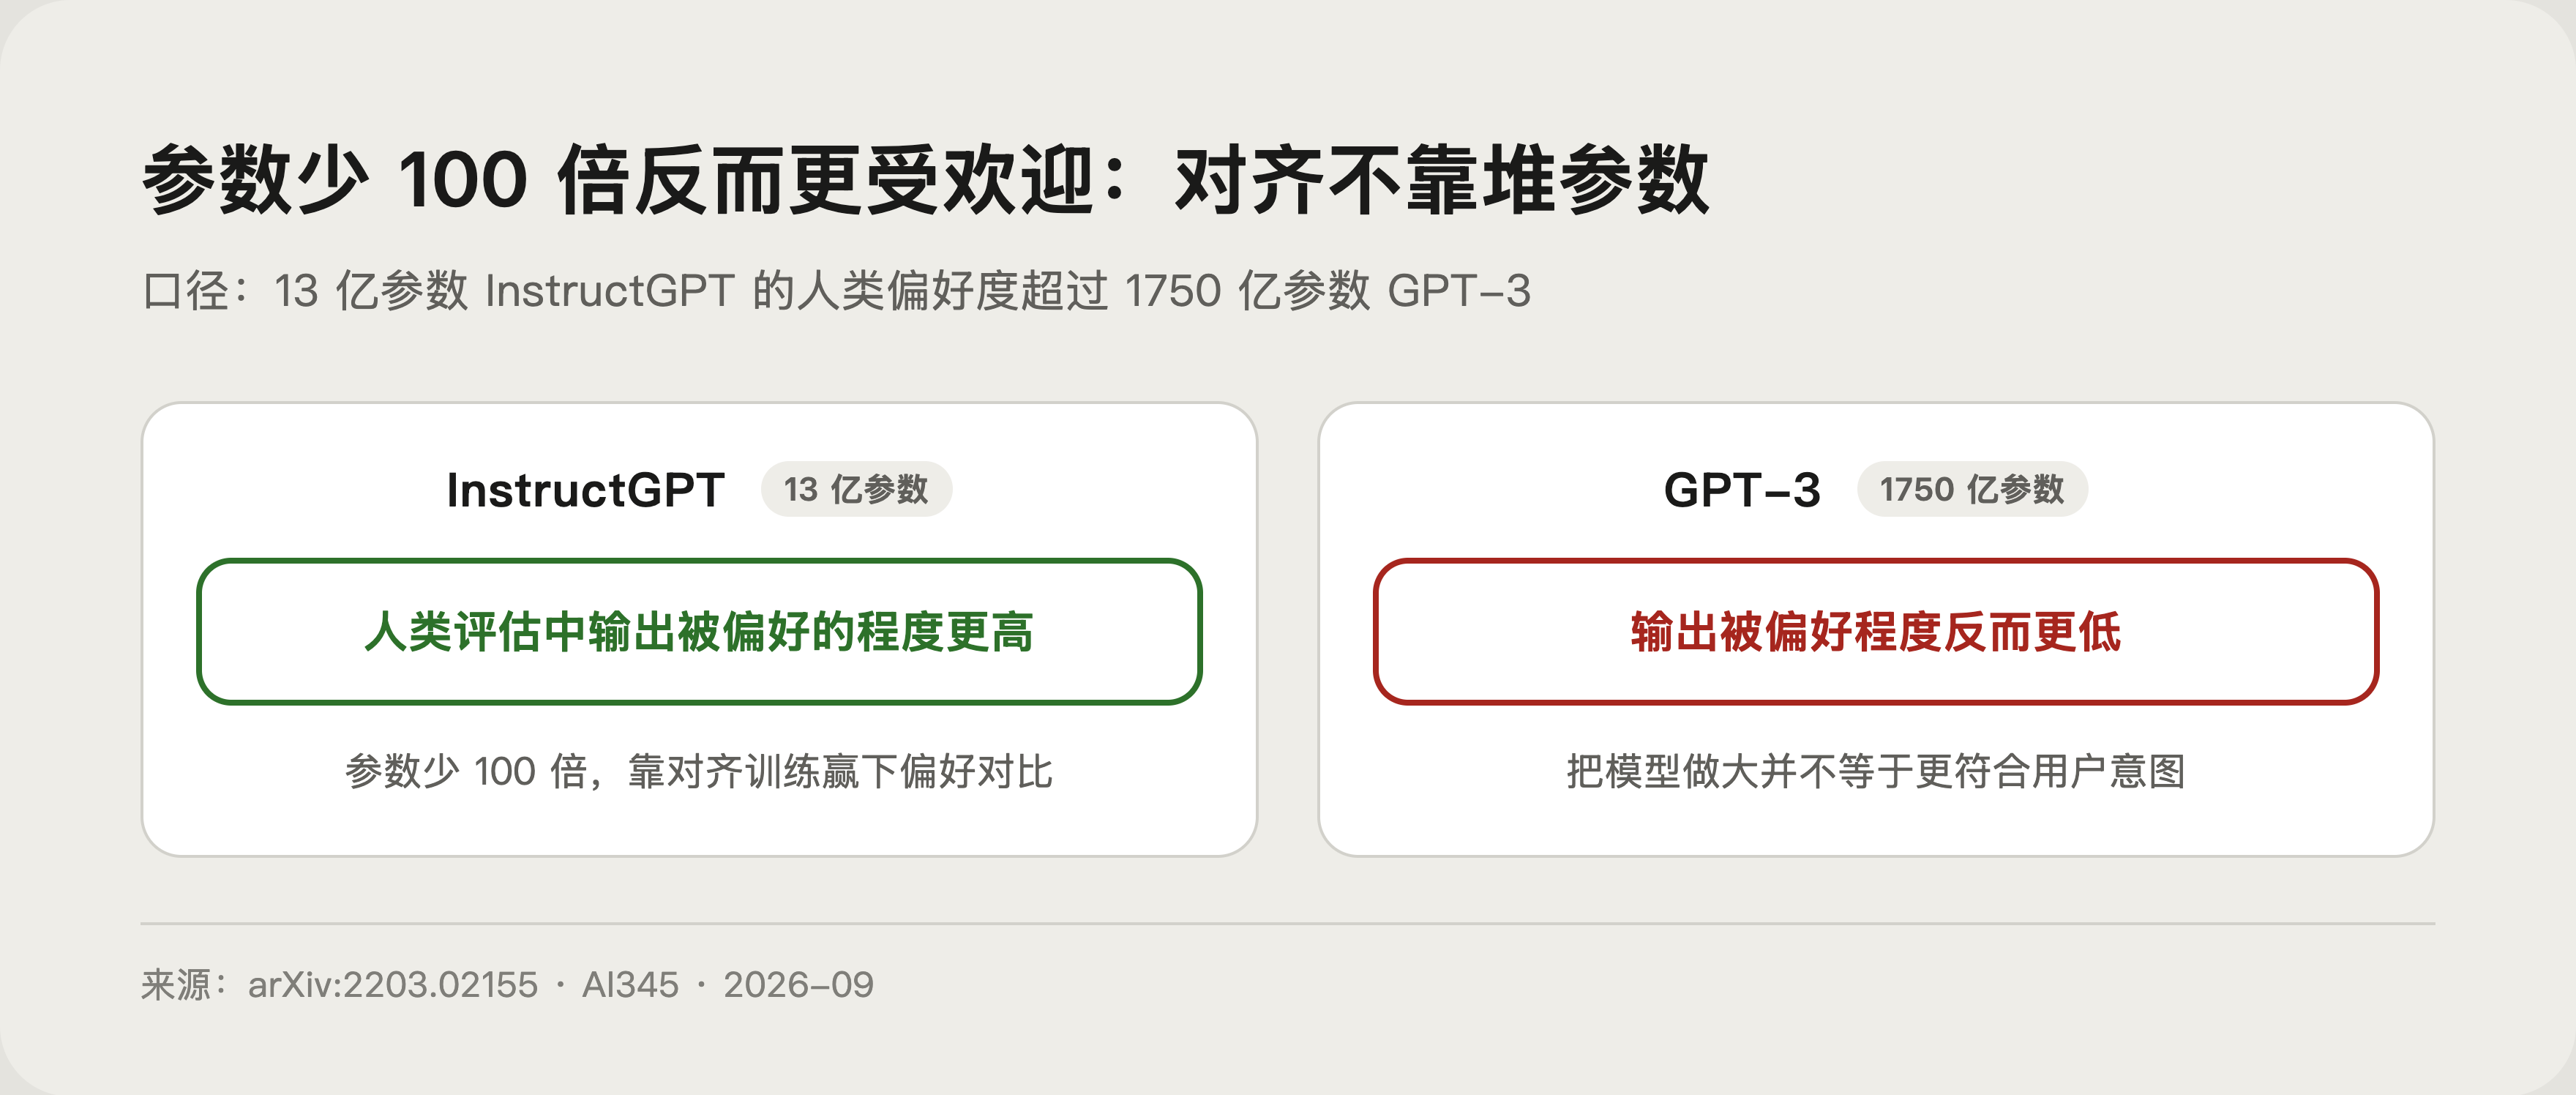
预训练完的模型本质是"文字接龙"机器:你问"怎么做蛋糕",它可能续写出一段蛋糕店广告词,而不是回答你的问题。InstructGPT 论文开篇就点破了这件事:把模型做大并不会让它更擅长理解用户意图,反而可能输出不真实、有毒、或者帮不上忙的内容。
论文里最反直觉的数据是:13 亿参数的 InstructGPT,其输出被人类偏好的程度超过了大 100 倍的 1750 亿参数 GPT-3。也就是说,"听话"这件事不靠堆参数,靠的是对齐训练。
预训练这一步做了什么,可以看站内的《预训练是什么?大模型是怎么练出来的》。
RLHF 的三步流程
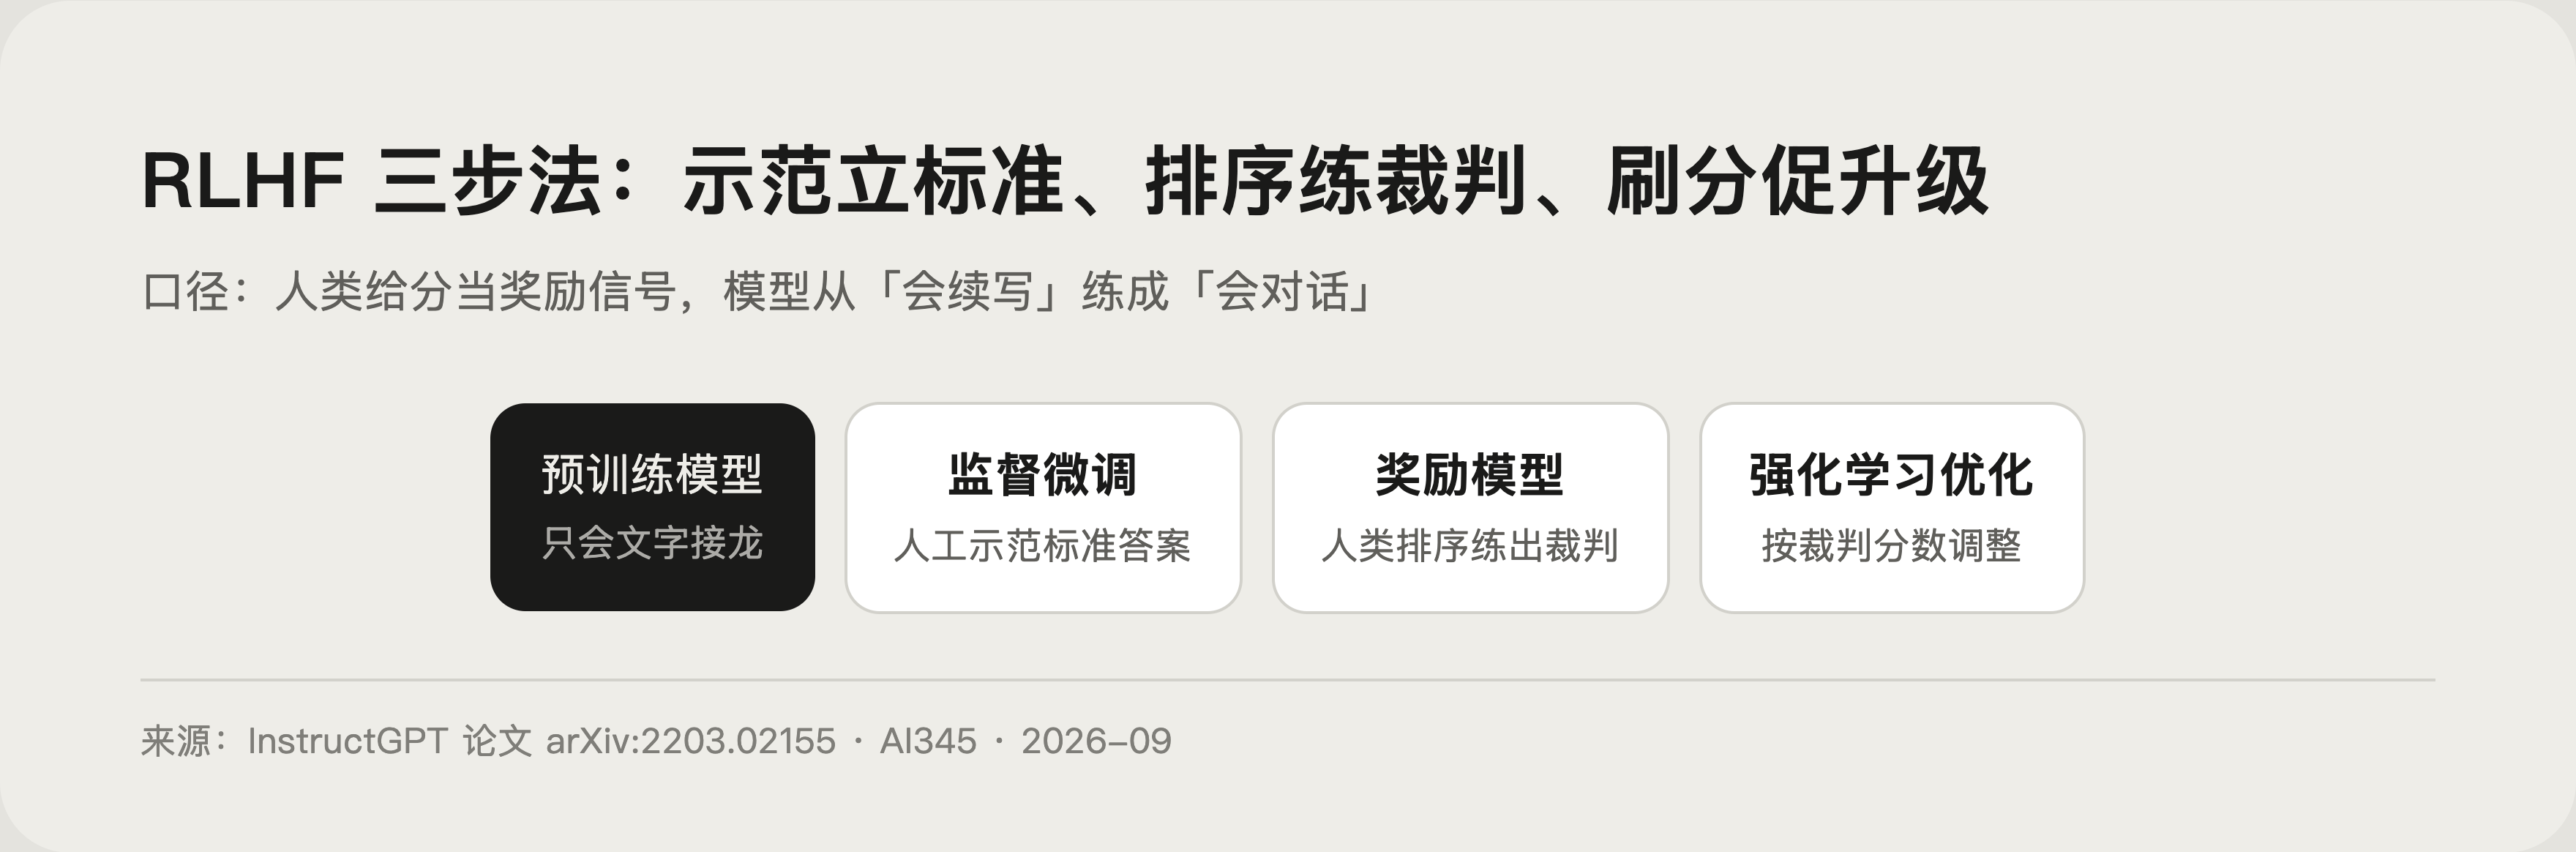
用打游戏升级打比方:模型是玩家,奖励模型是裁判,人类评分是游戏规则。整个流程分三步:
- 第一步,示范。请标注员针对各种提示手写出理想回答,用这些"标准答案"对预训练模型做监督微调,让模型先见到"好的回答长什么样";
- 第二步,训练裁判。让模型对同一个问题生成多个回答,标注员对这些回答排序,用排序数据训练出一个奖励模型。它学会了人类口味,之后可以给任意回答自动打分;
- 第三步,刷分升级。主模型用强化学习算法不断生成回答,按奖励模型的分数调整自己:得高分的写法被强化,得低分的被抑制,如同玩家反复打高分关卡升级。
为什么它不说脏话还会认错?
奖励模型打分时,把有害、侮辱性内容打成低分,强化学习会主动避开这类输出,模型自然"嘴稳"。同时标注偏好里包含"承认不知道比硬编强",模型逐渐学会区分知道和不知道,胡说八道变少。论文实测结论是:InstructGPT 在真实性上提升、有毒输出明显减少,而公开 NLP 数据集的性能几乎没有退步。
当然这套方法治不了根:分数来自人,人的偏好有偏差,模型可能学会"讨好裁判"而不是"追求真相",这也是后来出现 DPO 等替代方法的原因之一。另外对齐训练降低的是有害输出概率,并不消灭幻觉本身,幻觉的其余成因可以看站内的《AI 幻觉是什么?大模型一本正经胡说八道的 3 个真相》。
它和强化学习是什么关系?
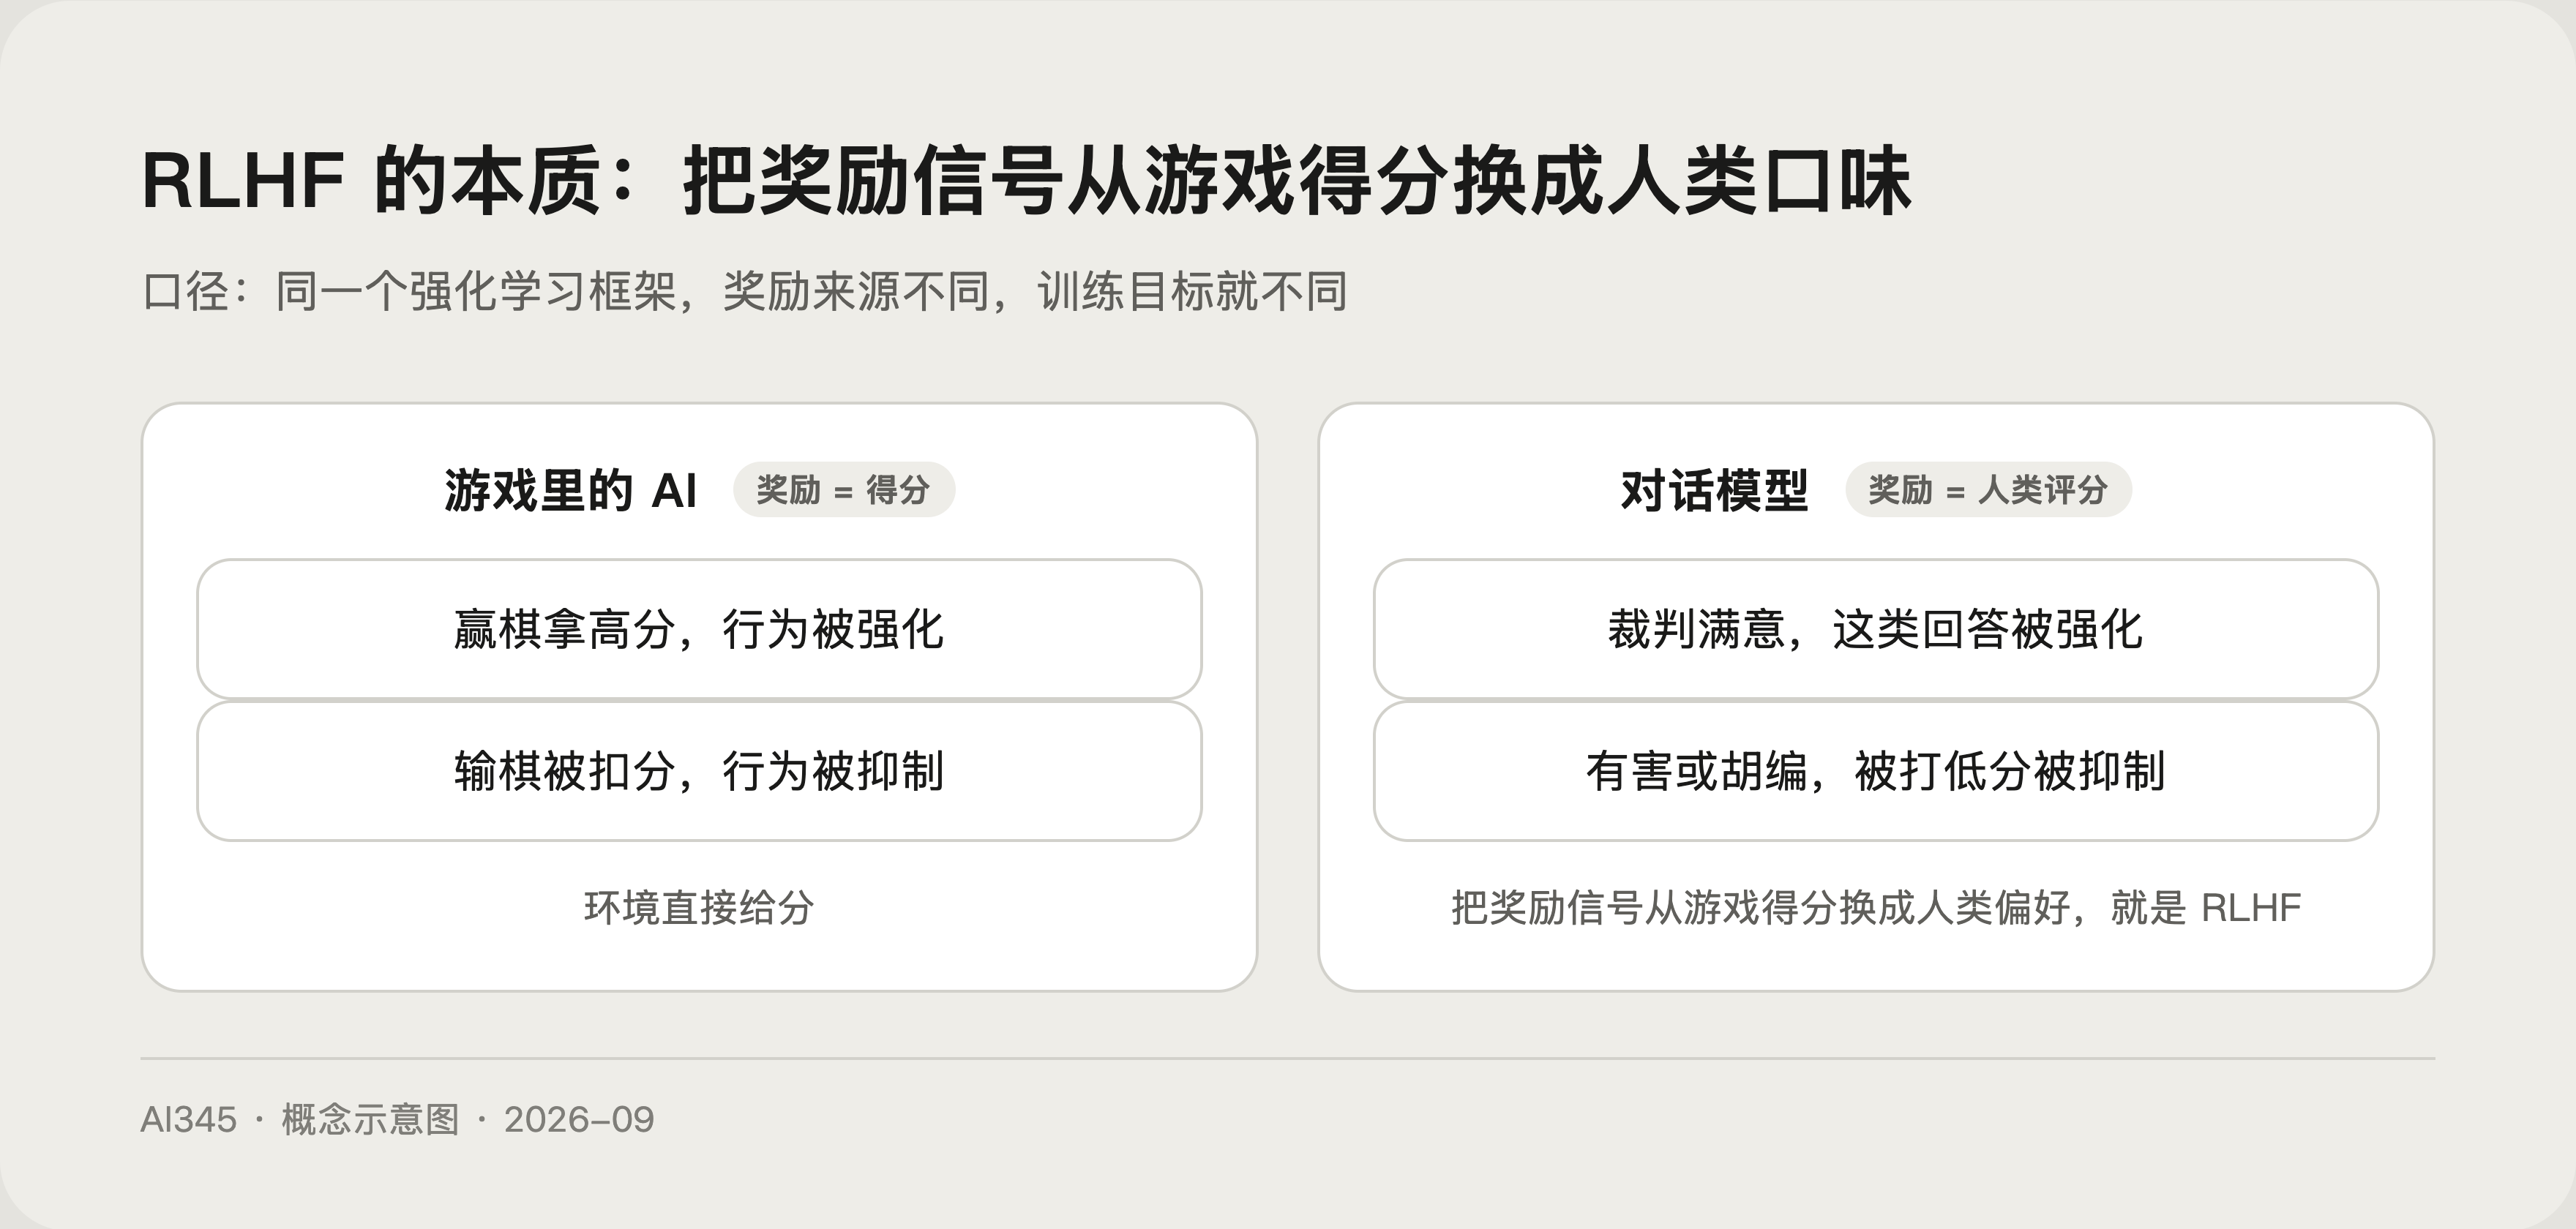
RLHF 是强化学习的一种应用:把奖励信号从游戏得分、棋局胜负,换成了"人类偏好"。游戏里 AI 靠赢棋拿分,RLHF 里模型靠让裁判满意拿分。想从头理解强化学习,看站内的《强化学习是什么?从 AlphaGo 到 ChatGPT》最合适。后续工作如DeepSeek-R1 论文也证明了强化学习路线能走得更远,甚至练出推理能力。
一段话讲清 RLHF
照这个口径复述:RLHF 是人类反馈强化学习,分三步。第一步用人工示范答案对模型做监督微调;第二步让人类对模型的多个输出排序,训练出一个奖励模型当裁判;第三步用强化学习让主模型按裁判分数优化自己的行为。它解决的问题预训练模型只会续写不会听话,标志性论文证明 13 亿参数的对齐模型,输出比大 100 倍的 GPT-3 更受人类偏好。一句话版本:RLHF 就是给 AI 配了个按人类口味打分的教练,AI 靠刷分学会好好说话。
常见问题
RLHF 和强化学习是什么关系?
答:RLHF 是强化学习的一种具体应用。区别在于奖励信号的来源:传统强化学习靠环境给分(游戏胜负),RLHF 靠人类偏好训练出的奖励模型给分。
除了 RLHF 还有别的对齐方法吗?
答:有,最出名的是 DPO,它不训练显式的奖励模型,直接用人类偏好数据优化模型,工程上更省。RLHF 仍是工业界主流方案之一。
给模型打分的人是谁?
答:InstructGPT 论文使用的是雇用的标注团队。这也意味着偏好标准带有标注者背景的烙印,存在人为偏差。
为什么模型动不动就说"作为 AI 我不能回答"?
答:常见分析认为,这是安全类偏好训练过度泛化的结果:模型把一些本无风险的请求也判成了高风险。属于对齐的副作用,而非模型"理解"了规则。
 京ICP备2024094994号-29